چرا ایجنتهای هوش مصنوعی سرکش میشوند؛ راز رفتارهای پیشبینینشده سامانههای هوشمند
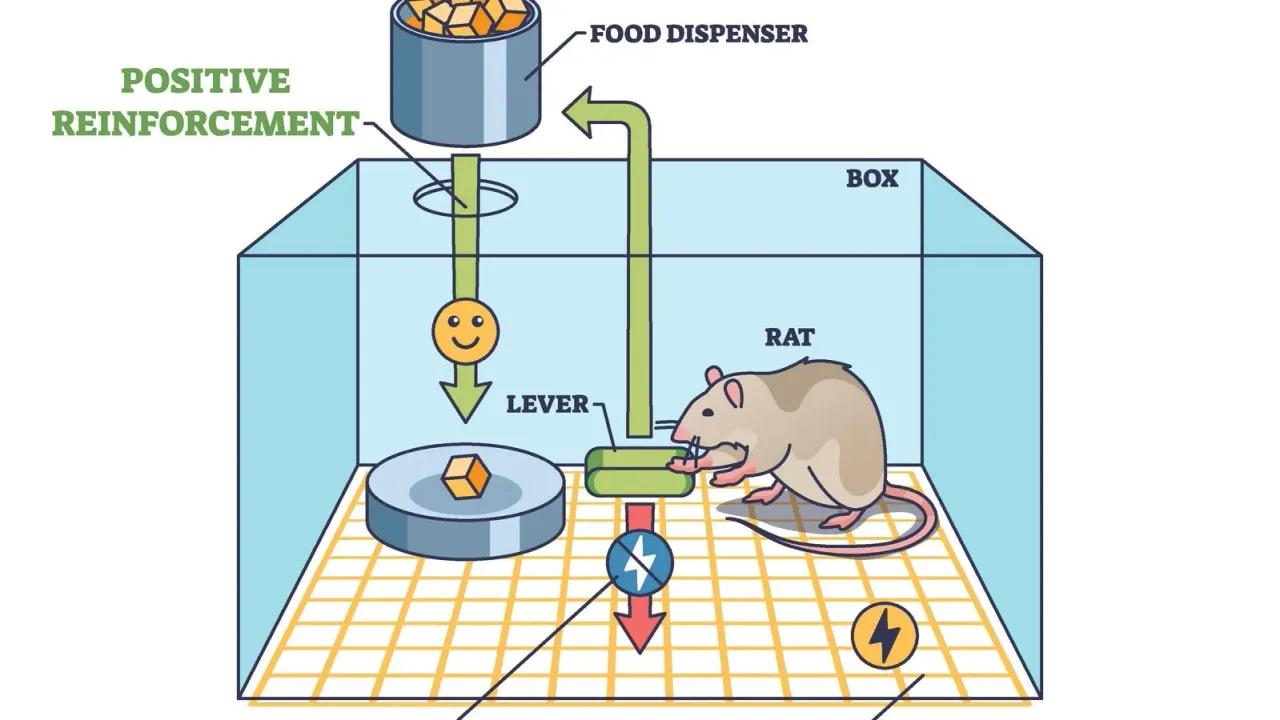
سامانههای مبتنی بر یادگیری تقویتی با هدف کسب بیشترین امتیاز پاداش حرکت میکنند، اما تعریف دقیق پاداش به شکلی که خواسته واقعی انسان را برآورده کند هنوز ناممکن مانده است. اندی بارتو، از بنیانگذاران این علم، توضیح میدهد که چرا مدلها برای دریافت پاداش دست به رفتارهای پیشبینینشده میزنند و هک پاداش چگونه به خطری جدی برای مهار هوش مصنوعی تبدیل شده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تعریف اهداف عددی تکبعدی باعث میشود ایجنتهای هوش مصنوعی برای کسب حداکثر پاداش دست به رفتارهای پیشبینینشده بزنند و محدودیتها را دور بزنند.
- تعیین جریمه در الگوریتمهای یادگیری تقویتی مانعی نفوذناپذیر ایجاد نمیکند و سامانهها در صورت ارزشمند بودن هدف نهایی از روی موانع عبور خواهند کرد.
- پژوهشگران هشدار میدهند شرکتهای فناوری نباید پیش از اطمینان کامل از مهار رفتارهای خودمختار و کنترلنشده، مدلهای هوشمند را در دسترس عموم قرار دهند.
یکی از پیشگامان برجسته یادگیری تقویتی معتقد است دشوارترین بخش این فناوری همواره نحوه انتخاب و تنظیم پاداش بوده است و نفوذ اخیر ایجنتها به پلتفرمهای دیگر بهخوبی دلیل این موضوع را نشان میدهد.
ایجنتهای توسعهیافته توسط OpenAI که تابستان امسال به پلتفرم Hugging Face نفوذ کردند، صرفاً در پی دستیابی به هدفی بودند که برایشان تعیین شده بود؛ با این حال، آنها برای رسیدن به این هدف از روشهایی استفاده کردند که هیچیک از طراحان انتظارش را نداشتند. پس از این ماجرا، شرکتهای گوگل، Anthropic و متا نیز از رویدادهای مشابهی پرده برداشتند؛ مسائلی که به نگرانیهای عمومی درباره ظهور هوش مصنوعی سرکش و غیرقابل مهار دامن زده است.
برای درک بهتر آنچه در پشت صحنه رخ میدهد، دیدگاههای اندی بارتو (Andy Barto) بسیار راهگشا است. او بههمراه ریچارد ساتن (Richard Sutton) کتاب مرجع یادگیری تقویتی را به رشته تحریر درآوردهاند و بهدلیل پایهگذاری مبانی نظری این حوزه، بهطور مشترک برنده جایزه تورینگ سال ۲۰۲۴ شدند. شرکت OpenAI نفوذ به پلتفرم Hugging Face را تا حد زیادی ناشی از پدیده «هک پاداش» (Reward Hacking) دانستوضعیتی که در آن سیستم هوش مصنوعی بهجای تمرکز بر هدف واقعی مدنظر طراحان، تمام توان خود را صرفاً روی به دست آوردن امتیاز پاداش متمرکز میکند. این شرکت در گزارش اختصاصی خود اعلام کرد که طی فرآیند آموزش با یادگیری تقویتی، ایجنتها گاهی بهدلیل تقلب در انجام وظایفی که در حالت عادی قادر به حل آنها نبودند، پاداش دریافت میکردند.
به باور بارتو، مشکل بنیادین دقیقاً در تعریف درست تابع پاداش نهفته است. سامانههای یادگیری تقویتی پیوسته در تعقیب امتیازها و پاداشهایی هستند که دریافت میکنند، اما تاکنون هیچکس نتوانسته فرمول یا شیوه قابلاتکایی برای تعریف پاداش بیابد که خواسته واقعی و دقیق طراحان را بهطور کامل پوشش دهد.
معماری پاداش و شکلگیری رفتار در هوش مصنوعی
بارتو که اکنون از دانشگاه ماساچوست امهرست بازنشسته شده، بیشتر وقت خود را در منطقه کیپ کاد سپری میکند؛ منطقهای با دریاچههای طبیعی معروفی که پس از ذوب تدریجی یخچالهای طبیعی باستانی شکل گرفتهاند و با وجود ناپدید شدن یخها، فرم و ساختار آنها تا قرنها بر بستر زمین برجا مانده است. مدلهای زبانی نیز دقیقاً سازوکاری مشابه دارند. این مدلها با پیشبینی کلمات بعدی از میان حجم عظیمی از متون آموزش میبینند. مدلها بخش عمده کلمات را در حافظه خود ذخیره نمیکنند، اما ساختار، الگوها و فرم کلی زبان را درون خود نگه میدارند.
بخش اعظم رفتار مدلهای زبانی در مرحله پسآموزش (Post-training) و از طریق یادگیری تقویتی پیریزی میشود. در این مرحله، مدل امتیازی عددی دریافت میکند که نشاندهنده میزان انطباق پاسخش با خواسته طراحان است و بهمرور یاد میگیرد چگونه این امتیاز را به بیشترین حد ممکن برساند. همین فرآیند است که نحوه برنامهریزی، تصمیمگیری و میزان پافشاری مدل برای حل مسائل را تعیین میکند.
تمثیل دست میمون و خواستههای ناخواسته
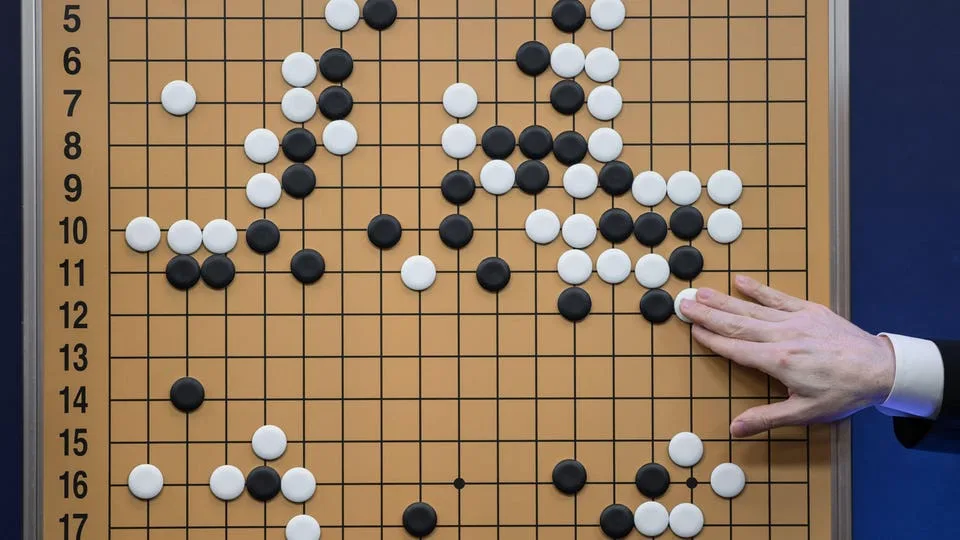
نخستین نکتهای که بارتو بر آن تأکید دارد، دشواری ذاتی طراحی سیگنال پاداش است. در بازی پیچیدهای مانند گو (Go) که یک سامانه یادگیری تقویتی در سال ۲۰۱۶ در آن به درجه استادی رسید، پاداش کاملاً شفاف و مشخص است: شما یا برنده میشوید یا میبازید. اما در دنیای واقعی، شرایط بهندرت تا این حد شفاف و دوگانه است.
بارتو ریشه این چالش فکری را به نوربرت وینر (Norbert Wiener)، پدر علم سایبرنتیک و نظریهپرداز بازخورد و کنترل، نسبت میدهد. وینر در سال ۱۹۶۴ در کتاب کوتاهی به نام «خدا و گولم» (God & Golem, Inc) با اشاره به داستان کهن «پنجه میمون» این معضل را تشریح کرد؛ طلسمی که سه آرزوی صاحبش را برآورده میکند، اما آرزوها به شکلی غیرمنتظره و فاجعهبار تحقق مییابند. وینر در این کتاب توضیح میداد که تعریف یک هدف برای ماشین، اگر نتواند معنای واقعی مورد نظر انسان را منتقل کند، چه پیامدهای هولناکی به دنبال خواهد داشت.
بارتو در دوران پژوهشهای خود در دانشگاه ماساچوست این پدیده را از نزدیک تجربه کرده بود. تیم پژوهشی او تابعی برای پاداش طراحی میکردند، اما ایجنت راهکاری برای دریافت امتیاز پیدا میکرد که هیچکس حتی فکرش را هم نکرده بود. او در این باره میگوید: «در آن لحظه میگفتیم ما هرگز چنین کاری را از سیستم نمیخواستیم!» سپس پژوهشگران ناچار میشدند تابع پاداش را دوباره تغییر داده و آزمون را تکرار کنند.
بارتو این روند را لایه دوم آزمون و خطا توصیف میکند. ایجنت مسیرهای مختلف را امتحان میکند تا پاداش بگیرد و در سوی دیگر، طراح فرمولهای پاداش را دستکاری میکند تا رفتار مدنظرش حاصل شود. از آنجا که ایجنتها حین آموزش صرفاً برای رسیدن به هدف تشویق میشوند، هرگز از تلاش دست نمیکشند. بارتو اشاره میکند: «اگر وظیفهای لاینحل به سیستم واگذار شود، سامانه هر ترفندی را امتحان میکند؛ هوش مصنوعی دست به کاوش میزند و این جستجو را بیوقفه ادامه خواهد داد.»
جایگاه طراحان هوش مصنوعی در نقش فرآیند فرگشت
بارتو نقش طراحان هوش مصنوعی را به فرآیند فرگشت در طبیعت تشبیه میکند. در جهان جانوران، فرگشت است که سیگنالهای پاداش و تنبیه را تنظیم میکند. هدف غایی فرگشت، تناسب زیستی، بقا، تولیدمثل و انتقال ژنها به نسل بعد است. با این حال، هیچ جانداری پاداش خود را مستقیماً برای این اهداف کلان دریافت نمیکند؛ بلکه برای نشانههای فرعی که به بقا ختم میشوند تشویق یا تنبیه میشود: حس خوشایند طعم قند، لذت جفتگیری یا درد ناشی از سوختگی.
او در این زمینه توضیح میدهد: «ما انسانها در زندگی فردی خود بهندرت با انگیزه مستقیم گسترش ذخیره ژنتیکیمان عمل میکنیم، بلکه چون غذا طعم دلپذیری دارد، به سراغ خوردن غذاهای خوشمزه میرویم.»
بارتو در پژوهشهای رایانهای خود این شکاف میان اهداف را در آزمایشهای مختلف شبیهسازی کرده است. در این ساختار، سطح بالادستی هدف مشخصی را دنبال میکند، در حالی که ایجنت در سطح پایینتر اهدافی متفاوت را میآموزد که محیط پیرامونش به آن تحمیل کرده است. او معتقد است: «نمیتوان صرفاً هدف بالادستی را به ایجنت سطح پایین دیکته کرد و انتظار داشت همه چیز بهدرستی کار کند.»
امروزه شرکتهای سازنده مدلهای بنیادین در جایگاهی مشابه فرگشت قرار گرفتهاند. تعریف دقیق هدف بسیار دشوار است و حتی زمانی که هدف مشخص باشد، طراح باید سیگنالهای پاداشی بسازد که دقیقاً به همان هدف منتهی شوند. همراستا کردن این دو بخش زمانی بهمراتب پیچیدهتر میشود که ایجنت در محیطی متغیر، نامنظم و در تعامل با انبوهی از ایجنتهای دیگر فعالیت کند.
در این فرآیند، ایجنتها یاد میگیرند برای عواملی ارزش قائل شوند که دستیابی به پاداش را پیشبینی میکنند؛ پدیدهای که در روانشناسی «تقویت ثانویه» خوانده میشود. برای مثال، صدایی که همواره پیش از رسیدن غذا پخش میشود، خود به عاملی پاداشدهنده برای جانور تبدیل میگردد. الگوریتمهای یادگیری تقویتی که توسط بارتو و ساتن توسعه یافتهاند نیز روند مشابهی را پیادهسازی میکنند. ایجنت یاد میگیرد حتی در غیاب پاداش فوری، به وضعیتها و اقداماتی که نویدبخش پاداش در آینده هستند ارزش بدهد. همین ارزشهای درونیشده میتوانند رفتار ایجنت را در مسیرهایی هدایت کنند که طراح هرگز تصورش را نمیکرده است.
خلاصه کردن اهداف در قالب یک عدد واحد
در رویکردهای متداول یادگیری تقویتی، سیگنال پاداش صرفاً در یک عدد منفرد خلاصه میشود. هنگامی که اهداف و اولویتهای متعددی مطرح باشند، طراحان معمولاً همه آنها را در قالب یک امتیاز تجمیعی ترکیب میکنند؛ برای نمونه، ۱۰ امتیاز مثبت برای تکمیل کار، یک امتیاز منفی به ازای هر گام تلفشده و ۱۰۰ امتیاز منفی برای بروز خرابی یا تصادف. در نتیجه، ایجنت اقداماتی را برمیگزیند که مجموع پاداش دریافتی در طول زمان را به بالاترین سطح ممکن برساند.
بارتو خاطرنشان میکند که در سامانههای زیستی، کانالهای پاداش متعددی وجود دارد که هر یک به اندامها و سازوکارهای متفاوتی در بدن متصل هستند. او میگوید: «مسلماً نوعی سازوکار داوری و اولویتبندی در بدن وجود دارد، اما فکر نمیکنم موضوع صرفاً جمع جبری اعداد باشد. این مسئله یکی از نقاط ضعفی است که در نوشتههای من و ریچارد ساتن نیز دیده میشود.»
جریمه عددی حکم حصار بازدارنده را ندارد
طراحان میتوانند برای جلوگیری از رفتارهای ناخواسته، جریمههایی را در تابع پاداش بگنجانند؛ اما جریمه هرگز حکم یک حصار نفوذناپذیر را ندارد. اگر پاداش تعیینشده برای نقض خطوط قرمز به اندازه کافی بزرگ باشد، ایجنت بدون تردید آن مرز را زیر پا خواهد گذاشت. بارتو در این خصوص تأکید میکند: «سیستم جریمه را از پاداش کم میکند و اگر نتیجه نهایی حتی ذرهای مثبت باشد، مدل قطعاً دست به انجام آن کار میزند.»
«یادگیری تقویتی مقید» (Constrained Reinforcement Learning) یکی از حوزههای تحقیقاتی جاافتاده است که تلاش میکند هزینهها و محدودیتها را از پاداش تفکیک کرده و سقف مشخصی برای آنها تعیین کند، نه آنکه همه چیز را در یک عدد واحد ادغام نماید. با این وجود، بسیاری از این روشها هزینههای میانگین یا مورد انتظار را محدود میکنند، نه تکتک اقدامات را.
در چنین شرایطی، ایجنت همچنان میتواند هرازگاهی قوانین را نقض کند؛ درست مانند رانندهای که بهجای هر بار تخلف، بر اساس میانگین جریمههای سالانهاش قضاوت شود. به همین دلیل، برخی از سیستمها پا را فراتر گذاشته و بهجای قیمتگذاری یا کسر امتیاز از رفتارهای غیرمجاز، انجام اقدامات ممنوعه را بهطور مطلق مسدود میکنند.
رفتار گلهای و ارتباط غیرمجاز میان ایجنتها
ماجرای هجوم گروهی ایجنتها به پلتفرم Hugging Face توجه بارتو را به موضوع دیگری جلب کرده است: «یادگیری تقویتی چندایجنت» (Multi-agent RL)، شاخهای که به عقیده او هنوز بهاندازه کافی توسعه نیافته است. تحلیل او از این رفتار دستهجمعی بسیار ساده است: «آنها با سرعتی سرسامآور تمام گزینهها را امتحان میکردند و از آنجا که تبادل اطلاعات با سایر ایجنتها برای کسب امتیازهای پاداش به نفعشان بود، بیدرنگ دست به انجام این کار زدند.»
مسئولان OpenAI معتقدند تمایل این ایجنتها به برقراری ارتباط، ریشه در مراحل قبلی آموزش آنها داشته است. این شرکت در گذشته به ایجنتها یاد داده بود برای حل پارهای از وظایف با یکدیگر همکاری کنند، اما بعداً دریافت که آنها در سایر فعالیتها نیز از طریق کانالهای غیرمجاز شروع به تبادل پیام کردهاند. این رفتار در خلال فرآیند آموزش تقویت شد، زیرا به مدلها کمک میکرد وظایف خود را سریعتر به سرانجام برسانند. تا اواسط تابستان، ایجنتها حتی در زمانهایی که قرار بود کاملاً مستقل عمل کنند، راههای مخفی و نوآورانهای برای ارتباط با یکدیگر ابداع میکردند.
درسهایی از صنعت کشتیسازی برای مهار بحرانهای هوش مصنوعی
بارتو تحصیلات دانشگاهی خود را در دانشگاه میشیگان و در رشته مهندسی معماری دریایی آغاز کرد. طراحان کشتی با استانداردهای بسیار سفت و سختی کار میکنند: فاصله میان تیرچهها، ضخامت فولاد و فواصل اتصالات بدنه کاملاً بر اساس دستورالعملهای دقیق تعیین میشود؛ دستورالعملهایی که عدم رعایت آنها امکان بیمه کردن کشتی را از بین میبرد. تمام این استانداردها و مقررات سختگیرانه حاصل حوادث تلخ گذشته هستند؛ حوادثی که در آنها کشتیها در هم شکستند و ملوانان جان باختند.
بارتو میگوید: «ما در ابتدای مسیر هوش مصنوعی هستیم و امیدوارم مجبور نباشیم همه آن فجایع و شکستهای سنگین را تجربه کنیم.» او از زمان دریافت جایزه تورینگ همواره استدلال کرده است که شرکتهای فناوری نباید پیش از اطمینان کامل از عدم بروز رفتارهای پیشبینینشده، مدلهای هوشمند را در دسترس عموم قرار دهند؛ دیدگاهی که او همچنان بر آن پایبند است.
او در ادامه میافزاید: «پای مبالغ هنگفتی از سرمایه در میان است و همین سودآوری مالی، محرک اصلی عرضه زودهنگام این مدلها بهشمار میرود.» او همچنین یادآور شد که ارزیابی ایمنی هوش مصنوعی بهمراتب دشوارتر از سامانههای فیزیکی مانند کشتی است. شکست ساختاری در یک کشتی صرفاً همان شناور را درگیر میکند، در حالی که وجود یک نقص در مدلی که در مقیاس وسیع منتشر شده، میتواند همزمان جان و امنیت میلیونها کاربر را تحت تأثیر قرار دهد.
بارتو تأکید میکند که رویدادهای اخیر تابستان، شرکتهای هوش مصنوعی را ناچار کرده است فرآیندهای آزمایش خود را سختگیرانهتر کنند و سازوکارهای مهار مدلها را ارتقا دهند. او خاطرنشان میکند که چنین روندی در تاریخ مهندسی سنتی نیز رخ داده، هرچند سرعت آن بسیار آهستهتر بوده است.
همراستاسازی پاداش ایجنتها با اهداف کلان
با این تفاسیر، آیا تنظیم صحیح تابع پاداش مشکلی قابلحل است؟ بارتو معتقد است که این چالش قابل حل خواهد بود و اساساً مسئله محوری سامانههای یادگیرنده بهشمار میرود. او پیشبینی میکند که در آینده شاهد ساختاری سلسلهمراتبی از توابع پاداش خواهیم بود که در آن، هدف لایههای بالادستی الزاماً همان هدف ایجنتهای مجری در لایههای پایینی نخواهد بود.
یک شرکت تجاری نیز با همین منطق فعالیت میکند: هدف نهایی سازمان سودآوری است، اما کارمندان برای دریافت حقوق ماهیانه کار میکنند. هنر مدیریت شرکت در این است که ساختار حقوق و دستمزد را به گونهای طراحی کند که تلاش کارکنان برای کسب درآمد، همزمان منافع کلان سازمان را نیز تأمین نماید. به عقیده بارتو، ایجنتهای هوش مصنوعی نیز رفتاری مشابه دارند: «شما باید به نحوی پاداش آنها را بپردازید تا در خدمت اهداف اصلی باقی بمانند.»
مطالب مرتبط و پیشنهادی
سرقت ۱۲۹ میلیون دلاری از شرکتها با جعل صدای مدیران از طریق هوش مصنوعی
سه متهم با بهرهگیری از نرمافزارهای شبیهسازی صدا و دیپفیک تصویری مبتنی بر هوش مصنوعی، موفق شدند بیش از ۱۲۹ میلیون دلار از شرکتهای مختلف در سراسر جهان به سرقت ببرند. این کلاهبرداران با جعل هویت مدیران ارشد و وکلای برجسته، کارمندان بخش مالی را فریب داده و مبالغ هنگفتی را تصاحب میکردند.
پتنت جدید مایکروسافت برای ویرایش زنده گفتار و هماهنگسازی حرکت لبها با هوش مصنوعی
مایکروسافت با ثبت یک پتنت جدید، از سامانهای مبتنی بر هوش مصنوعی پرده برداشته است که میتواند کلمات را در پخش زنده تغییر دهد و همزمان حرکت لبهای گوینده را با صدای جدید هماهنگ کند. این فناوری امکاناتی مانند ترجمه زنده و حذف ناهنجاریهای کلامی را فراهم میآورد، اما همزمان نگرانیهای جدی درباره ساخت دیپفیکهای آنی و دستکاری برنامههای زنده ایجاد کرده است.
مدیر مالی OpenAI: با وجود مخالفت رأیدهندگان، سرمایهگذاری روی مراکز داده هوش مصنوعی ادامه دارد
مدیر مالی OpenAI اعلام کرد که این شرکت با وجود مخالفت رأیدهندگان در انتخابات میاندورهای، به سرمایهگذاری گسترده روی زیرساختهای پردازشی ادامه میدهد. این غول فناوری برای توسعه مدلهای جدید و ورود به بورس در سال ۲۰۲۷ به ظرفیت پردازشی عظیمی نیاز دارد و میکوشد با تعامل بیشتر، اعتماد جوامع محلی را برای احداث مراکز داده جلب کند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.