بحران کپیرایت در غولهای هوش مصنوعی؛ تصاحب دسترنج دیگران و جیب پرپول شرکتها
اسناد افشاشده دادگاه نشان میدهد غولهای هوش مصنوعی با نادیدهگرفتن کپیرایت و مجوزهای متنباز، وب را به معدن داده رایگان خود تبدیل کردهاند. این شرکتها با تکیه بر استدلال استفاده منصفانه، نهتنها از پرداخت دستمزد به پدیدآورندگان اصلی محتوا طفره میروند، بلکه بقای زنجیره تأمین دانش را نیز به مخاطره انداختهاند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- اسناد دادگاه نیویورک تایمز نشان میدهد مدیران مایکروسافت آموزش مدلهای زبانی روی دادههای وب را «بزرگترین سرقت کار در تاریخ بشر» خواندهاند.
- حکم دادگاه استیناف آمریکا پیرامون گیتهاب کوپایلت نهتنها چالش مجوزهای متنباز را حل نکرده، بلکه خطرات حقوقی استفاده از کدهای هوش مصنوعی را افزایش داده است.
- بزرگان هوش مصنوعی با استناد به بهانههایی چون ایمنی و استفاده منصفانه، به دنبال تصاحب یکجانبه درآمدها و محدودسازی رقبای نوپا هستند.
غولهای هوش مصنوعی با بحران بزرگی روبهرو شدهاند. شرکتهای فعال در این حوزه ناچارند برای آموزش مدلهای زبانی بزرگ (LLM) دسترنج دیگران را ببلعند؛ از کتابها و مقالههای خبری گرفته تا عکسها، قطعهکدها، وبسایتها و عملاً هر آنچه در پهنه وب وجود دارد. این واقعیتی آشکار است، اما واقعیت ملموستر این است که این شرکتها بهشدت از پرداخت هزینه بابت این دادهها، رعایت مجوزهای کپیرایت یا حتی شریککردن تولیدکنندگان اصلی آثار در درآمدهای نجومی خود بیزارند.
اخیراً فرمول پیشفرض غولهای فناوری یعنی «اول تصاحب کن و بعداً در دادگاه چانه بزن»، بیش از هر زمان دیگری در کانون توجه قرار گرفته است. نمونه بارز این رویکرد را میتوان در نبرد حقوقی جنجالی روزنامه نیویورک تایمز علیه اوپنایآی و مایکروسافت مشاهده کرد. بر اساس گزارش رسانه 404 Media از اسناد بهتازگی افشاشده دادگاه (که البته هنوز قاضی درباره آنها رأی نهایی صادر نکرده)، شواهد نشان میدهد مایکروسافت هنگام جمعآوری بیرویه دادههای وب دقیقاً میدانسته دست به چه کاری میزند.
در لایحه ۹۲ صفحهای وکلای نیویورک تایمز، نقلی از دکتر برنت هکت (Brent Hecht)، مدیر علوم کاربردی مایکروسافت، آمده است که این پرونده را «سرقتی حیرتانگیز در ابعادی بیسابقه» توصیف میکند. در خلاصه لایحه وکلای خبرنگاران آمده که او حتی این ماجرا را احتمالاً «بزرگترین سرقت کار و دسترنج در تاریخ بشر» دانسته است (نسخه PDF). نکته تأملبرانگیز اینجاست که این اظهارنظر از سوی خبرنگاران یا منتقدان مطرح نشده، بلکه اعتراف یکی از مدیران ارشد خودِ مایکروسافت است.
هکت تنها فردی در مایکروسافت نبود که چنین دیدگاهی داشت. در یکی از اسناد سیاستگذاری داخلی مایکروسافت که به دادگاه ارائه شده، نویسندگان اعتراف کردهاند هوش مصنوعی مولد میتواند «شغل همان افرادی را که دادههای آموزش مدل پایه را خلق کردهاند، به مخاطره بیندازد؛ چراکه مدلهای زبانی محصولی به شمار میروند که زنجیره تأمین خود را نابود میکنند». این تخریب زنجیره تأمین در نهایت به پدیده فروپاشی مدل (Model Collapse) منجر میشود؛ طنز تلخی که نشان میدهد هوش مصنوعی در حال کشتن همان غازی است که تخمهای طلایی محتوای ارزشمند را میگذارد.
البته باید توجه داشت که قاضی سیدنی اشتاین (Sidney H. Stein) در دادگاه ناحیهای جنوب نیویورک هنوز حکم نهایی را در این پرونده صادر نکرده است.
اوپنایآی و مایکروسافت با تمسک به اصل «استفاده منصفانه» (Fair Use)، قاطعانه اتهامات شاکیان را رد میکنند. آنها استدلال میآورند که بهرهگیری از مقالات و کتابهای عمومی برای آموزش مدلهای زبانی به ارتقای دانش عمومی بشر کمک میکند و جایگزین اقتصادی غیرقانونی برای بازار آثار اصلی محسوب نمیشود.
اما واقعیت اظهارات افشاشده در اسناد غیرقابل انکار است. غولهای هوش مصنوعی خوب میدانند که حیاتشان به این محتوا وابسته است. برخی از این شرکتها حتی پروایی از عواقب کار ندارند و شعارشان این است: «الان سود را به جیب بزن، بعداً نگران پیامدهایش باش». کسانی هم که فراتر از ارقام درآمدی کوتاهمدت فکر میکنند، بهخوبی واقفاند که وارد نوعی «چرخه ویرانگر» (Doom Loop) در استراتژی محتوای هوش مصنوعی شدهاند؛ همان تعبیری که مایکروسافت در اسناد افشاشده به کار برده است. اما آیا این آگاهی جلوی آنها را میگیرد؟ ابداً.
بر اساس اسناد ارائهشده به دادگاه (نسخه PDF) که به اظهارات سوگندخورده نماینده رسمی اوپنایآی استناد دارد، مدلهای زبانی این شرکت حتی از بلعیدن محتوای پشت دیوارهای پرداخت پولی (Paywall) نیز ابایی نداشتهاند. نماینده اوپنایآی در اظهارات خود بیان کرده که از «هیچ تلاشی برای شناسایی یا حذف محتوای دارای دیوار پرداخت در مجموعهدادههای آموزشی» آگاهی ندارد. جالبتر آنکه وقتی به گرگ بروکمن (Greg Brockman)، همبنیانگذار اوپنایآی، اطلاع داده شد که سیستم میتواند دیوارهای پرداخت را دور بزند، او در پاسخ بهسادگی گفت: «آه، عالیه!»
فارغ از اینکه این اظهارات بازتابدهنده رویکرد کلی یک شرکت باشد یا خیر، نگرش مشابهی در میان تمام بزرگان هوش مصنوعی حاکم است. چنین سیاستهایی ممکن است در نهایت دامن سازندگان مدلهای زبانی را بگیرد؛ رویکردی که همین حالا هم بازار روزنامهنگاری، نویسندگی، طراحی گرافیک و هر حوزهای را که نیازمند پرداخت دستمزد به انسانها بابت خلق اثر اصیل است، تحت فشار گذاشته است.
با این حال، بزرگان هوش مصنوعی حاضر به پرداخت هزینه محتوا نیستند. این اتفاق یک عارضه جانبی نیست؛ بلکه مدل تجاری اصلی آنهاست.
کاربران عادی نیز اغلب اهمیتی به این موضوع نمیدهند؛ آنها صرفاً پاسخی سریع و بهظاهر درست میخواهند. برای بسیاری حتی صحت پاسخها نیز چندان دغدغه مهمی نیست و بررسی عمیقتر برای اطمینان از درستی اطلاعات بازتولیدشده، عملاً به فراموشی سپرده شده است. همانطور که یکی از مهندسان نرمافزار اوپنایآی میگوید: «هر چقدر هم لینک منابع را برجسته نشان دهیم، کاربران روی آنها کلیک نخواهند کرد».
با وجود این، کاربران حرفهای و پژوهشگران رویکرد متفاوتی دارند. برای نمونه، دلیل محبوبیت ابزارهایی مانند پرپلکسیتی (Perplexity) برای بسیاری از افراد، دقیقاً ارائه منابع و پیوندهای مستند است تا پیش از پذیرش هر ادعایی بتوان به مراجع دستاول رجوع کرد؛ عادتی بنیادین که سالها در محافل دانشگاهی آموزش داده شده اما در میان عموم کاربران جایی ندارد.
غولهای فناوری رویکرد مشابهی را در حوزه ابزارهای تولید خودکار کد در پیش گرفتهاند. دادگاه استیناف حوزه نهم ایالات متحده اخیراً در پرونده شکایت از گیتهاب، پیروزی شکنندهای را به گیتهاب، مایکروسافت و اوپنایآی واگذار کرد. دادگاه حکم داد که شاکیان نتوانستهاند ادعای خود را بر اساس یکی از بندهای خاص قانون کپیرایت هزاره دیجیتال (DMCA) که به حذف یا تغییر اطلاعات مدیریت کپیرایت (CMI) مربوط میشود، اثبات کنند.
به زبان ساده، دادگاه اعلام کرد تولید کد جدید بدون درج اطلاعات مدیریت کپیرایت، لزوماً به معنای حذف یا دستکاری اطلاعات کپیرایت یک اثر موجود نیست. اریک میلر (Eric Miller)، قاضی پرونده، در این باره نوشت: «کسی که اثر جدیدی خلق میکند و اطلاعات CMI را در آن نمیآورد، نمیتوان گفت چیزی را "حذف" یا "تغییر" داده است».
این حکم به هیچ عنوان به این معنا نیست که گیتهاب کوپایلت یا هر مدل برنامهنویسی دیگری مجاز است بدون محدودیت از تمام پروژههای متنباز برای آموزش استفاده کند. دادگاه نه تأیید کرده که کپیکردن کدهای منبع در مجموعهداده آموزشی همواره مصداق استفاده منصفانه است، و نه اعلام کرده که کدهای تولیدشده با هوش مصنوعی نمیتوانند نقض کپیرایت باشند. همچنین این رأی اعتبار مجوزهای متنباز مانند GPL، Apache، BSD یا MIT را لغو نکرده است. در نهایت، مفهوم متنباز به معنای «هر کاری دلتان خواست با آن انجام دهید» نیست؛ هرچند وقتی پای هوش مصنوعی به میان میآید، ماجرا دقیقاً همینگونه به نظر میرسد.
چالش اصلی کدهای تولیدشده توسط هوش مصنوعی در همین نقطه نهفته است. برنامهنویسی که پیشنهادی از کوپایلت دریافت میکند، بهندرت بررسی میکند که آیا آن قطعهکد تحت پوشش مجوز GPL قرار دارد یا از کتابخانهای با مجوز Apache برداشته شده است. توسعهدهنده به هیچ وجه نمیتواند بفهمد کدی که مدلهایی مانند Opus 5.5 یا GPT-6 تولید کردهاند، تابع چه شرایط حقوقی و مجوزی است. همانطور که مهندس اوپنایآی اشاره کرد، کاربران روی لینکها کلیک نمیکنند و در چرخهها و ابزارهای برنامهنویسی هوش مصنوعی، اصولاً لینکی هم به منابع داده نمیشود.
یکی از وکلای برجسته حوزه متنباز نگرانی بسیار عمیقتری نسبت به این حکم محدود دارد. به باور او، یک روند نگرانکننده بزرگتر در حال شکلگیری است: «در موارد متعددی مشاهده میشود که طرفین دعوا با مجوزهای متنباز نه بهعنوان مجوزهای مالکیت فکری و حق تألیف، بلکه صرفاً به مثابه قراردادهای حقوقی ساده برخورد میکنند. پیگیری دعاوی در چارچوب نظریه قراردادها به شاکیان اجازه میدهد از پاسخ به پرسشهای بنیادی کپیرایت طفره بروند؛ پرسشهایی از این دست که: "آیا شما مالک اثر هستید؟ آیا اثر قابلیت حفاظت قانونی دارد؟ و آیا سرقت و نسخهبرداری واقعاً رخ داده است؟"»
او در ادامه تأکید میکند: «این پرسشها همان ستونهایی هستند که مجوزها بر پایه آنها بنا شدهاند. مجوزهای متنباز در واقع اعطای اجازه برای استفاده از مالکیت فکری دیگران هستند. اگر در یک پرونده نتوان اثبات کرد که مالکیت فکری نقض شده، جای این پرسش وجود دارد که آیا اجرای مجوز بهعنوان یک قرارداد حقوقی ساده، واقعاً از اکوسیستم متنباز محافظت میکند یا آن را بیصدا به پدیدهای کاملاً متفاوت تبدیل میسازد؟»
با ورود هوش مصنوعی به این معادله، مناقشات مالکیت فکری به معضلی تبدیل خواهند شد که برنامهنویسان از آن فراریاند و کسبوکارها مایل به دوری از آن هستند؛ اما در نهایت دادگاهها باید با حضور وکلای گرانقیمتی که دستمزد ساعتی آنها حتی ثروتمندان حوزه هوش مصنوعی را شگفتزده میکند، به حلوفصل آن بپردازند.
ناگفته پیداست که ابهامات حوزه مالکیت فکری صرفاً یک مسئله اداری ساده نیست؛ بلکه معضلی اساسی در امنیت زنجیره تأمین و تطابق قانونی محسوب میشود. استفاده از کدهای تولیدشده با هوش مصنوعی ممکن است تعهدات حقوقی ناشناختهای را به نرمافزار شما تحمیل کند. اگر توسعهدهنده متنباز باشید، دسترنج شما ممکن است برای ارتقای یک سرویس انحصاری به کار رود که کدها را بدون ذکر منبع، استناد یا هیچگونه تعهد متقابل ارائه میدهد. از سوی دیگر، اگر مشتری یا کاربر نهایی باشید، شاید از نرمافزاری استفاده کنید که هیچکس مبدأ واقعی آن را نمیداند. رأی دادگاه استیناف هیچیک از این بحرانها را برطرف نکرد و باید در انتظار سیل جدیدی از پروندههای حقوقی در حوزه متنباز باشیم که مناقشات تاریخی لینوکس در برابر آن شبیه به جریمه پارک ممنوع به نظر برسد.
علاوه بر این، چالش تازه دیگری نیز نمایان شده است: یک دادخواست ضد انحصار فدرال علیه آنتروپیک، اوپنایآی، اسپیسایکس/xAI و گوگل به ثبت رسیده است. شاکیان مدعی هستند که این شرکتها برای کند کردن عمدی روند توسعه سیستمهای هوش مصنوعی پیشرفته با یکدیگر تبانی و هماهنگی کردهاند.
این دادخواست به اظهارات عمومی رهبران هوش مصنوعی اشاره دارد که همگی در برههای مشترک خواستار هماهنگی برای «تنظیم سرعت» توسعه مدلهای هوش مصنوعی مرزی (Frontier AI) شده بودند. داریو آمودی (Dario Amodei)، مدیرعامل آنتروپیک، از ضرورت هماهنگی همگانی برای کاهش سرعت توسعه سخن گفته بود و سم آلتمن مدیرعامل اوپنایآی، دمیس هاسابیس همبنیانگذار گوگل دیپمایند و ایلان ماسک نیز دیدگاههای مشابهی درباره ضرورت مهار و استقرار محتاطانه سیستمهای قدرتمند هوش مصنوعی مطرح کردهاند.
در نگاه اول، چنین مطالبهای منطقی به نظر میرسد؛ چراکه ایمنی هوش مصنوعی یک مسئله کاملاً واقعی و جدی است. اما تفاوت بسیار بزرگی وجود دارد میان دغدغه ایمنی با این وضعیت که تمام بازیگران اصلی هوش مصنوعی پشت درهای بسته بر سر سرعت رشد و توسعه کل بازار با یکدیگر توافق کنند.
این وضعیت بهشدت شبیه به آن است که رقبای اصلی تصمیم بگیرند چه کسی اجازه رقابت دارد، چه محصولاتی باید ساخته شوند و زمان عرضه آنها کی خواهد بود. در این سناریو، غولهای هوش مصنوعی ژست انساندوستانه و نگران برای ایمنی به خود میگیرند، در حالی که همزمان گلوی رقبای کوچکتر را میفشارند.
شاید در نگاه نخست، اثبات این اتهام ساده به نظر برسد، اما در واقعیت اینگونه نیست. قوانین ضد انحصار به مدارک روشن مبنی بر تبانی و ایجاد آسیب واقعی به فضای رقابت نیاز دارند و صرفاً تکرار مواضع عمومی مشابه توسط مدیران ارشد برای محکومیت کافی نیست. بنابراین شاکیان برای پیروزی در دادگاه به مستنداتی بسیار فراتر از چند نقلقول درباره ایمنی هوش مصنوعی یا توسعه مسئولانه نیاز خواهند داشت.
از طرفی، حتی اگر شاکیان در این پرونده پیروز شوند، چه دستاوردی حاصل خواهد شد؟ در گذشته نیز آنچه پیروزیهای عظیم ضد انحصار به شمار میرفت، هنگام اجرای مجازاتهای واقعی کاملاً بیخاصیت شد؛ همانند پروندههای مربوط به کسبوکار تبلیغاتی گوگل یا ماجرای موتور جستجوی گوگل که با مصالحه و بدون جریمه بنیادین فیصله یافت.
آیا الگوی تکرارشونده در این ماجراها را مشاهده میکنید؟
غولهای هوش مصنوعی عملاً بر این باورند که قوانین کپیرایت، مجوزهای متنباز و مقررات ضد انحصار نباید سد راه پیشرفت آنها شود. هرگاه پدیدآورندگان و نویسندگان اعتراض میکنند، پاسخ میشنوند که آموزش مدل مصداق استفاده منصفانه است؛ هرگاه توسعهدهندگان اعتراض دارند، ادعا میشود کد تولیدشده اثری جدید است؛ و زمانی که رقبا معترض میشوند، ایمنی فناوری بهانهای میشود تا بزرگترین شرکتها بازار را میان خود هماهنگ کنند.
بسیار عجیب و تأملبرانگیز است که حاصل تمام این توجیهها، همیشه این است که دادهها، بازار و کوه درآمدهای سرشار فقط در اختیار غولهای هوش مصنوعی باقی بماند.
مسئله اصلی این نیست که آیا هوش مصنوعی باید توسعه یابد یا خیر؛ این فناوری به مسیر خود ادامه خواهد داد. مسئله اصلی این است که آیا شرکتهای سازنده این سیستمها باید مجاز باشند با دسترنج و آثار دیگران مانند مواد اولیه رایگان رفتار کنند و سپس با محصولات نهایی خود، ترافیک، درآمد و قدرت چانهزنی همان پدیدآورندگان را به تصاحب خود درآورند؟
اگر جلوی این غارت گسترده توسط پردازندههای گرافیکی غولهای فناوری گرفته نشود، در نهایت تنها مشتی میلیاردر و تریلیونر از هوش مصنوعی سود خواهند برد و مابقی جامعه به رعیتهایی در نظام فئودالیِ پساصنعتی قرن بیستویکم بدل خواهند شد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
خیز بزرگ چین برای تقویت هوش مصنوعی با راهاندازی شرکت دولتی «گروه ملی داده»
دولت چین با راهاندازی شرکت دولتی «گروه ملی داده» در منطقه شیونگآن، گام راهبردی تازهای برای یکپارچهسازی منابع اطلاعاتی کشور برداشت. این مجموعه با هدف از بین بردن جزیرههای داده و تقویت زیرساختهای هوش مصنوعی فعالیت خواهد کرد تا وابستگی پکن به فناوریهای خارجی کاهش یابد.
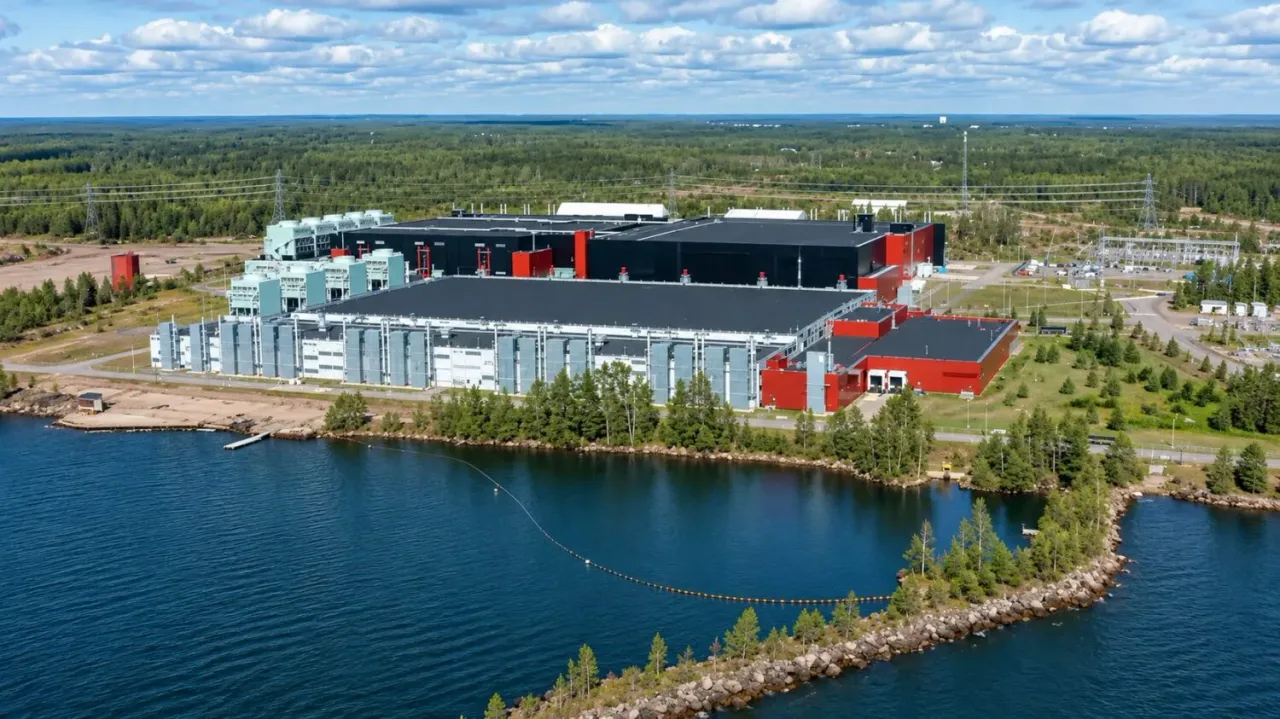
یکچهارم مراکز داده جهان در مناطق دچار تنش آبی قرار دارند؛ چالش بزرگ توسعه هوش مصنوعی
پژوهشی جدید نشان میدهد ۲۵ درصد از مراکز داده دنیا در مناطقی احداث شدهاند که با تنش آبی روبهرو هستند؛ رقمی که با تشدید گرمایش زمین ممکن است به یکسوم افزایش یابد. این یافته حاکی از آن است که رشد شتابان هوش مصنوعی و خدمات ابری، فشار مضاعفی بر منابع آب شرب و کشاورزی وارد میکند.
کیندلینگ با فشردهسازی مدل ۷۴۴ میلیاردی GLM-5.3 اجرای آن را روی کلاسترهای محدود ممکن کرد
استارتاپ Kindling AI نسخه پیشنمایش بسته کوانتایز مدل ۷۴۴ میلیارد پارامتری GLM-5.3 را با فرمت EXLR8 v2 منتشر کرد. این راهکار به کلاسترهای سختافزاری محدود مانند نودهای GB10 انویدیا اجازه میدهد این مدل غولپیکر را با پهنای باند کمتر و سرعت بالاتر اجرا کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.