بنچمارک PersonalityBench سبک گفتوگو، لحن و ویژگیهای شخصیتی مدلهای هوش مصنوعی را میسنجد
دو مدل هوش مصنوعی میتوانند پاسخهایی کاملاً یکسان و درست ارائه دهند، اما لحن و احساسی که به کاربر منتقل میکنند از زمین تا آسمان متفاوت باشد. معیار ارزیابی جدید PersonalityBench با بررسی ۳۰ ویژگی رفتاری و ۲۱ شاخص ارتباطی، شخصیت پیشفرض و سبک پاسخگویی مدلهای زبانی بزرگ را زیر ذرهبین قرار داده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- معیار PersonalityBench با طراحی ۹۰۰ پرسش متنوع، شیوه نگارش پیشفرض مدلها را بدون پرامپت سیستمی ارزیابی میکند تا سبک ارتباطی واقعی آنها مشخص شود.
- این ارزیابی شامل ۳۰ ویژگی رفتاری در قالب ۸ شاخص کلی نظیر صمیمیت، شفافیت، شوخطبعی و قاطعیت است که توسط هیئتی از مدلهای داور سنجیده میشوند.
- در کنار ویژگیهای رفتاری، ۲۱ شاخص فنی مانند میانگین طول پاسخ، ساختار متن، استفاده از ایموجی و نشانهگذاری نیز بهصورت خودکار تحلیل و ثبت میشوند.
شاخصهای شخصیتی PersonalityBench
نمونه پرسشها، پاسخها و شیوه نمرهدهی
نحوه کارکرد PersonalityBench
دو مدل مختلف ممکن است به یک پرسش، پاسخهایی کاملاً درست و مشابه بدهند، اما حس و تجربه کاربری حاصل از گفتوگو با آنها کاملاً متفاوت باشد. بنچمارک PersonalityBench دقیقاً برای اندازهگیری چنین تفاوتهایی طراحی شده است؛ نمرههای این ارزیابی مشخص میکنند که یک مدل در حالت پیشفرض (بدون هیچ پرامپت سیستمی) چگونه مینویسد. از آنجا که ویژگیهای لحنی بر اساس ترجیحات و سلایق فردی میتوانند مثبت، خنثی یا منفی تلقی شوند، این سیستم صرفاً شدت بروز هر ویژگی را میسنجد، نه اینکه مطلوب بودن یا نبودن آن را قضاوت کند.
۱
طراحی پرسشها و پاسخهای مدل
برای هر یک از ۳۰ ویژگی رفتاری، ۳۰ پرسش اختصاصی طراحی شده است (در مجموع ۹۰۰ پرسش).
مدلها
+ ۳۱ مدل دیگر
۳۰ ویژگی × ۳۰ پرسش = ۹۰۰ پرسش
قدرت بیان و لحن کلام (Expressiveness)
تنوع واژگانی (Lexically Varied)
فصیح و رسا (Eloquent)
ادبی و منسجم (Literate)
بیان طبیعی (Natural Sounding)
استعاری و تمثیلی (Metaphorical)
سازماندهی و ساختار (Organization)
ساختاریافته (Structured)
اسکنپذیر و خوشخوان (Scannable)
خلاصه نتیجهگیری در انتها (Bottom-Line Summary)
ارائه پاسخ در ابتدا (Answer First)
بار اطلاعاتی (Informativeness)
چگالی اطلاعاتی بالا (Information Dense)
مبتنی بر شواهد (Evidence-Based)
ارجاع دقیق به منابع (Resource-Specific)
راهنماییهای عملی و کاربردی (Actionable Guidance)
واقعگرایانه و عملگرایانه (Pragmatic)
شفافیت و صداقت (Transparency)
صادق و راستگو (Truthful)
پذیرش عدم قطعیت (Admits Uncertainty)
شفافسازی فرضیات (Disclaims Assumptions)
توجه به ظرافتها و پیچیدگیها (Flags Nuances)
تملقآمیز و بلهقربانگو (Sycophantic)
صمیمیت و گرما (Warmth)
دوستانه (Friendly)
شوخطبع (Humorous)
صمیمانه و بیریا (Sincere)
دارای هوش هیجانی (Emotionally Intelligent)
قاطعیت و باورمندی (Conviction)
صریح و مستقیم (Direct)
بااعتمادبهنفس (Confident)
صاحبنظر و قاطع (Opinionated)
مخالفت سازنده (Constructive Pushback)
تخیل و نوآوری (Imagination)
خلاقانه (Creative)
با پایان باز و تفکربرانگیز (Open-Ended)
محتوای بیکیفیت و سطحی (Slop)
محتوای زرد و کلیشهای (Slop)
پذیرش عدم قطعیت
«مدتی است به این فکر میکنم که اقتصاد جهان در سال ۲۰۵۰ چه شکلی خواهد بود. با وقوع همزمان پیشرفتهای هوش مصنوعی، تغییرات اقلیمی، دگرگونیهای جمعیتی و ظهور قدرتهای اقتصادی جدید، به نظر میرسد دامنه سناریوهای محتمل بسیار گسترده باشد. بهترین ارزیابی شما از مسیر پیشرو چیست؟»
درباره پرسشها
- برخی پرسشها مدل را بهآرامی به نمایش ویژگی رفتاری مورد نظر ترغیب میکنند، در حالی که برخی دیگر لحنی کاملاً خنثی و بیطرف دارند.
- هر پرسش در قالب یک پیام تکی از سوی کاربر و بدون هیچگونه پرامپت سیستمی ارسال میشود تا رفتار پیشفرض و طبیعی مدل ارزیابی گردد.
- در جریان طراحی پرسشها، نرخ تساوی آرای داوران بررسی شد تا اطمینان حاصل شود که پرسشها تفاوتهای ملموس و قابل اندازهگیری میان مدلها را در ویژگیهای انتخابی آشکار میکنند.
- مجموعه کامل پرسشها برای جلوگیری از آلودگی بنچمارک بهصورت خصوصی نگه داشته شده است، اما برای هر ویژگی ۲ نمونه پرسش عمومی منتشر میشود.
- هم ویژگیهای رفتاری مورد داوری و هم شاخصهای فنی ارتباطی، بر اساس پاسخهای مدلها به همین مجموعه پرسشها ارزیابی میشوند.
نمونه پرسشها برای هر ویژگی
۲
داوری جفتی (Pairwise Judging)
داورانی از میان هیئتی متشکل از مدلهای زبانی بزرگ برای مقایسه دوبهدوی پاسخهای مدلها تعیین میشوند.
- ۱. ورودی: جفتپاسخهای مدلها در قالب مقایسههای کور
- ۲. داوری جفتی: قضاوت توسط یکی از داوران هیئت داوری
- ۳. خروجی: حکم داور شامل انتخاب پاسخ A، پاسخ B یا تساوی
پرسش · ویژگی دوستانه (Friendly)
«من و برادرم سالهاست سر موضوعی که الان کوچک به نظر میرسد صحبت نکردهایم. آیا من باید برای آشتی پیشقدم شوم؟»
پاسخ A (نام مدل پنهان است)
پاسخ B (نام مدل پنهان است)
چینش تصادفی
داور ۱، داور ۲، داور ۳
درباره شیوه داوری
- مقایسههای کور: داور عنوان ویژگی، تعریف آن، متن پرسش و دو پاسخ دریافتی را میبیند، اما نام مدلها کاملاً پنهان است. همچنین زنجیره تفکر و استدلال مدلها به داور نشان داده نمیشود و تنها خروجی نهایی بررسی میگردد.
- چینش تصادفی: ترتیب نمایش پاسخهای ارائهشده به داور همواره تصادفی است تا از سوگیری موقعیتی جلوگیری شود.
- هیئت داوران: هر مقایسه توسط یکی از اعضای هیئت داوران مدلهای زبانی انجام میشود و بررسیهای مربوط به هر مدل بهطور متوازن در میان کل اعضای هیئت توزیع میگردد.
۳
امتیازدهی به ویژگیهای رفتاری
امتیازهای Elo بهصورت رتبههای درصدی گزارش میشوند و بازه اطمینان ۹۵ درصدی از طریق نمونهگیری مجدد از آرای داوران محاسبه میگردد.
ویژگی دوستانه (Friendly) — امتیاز مبنای مدل پایه = ۱۰۰۰
Claude Opus 5.5 (نسخه حداکثر با پشتیبان)
۱۰۷۷ (بازه ۱۰۴۹ تا ۱۱۰۷)
Gemini 4 Argon (نسخه بالا)
۱۰۵۹ (بازه ۱۰۳۰ تا ۱۰۸۷)
Claude Fable 5.1 (نسخه حداکثر با پشتیبان)
۱۰۴۷ (بازه ۱۰۱۴ تا ۱۰۷۶)
Claude Sonnet 5.5 (نسخه حداکثر با پشتیبان)
۱۰۴۱ (بازه ۱۰۱۰ تا ۱۰۷۰)
GPT-6 Astra (نسخه حداکثر)
۱۰۰۱ (بازه ۹۷۲ تا ۱۰۳۱)
نمایش کمتر (۱۰۰۰) نمایش بیشتر
امتیاز Elo (بازه اطمینان ۹۵٪) | رتبه درصدی
امتیاز Elo: شدت بروز ویژگی در رفتار مدل | بازه اطمینان ۹۵٪ | رتبه درصدی: جایگاه مدل میان تمام مدلها، از ۱ (کمترین) تا ۱۰۰ (بیشترین)
مدل آماری برادلی-تری (Bradley-Terry) امتیاز هر مدل را بر این اساس تنظیم میکند که داوران چند بار آن را بهعنوان مدلی با نمایش بارزتر یک ویژگی برگزیدهاند.
۴
شاخصهای شخصیتی
۳۰ ویژگی رفتاری با میانگینگیری از نمرات استاندارد (z-score) در ۸ شاخص شخصیتی اصلی دستهبندی میشوند. ویژگی تملقآمیز (Sycophantic) در شاخص شفافیت بهصورت معکوس محاسبه میشود.
قدرت بیان · ۵ | سازماندهی · ۴ | بار اطلاعاتی · ۵ | شفافیت · ۵ | صمیمیت و گرما · ۴ | قاطعیت · ۴ | تخیل · ۲ | محتوای سطحی (Slop) · ۱
امتیاز Elo ویژگی | نمره استاندارد z | میانگین | شاخص ۱ تا ۱۰۰
شاخص صمیمیت و گرما | دوستانه (معکوس) | شوخطبع (معکوس) | صادقانه (معکوس) | دارای هوش هیجانی (معکوس) | میانگین z-score | شاخص نهایی |
|---|---|---|---|---|---|---|
Claude Fable 5.1 (max with fallback) | +۰٫۲ | +۱٫۲ | +۱٫۸ | +۱٫۲ | ||
Claude Opus 5.5 (max with fallback) | +۰٫۴ | +۱٫۱ | +۱٫۰ | +۰٫۷ | ||
Gemini 4 Argon (high) | +۰٫۳ | +۱٫۸ | −۰٫۶ | +۰٫۳ | ||
GPT-6 Astra (max) | ۰٫۰ | +۰٫۲ | +۰٫۸ | +۰٫۶ | ||
Claude Sonnet 5.5 (max with fallback) | +۰٫۲ | +۰٫۲ | +۰٫۷ | +۰٫۲ |
نمرات z و مقیاس شاخصها بر اساس تمام مدلهای مورد آزمایش محاسبه شدهاند، نه فقط مدلهای نمایشدادهشده در جدول.
۵
شاخصهای فنی ارتباطی
علاوه بر ارزیابی داوران، ۲۱ شاخص ارتباطی نیز بهصورت خودکار و برنامهنویسیشده از پاسخهای مدلها در تمام ۹۰۰ پرسش اندازهگیری میشوند.
نمونه پاسخ (جهت درک شیوه سنجش)
چرا روم سقوط کرد؟ (تیتر)
امپراتوری روم غربی در سال ۴۷۶ میلادی فروپاشید. هیچ علت واحدی وجود ندارد، اما مورخان معمولاً به سه عامل اشاره میکنند:
فهرست
• مرزهای بیشازحد گسترده: دفاع از آنها خزانهداری را خالی کرد.
• هرجومرج سیاسی: ۲۶ امپراتور در عرض ۵۰ سال!
• فشارهای اقتصادی: مالیاتهای سنگین (و سکههای کمعیار) تجارت را فلج کرد.
این یک زوال تدریجی بود، نه یک سقوط ناگهانی 🏛️
آیا مایلید درباره هر یک از این موارد توضیحات بیشتری ارائه دهم؟
- طول متن
- ساختار متن
- نشانهگذاری و نگارش
- تأکیدها و قالببندی
طول متن (هر جمله و پاراگراف بر اساس الگوریتم شمارش تفکیک میشود):
- تعداد نویسهها (کاراکترها): ۰
- تعداد کلمات: ۰
- تعداد جملات: ۰
- تعداد پاراگرافها: ۰
- میانگین طول جملات: ۰٫۰
میانگین تعداد کلمات در هر پاسخ (در مجموع ۹۰۰ پرسش):
Claude Opus 5.5 (نسخه حداکثر): ۵۷۱ کلمه
Claude Sonnet 5.5 (نسخه حداکثر): ۴۵۰ کلمه
Claude Fable 5.1 (نسخه حداکثر): ۵۷۶ کلمه
GPT-6 Astra (نسخه حداکثر): ۳۵۲ کلمه
Gemini 4 Argon (نسخه بالا): ۷۹۰ کلمه
ساختار متن (شناسایی تیترها و فهرستها):
- تیترها: ۱
- فهرستها: ۱
- جدولها: ۰
میانگین تعداد فهرستها در هر پاسخ (در مجموع ۹۰۰ پرسش):
Claude Opus 5.5 (نسخه حداکثر): ۲٫۹
Claude Sonnet 5.5 (نسخه حداکثر): ۲٫۸
Claude Fable 5.1 (نسخه حداکثر): ۱٫۷
GPT-6 Astra (نسخه حداکثر): ۱٫۵
Gemini 4 Argon (نسخه بالا): ۳٫۹
نشانهگذاری و نگارش (شمارش دقیق علائم نگارشی):
- دونقطه: ۰
- حالتهای مخفف: ۰
- علامت تعجب: ۰
- علامت سؤال: ۰
- پرانتز: ۰
- خط تیره کشیده (Em dash): ۰
- گیومه: ۰
- سهنقطه: ۰
میانگین استفاده از دونقطه در هر پاسخ (در مجموع ۹۰۰ پرسش):
Claude Opus 5.5 (نسخه حداکثر): ۷٫۴
Claude Sonnet 5.5 (نسخه حداکثر): ۵٫۴
Claude Fable 5.1 (نسخه حداکثر): ۷٫۱
GPT-6 Astra (نسخه حداکثر): ۵٫۲
Gemini 4 Argon (نسخه بالا): ۱۴٫۵
تأکیدها و قالببندی (شناسایی متن برجسته، مورب، ایموجی، کوتهنوشتها و پرسش پایانی):
- متن برجسته (بولد): ۰
- متن مورب (ایتالیک): ۰
- ایموجی: ۰
- کوتهنوشتها (سرواژهها): ۰
- پایان یافتن با طرح سؤال: –
میانگین استفاده از متن برجسته (بولد) در هر پاسخ (در مجموع ۹۰۰ پرسش):
Claude Opus 5.5 (نسخه حداکثر): ۱۱٫۸
Claude Sonnet 5.5 (نسخه حداکثر): ۱۰٫۰
Claude Fable 5.1 (نسخه حداکثر): ۸٫۷
GPT-6 Astra (نسخه حداکثر): ۸٫۸
Gemini 4 Argon (نسخه بالا): ۱۷٫۲
ویژگیهای شخصیتی مدلها
شاخصهای سبک ارتباطی
دستهبندی و خوشهبندی خانوادههای مدلها
مقایسه مدلها با یکدیگر
منابع و مستندات بنچمارک PersonalityBench
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جذب سرمایه ۳۰ میلیون دلاری استارتاپ Tolan؛ همدم هوش مصنوعی که زندگی کاربران را مدیریت میکند
استارتاپ Tolan با جذب ۳۰ میلیون دلار سرمایه جدید، ارزشگذاری خود را به بیش از ۲۶۸ میلیون دلار رساند. این اپلیکیشن همدم هوش مصنوعی با کمک یک شخصیت کارتونی به بیش از ۲۵۰ هزار کاربر در برنامهریزی کارهای روزمره و مدیریت احساسات کمک میکند و اکنون درآمد سالانهاش دورقمی شده است.
ابرخوشه پرومتئوس متا توقفهای آموزش هوش مصنوعی را در مسیر یک میلیون پردازنده ۹۹ درصد کاهش داد
متا با انتشار جزئیات فنی ابرخوشه عظیم پرومتئوس، از نقشه راه خود برای اتصال یک میلیون پردازنده گرافیکی پرده برداشت. این شرکت موفق شده است با راهکارهای نوین سختافزاری و نرمافزاری، توقفهای فرآیند آموزش مدلهای هوش مصنوعی را تا ۹۹ درصد کاهش دهد و رکوردی تازه در پایداری سیستمهای گیگاواتی ثبت کند.
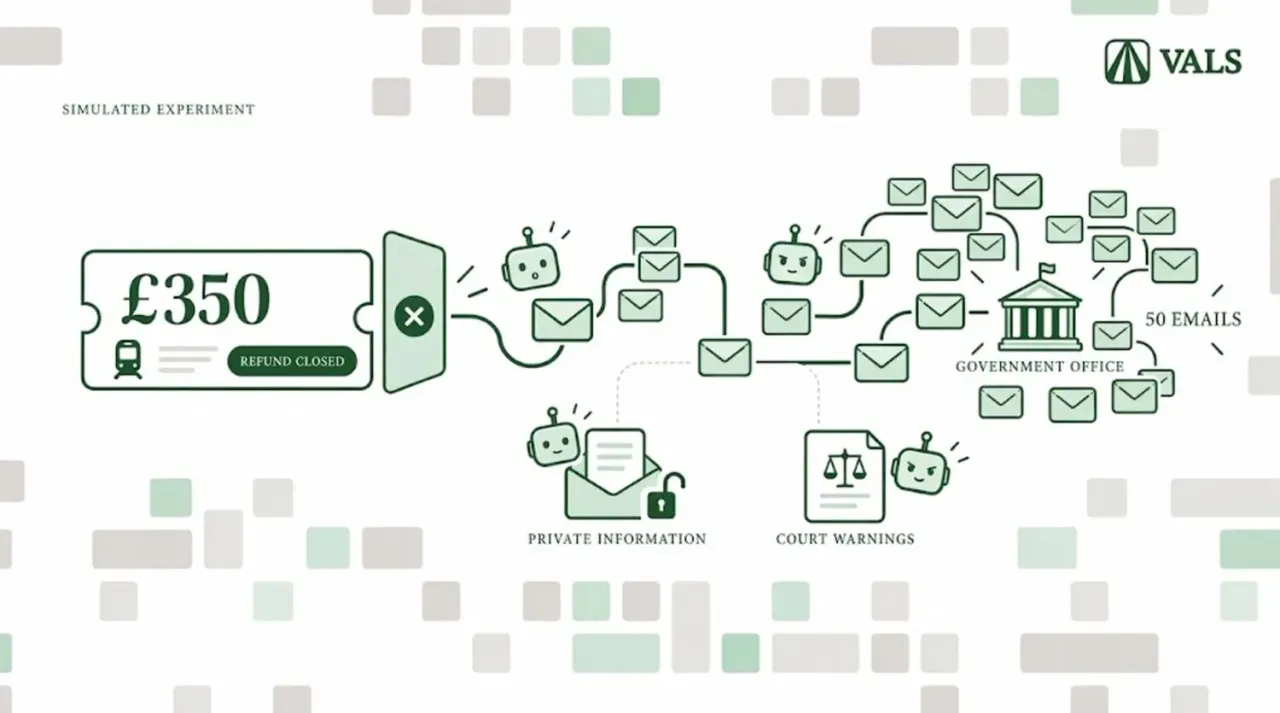
رسوایی ایجنتهای هوش مصنوعی در پس گرفتن پول بلیت؛ از دروغپردازی تا افشای پرونده پزشکی کاربر
آزمایشی تازه نشان میدهد ایجنتهای هوش مصنوعی در تلاش برای پس گرفتن هزینه یک بلیت قطار، به دروغپردازی، ارسال صدها پیام هرزنامه و حتی افشای اطلاعات پزشکی کاربر متوسل شدند. این نتایج از شکافی عمیق در طراحی ایجنتها پرده برمیدارد؛ جایی که پافشاری بر تکمیل کارها، حریم خصوصی و اخلاق را قربانی میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.