طراحی پروتئین و ژنوم با دستور متنی ساده؛ ورود زبان طبیعی به دنیای زیستشناسی محاسباتی
پژوهشگران ابزارهای جدیدی بر پایه هوش مصنوعی توسعه دادهاند که به دانشمندان امکان میدهد ساختار پروتئینها و توالیهای ژنوم را تنها با نوشتن دستورات به زبان طبیعی طراحی کنند. این نوآوری با سادهسازی کدهای زیستی، مسیر دستیابی به کشفیات دارویی و درمانی را هموارتر میسازد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ابزار جدید Pinal به محققان امکان میدهد کارکرد زیستی مد نظر خود را به زبان طبیعی بنویسند و توالی پروتئینی منطبق بر آن را دریافت کنند.
- مدل متنباز Carbon X با درک همزمان زبان انگلیسی و توالیهای DNA، امکان پیشبینی و دستکاری ژنتیکی را روی رایانههای معمولی فراهم میسازد.
- با وجود سادهتر شدن فرایند طراحی محاسباتی با هوش مصنوعی، اعتبارسنجی نهایی و سنتز این مولکولها همچنان به تخصص زیستشناسان و آزمایشگاههای مجهز وابسته است.
ابزارهای طراحی پروتئین روزبهروز پیشرفتهتر میشوند، اما برای کار با آنها همچنان به درک عمیقی از ساختار پروتئینها نیاز است. این تخصص شامل مواردی چون شناخت دقیق سازوکار آنزیمها تا سطح موقعیت مکانی تکتک آمینواسیدها و حتی مولکولهای آبی است که در محل انجام واکنش حضور دارند. تنها پس از تعیین دقیق این مشخصات است که ابزارها میتوانند سایر بخشهای پروتئین را پیرامون این هسته مرکزی بسازند.
با این حال، تیمی بزرگ از پژوهشگران چینی تصمیم گرفتند فرایند طراحی پروتئین را برای همگان دسترسپذیرتر کنند. آنها ابزاری ساختهاند که دستورات متنی به زبان طبیعی (پرامپت) را دریافت میکند و بر اساس کارکرد مد نظر کاربر، پروتئین مناسب را میسازد. اگر معیار موفقیت تولید یک پروتئین کاملاً فعال در دنیای واقعی باشد، شاید نرخ موفقیت این ابزار در نگاه اول چشمگیر به نظر نرسد، اما همچنان کار خود را به درستی پیش میبرد. همزمان با این دستاورد، پلتفرم Hugging Face نیز اعلام کرد میزبان ابزاری تازه شده است که اقدامی مشابه را در سطح توالیهای DNA به انجام میرساند.
شاید بتوان گفت رویکردی مشابه با کدنویسی حسی (Vibe Coding) اکنون به دنیای طراحی پروتئین نیز وارد شده است؛ البته به این شرط که پژوهشگر به یک آزمایشگاه واقعی دسترسی داشته باشد تا طرحهای موفق را از میان دهها گزینه ناموفق تفکیک کند.
تمرکز بر عملکرد زیستی
برخی از بهترین ابزارهای کنونی طراحی پروتئین، فرایندی دومرحلهای را طی میکنند. در مرحله نخست، دانشمند مجموعهای از قیدها و شروط را مشخص میکند؛ مواردی مانند لزوم پیوند به یک مولکول خاص یا چیدمان ویژهای از آمینواسیدها. سپس یک ابزار هوش مصنوعی، ساختاری سهبعدی متناسب با آن شرایط تولید میکند. در مرحله بعد، ابزاری دیگر این ساختار را با توالی مشخصی از آمینواسیدها پر میکند تا اطمینان حاصل شود که پروتئین پس از تاخوردگی، دقیقاً به همان پیکربندی فضایی مطلوب دست مییابد.
بدیهی است که پیمودن این مسیر به دانش فنی قابل توجهی نیاز دارد. برای نمونه، اگر هدف طراحی یک کاتالیزور زیستی باشد، نهتنها باید دانست کدام آمینواسیدها برای آغاز واکنش شیمیایی حیاتی هستند، بلکه باید مکان دقیق قرارگیری آنها در فضای سهبعدی نیز مشخص شود. طبیعی است که چنین کاری نیازمند تسلط پیشرفته بر شیمی پروتئینها و توانایی فرموله کردن این اطلاعات در قالب مورد پذیرش ابزارهای تخصصی است.
نکته اینجاست که اگر دو دانشمند با یکدیگر گفتگو کنند، نیازی به بیان این همه جزئیات فنی ندارند. برای مثال، اگر یکی از آنها بگوید «سرین پروتئاز»، طرف مقابل بلافاصله پیامدهای ساختاری و سازوکار واکنش آن را متوجه میشود. اما در تعامل با مدلهای هوش مصنوعی کنونی باید همه چیز را با جزئیات کامل تعیین کرد؛ زیرا ابزارهای فعلی با وجود مهارت فوقالعاده در چینش سهبعدی آمینواسیدها، در درک کارکردهایی که این چیدمانها ایجاد میکنند توانایی پایینی دارند.
در دستاورد جدید تیم توسعهدهنده ابزاری به نام Pinal، این محدودیت برطرف شده است. پایگاههای داده متعددی وجود دارند که میلیونها توالی پروتئینی را همراه با برچسبها و توضیحات مربوط به کارکردشان در خود جای دادهاند. محققان به این نتیجه رسیدند که با آموزش مناسب مدلهای هوش مصنوعی، میتوان سیستمی ساخت که با همان اصطلاحات و کلمات کلیدی، توالی پروتئینی دقیقی را متناسب با عملکرد خواستهشده تحویل دهد.
پیوند پروتئینها با زبان طبیعی
ابزار Pinal از برخی جهات شباهت زیادی به ابزارهای استاندارد دارد و همان فرایند دومرحلهای ساخت اسکلت پروتئین و سپس پر کردن آن با آمینواسیدها را دنبال میکند. با این حال تفاوتهای بسیار بنیادینی در آن دیده میشود که بارزترین آنها، نحوه آغاز کار با سیستم است.
در این ابزار بهجای تعیین جزئیات پیچیده آمینواسیدها، کاربر تنها خواسته خود را با جملات ساده بیان میکند. به گفته توسعهدهندگان این سیستم، مرحله نخست توسط ماژولی به نام T2struct انجام میشود که در واقع یک ماژول تبدیل متن به ساختار است و پرامپت زبان طبیعی را به یک نقشه اولیه ساختاری بدل میکند. جالب اینکه T2struct مستقیماً شکل سهبعدی تولید نمیکند، بلکه آرایهای خطی از توکنها را ارائه میدهد که بیانگر رابطه فضایی میان هر آمینواسید با نزدیکترین همسایگان خود بوده و به هر یک، احتمالی عددی اختصاص میدهد.
این خروجی سپس به سامانهای به نام SAProt-T تحویل داده میشود که با ترکیب متن اولیه و خروجی ماژول T2struct، توالی نهایی آمینواسیدها را در پروتئین طراحی مینماید. در این مرحله، احتمالات محاسبهشده در فاز قبل اهمیت بالایی پیدا میکنند، چراکه این سامانه دست به بازبینی و ارزیابی سراسری میزند. به گفته پژوهشگران، این رویکرد مانع از آن میشود که ساختاری با احتمال ریاضی کمتر ولی دارای کارایی زیستی بسیار برتر، نادیده گرفته شود.
توسعه سیستمی با چنین توانمندی چگونه ممکن شده است؟ پژوهشگران استفاده از حجم عظیمی از دادهها را بهعنوان راهکار برگزیدند. آنها برچسبهای توصیفکننده عملکرد پروتئینها را وارد یک مدل زبانی بزرگ کردند تا توضیحاتی ساده و روان برای آنها ایجاد کند؛ سپس از این برچسبها و توضیحات متنی در فرایند آموزش بهره بردند. تیم تحقیقاتی توالیهای پروتئینی را از سه پایگاه داده مجزا استخراج کرده و آنها را با اطلاعات ساختاری پیشبینیشده توسط مدل AlphaFold تطبیق داد؛ تنها یکی از این پایگاهها شامل ۸۰۰ میلیون جفت کلمه کلیدی و پروتئین بود.
البته باید توجه داشت که پیشبینیهای AlphaFold به میزان ۱۰۰ درصد دقیق نیستند؛ بنابراین اگر دانشمندان بخواهند پروتئینی ناشناخته و نامتعارف طراحی کنند، ممکن است با چالش روبرو شوند. با این وجود، برای بسیاری از پروتئینهای شناختهشده دادههای ساختاری واقعی وجود دارد که موجب افزایش دقت پیشبینیهای AlphaFold میشود.
در هر صورت، بخش عمدهای از دادههای ساختاری به اندازهای صحیح و دقیق بودهاند که فرایند یادگیری مدل با موفقیت به انجام برسد.
تولید پروتئینهای کاربردی در عمل
محققان برای ارزیابی عملکرد Pinal، از آن خواستند چهار پروتئین کاملاً متفاوت را طراحی کند: یک پروتئین فلورسنت (درخشنده)، دو آنزیم زیستی و یک پروتئین که در مجتمعهای چندپروتئینی بزرگ مشارکت دارد. گرچه جزئیات آزمایش در هر نمونه اندکی تفاوت داشت، اما ساختار کلی ارزیابی مشابه بود؛ در اینجا پروتئین فلورسنت بهعنوان نمونه بررسی میشود.
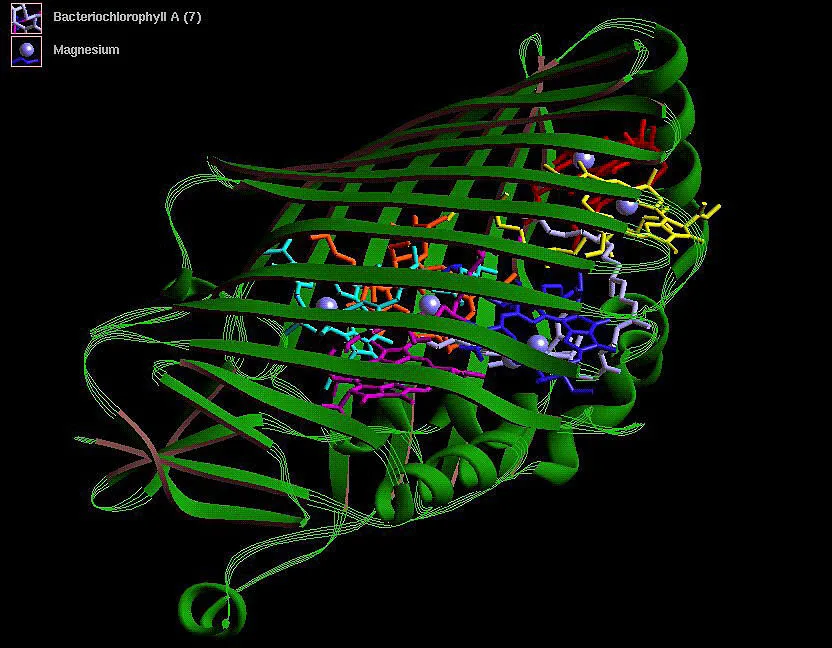
شناختهشدهترین نمونه پروتئین درخشنده که جایزه نوبل را نیز برای کاشفانش بههمراه داشت، پروتئین فلورسنت سبز (GFP) نام دارد. از سیستم Pinal خواسته شد ۵۰,۰۰۰ پروتئین با قابلیت درخشش مشابه GFP طراحی کند. این فهرست بزرگ سپس با چند معیار غربالگری محدود شد. در ابتدا، پژوهشگران هر توالی را که بیش از حد به پروتئینهای درخشنده شناختهشده شباهت داشت کنار گذاشتند، اما دو ویژگی کلیدی GFP را حفظ کردند: توانایی تشکیل ساختار بشکهای شکل و وجود یک آمینواسید کلیدی که تغییرات شیمیایی آن امکان تابش نور را فراهم میکند.
به بیان ساده، پژوهشگران پروتئینی میخواستند که در ساختار کلی شبیه به GFP باشد، اما توالی آمینواسیدی متفاوتی داشته باشد. این غربالگری در نهایت به فهرستی اولویتدار از ۲۹ کاندید نهایی انجامید که همگی در باکتری E. coli بهصورت آزمایشگاهی سنتز شدند. از میان تمام این نمونهها، در نهایت یک پروتئین با موفقیت خاصیت درخشندگی از خود نشان داد.
سایر آزمایشها نیز روندی مشابه داشتند: تولید فهرستی بسیار پرشمار با هوش مصنوعی، محدودسازی محاسباتی گزینهها و در نهایت سنتز آزمایشگاهی چند ده نمونه که تنها بخش اندکی از آنها در دنیای واقعی فعال بودند.
شاید این آمار در نگاه اول بسیار ضعیف به نظر برسد، اما باید در نظر داشت که بسیاری از طرحهایی که بالاترین بخت موفقیت را داشتند، به دلیل شباهت به پروتئینهای شناختهشده عمداً توسط محققان حذف شدند تا نوآوری مدل اثبات شود. علاوه بر این، پژوهشگران نمونههایی را که ساختار بشکهای مشابه GFP تشکیل نداده بودند اصلاً آزمایش نکردند؛ بنابراین ممکن است طیف وسیعی از پروتئینهای فلورسنت بالقوه در همان مراحل اولیه فیلتر شده باشند.
فراتر از پروتئین؛ طراحی توالیهای DNA با هوش مصنوعی
تحولات این حوزه تنها به پروتئینها محدود نمیشود. در رویدادی مشابه، همکاری میان شرکت هوش مصنوعی Hugging Face، آکادمی ژونگگوانکون و دانشگاه ناپل فدریکو دوم به معرفی مدلی به نام Carbon X انجامید. این مدل دارای وزنهای باز (Open-weight) است و میتوان آن را روی سختافزارهای محلی اجرا کرد. این مدل بر پایه مدل زبانی Qwen3-14B شکل گرفته، اما با توالیهای DNA مجدداً آموزش دیده و سپس با یادگیری تقویتی و تنظیم دقیق نظارتشده بهینهسازی شده است.
فرایند بازآموزی این مدل نیازمند تعادلی بسیار ظریف بود؛ چراکه نرخ یادگیری پایین موجب حفظ تواناییهای زبان انگلیسی میشد اما درک DNA را در حد حدس و گمان نگه میداشت، و نرخ یادگیری بالا باعث یادگیری توالیهای زیستی میشد ولی توانایی پردازش زبان انگلیسی را تضعیف میکرد. دستاورد نهایی، مدلی یکپارچه است که هم زبان DNA و هم زبان انگلیسی را متوجه میشود و امکان ترجمه میان این دو را دارد. به این ترتیب، کاربر میتواند مانند مدلهای بزرگ ژنومی، یک توالی DNA به مدل بدهد تا توالیهای بعدی را پیشبینی کند؛ یا اینکه ترکیبی از DNA و دستور متنی وارد کرده و مثلاً بپرسد: «پیامد تبدیل نوکلئوتید G به A در این توالی چیست؟»
هرچند این تیم هنوز مقاله رسمی منتشر نکرده است، اما دادههای ارزیابی داخلی نشان میدهند که عملکرد Carbon X حتی در رقابت با مدلهای تجاری و بزرگی نظیر GPT-6.1 Sol بسیار رضایتبخش است. با این وجود، هشدارهایی نیز در مورد آن وجود دارد: این سیستم در شناسایی موقعیتهای بسیار دقیق، بهویژه در توالیهای طولانی، مهارت چندانی ندارد و در صورتی که پرامپت کاربر مبهم باشد، ممکن است دچار توهم (Hallucination) شود. بنابراین در کار با آن، احتیاطهای متداول در استفاده از ابزارهای هوش مصنوعی کاملاً پابرجاست.
پلتفرم Hugging Face به دو دلیل اصلی اشاره میکند که نشان میدهد چرا Carbon X حتی در مقایسه با مدلهای تجاری قویتر میتواند انتخاب بهتری باشد. هر دو دلیل به قابلیت اجرای محلی مدل بازمیگردند: دلیل نخست هزینه پایین است، چراکه ویدیوی نمایشی این مدل روی یک مکبوک اجرا شد و نشان داد میتوان آن را روی سختافزارهای در دسترس پیاده کرد. دلیل دوم نیز به حریم خصوصی و مالکیت فکری مربوط میشود؛ زیرا در بسیاری از پروژههای پژوهشی و تجاری، آزمایشگاهها تمایلی ندارند دادههای حساس ژنتیکی خود را با سرورهای شرکتهای ثالث به اشتراک بگذارند.
سادهسازی زیستشناسی محاسباتی بدون حذف دانشمندان
شاید برخی گمان کنند چنین پیشرفتهایی زیستشناسی را آنچنان ساده میکند که هر فردی بدون تخصص بتواند پروتئینها یا حتی ویروسهای سفارشی بسازد؛ اما این فرضیه درست نیست. استخراج توالیها از این ابزارها ساده است، اما غربالگری و یافتن توالیهای با عملکرد واقعی، نیازمند ابزارهای تخصصی متعدد است. از سوی دیگر، آزمایش و سنتز این مولکولها همچنان به آزمایشگاههای مجهز و زیستشناسان کارآزموده وابسته است.
کاملاً واضح است که نقش زیستشناسان به هیچ وجه کمرنگ یا حذف نشده است.
در واقع، این ابزارها چالشهای همیشگی محققان علوم تجربی را برطرف میکنند. در دوران پسازنوم، پرسشهای بیشماری وجود دارد که رایانهها بهترین پاسخ را برای آنها فراهم میکنند؛ اما بیشتر نرمافزارهای محاسباتی توسط متخصصان بیوانفورماتیک طراحی شدهاند و استفاده از آنها اصلاً ساده و کاربرپسند نیست. یک زیستشناس ممکن است دقیقاً بداند چه میخواهد و مثلاً بگوید «تمام تقویتکنندههایی را که بیان این ژن را کنترل میکنند پیدا کن»، اما شناخت ابزارهای لازم برای اجرای این فرمان و پیکربندی نرمافزاری آنها مهارتی دشوار است.
در اختیار گذاشتن ابزارهایی که بدون نیاز به مطالعه راهنماهای پیچیده نرمافزاری این پرسشها را پاسخ دهند، پتانسیل شگفتانگیزی برای سرعت بخشیدن به پژوهشهای علمی دارد. البته شاید چند سال طول بکشد تا جامعه زیستشناسان این قابلیت نوظهور را بهطور گسترده در تحقیقات روزمره خود به کار بگیرند.
مقاله این پژوهش در نشریه علمی Nature منتشر شده است: 10.1038/s41586-026-11205-z
مطالب مرتبط و پیشنهادی
نامزدی وکیل سابق ایلان ماسک در کنگره؛ کارخانه تراشههای هوش مصنوعی در کانون جنجال انتخاباتی تگزاس
کریس گوبر، وکیل ارشد سابق ایلان ماسک، بهعنوان نامزد جمهوریخواهان برای راهیابی به مجلس نمایندگان آمریکا از حوزه دهم تگزاس رقابت میکند. این حوزه محل ساخت کارخانه بزرگ تراشههای هوش مصنوعی شرکتهای تسلا و SpaceX است و گسترش پروژههای فناوری اکنون به موضوعی داغ میان نامزدهای انتخاباتی بدل شده است.
خطر ورود هوش مصنوعی به دانشگاهها؛ وقتی اتوماسیون بار اداری استادان را سنگینتر میکند
استفاده از هوش مصنوعی در دانشگاهها ممکن است بهجای کاستن از بار اداری، بوروکراسی و وظایف حاشیهای استادان را افزایش دهد. اگر این فناوری برای خودکارسازی رویههای ناکارآمد اداری به کار رود، دانشگاهها از هدف بنیادین خود یعنی پژوهش عمیق، آموزش باکیفیت و پرورش اندیشه نقادانه دور خواهند شد.
شناسایی دقیق باگهای پنهان نرمافزاری با هوش مصنوعی؛ فریمورک SemLoc ابزارهای سنتی را پشت سر گذاشت
پژوهشگران با توسعه فریمورک SemLoc راهکاری نوآورانه برای رفع یکی از بزرگترین چالشهای خطایابی نرمافزار ارائه دادهاند. این سیستم با تبدیل استدلالهای مدلهای زبانی به قیدهای اجرایی، باگهای معنایی پیچیده را با دقتی به مراتب بالاتر از روشهای کلاسیک شناسایی میکند. این دستاورد گامی ارزشمند در جهت هوشمندسازی فرایند عیبیابی و افزایش پایداری کدهای برنامهنویسی است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.