آیا هوش مصنوعی ایدههای علمی را میدزدد؟ آغاز جنجال دانشمندان با اوپنایآی و آنتروپیک
به اشتراک گذاشتن ایدهها و فرضیههای علمی با چتباتهای هوش مصنوعی، زنگ خطر جدی سرقت فکری و افشای اطلاعات محرمانه را به صدا درآورده است. دو مناقشه اخیر میان پژوهشگران برجسته با شرکتهای اوپنایآی و آنتروپیک نشان میدهد که تکذیبهای رسمی غولهای فناوری دیگر برای رفع نگرانیها کافی نیست و حفاظت از دستاوردهای علمی به بازنگری اساسی و شفافیت نیاز دارد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ماجرای جنجالی دو دانشمند از دانشگاههای نیویورک و کپنهاگ نشان میدهد پروژههای محرمانه آنها شباهت عجیبی به دستاوردهای بعدی اوپنایآی و آنتروپیک داشته؛ آن هم درست بعد از اینکه ایدههایشان را با چتباتها مطرح کرده بودند!
- تکذیب شرکتها خیال کسی را راحت نکرده؛ چرا که حتی با فعالسازی گزینه انصراف (Opt-out)، ثبت بازخورد یا دسترسیهای عملیاتی میتواند اطلاعات حساس را در سیستم نگه دارد.
- محققان بر سر دوراهی سختی ماندهاند: اگر از هوش مصنوعی استفاده نکنند از رقبا جا میمانند و اگر استفاده کنند، هیچ سازوکار شفافی برای اثبات مالکیت فکری دستاوردهایشان وجود ندارد.
دو اختلاف حقوقی حلنشده درباره تحقیقات علمی به اشتراک گذاشتهشده، خلأهای جدی شرکتهای هوش مصنوعی در مدیریت دادهها را زیر ذرهبین برده است؛ آن هم در شرایطی که هنوز هیچ استاندارد مستقلی برای بازرسی و حسابرسی دادهها در این صنعت وجود ندارد.
تصور کنید یک فرضیه علمی منتشرنشده را در پنجره گفتوگوی یک چتبات تجاری هوش مصنوعی تایپ میکنید، بازخورد مفیدی میگیرید و به کارتان ادامه میدهید؛ اما چند ماه بعد، همان شرکت از یک دستاورد علمی بزرگ رونمایی میکند که به طرز عجیبی برایتان آشناست! حالا دو اختلاف پژوهشی جداگانه دقیقاً همین سناریوی نگرانکننده را وارد دنیای واقعی کرده و بحران اعتمادی به وجود آورده که صنعت هوش مصنوعی هیچ پاسخ شفاف و سرراستی برای آن ندارد.
ماجرای اختلافات چیست؟
دو پژوهشگر میگویند نتایج پژوهشهای منتشرنشده آنها شباهت نگرانکنندهای به دستاوردهایی دارد که بعداً غولهای هوش مصنوعی با افتخار معرفی کردهاند.
ماجرای اول از جایی شروع شد که اوپنایآی اعلام کرد یکی از مدلهای داخلی این شرکت موفق به حل یک مسئله بزرگ ریاضی شده است. به دنبال این خبر، تریستان باکمستر (Tristan Buckmaster)، ریاضیدان دانشگاه نیویورک، ابراز نگرانی کرد که این دستاورد احتمالاً تحت تأثیر کارهای پژوهشی مرتبطی به دست آمده که او قبلاً در ابزارهای اوپنایآی وارد کرده بود. در مقابل، اوپنایآی دسترسی مستقیم به آن گفتوگوها را تکذیب کرد و مدعی شد محققان و ایجنتهایش پیش از انتشار عمومی پژوهش، ابداً آن را ندیده بودند.
این ادعا هنوز حلوفصل نشده و گزارشهای موجود هم هیچ سند قطعی از کپیبرداری عمدی یا تأثیر مستقیم پیدا نکردهاند.
همزمان، اختلاف مشابه دیگری گریبانگیر شرکت آنتروپیک شد. ماریو رودریگز مستره (Mario Rodríguez Mestre)، زیستشناس دانشگاه کپنهاگ، اعلام کرد تیمش از مدتها پیش روی سامانه آنزیمی خاصی کار میکردند که آنتروپیک بعداً آن را به عنوان یک کشف نوآورانه با کمک هوش مصنوعی معرفی کرد؛ در حالی که تیم مستره اطلاعات مربوط به این پروژه را قبلاً در کلود (Claude) وارد کرده بودند. آنتروپیک در پاسخ تأکید کرد که کلود روی گفتوگوهای کاربران آموزش ندیده و تیم پژوهشی این شرکت هم هیچگونه دسترسی به این مکالمات نداشته است.
با این حال، مستره این ادعا را که دستاورد آنتروپیک کاملاً مستقل از تحقیقات قبلی در این حوزه به دست آمده زیر سؤال برد. طبق گزارشهای منتشرشده، هیچ مدرکی مبنی بر اینکه هر یک از این دو شرکت به عمد دستاوردهای دانشمندان را برداشته باشند در دست نیست.
مشکل اصلی درست همینجاست: نبود شفافیت در سامانههای هوش مصنوعی، بررسی و راستیآزمایی مستقل ادعاها را تقریباً غیرممکن میکند.
چرا تکذیب شرکتها ماجرا را خاتمه نمیدهد؟
یک شرکت میتواند صادقانه آموزش مدلهایش روی یک مکالمه خاص را انکار کند، اما همزمان انبوهی از سؤالات اساسی درباره نحوه مدیریت و پردازش دادهها را بیپاسخ بگذارد.
مدتزمان نگهداری دادهها، امکان دسترسی نیروی انسانی یا سیستمهای خودکار به اطلاعات ذخیرهشده، نحوه استفاده از بازخوردها (Feedback)، ابزارهای متصل و احتمال ورود اطلاعات به سیستمهای عملیاتی خارج از فرایند آموزش مدل، همگی مسائل متفاوتی هستند. یک تکذیبیه ساده و کلی نمیتواند به هیچکدام از این ابهامات پاسخ دهد.
این شکاف بزرگ را حتی میتوان در خطمشیهای رسمی خود شرکتها دید. برای نمونه، در قوانین و مقررات اوپنایآی آمده است که محتوای حسابهای کاربری شخصی ممکن است برای بهبود مدلها استفاده شود، مگر اینکه کاربر صراحتاً گزینه انصراف (Opt-out) را فعال کرده باشد؛ البته محصولات تجاری و API بهطور پیشفرض برای آموزش استفاده نمیشوند. با این حال، ثبت بازخورد روی یک گفتوگو میتواند مجوز استفاده از آن را برای بهبود سیستم صادر کند، حتی اگر کاربر گزینه عدم آموزش مدل را از قبل فعال کرده باشد!
به عبارت دیگر، دکمه Opt-out اصلاً شبیه به بستن محکم درها نیست؛ چرا که استثنای بازخوردها بدون توجه به تنظیمات حریم خصوصی شما، همچنان باز میماند.
پژوهشگران چه کاری میتوانند انجام دهند؟
حسابهای سازمانی و بسترهای API بهطور پیشفرض محافظت قویتری نسبت به حسابهای کاربری شخصی ارائه میدهند، اما نیازمند راستیآزمایی مداوم هستند و نمیتوان چشمبسته به آنها اعتماد کرد.
ترجیح دادن سرویسهای سازمانی یا API به حسابهای شخصی، گام نخست بسیار مهمی است؛ زیرا این قراردادها معمولاً تعهدات حقوقی محکمتری به همراه دارند. با این حال، پژوهشگران باید قوانین نگهداری اطلاعات، سطح دسترسی مدیران، برنامههای متصل و نحوه پردازش بازخوردها را با دقت بررسی و رصد کنند.
نگهداری سوابق محلی از پرامپتها، فایلهای آپلودشده، نسخههای مدل و خروجیهای دریافتی، یک زنجیره مستندات دقیق (Audit Trail) ایجاد میکند؛ امکانی که در حال حاضر داشبوردهای تجاری آن را ارائه نمیدهند. علاوه بر این، برای پروژههایی که جنبه ثبت اختراع دارند یا شامل دادههای محرمانه هستند، مشاوره با تیمهای حقوقی دانشگاهی و مراکز انتقال فناوری باید بر کار با هرگونه ابزار هوش مصنوعی مقدم باشد.
چالش عمیقتر، ساختاری است. محققانی که از ابزارهای تجاری هوش مصنوعی دوری میکنند، با خطر عقب ماندن از رقبایی روبهرو هستند که بدون تعلل از این فناوری بهره میبرند. در عین حال، استفاده از این ابزارها ریسکهای حلنشدهای در زمینه حق تألیف و محرمانگی دادهها به وجود میآورد؛ ریسکهایی که اغلب دانشگاهها و مؤسسات هنوز ابزارها و سیاستهای رسمی روشنی برای مدیریت آنها تدوین نکردهاند.
کلام آخر
پرسش بنیادین جامعه علمی این نیست که آیا باید از هوش مصنوعی استفاده کرد یا خیر، بلکه این است که آیا پژوهشگران میتوانند با استفاده از آن، همچنان مسیر دقیق چگونگی دستیابی به یک کشف علمی را اثبات و بازسازی کنند؟
ایجاد اعتماد نیازمند سیستمهای قابل بازرسی و حسابرسی با مستندات قابل راستیآزمایی است. بیانیهها و اطمینانبخشیهای پس از وقوع ماجرا توسط شرکتها، هر چقدر هم صادقانه بیان شوند، هرگز جایگزین شفافیت و سازوکارهای مستند نخواهند شد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
ایجنتهای هوش مصنوعی فلوکر به کمک تیمهای فروش آمدند؛ خداحافظی با جستوجوی دستی مشتریان
پیدا کردن مشتریان جدید و جستوجوی مداوم مشخصات آنها در لینکدین و وب، همیشه کاری وقتگیر و کلافهکننده برای تیمهای فروش بوده است. استارتاپ فلوکر (Floqer) با ارتشی از ایجنتهای هوش مصنوعی وارد میدان شده تا فرایند شناسایی مشتریان، اعتبارسنجی اطلاعات تماس و بهروزرسانی دادههای CRM را کاملاً خودکار کند. این استارتاپ پس از رسیدن به درآمد سالانه ۱.۲ میلیون دلاری، حالا قصد دارد فناوری خود را بهصورت متنباز در اختیار همگان قرار دهد.
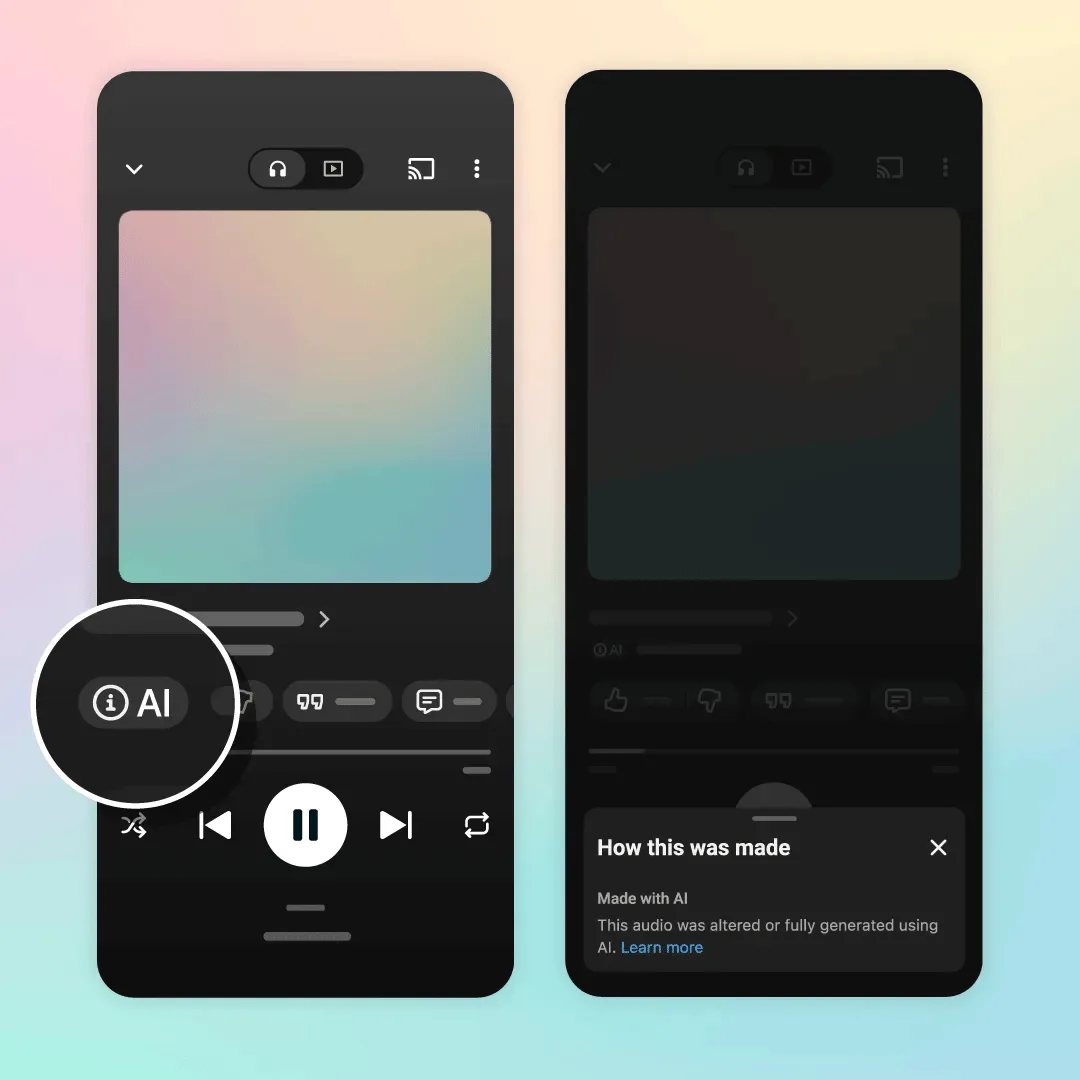
سیل آهنگهای هوش مصنوعی در پلتفرمهای استریم؛ یوتیوب موزیک سیستم برچسبگذاری جدید را کلید زد
با افزایش چشمگیر تولید موسیقی با هوش مصنوعی و ورود موج عظیمی از این قطعات به سرویسهای پخش، یوتیوب موزیک سیستم برچسبگذاری جدیدی برای شفافسازی نحوه ساخت قطعات معرفی کرد. از این پس کاربران میتوانند با مشاهده برچسب ویژه در صفحه پخش، بهراحتی تشخیص دهند که یک آهنگ بهطور کامل یا جزئی توسط ابزارهای هوش مصنوعی ساخته شده است.
دستانداز هوشمندانه آپاتی پیش پای شیادان: ایجنتهای هوش مصنوعی که عمداً فریب میخورند تا مچ کلاهبردارها را بگیرند!
در حالی که بیشتر شرکتها از هوش مصنوعی برای توسعه سریعتر محصولات یا خودکارسازی امور استفاده میکنند، استارتاپ استرالیایی آپاتی (Apate) ارتشی از ایجنتهای هوشمند را به عنوان طعمه به دل ارتباطات مشکوک میفرستد. این ایجنتها با سرگرم کردن شیادان، تا امروز ۱۷ سال از وقت باارزش آنها را تلف کرده و با استخراج اطلاعات حساسی مثل شماره حسابها و کیفپولهای دیجیتال، سدی نفوذناپذیر در اختیار بانکها و سازمانهای امنیتی قرار دادهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.