خداحافظی با هدررفت کارتهای گرافیک؛ فریمورک QwenGyre علیبابا آموزش ایجنتها را ۱.۸۵ برابر سریعتر کرد!
تیم Qwen در شرکت علیبابا از فریمورک نوآورانه QwenGyre رونمایی کرد که روند آموزش یادگیری تقویتی ایجنتهای هوش مصنوعی در پروژههای سنگین و چندساعته را تا ۱.۸۵ برابر سریعتر میکند. این معماری هوشمند با مدیریت پویا و منعطف کارتهای گرافیک، مانع از بیکار ماندن سختافزارها حین پردازشهای طولانی میشود و بازدهی مدلها را به شکل چشمگیری افزایش میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم هوش مصنوعی Qwen در علیبابا فریمورک جدیدی به اسم QwenGyre توسعه داده که فرایند آموزش ایجنتهای کدنویسی را در تسکهای پیچیده و چندساعته تا ۱.۸۵ برابر پرسرعتتر میکند.
- این معماری با بازتخصیص هوشمند کارتهای گرافیک (GPUها) و مدیریت شاخههای پردازشی، مشکل بیکار ماندن سختافزار و اتلاف منابع سنگین رایانشی را به طور کامل حل کرده است.
- در ارزیابیهای عملی روی بنچمارک تولید کامل ریپازیتوری (NL2RepoBench)، این روش موفق شد نرخ موفقیت ایجنتها را ۶ درصد ارتقا دهد و دهها ساعت در زمان آموزش صرفهجویی کند.
روشن ماندن موتور GPUها در ماراتن چندساعته ایجنتها با QwenGyre
اجرای طولانی و چندساعته ایجنتهای کدنویسی، زیرساختهای یادگیری تقویتی (RL) را حسابی به چالش میکشد؛ چرا که تفاوت زمان انجام کارها، تاریخچههای اجرایی شاخهشاخه و تولید توکنهایی که در هر تسک به مرز یک میلیون میرسد، فشار عجیبی به سرورها میآورد. در همین راستا، تیم Qwen در شرکت علیبابا از QwenGyre رونمایی کرده است؛ فریمورکی اختصاصی که دقیقاً برای مدیریت این حجم کاری سنگین طراحی شده است. گزارشهای این مقاله از ارتقای ۶ درصدی عملکرد در بنچمارک تولید مخزن کد (ریپازیتوری) و شتاب ۱.۸۵ برابری فرایند آموزش سرتاسری نسبت به روشهای سنتی Async و Colocate خبر میدهند.
چرا تسکهای طولانی کارتهای گرافیک را بیکار و معطل میگذارند؟
سیستمهای یادگیری تقویتی سنتی برای ایجنتها فرض را بر این میگذارند که هر رولاوت (Rollout یا همان یک دور تعامل و اجرای کامل مدل در محیط) نهایتاً چند دقیقه بیشتر طول نمیکشد. اما QwenGyre دست روی پروژههایی گذاشته که محققان به آن تسکهای با افق بسیار طولانی (xLong-horizon) میگویند؛ کارهایی مثل ساخت صفر تا صد یک ریپازیتوری کامل، بازنویسی کل ساختار یک پایگاه کد (Codebase) یا مهاجرتهای بزرگ پلتفرمی که ساعتها زمان برده و به صدها بار فراخوانی ابزار مختلف نیاز دارند.
تفاوت فاحش در زمان اجرای کارها باعث شکلگیری پدیده «دم دراز» (Long Tail) میشود؛ جایی که پس از اتمام بیشتر کارها، فقط چند وظیفه سنگین و کُند باقی مانده و کل گام بعدی آموزش را معطل خود نگه میدارند. دو روش رایج زمانبندی هم هر کدام به شکلی این منابع ارزشمند را هدر میدهند:
- روش Colocate: یک مجموعه مشترک از کارتهای گرافیک را به صورت نوبتی بین تولید رولاوت و مرحله آموزش جابهجا میکند. در نتیجه، بخش آموزش باید منتظر کُندترین دسته رولاوتها بماند تا بتواند کل منابع GPU را در اختیار بگیرد.
- روش Async: دستههای ثابتی از پردازندههای گرافیکی را جداگانه به تولید و آموزش اختصاص میدهد. با این فرمول، ظرفیتهای بیکار در یک بخش هرگز نمیتوانند به کمک بخش دیگر بیایند و عملاً میسوزند.
محیطهای پیشرفته اجرای کد (هارنسها) دردسر دیگری هم درست میکنند؛ فشردهسازی زمینه (Context Compaction) پیامهای قدیمیتر را با خلاصهها جایگزین میکند، سابایجنتها در محیطهای ایزوله فعالیت میکنند و تلاشهای مجدد، مسیرهای شاخهشاخه جدیدی میسازند. اگر همه این مسیرها را به نمونههای مستقل تبدیل کنیم، پیشوندهای مشترک بارها و بارها تکرار میشوند و زمینه دقیقی که هر توکن را تولید کرده به کلی گم میشود.
حل معما با تقسیم کار میان سلولها و درختها
فریمورک QwenGyre طول عمر اجرای تسکها را کاملاً از تخصیص منابع کارت گرافیک و نمونههای آموزشی جدا میکند. بخش «زمانبند منعطف» (Elastic Scheduler) در طول رولاوت منابع پردازشی را دوباره سازماندهی میکند، در حالی که «پردازشگر مسیر» (Trajectory Processor) تاریخچههای منشعب و شاخهای را برای مرحله آموزش سرهم میکند.
حرکت سلولها به سمت پردازشهای آماده
زمانبند منعطف کل کلاستر را به «سلولها» (کوچکترین دستههای GPU که توانایی میزبانی چینش موازی مدل برای آموزش را دارند) تقسیم میکند. هر سلول میتواند به درخواستهای رولاوت پاسخ دهد یا یک کپی از اکتور آموزشی را اجرا کند؛ بنابراین، ظرفیتهای خالی تولید میتوانند بدون نیاز به متوقف کردن کارهای در حال اجرا، مستقیماً به چرخه آموزش بپیوندند.
در هر استقرار، یک سلول هسته وجود دارد که وزنهای اصلی مدل را نگه داشته و بهینهساز را اجرا میکند. در کنار آن، سلولهای اقماری (Satellite Cells) بسته به نوسان تقاضا، وظیفه خود را میان تولید و آموزش تغییر میدهند. موازیسازی پویای دادهها نیز به سلولهای ماهوارهای تازهنفس اجازه میدهد بلافاصله به یک بچ آموزشی که از قبل شروع شده ملحق شوند.
در زمان تغییر وظیفه، یک پروکسی هوشمند درخواستهای جاری مدل را به یک موتور استنتاج دیگر هدایت میکند. کش کلیدها و مقادیر توجه (KV Cache) نیز از طریق فناوری RDMA جابهجا میشود تا سیستم مقصد به جای محاسبه مجدد، همان پیشوندهای پردازششده قبلی را دوباره استفاده کند.
درختها زمینه دقیق را حفظ میکنند
پردازشگر مسیر، هر اجرای تسک را به شکل یک ساختار درختی ثبت میکند که شاخههای آن پیشوندهای ذخیرهشده را با هم به اشتراک میگذارند. به این ترتیب، هر خروجی تولیدشده دقیقاً به همان زمینهای متصل میماند که آن را خلق کرده است؛ حتی خروجیهایی که پیش از فشردهسازی متن یا درون سشن یک سابایجنت ساخته شدهاند.
ماسک زیان (Loss Mask) این سیستم فقط شامل توکنهایی میشود که مستقیماً توسط پالیسی تولید شدهاند. اهداف مشترک فقط یک بار تأثیر داده میشوند و میزان خطای توکنها پیش از تجمیع نهایی، در درون هر اجرا میانگینگیری میشود. این سازوکار مانع از آن میشود که کارهای پرشاخه و شلوغ، وزن غیرمنصفانهای در جریان آموزش به خود بگیرند.
دستاوردهای مفید حتی در زمان تایماوت
اگر اجرای تسک تولید یک ریپازیتوری با خطای اتمام زمان (Timeout) روبهرو شود، معمولاً هنوز بخشهایی از آن ریپازیتوری کار میکند، پکیجهایی ساخته شدهاند و تستهایی با موفقیت پاس شدهاند. سیستم QwenGyre این فضای کاری حفظشده را دقیقاً بررسی میکند و در صورت امکان ارزیابی، برای کارهای انجامشده امتیاز نسبی (Partial Credit) در نظر میگیرد تا این تلاشهای ناتمام هم به نمونههای آموزشی نمرهدار و ارزشمند تبدیل شوند.
سیستمهای کنترل نمونهبرداری این موارد را در چارچوب یک بودجه محاسباتی مشخص نگه میدارند. پردازشگر در هر اجرا حداکثر پنج مسیر (Jmax) انتخاب کرده و آنها را بر اساس نقششان در محیط کار رتبهبندی میکند. برای مثال در ابزار Claude Code، گامهای ایجنت اصلی که وظیفه هدایت تسک را دارد بالاتر از گامهای سابایجنتها قرار میگیرند و مسیرهای خلاصه در آخر میآیند. در آزمایشهای انجامشده، تعیین سقف ۵ مسیر با کیفیت نمونهبرداری بدون محدودیت برابری کرد و زمان رفتوبرگشت پردازش (Forward-Backward) را حدود ۲۵ درصد کاهش داد، در حالی که آموزش صرفاً روی مسیر اصلی به امتیازهای ضعیفتری منجر شد.
دستاوردهای چشمگیر و ارقام خیرهکننده در مقیاس بزرگ
پژوهشگران فریمورک QwenGyre را روی سه بار کاری ایجنتی ارزیابی کردند: NL2RepoBench برای ساخت ریپازیتوریها از توضیحات زبان طبیعی، DeepSWE برای برطرف کردن باگها در کدهای موجود، و TerminalBench برای انجام تسکهای چندمرحلهای در ترمینال. در تمام این آزمایشها از Claude Code درون محیطهای ایزوله کانتینری استفاده شد.
در بزرگترین مقیاس آزمایششده، مدل Qwen 3.8 2.4T توانست ۴۸ گام آموزشی را ظرف ۷۵.۴ ساعت به پایان برساند؛ در حالی که همین تعداد گام با روش Async حدود ۱۳۴.۶ ساعت و با Colocate نزدیک به ۹۱.۵ ساعت زمان میبرد. این آمار نشاندهنده شتاب به ترتیب ۱.۷۸ برابری و ۱.۲۱ برابری است. جالب اینکه نرخ قبولی در بنچمارک NL2RepoBench نیز در طول این روند از ۵۲.۵ درصد به ۵۸.۵ درصد جهش پیدا کرد.
معیار کهنگی خطمشی (Policy Staleness) نشان میدهد که پالیسیِ تولیدکننده رولاوت چند بهروزرسانی بهینهساز با پالیسیِ مصرفکننده آن در مرحله آموزش فاصله دارد. سیستم QwenGyre میانگین کهنگی فوقالعاده پایینی معادل ۱.۵ بهروزرسانی را در هر سه نوع بار کاری ثبت کرد.
نوع تسک | میانگین کهنگی | نسبت به Async | نسبت به Colocate |
|---|---|---|---|
DeepSWE | ۱.۵ بهروزرسانی | ۱.۵۷ برابر | ۱.۸۲ برابر |
TerminalBench | ۱.۵ بهروزرسانی | ۱.۴۳ برابر | ۱.۸۵ برابر |
NL2RepoBench (مدل 2.4T) | ۱.۵ بهروزرسانی | ۱.۷۸ برابر | ۱.۲۱ برابر |
جابهجایی نقشها از رولاوت به آموزش به طور متوسط ۸.۵۲ ثانیه و در مسیر برعکس تنها ۳.۴۶ ثانیه طول کشید. هر انتقال کمتر از ۹ ثانیه زمان برد؛ رقمی که در مقایسه با تسکهای دوساعته عملاً ناچیز است، هرچند هزینه انباشته در نهایت به تعداد دفعات تعویض نقش بستگی دارد.
ریشهیابی علت اصلی افزایش سرعت
آزمایشهای تحلیلی روی یک بار کاری ۱۲ مرحلهای نشان داد که چه سهمی از افزایش سرعت به آموزش جریانی (Streaming) و چه بخشی به زمانبندی منعطف مربوط است. قابلیت استریمینگ به تنهایی توانست زمان روش Async را ۱۱.۶ درصد کاهش دهد، اما اضافه کردن نودهای رولاوت مستقل به روش Colocate بهبود چندانی ایجاد نکرد.
در نقطه مقابل، ترکیب آموزش جریانی با تغییر نقش در سطح سلولها توانست زمان اتمام کار را از ۲۵.۰۸ ساعت در مدل خام Async به ۱۶.۱۲ ساعت در پیکربندی کامل QwenGyre برساند. این دستاورد حاصل بازپسگیری ظرفیتهای بیکار رولاوت است؛ در حالی که مسیرهای پردازششده به صورت همزمان به بخش آموزش سرازیر میشوند.
همافزایی سه لایه کلیدی در سیستم
- بازتخصیص منابع در سطح سلول: کارتهای گرافیکی که تازه آزاد میشوند را از طریق موازیسازی پویای دادهها به یک بچ آموزشی فعال ملحق میکند.
- ردیابی منشأ توکنها (TITO): ورودیها و خروجیهای مرتبط با فشردهسازی زمینه، تلاشهای مجدد و تقسیم کار بین سابایجنتها را بدون دستکاری محیط اجرا به طور کامل حفظ میکند.
- ارزیابی پیشرفت ناقص: به جای دادن پاداش صفر به تسکهای تایماوتشده، به کارکردهای سالم و قابل سنجش آنها نمره میدهد و از زحمات سیستم استفاده میکند.
کاربرد ایدهآل QwenGyre کجاست؟
پروژههایی با رولاوتهای چندساعته، نوسانات شدید زمانی و شمار توکنهایی نزدیک به یک میلیون در هر اجرا، دقیقاً همان زمین بازی هستند که QwenGyre برای آن متولد شده است. در مقابل، وظایف کوتاهمدت مثل محاسبات ریاضی که در عرض ۳۰ ثانیه تمام میشوند، ظرفیت بیکار چندانی تولید نمیکنند و تغییر نقش مداوم پردازندهها برای آنها فایده چشمگیری نخواهد داشت.
محدودیتهای مربوط به کلاستر و نمونهبرداری
- حداقل اندازه کلاستر: هر سلولِ قابل تعویض باید گنجایش نگهداری مدل و ساختار موازی آن را داشته باشد. کلاسترهای کوچک احتمالاً سلولهای مستقل کافی برای جابهجایی مؤثر منابع نخواهند داشت.
- محدودیت در برزدن سراسری دادهها (Global Shuffling): پردازش جریانی گروههای تکمیلشده رولاوت را به بهروزرسانیهای متوالی تخصیص میدهد. بنابراین، فرایندهای آموزشی که نیازمند تصادفیسازی کامل مینیبچها هستند باید از حالت جهشهای تکمرحلهای استفاده کنند که هرچند طبق مقاله سرعت کمتری دارد، اما باز هم از روشهای پایه سریعتر عمل میکند.
کد مرجع هنوز منتشر نشده است
در مقاله منتشرشده و اطلاعیههای رسمی تیم Qwen، کدی برای این فریمورک ارائه نشده است. در صفحه رسمی Qwen در هاگینگ فیس نیز پژوهش مذکور ثبت شده اما مخزن رسمی مستقلی برای QwenGyre در دسترس نیست.
تیمهای مهندسی برای پیادهسازی این ایده باید زمانبندی مبتنی بر سلول، هدایت مجدد درخواستها، انتقال پرسرعت KV-Cache، ردیابی منشأ توکنها و سیستمهای ارزیابی امتیاز نسبی را شخصاً توسعه دهند. در نهایت، بیشترین بهرهوری این فریمورک نصیب کلاسترهای بزرگی خواهد شد که بارهای کاری سنگین ایجنتی را اجرا میکنند و به دنبال نجات ظرفیتهای باارزش کارتهای گرافیک خود هستند.
مطالب مرتبط و پیشنهادی
فکر میکرد با جان بون جووی نامزد کرده و تا پای حراج خانهاش رفت؛ جولان کلاهبرداریهای عاشقانه با هوش مصنوعی
توسعه روزافزون هوش مصنوعی مولد و جعل هویت چهرههای مشهور، کلاهبرداریهای عاطفی را به یک تهدید مالی ویرانگر تبدیل کرده است. مستند افشاگرانه Super Scam Me با تمرکز بر شگردهای هولناک این شبکهها نشان میدهد که چگونه فریبخوردن در فضای مجازی میتواند زندگی و دارایی افراد را تا پای نابودی بکشاند.
تست جنجالی ایجنتهای هوش مصنوعی در کارهای روزمره؛ چرا از بین Dots، Spark و Muse فقط یکی سربلند شد؟
ایجنتهای جدید هوش مصنوعی وعده دادهاند کارهای خستهکننده روزمره را به دست بگیرند، اما در عمل چقدر موفقاند؟ در یک آزمایش میدانی جذاب، سه ایجنت سرشناس Dots از چتجیپیتی، Spark از جمینای و Muse از متا در ۵ چالش واقعی از خرید آنلاین تا پاکسازی ایمیلها محک خوردند. نتایج نشان میدهد که تا یک دستیار خودمختار بینقص هنوز فاصله داریم، اما یکی از این هوشهای مصنوعی فراتر از انتظار عمل کرده است.
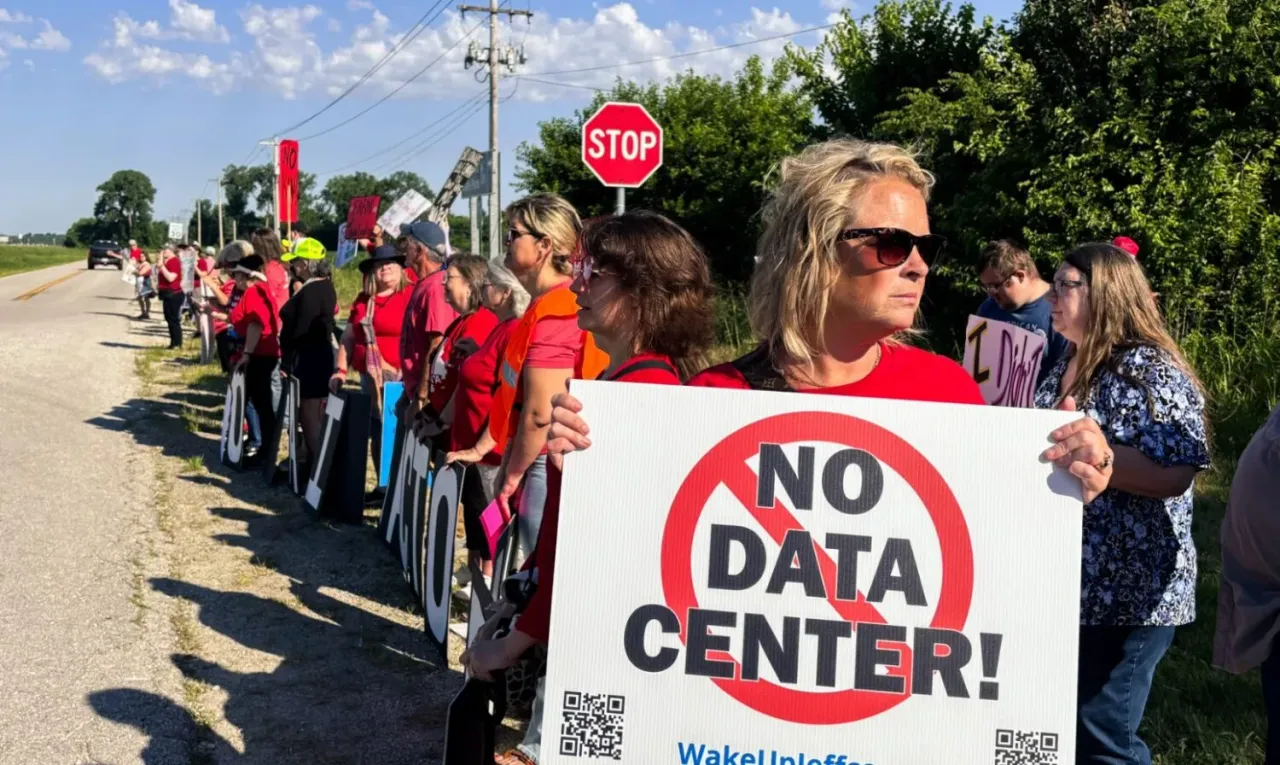
نه قاطع اهالی پنسیلوانیا به چک ۱۰ هزار دلاری: دیتاسنتر هوش مصنوعی آمازون پشت درهای بسته ماند
ساکنان محلی در پنسیلوانیا در تصمیمی غافلگیرکننده، پیشنهاد دریافت چکهای ۱۰ هزار دلاری برای ساخت یک دیتاسنتر عظیم متصل به آمازون را رد کردند و نشان دادند که پول نمیتواند جای شفافیت را بگیرد. این ماجرا باعث شد فرماندار ایالت رسماً ترمز اعطای مجوزهای سریع به دیتاسنترهای هوش مصنوعی را بکشد و قوانین سفتوسختتری وضع کند. حالا این پرونده به نقطه عطفی در چالش میان غولهای فناوری و جوامع محلی برای تأمین برق و آب زیرساختهای هوش مصنوعی تبدیل شده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.