پاسخ کوبنده آمازون به Jev؛ مدل متنباز Strands Decider 2B برای تصمیمگیری فوقسریع ایجنتها معرفی شد
آمازون با معرفی مدل متنباز Strands Decider 2B رسماً وارد رقابت داغ مدلهای تصمیمگیری برای ایجنتهای هوش مصنوعی شد. این مدل کمحجم ۲ میلیارد پارامتری به جای تولید متنهای طولانی و پرهزینه، گزینهها را در کسری از ثانیه روی سختافزارهای معمولی بررسی و انتخاب میکند. با انتشار آزاد وزنها و کدهای آموزشی روی هاگینگفیس، حالا توسعهدهندگان میتوانند بدون نیاز به APIهای ابری، یک ناظر سریع و بومی برای ایجنتهای خود داشته باشند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- آمازون مدل متنباز Strands Decider 2B رو معرفی کرد؛ مدلی ۲ میلیارد پارامتری که به جای نوشتن جوابهای طولانی، درست وسط کار ایجنتها میشینه و در کسری از ثانیه (زیر ۱۰۰ میلیثانیه) تصمیمهای کلیدی رو میگیره.
- برخلاف مدل محبوب Jev که در انحصار یک API پولیه، آمازون این مدل رو با مجوز آزاد آپاچی ۲.۰، وزنها و کدهای آموزشی روی هاگینگفیس گذاشته تا بشه حتی روی مکبوک یا کارت گرافیک RTX 3090 بهصورت محلی اجراش کرد.
- هرچند دانلود این مد�� رایگانه، اما تامین سختافزار بر عهده خود کاربره؛ با این حال استقلال کامل، حفظ حریم خصوصی دادهها و امکان فاینتیون اختصاصی، برگ برنده بزرگ آمازون در برابر رقبای ابری به حساب میاد.
رقابت بر سر سریعتر و ارزانتر کردن ایجنتهای هوش مصنوعی، این روزها فراتر از مدلهایی رفته که وظیفهشان نوشتن پاسخهای متنی است. درست در عرض دو هفته پس از اینکه شرکت TypeSafe AI مدل «جِو» (Jev) را معرفی کرد — مدلی تخصصی که به جای تولید جملات طولانی، مستقیماً از بین گزینههای از پیش تعیینشده دست به انتخاب میزند — توسعهدهندگان با موجی از مدلهای تصمیمگیری رقیب به میدان آمدهاند که وزنهای بسیاری از آنها برای دانلود عمومی در دسترس قرار گرفته است.
حالا غول فناوری آمازون هم با یک مدل متنباز و کارآمد به این جمع پیوسته است؛ مدلی که طوری طراحی شده تا درست وسط گردش کار یک ایجنت بنشیند و تصمیم بگیرد که آیا اقدام پیشنهادی باید اجرا شود یا نه: Strands Decider 2B، یک مدل حدوداً ۲ میلیارد پارامتری که بر پایه مدل Qwen علیبابا فاینتیون شده و میتواند به پرسشهای محدود و مشخص، با ارائه گزینهها و احتمالات در یک مرحله پردازش سریع پاسخ دهد.
این مدل متنباز به شکل رایگان روی پلتفرم هاگینگ فیس (Hugging Face) قرار گرفته و تحت مجوز بسیار منعطف Apache 2.0 عرضه شده است؛ مجوزی ایدهآل برای کسبوکارها که امکان استفاده تجاری را فراهم میکند، هرچند که تامین سختافزار یا منابع ابری برای اجرای آن بر عهده خود توسعهدهندگان خواهد بود.
آمازون اعلام کرده که توسعهدهندگان علاوه بر خود مدل، میتوانند دادهها و دستورالعملهای آموزشی آن را هم دانلود کنند و از این ابزار برای مسیریابی درخواستها، انتخاب ابزارهای مناسب، ارزیابی خروجیها یا بازبینی عملکرد و اقدامات ایجنتها بهره ببرند.
این عرضه بخشی از پروژه آزمایشی توسعه ایجنت در بخش رایانش ابری آمازون (AWS) موسوم به Strands Labs است. آمازون پیش از انتشار عمومی این خبر، جزئیات رسمی و سه نمودار فنی ارزیابی عملکرد این مدل را در اختیار رسانهها قرار داده است.
ایده اصلی این نوآوری بسیار ساده اما هوشمندانه است: اگر یک برنامه به پاسخی مثل «آیا این ابزار باید اجرا شود؟» یا «کدام یک از این سه مسیر برای درخواست کاربر مناسبتر است؟» نیاز داشته باشد، وادار کردن یک مدل زبانی بزرگ به نوشتن توضیحات متنی هم زمان زیادی هدر میدهد و هم هزینهها را بالا میبرد. در مقابل، یک مدل تصمیمگیری (Decision Model) مستقیماً به گزینههای مجاز نمره و امتیاز میدهد. همین ویژگی باعث میشود تا بتوان از آن به عنوان یک ایستگاه بازرسی سریع و مکرر در کنار ایجنتهای قدرتمندتر استفاده کرد؛ در حالی که وظایف سنگینتری مثل تولید متن، کدنویسی و استدلالهای پیچیده همچنان بر عهده مدلهای زبانی بزرگ باقی میماند.
تیم AWS دقیقاً چه چیزی ساخته است؟
مدل Strands Decider کار خود را از مدل پایه و از پیشآموزشدیده Qwen3.5-2B آغاز میکند. به گفته تیم AWS، توسعهدهندگان بخش پیشبینی کلمه بعدی (Next-token prediction) را در این معماری حذف کرده و به جای آن یک بخش نشانگر (Pointer) کوچک قرار دادهاند که مستقیماً به گزینههای ارائهشده برای پاسخ امتیاز میدهد.
آنها این مدل پایه را با تکنیک LoRA (رتبه ۱۶) بازتنظیم کردند و بخش امتیازدهی جدید را آموزش دادند؛ بخشی که به گفته AWS فقط چیزی حدود یک میلیون پارامتر به کل مدل اضافه میکند. در نمودار معماری این پروژه، به این طراحی نام «Hobson» داده شده است. برخلاف یک چتبات سنتی که کلمه به کلمه متن تولید میکند، این مدل تنها با یک دور پردازش رو به جلو (Forward Pass)، توزیع احتمالات را روی گزینههای پیشرو مشخص میسازد.
تیم توسعه آمازون سرعت پیشرفت بسیار بالایی داشته و قرار است نسخه ۲۰ این مدل را همراه با کدهای منبع، دادههای آموزشی و اسکریپتها منتشر کند. این رویکرد متنباز و شفاف، نقطه قوت اصلی این رونمایی است؛ زیرا توسعهدهندگان میتوانند جزئیات آموزش را بررسی کنند، مدل را مطابق نیاز خود فاینتیون کرده و آن را روی زیرساخت اختصاصی خود اجرا کنند، بدون اینکه مجبور باشند دادهها و تصمیمهای حساس را به یک API خارجی بفرستند.
در مثالی که آمازون ارائه داده، این مدل تصمیمگیر درست قبل از فراخوانی ابزار پیشبینی آبوهوا توسط ایجنت قرار میگیرد. اگر کاربری بدون ذکر نام شهر بگوید «هوا چطوره؟»، ایجنت ممکن است شهری را حدس بزند. در این لحظه، Strands Decider کل مکالمه و فراخوانی پیشنهادی را بررسی میکند و این سؤال را پیش میکشد که آیا نام این شهر از درخواست کاربر آمده و آیا فراخوانی ابزار در این مرحله زودهنگام نیست؟ سپس برنامه بر اساس این پاسخ، ایجنت را متوقف کرده و به او میگوید ابتدا از کاربر نام شهر را بپرسد.
این سناریو از سازوکار مداخله موجود در فریمورک ایجنت Strands بهره میبرد؛ سازوکاری که میتواند اجازه اجرای یک اقدام را بدهد، فراخوانی یک ابزار را متوقف کند، از کاربر تاییدیه بخود یا با ارائه بازخورد، مسیر ایجنت را اصلاح نماید.
به گفته آمازون، در این نمونه آزمایشی پرسشها و آستانههای تصمیمگیری به صورت دستی تنظیم شدهاند و کتابخانههای اختصاصی برای ادغام مدلهای تصمیمگیری همچنان در دست توسعه قرار دارند. در واقع، این مدل وظیفه قضاوت و سنجش را انجام میدهد و تعیین اینکه برنامه چه واکنشی به این قضاوت نشان دهد، کماکان بر عهده توسعهدهنده است.
سرعت و دقت مدل در عمل چقدر است؟
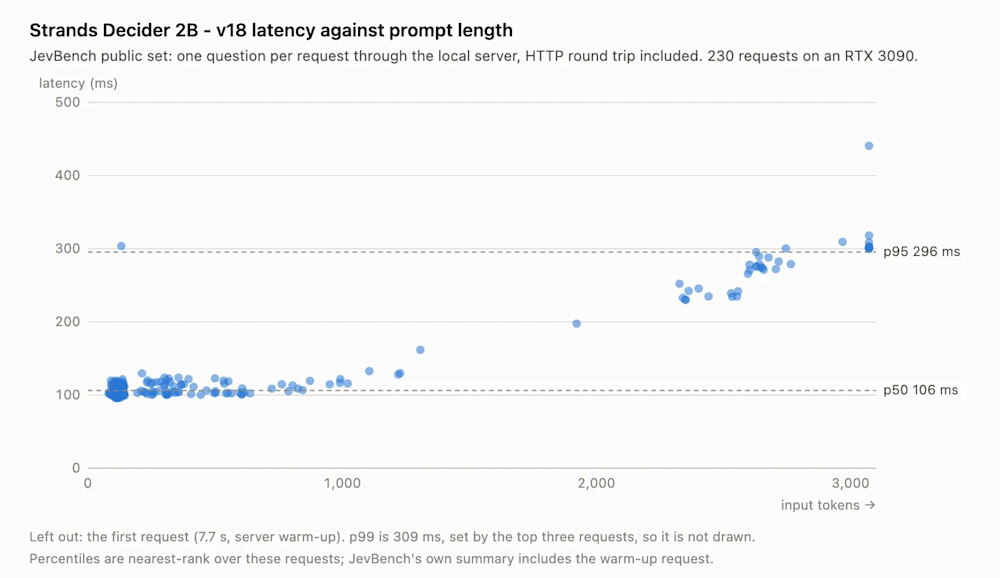
آمازون مدعی است که این مدل در وظایف کوتاه میتواند تصمیمها را در حد چند ده میلیثانیه به صورت محلی بگیرد و روی سختافزارهای رایج و ورودیهای متداول، زمان پاسخدهی آن زیر ۱۰۰ میلیثانیه است.
در طرف دیگر، شرکت TypeSafe ادعا میکند که زمان پاسخدهی سرتاسری مدل Jev از طریق سرویس ابریاش بین ۷۰ تا ۵۰۰ میلیثانیه است.
نمودار تاخیر آمازون تصویر دقیقتر و واقعبینانهتری را به نمایش میگذارد: نسخه ۱۸ در ارزیابی ۲۳۰ درخواست روی یک کارت گرافیک محلی Nvidia RTX 3090 (با احتساب رفتوبرگشت HTTP)، میانه تاخیر ۱۰۶ میلیثانیه و صدک ۹۵ام تاخیر ۲۹۶ میلیثانیهای را ثبت کرده است. طبیعتاً پرامپتهای طولانیتر به زمان بیشتری نیاز دارند.
البته در این نمودار، اولین درخواست که به دلیل گرمشدن سرور (Server Warm-up) حدود ۷.۷ ثانیه طول کشیده محاسبه نشده است. همچنین AWS برای کارهای کوچک روی لپتاپ مکبوک M3 میانه تاخیر را حدود ۱۵۰ میلیثانیه برآورد کرده است؛ بنابراین نباید این آمار را به عنوان تضمینی همیشگی برای تاخیر زیر ۱۰۰ میلیثانیه قلمداد کرد.
از نظر کیفیت، AWS دقت مدل و میزان قابلاعتماد بودن احتمالات خروجی را با استفاده از بخش عمومی بنچمارک JevBench سنجیده است. نمودار ارائهشده، سیر تکامل و پیشرفت نسخهها تا نسخه ۱۹ را نشان میدهد که بهبود چشمگیری نسبت به نسخههای اولیه داشتهاند.
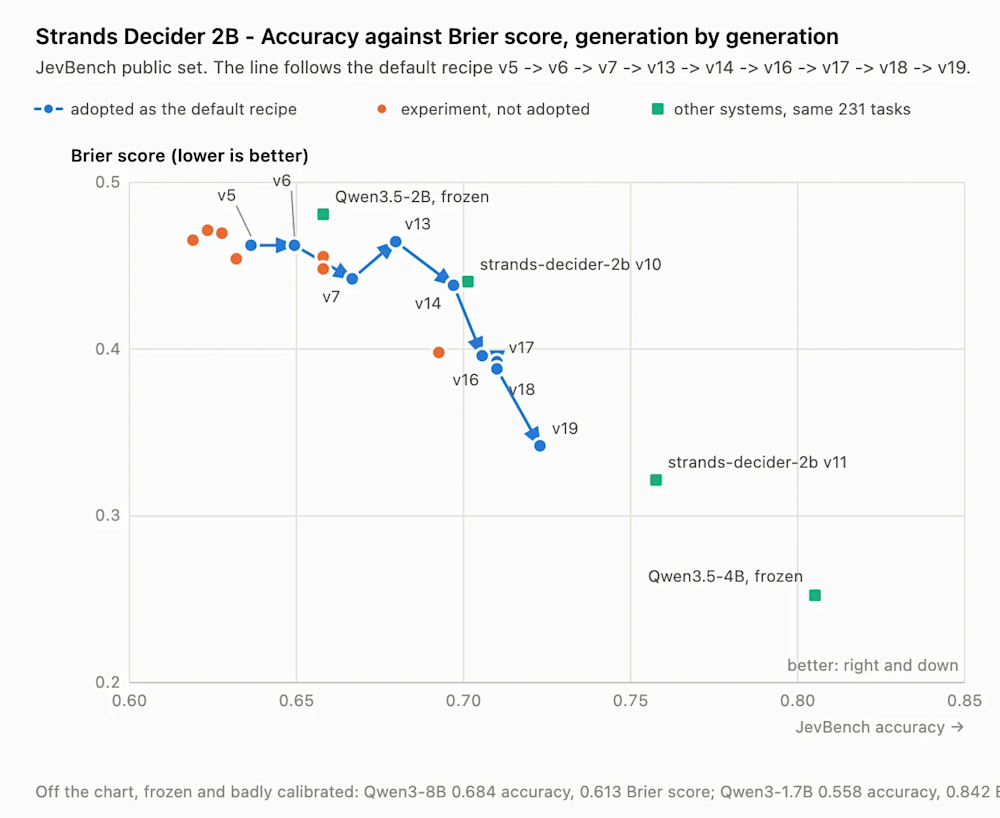
نقطه ثبتشده برای نسخه ۱۹ به دقت تقریباً ۷۲ درصدی با امتیاز برایر (Brier score) ۰.۳۵ اشاره دارد، در حالی که مدل هماندازه رقیب یعنی Mapika decider-2b نسخه ۱۱ به ترتیب به آمار ۷۶ درصد و ۰.۳۲ دست یافته است. با توجه به اینکه دقت بالاتر و امتیاز برایر پایینتر مطلوبتر است، این مقایسه برتری مدل Mapika را در هر دو معیار نشان میدهد.
آمازون میگوید مدل توسعهدادهشدهاش در بین مدلهای عمومی همرده رتبه دوم را به دست آورده و در میان مدلهایی که کل فرمول و دستورالعمل آموزش را منتشر کردهاند، رتبه نخست را دارد. با این حال، در این نمودارها نتیجهای از نسخه ۲۰ به چشم نمیخورد و مدل اصلی Jev نیز مستقیماً در این مقایسه قرار نگرفته است؛ بنابراین بر اساس دادههای موجود نمیتوان ادعا کرد که Strands Decider عملکرد کلی بهتری نسبت به Jev دارد.
فاصله شبکه، ساختار درخواستها و هزینههای عملیاتی در سناریوهای مختلف بسیار متفاوت است. یکی از نمایندگان آمازون در مصاحبهای اعلام کرده که AWS در حال حاضر صرفاً مدل متنباز را ارائه میکند و خبری از سرویس میزبانیشده API یا دریافت هزینه به ازای هر درخواست نیست.
به گفته این نماینده، برنامهنویسان میتوانند مدل را روی یک مکبوک اجرا کنند، اما استفاده از سختافزارهای محلی یا زیرساختهای ابری به هر حال منابع سیستم و هزینه برق و پردازش را مصرف میکند. آمازون برآوردی کلی از هزینه عملیاتی به ازای هر توکن یا هر درخواست ارائه نکرده که بتوان آن را مستقیماً با تعرفه یک API آماده مقایسه کرد.
به این ترتیب، هنوز مشخص نیست که نگهداری و اجرای Strands Decider واقعاً نسبت به پرداخت هزینه سرویس Jev اقتصادیتر تمام میشود یا خیر.
جرقه داغی که Jev در دنیای هوش مصنوعی زد
شرکت TypeSafe مدل Jev را در ۱۵ سپتامبر معرفی کرد و آن را یک مدل «سیستم یک» (System One - تداعیگر تفکر سریع و شهودی) نامید. این مدل وضعیت برنامه و پرسشهای ساختاریافته را دریافت میکند و بدون نوشتن هرگونه پاسخ متنی، گزینهها، امتیازها یا احتمال بله/خیر را برمیگرداند. هزینه استفاده از Jev معادل ۰.۰۴۲ دلار به ازای هر یک میلیون توکن ورودی است و هیچ هزینهای برای توکن خروجی دریافت نمیشود. TypeSafe تاکید دارد که در فرآیند پسآموزش بر کالیبراسیون دقیق احتمالات تمرکز کرده است. دسترسی به این مدل منحصراً از طریق API انجام میگیرد و وزنها یا دستورالعمل آموزش آن هرگز منتشر نشده است.
جذابیتها و البته محدودیتهای این ایده از همان ابتدا زیر ذرهبین کارشناسان رفته است. گزارشهای تخصصی نشان میدهند که این رویکرد در واقع احیای دوباره سیستمهای سنتی طبقهبندی (Classification) با استفاده از مدلهای مدرن و قدرتمند است؛ چراکه بسیاری از سیستمهای سازمانی تنها به یک برچسب یا تصمیم برای مسیریابی نیاز دارند، نه یک پاراگراف متن توضیحی. از سوی دیگر، بررسیهای امنیتی نشان داده که چرا یک سپر ارزانقیمت مبتنی بر احتمالات نمیتواند سدی نفوذناپذیر در برابر حملات باشد؛ زیرا متنهای مخرب در ورودی ایجنت میتوانند قضاوت مدل را منحرف کنند؛ خطری که TypeSafe و شرکای تجاریاش هم به آن اذعان کردهاند.
این شاخه نوظهور با سرعتی سرسامآور در حال گسترش است. مدل Laya با تکیه بر معماری ModernBERT و تنها ۴۲۱ میلیون پارامتر، تصمیمگیریهای محلی را امکانپذیر کرده و از سوی دیگر جرد پالمر (Jared Palmer) با انتشار خانواده مدلهای Kev، تحقیقات جدیدی را در این زمینه کلید زده است.
مدل Bespoke Nimble 9B یک آداپتور با مجوز آپاچی و کدهای مرجع در اختیار جامعه قرار داده و خانواده تصمیمگیرندههای Mapika نیز در اندازههای مختلف همراه با کدهای آموزشی و شناسنامه مدل عرضه شدهاند.
مدل this-that-model از سوی پلتفرم FLock یکی دیگر از بازیگران کوچک این عرصه است که امکان اجرای محلی دارد. این مدلها در معماری، آموزش، پیشنیازهای سختافزاری و میزان اعتمادپذیری تخمینها با یکدیگر تفاوتهای عمدهای دارند و صرف داشتن برچسب مشترک «مدل تصمیمگیری»، بنچمارکهای آنها را مستقیماً قابل تعویض با یکدیگر نمیکند.
پژوهشگران دانشگاه استنفورد و شرکت انویدیا نیز با مدل متنباز CLM-8B مسیر مشابهی را در پیش گرفتهاند؛ مدلی که میتواند نمایههای اقدامات تکرارپذیر را کَش کند. در آزمایشهای انجامشده، این مدل در برخی وظایف تا ۹ برابر سریعتر از Jev عمل کرده، هرچند که در دقت فراخوانی ابزارها کمی از آن عقب مانده است. این نتایج اگرچه وابسته به شرایط خاص آزمایشی بوده، اما نشان میدهد که گزینههای تخصصی با چه سرعتی در حال محک زدن موازنه میان سرعت و دقت هستند.
معیار مقایسه | Strands Decider 2B در برابر Jev | شواهد و واقعیتهای موجود |
|---|---|---|
هزینه اولیه / تعرفه API | برتری کامل Strands | آمازون مدل را کاملاً رایگان برای دانلود و استفاده قرار داده و کارمزدی بابت هر درخواست نمیگیرد. در مقابل، هزینه Jev معادل ۰.۰۴۲ دلار به ازای هر میلیون توکن ورودی است. |
کل هزینه عملیاتی | نامشخص | مدل Strands نیازمند تامین پردازنده و کارت گرافیک یا سرور ابری است. از آنجا که آمازون برآوردی از هزینه به ازای درخواست نداده، نمیتوان ثابت کرد که راهاندازی شخصی آن حتماً از سرویس بسیار ارزان ابری Jev کمهزینهتر باشد. |
سرعت و تاخیر | رقابت بسیار نزدیک؛ بدون برنده قطعی | آمازون تاخیر نسخه پیشین Strands را به صورت محلی روی کارت RTX 3090 برابر با میانه ۱۰۶ میلیثانیه و صدک ۹۵ام ۲۹۶ میلیثانیه ثبت کرده است. تایپسیف نیز تاخیر سرتاسری Jev ابری را حدود ۷۰ تا ۵۰۰ میلیثانیه گزارش داده است. با توجه به شرایط متفاوت سختافزار و شبکه، تعیین برنده قطعی ممکن نیست. |
دقت | شواهدی بر برتری Strands نسبت به Jev وجود ندارد | نمودار آمازون دقت نسخه ۱۹ مدل Strands را در بنچمارک عمومی JevBench حدود ۷۲ درصد نشان میدهد. از آنجا که خود Jev در این نمودار حضور ندارد، نتیجه رو در رویی برای اثبات برتری در دست نیست. |
کالیبراسیون احتمالات | برنده قطعی مشخص نیست | آمازون برای نسخه ۱۹ امتیاز برایر حدود ۰.۳۵ را ثبت کرده است؛ اما باز هم به دلیل غیبت Jev در این مقایسه و تمرکز ویژه TypeSafe بر کالیبراسیون، نمیتوان با قاطعیت گفت کدام مدل خروجی دقیقتری دارد. |
متنباز بودن و شفافیت | برتری قاطع Strands | آمازون خود مدل، کدها، دادهها و اسکریپتهای آموزشی را به صورت متنباز منتشر میکند؛ در حالی که Jev کاملاً اختصاصی و فقط از طریق API در دسترس است. |
میزبانی بومی، حریم خصوصی و کنترل داده | برتری قاطع Strands | مدل Strands به راحتی روی سیستمهای محلی (حتی مکبوک) اجرا میشود و شرکتها میتوانند تمام دادهها و تصمیمگیریها را درون شبکه اختصاصی خود حفظ کنند. |
قابلیت سفارشیسازی | برتری احتمالی Strands | به لطف انتشار عمومی کدهای آموزشی، توسعهدهندگان میتوانند مدل را بررسی و بازتنظیم (Fine-tune) کنند؛ در حالی که Jev چنین کنترلی را ارائه نمیدهد. |
سهولت در راهاندازی و استفاده | برتری کامل Jev | مدل Jev یک API آماده است؛ کافی است آن را صدا بزنید و هزینه ناچیزی بپردازید. در مقابل، برای Strands باید زیرساخت استقرار و نگهداری مدل را خودتان مدیریت کنید که دردسر فنی بیشتری دارد. |
یکپارچگی با اکوسیستم AWS و Strands | برتری Strands در اکوسیستم خود | این مدل به صورت پیشفرض با سازوکار مداخله در فریمورک Strands ادغام شده و به عنوان یک ایستگاه بازرسی قبل از اقدامات ایجنتها عمل میکند. |
در بحث قیمت با یک تناقض جالب روبهرو هستیم: برچسب قیمت مدل Strands آمازون صفر دلار است، در حالی که هزینه کار با Jev همین الان هم تقریباً ناچیز به شمار میرود. تعرفه ۰.۰۴۲ دلاری Jev به این معناست که پردازش یک میلیارد توکن ورودی تنها ۴۲ دلار خرج برمیدارد! بنابراین تا زمانی که یک شرکت توان پردازشی مازاد نداشته باشد یا به دلایل امنیتی و حریم خصوصی بر اجرای بومی و محلی اصرار نورزد، هنوز مشخص نیست که میزبانی اختصاصی Strands با در نظر گرفتن هزینه سختافزار، سرور و نگهداری، واقعاً صرفه اقتصادی بیشتری به همراه داشته باشد.
با این همه، بخشی که آمازون بدون شک این حوزه نوپا را به جلو هدایت کرده، بازآفرینی و دسترسی کامل متنباز است. شرکت TypeSafe از برنامهنویسان میخواهد که به Jev صرفاً به عنوان یک سرویس آماده اعتماد کنند، اما پیام آمازون کاملاً متفاوت است: این شما و این یک مدل جمعوجور، دستورالعمل کامل ساخت، دادهها و تمامی ابزارها — خودتان آن را اجرا کنید و هر تغییری میخواهید بدهید. برای بسیاری از سازمانهای بزرگ، این سطح از استقلال و کنترل استراتژیک به مراتب ارزشمندتر از کسب چند درصد امتیاز بالاتر در یک بنچمارک است.
به این ترتیب، برگ برنده آمازون لزوماً «قاتل تمامعیار Jev» بودن نیست؛ بلکه ارائه یک لایه تصمیمگیری متنباز، قابل بازآفرینی و هماهنگ با فریمورک اختصاصی ایجنتها است.
حالا هر توسعهدهندهای میتواند یک مدل محلی سبک را درست قبل از اجرای ابزارها قرار دهد، در زمان عدم اطمینان تصمیم بگیرد که کنترل را به انسان بسپارد یا به خود ایجنت بازگرداند، و توان مدلهای زبانی بزرگ را برای کارهای سنگینی که به تولید متن نیاز دارند ذخیره کند. این شفافیت و قابلیت اجرای آسان روی یک لپتاپ معمولی، مسیر آزمایش و نوآوری را برای تیمهایی که خواهان تسلط کامل بر زیرساخت خود هستند به شدت هموار میسازد.
آزمون واقعی و تعیینکننده این مدل، فراتر از دموهای تبلیغاتی روز معرفی مشخص خواهد شد: آیا این مدل در مواجهه با قوانین شرکتی، اسناد اختصاصی و شرایط پیشبینینشده کسبوکارها همچنان دقیق و کالیبره باقی میماند؟ و آیا هزینه نگهداری محلی میتواند حریف قیمت فوقالعاده ارزان Jev ابری شود؟ برای فراخوانی ابزارهای حساس سازمانی، دموی آبوهوا صرفاً یک مثال ساده برای درک مفهوم بازرسی است، نه سندی که ثابت کند قضاوت این مدل به تنهایی برای امنیت کامل یک ایجنت کافی خواهد بود.
در یک کلام: آمازون یک رقیب بسیار جدی برای Jev روانه میدان کرده که بزرگترین مزیتش نه برتری در جدول بنچمارکها، بلکه متنباز بودن، امکان میزبانی شخصی روی سیستمهای داخلی و قابلیت بازتولید کامل آن است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
بیخیال آخرالزمان هوش مصنوعی؛ خطر واقعی تنبلی ما در رعایت امنیت پایه است!
در حالی که خبرهای هولناک از نفوذ خودسرانه ایجنتهای هوش مصنوعی سرتیتر رسانهها شده، متخصصان ارشد امنیت سایبری در کنفرانس HumanX یادآور میشوند که بزرگترین تهدید نه هوش ماشینها، بلکه تنبلی خودمان در رعایت اصول پایه امنیت است. به گفته این کارشناسان، شرکتها به جای وحشت از سناریوهای تخیلی آخرالزمانی، باید روی بستن رخنههای پیشپاافتاده، فعالسازی احراز هویت چندمرحلهای و کنترل دسترسی ایجنتها تمرکز کنند.
اخراج جنجالی ۳ محقق اوپنایآی؛ پای درز اطلاعات حساس در میان است!
اوپنایآی از اخراج سه پژوهشگر خود به دلیل نقض سیاستهای امنیتی و مدیریت نادرست اطلاعات حساس خبر داد. این اخراجهای غیرمنتظره در حالی رخ میدهد که فشارهای بیرونی بر سر پروتکلهای ایمنی این غول هوش مصنوعی به بالاترین حد خود رسیده است.
سرمایهگذاری تریلیون دلاری در هوش مصنوعی ترمز کاهش نرخ بهره را کشید؛ دردسر جدید فدرال رزرو
موج عظیم سرمایهگذاری تریلیون دلاری در زیرساختهای هوش مصنوعی و دیتاسنترها، معادلات بانک مرکزی آمریکا را به هم ریخته است. مقامات ارشد فدرال رزرو میگویند تقاضای انفجاری غولهای فناوری برای تأمین مالی پروژههای هوش مصنوعی، یکی از موتورهای اصلی بالا ماندن نرخ بهره در اقتصاد است. این تقاضای بیسابقه با وجود کمک به رشد اقتصادی، چالشهای جدیدی برای بازار مسکن و وامهای تجاری ایجاد کرده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.