آمازون با ابزار TorchNeuron انحصار انویدیا را هدف گرفت؛ مهاجرت به تراشههای ترینیم با یک خط کد
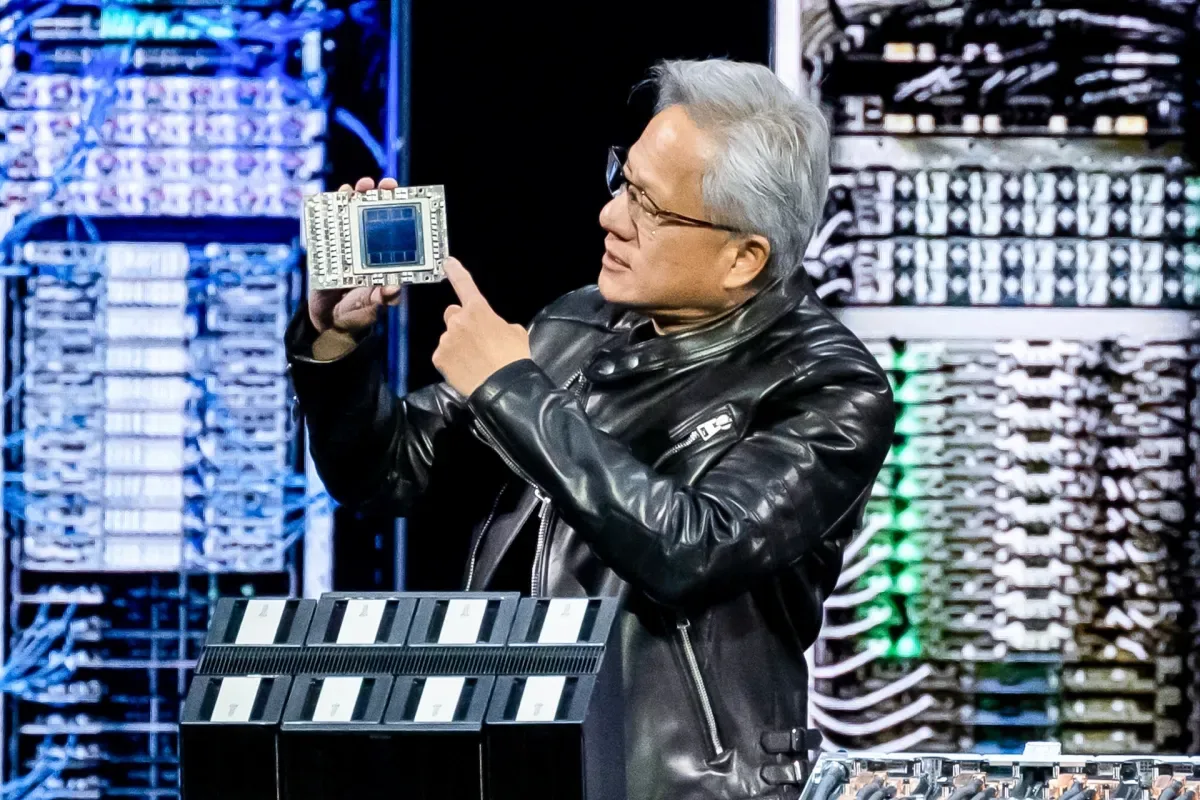
واحد رایانش ابری آمازون با معرفی ابزار جدید TorchNeuron، امکان اجرای آسان برنامههای هوش مصنوعی را روی تراشههای اختصاصی ترینیم فراهم کرده است. این غول فناوری قصد دارد با کاهش وابستگی فریمورک محبوب PyTorch به نرمافزار کوآدای انویدیا، تنوع سختافزاری و گزینههای اقتصادیتری پیش روی توسعهدهندگان قرار دهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ابزار متنباز TorchNeuron به توسعهدهندگان اجازه میدهد اپلیکیشنهای مبتنی بر PyTorch را تنها با تغییر یک خط کد روی تراشههای هوش مصنوعی ترینیم آمازون اجرا کنند.
- آمازون با همکاری جامعه متنباز، در تلاش است کدهای وابسته به انویدیا را از هسته اصلی PyTorch جدا کند تا این فریمورک به ابزاری کاملاً مستقل از سختافزار تبدیل شود.
- آمازون مدعی است استفاده از یک پلتفرم سختافزاری واحد برای آموزش و استنتاج مدلها، هزینههای پردازشی استارتاپها را در مقایسه با سرورهای اختصاصی انویدیا کاهش میدهد.
واحد خدمات ابری آمازون (AWS) بهتازگی از ابزاری به نام TorchNeuron رونمایی کرده است که به استارتاپهای حوزه هوش مصنوعی اجازه میدهد اپلیکیشنهای خود را بهسادگی به تراشه اختصاصی آمازون، یعنی «ترینیم» (Trainium) منتقل کنند. آمازون با این اقدام، مستقیماً مزیت انحصاری نرمافزاری انویدیا را هدف گرفته است؛ همان مزیتی که انویدیا را به گزینه پیشفرض و بیرقیب سختافزاری برای توسعه برنامههای هوش مصنوعی تبدیل کرد.
ابزار TorchNeuron در تعامل کامل با PyTorch کار میکند؛ فریمورک متنباز و رایگانی که توسعهدهندگان از آن برای ساخت، آموزش و اجرای مدلهای هوش مصنوعی استفاده میکنند. به گفته آمازون، این ابزار امکان اجرای برنامههای نوشتهشده با PyTorch را روی تراشه ترینیم تنها با تغییر یک خط از تنظیمات و بدون نیاز به بازنویسی کدها فراهم میسازد.
آمازون اعلام کرده است که حدود ۸۵ درصد از اپلیکیشنهای هوش مصنوعی با PyTorch نوشته میشوند. این فریمورک در ابتدا توسط فیسبوک (متا) توسعه داده شد، اما از سال ۲۰۲۲ تحت مدیریت بنیاد لینوکس قرار گرفت که از پروژههای متنباز میزبانی میکند. انویدیا سالها زمان صرف کرد تا مطمئن شود بستر نرمافزاری کوآدا (CUDA) — زیرساختی که اجرای برنامهها را روی پردازندههای گرافیکی و سایر سختافزارهای انویدیا ممکن میکند — بهصورت بینقص از برنامههای PyTorch پشتیبانی میکند. در نتیجه این تلاشها، سختافزارهای انویدیا اکنون بهشکل ریشهای و بهعنوان گزینه پیشفرض در دل این فریمورک جا خوش کردهاند.
نرمافزار TorchNeuron بر پایه ساختار PyTorch طراحی شده است؛ بنابراین توسعهدهندگانی که با این فریمورک آشنایی دارند، بهراحتی میتوانند با ابزار جدید کار کنند. البته آمازون نخستین شرکتی نیست که برای اتصال آسان تراشههای اختصاصی خود به این پلتفرم تلاش میکند؛ کاربران PyTorch در حال حاضر نیز میتوانند با اعمال تغییراتی ساده در تنظیمات، برنامههای خود را به پردازندههای گرافیکی AMD یا حتی تراشههای اپل منتقل کنند.
با این حال، آمازون استدلال میکند که مهاجرت به تراشههای ترینیم نهتنها فرآیندی بسیار ساده است، بلکه دسترسی کامل استارتاپها به اکوسیستم ابری گسترده AWS را نیز امکانپذیر میسازد. مطابق انتظار، این شرکت مدعی است که این راهکار برای استارتاپها گزینهای بسیار بهتر از همکاری با کلودهای تخصصی هوش مصنوعی (نئوکلاودها) نظیر CoreWeave ،Nebius و Firmus محسوب میشود؛ شرکتهایی که وابستگی عمیقی به سختافزارها و زیرساختهای انویدیا دارند.
«کالین بریس»، نایبرئیس نرمافزارهای فنی در آزمایشگاههای آناپورنا (واحد طراحی و ساخت تراشههای اختصاصی آمازون)، در این رابطه توضیح میدهد: «شما در حال توسعه محصول خود روی بستر AWS هستید؛ این یعنی آینده پروژه خود را به یک ارائهدهنده تکمنظوره پردازش گره نمیزنید تا بعداً مجبور شوید تمام ابزارهای جانبی را با زحمت زیاد پیرامون آن بسازید. در سرویسهای ابری آمازون، تمام زیرساختهای لازم برای تبدیل یک پیشنمایش اولیه به محصول نهایی از پیش مهیاست و به بنیانگذاران اجازه میدهد با سرعت بالا پیش بروند و در زمان نیاز، پروژه خود را بهراحتی مقیاسپذیر کنند.»
به گفته AWS، از آنجا که تراشه ترینیم هر دو مرحله آموزش (یادگیری مدل) و استنتاج (اجرا و پاسخدهی به پرسشهای کاربران) را بر عهده میگیرد و یکپارچگی عمیقی با زیرساختهای ابری مورد نیاز استارتاپها دارد، استفاده از آن در مجموع به صرفهجویی اقتصادی منجر خواهد شد؛ حتی اگر هزینه محاسبهشده به ازای هر توکن، ارزانترین نرخ بازار نباشد.
بریس در ادامه میگوید: «ارزش واقعی ترینیم در نسبت قیمت به عملکرد و بهرهگیری از یک پلتفرم واحد برای آموزش و استنتاج نهفته است؛ رویکردی که توجیه اقتصادی کل بار کاری را بهبود میبخشد. برای نمونه، شرکت دیپگرام (Deepgram) با تکیه بر پشتیبانی پیشفرض PyTorch به تراشههای ترینیم مهاجرت کرده است و اکنون به ازای هر دلار هزینه، ۷۰ درصد فایلهای صوتی بیشتری را با دقتی در سطح استانداردهای تجاری پردازش میکند.» شرکت دیپگرام در حوزه ابزارهای صوتی هوش مصنوعی فعالیت دارد و یکی از رقبای اصلی الونلبز (ElevenLabs) بهشمار میرود.
با این همه، هدف آمازون صرفاً فراهم کردن راهکاری آسان برای جذب توسعهدهندگان PyTorch به بستر ابری خود نیست.
این شرکت اعلام کرده است که تلاش میکند وابستگی پیشفرض فریمورک PyTorch به انویدیا را کاهش دهد و کدهای لازم برای تحقق این هدف را در اختیار پروژه اصلی PyTorch قرار خواهد داد. آمازون در پست وبلاگی معرفی ابزار جدید خود، در این زمینه مینویسد:
رویکرد آمازون فراتر از سختافزارهای اختصاصی این شرکت است. ما در حال ارسال تغییراتی بهصورت مستقیم به سورس اصلی پروژه PyTorch هستیم و با جامعه توسعهدهندگان آن همکاری میکنیم تا کدهایی را که این فریمورک را به تراشههایی خاص محدود میکنند، حذف کنیم. هدف اصلی این است که PyTorch نهفقط برای کاربران ترینیم، بلکه برای کل جامعه توسعهدهندگان به ابزاری کاملاً مستقل از سختافزار تبدیل شود.
اگرچه چنین استراتژی مهمی بدون شک به نفع فروشندگان سختافزار و سرویسهای ابریِ رقیب انویدیا تمام خواهد شد، اما فلسفه اصلی فریمورک PyTorch همواره پنهانکردن پیچیدگیها و دردسرهای اجرای کدهای هوش مصنوعی روی سختافزارهای مختلف بوده است. حال باید منتظر ماند و دید که آیا تضعیف جایگاه انحصاری انویدیا همانطور که آمازون وعده میدهد به تنوع بیشتر و گزینههای مقرونبهصرفهتر برای توسعهدهندگان منجر خواهد شد، یا صرفاً چالشها و سردردهای جدیدی در زمینه تنظیمات و پیکربندی بههمراه خواهد داشت.
در هر صورت، اگر آمازون موفق شود پیوند عمیق میان PyTorch و انویدیا را از بین ببرد، پیامدهای این اتفاق برای این غول تولیدکننده پردازندههای گرافیکی بسیار سنگینتر از مواجهه ساده با چند رقیب سختافزاری خواهد بود. همانطور که بریس تأکید میکند: «مسئله اصلی، از بین بردن انحصار و وابستگی اجباری به یک سختافزار مشخص است؛ عاملی که در تمام این سالها توسعهدهندگان را از داشتن حق انتخاب واقعی محروم کرده بود.»
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
مدل زبانی مرکوری ۳ با سرعت ۱٬۰۶۸ توکن بر ثانیه از رقبای سرعتی جیپیتی و کلود پیشی گرفت
استارتاپ اینسپشن از مدل زبانی مرکوری ۳ رونمایی کرد که با بهرهگیری از رمزگشایی موازی دیفیوژن، بهسرعت کمنظیر ۱٬۰۶۸ توکن بر ثانیه دست مییابد. سازندگان این مدل ادعا میکنند که مرکوری ۳ علاوهبر کاهش چشمگیر تأخیر پاسخگویی در سیستمهای مبتنیبر ایجنت، کیفیتی همتراز یا حتی بالاتر از سریعترین مدلهای جیپیتی و کلود ارائه میدهد.
بزرگترین تحول محصولات لاجیتک در سالهای اخیر؛ آمادهسازی اتاق جلسات برای عصر ایجنتهای هوش مصنوعی
لاجیتک با رونمایی از نسل جدید تجهیزات ویدیو کنفرانس مجهز به تراشههای پردازش هوش مصنوعی، بزرگترین بهروزرسانی محصولات سازمانیاش را کلید زد. این شرکت قصد دارد با سادهسازی سختافزارها و بهکارگیری حسگرهای محیطی، سالنهای کنفرانس را به لایه فیزیکی دادهها برای ایجنتهای هوش مصنوعی تبدیل کند.
کدام مدل هوش مصنوعی در مشاورههای پزشکی بهتر عمل میکند؟ ارزیابی غولهای زبانی در بنچمارک HealthBench
بنچمارکهای تخصصی HealthBench شیوه پاسخگویی و کیفیت مشاورههای بالینی مدلهای هوش مصنوعی را در هزاران مکالمه پزشکی مورد سنجش قرار دادند. نتایج نشان میدهد در حالی که مدلهای اوپنایآی از نظر تعادل کارایی و هزینه دست بالا را دارند، کلود سانست ۵٫۵ با پاسخهای جامع خود رتبه اول مکالمات عمومی سلامت را تصاحب کرده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.