لشکر مینیونهای اپل برای هوش مصنوعی؛ تبدیل مکهای بیکار به ابَرکلاود پردازشی قدرتمند!
اپل از سیستم توزیعشده جدیدی به نام «مینیونز» (Minions) رونمایی کرده که پردازندههای گرافیکی بیکار مکهای کارمندان را به یک ابرکلاود یکپارچه هوش مصنوعی تبدیل میکند. این فناوری هوشمندانه صفهای دهساعته اجرای تسکهای استنتاج را به تنها چند دقیقه کاهش داده است. با این رویکرد، اپل از حداکثر توان پردازشی تراشههای اپل سیلیکون بدون نیاز به سرورهای گرانقیمت بهره میبرد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- اپل سیستمی توزیعشده به نام Minions توسعه داده که پردازندههای گرافیکی بیکار مکهای کارمندانش رو برای اجرای تسکهای هوش مصنوعی به هم متصل میکنه.
- این فناوری صفهای طولانی اجرای پروژههای یادگیری ماشین رو از بیش از ۱۰ ساعت معطلی به چند دقیقه رسونده و سرعت تیمها رو به شدت بالا برده.
- اپل با اتکا به تاندربولت ۵ و فناوری RDMA به جای خرید کلاسترهای سنگین و سروری انویدیا، از ظرفیت دستنخورده تراشههای اپل سیلیکون در شبکه داخلی استفاده میکنه.
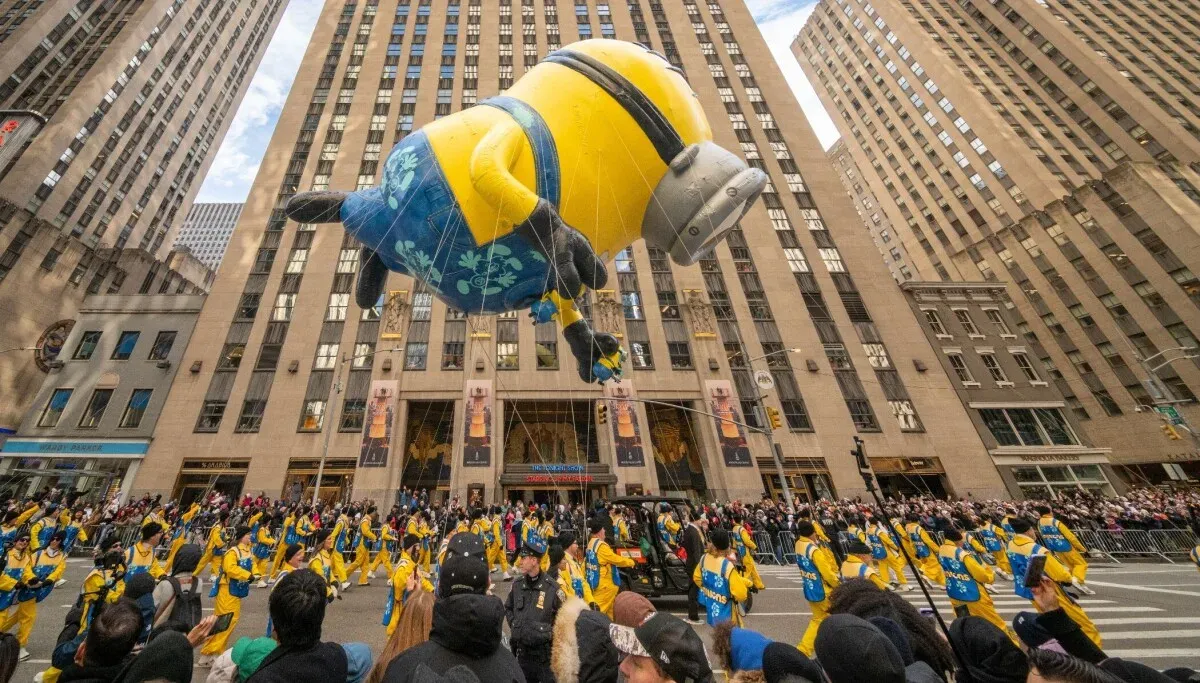
اپل برای اینکه دسترسی مهندسان و کارکنانش به منابع پردازش گرافیکی (GPU) رو برای کارهای استنتاج هوش مصنوعی راحتتر کنه، لشکری از مینیونها (Minions) رو به خط کرده! البته نگران نباشید، منظور اون کاراکترهای کارتونی زرد و بامزه نیست؛ بلکه یک سیستم توزیعشده هوشمنده که پردازندههای گرافیکی بیکار مکهای شرکت رو جمع میکنه تا پردازش تسکهای سنگین یادگیری ماشین رو به عهده بگیرن.
محققان اپل این سیستم رو یک «ابَرکلاود گرافیکی مجازی، پویا و توزیعشده» توصیف کردن که تراشههای گرافیکی آزاد اپل سیلیکون (Apple Silicon) رو در سرتاسر دستگاههای مک به هم متصل میکنه تا کارهای سنگین استنتاج در مقیاس بزرگ رو بدون معطلی انجام بده.
پژوهشگران اپل اعلام کردن که با راهاندازی مینیونز، توان پردازش گرافیکی خیلی سریعتر و راحتتر در اختیار تیمهای مختلف قرار گرفته است.
در مقاله پژوهشی مینیونز اومده: «پیش از پیادهسازی این سیستم، به خاطر محدودیت کارتهای گرافیک در سرورهای مرکزی، برخی پروژههای استنتاج بیش از ۱۰ ساعت در صف انتظار خاک میخوردن! اما حالا به لطف مینیونز و بهرهگیری از مکهای بیکار، بیشتر تسکها تنها ظرف چند دقیقه شروع به اجرا میشن.»
نسخههای جدید مک مینی و مک استودیو از قابلیت خوشهبندی با فناوری RDMA (دسترسی مستقیم حافظه از راه دور) روی پورت تاندربولت ۵ پشتیبانی میکنن. این فناوری اجازه میده حافظه و توان پردازشی چند سیستم با هم ترکیب بشن تا از پس یک بار پردازشی سنگین هوش مصنوعی بربیان؛ قابلیتی که مثلاً اجرای مدلهای فوقالعاده حجیمی رو که روی رم یک سیستم جا نمیشن، ممکن میکنه.
هدف اصلی مینیونز، ایجاد یک کلاود گرافیکی مجازی از سختافزارهای مکِ متصلبههم است تا یک استخر پردازشی پایدار و ضدخطا برای استنتاج اشتراکی به وجود بیاره. این یعنی پردازندههای گرافیکی به جای بیکار موندن، بلافاصله در اختیار تیمهای شبکه قرار میگیرن. در واقع این سیستم بیشتر از اینکه به دنبال اجرای غولآساترین مدلها باشه، با هدف بازتوزیع هوشمندانه منابع بلااستفاده در شبکه طراحی شده است.
سیستم Minions از چهار بخش اصلی تشکیل شده: سرور مینیون (Minion Server)، پایگاه داده متادیتا بر پایه PostgreSQL، مجری مینیون (Minion Executor) و ناظر مینیون (Minion Watchdog).
سرور مینیون نقش مرکز هماهنگی رو داره؛ درخواستهای کاربران رو تحویل میگیره و اونها رو به تسکهای خرد تبدیل میکنه. مجری مینیون هم وظایف استنتاج رو روی GPU یک مک اجرا میکنه، خروجیها رو روی فضای ابری S3 میفرسته و وضعیت اجرا رو به سرور گزارش میده (سرور هم اطلاعات تسکها رو در PostgreSQL ذخیره میکنه). در این میان، ناظر مینیون کل فرآیند رو زیر نظر داره تا اگه مشکلی پیش اومد — مثلاً یکی از مکها پاسخی نداد — کار رو بلافاصله به یک سیستم دیگه بسپاره.
تمام آمارها و اطلاعات این دیتابیس هم به داشبوردهای گرافانا (Grafana) سرازیر میشن تا وضعیت کل سیستم به صورت زنده و شفاف جلوی چشم تیم فنی باشه.
رویکرد اپل که روی در دسترس بودن و استفاده حداکثری از سختافزارهای موجود تمرکز داره، با استراتژی کلاسترهای انویدیا متفاوته؛ کلاسترهای انویدیا معمولاً برای دستیابی به بالاترین نرخ انتقال، کمترین تاخیر و بیشترین بهرهوری کارتهای گرافیک برای مدلهای بسیار بزرگ هوش مصنوعی بهینهسازی میشن.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جنجال موزیکویدئوی جدید گرایمز؛ پای هوش مصنوعی در میان است یا خلاقیت ۷۰ هنرمند واقعی؟
انتشار موزیکویدئوی جدید گرایمز جنجال تازهای بر سر استفاده از هوش مصنوعی به راه انداخته است. با این حال، تیم تولید تاکید کرده که هوش مصنوعی صرفاً نقش یک ابزار کمکی را داشته و بیش از ۷۰ هنرمند واقعی ماهها برای خلق این اثر تلاش کردهاند.
خرید استارتاپ Moondream توسط Prime Intellect: سرعت پردازش مدلهای بینایی دو برابر میشود!
شرکت زیرساخت هوش مصنوعی Prime Intellect استارتاپ Moondream، سازنده مدلهای بینایی پرطرفدار متنباز را تصاحب کرد. با این معامله، موتور استنتاج اختصاصی Photon به پلتفرم Prime Intellect ملحق میشود تا سرعت پردازش مدلهای بینایی تا دو برابر افزایش یابد.
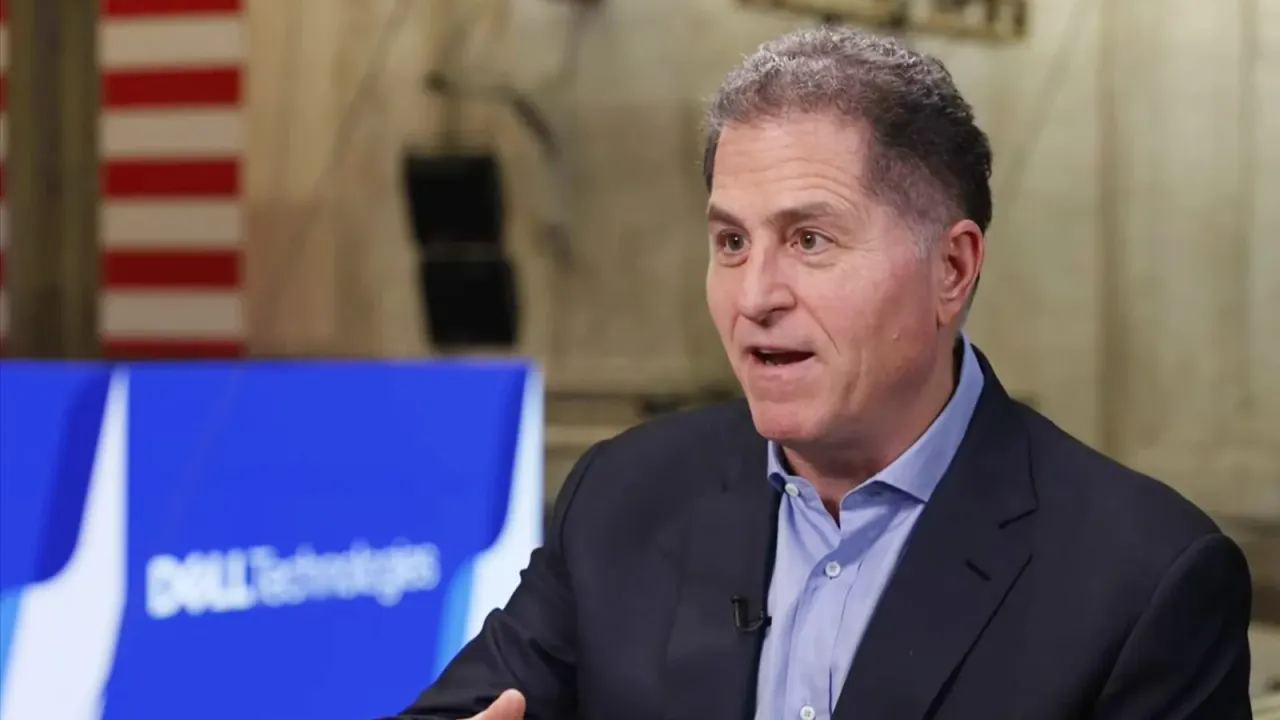
هشدار جدی مایکل دل درباره مهار هوش مصنوعی: «آتش هم خانه را گرم میکند، هم میتواند کل روستا را بسوزاند!»
مایکل دل، مدیرعامل شرکت دل، با تشبیه هوش مصنوعی به آتش هشدار داد که این فناوری شتابان برای جلوگیری از فاجعه به سازوکارهای نظارتی، کنترل دقیق و مداخله مستقیم دولت نیاز دارد. او معتقد است توسعهدهندگان باید خط قرمزها و سطوح دسترسی مشخصی برای مدلها تعیین کنند تا مانع خروج فناوری از کنترل شوند. دل همچنین جنجالهای مربوط به مصرف بالای انرژی دیتاسنترها را فرصتی عالی برای بهینهسازی و ارتقای بهرهوری دانست.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.