فرمول تازه آرنا برای پساآموزش: مدل FLUX.2-dev با نرخ برد ۶۶ درصدی صدرنشین شد!
تیم آرنا با ارائه یک چارچوب پساآموزش نوین مبتنی بر یادگیری تقویتی، معضل بزرگ انحراف مدلهای تصویرساز از پرامپت را برطرف کرد. در این متد پیشرفته، مدل ارتقایافته FLUX.2-dev با ثبت نرخ برد خیرهکننده ۶۶ درصدی در برابر مدل پایه، بالاتر از تمام رقبای متنباز قرار گرفت.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم آرنا فرمول جدیدی برای پساآموزش مدلهای تبدیل متن به تصویر ابداع کرده که ترکیب پاداش انسانی، چکلیست دقیق پرامپت و سیستم ضدتقلب، جلوی خرابکاری مدل و انحراف از دستورات کاربر را میگیرد.
- مدلهای نامآشنای FLUX.2-dev و Ideogram 4 با این متد بهینهسازی شدند و مدل FLUX.2-dev با ثبت نرخ برد ۶۶ درصدی توانست تمام رقبای مطرح متنباز را در جدول ارزیابی آرنا شکست دهد.
- به لطف تکنیک سوپ مدلها (Model Soups) و ادغام تغییرات وزنی، بدون نیاز به اضافه شدن بار پردازشی جدید در زمان تولید تصویر، خروجی نهایی به بالاترین سطح کیفیت رسیده است.
مهار انحراف از پرامپت؛ ترفند هوشمندانه آرنا با پاداشهای فیلترشده در یادگیری تقویتی
یادگیری تقویتی (RL) پس از مرحله پیشآموزش میتواند عملکرد مدلهای تبدیل متن به تصویر را حسابی ارتقا دهد؛ اما چالش بزرگ اینجاست که مدل یاد میگیرد دقیقاً پاداش تعیینشده را به حداکثر برساند، حتی اگر این کار به قیمت سوءاستفاده از نقاط کور سیستم تمام شود! مثلاً مدلی که فقط بر اساس «سلیقه و ترجیح انسانی» پاداش میگیرد، ممکن است تصاویری بسیار چشمنواز و براق بسازد، اما در عوض برخی اشیای خواستهشده در پرامپت را جا بیندازد، جزئیات ناخواسته اضافه کند یا حتی سبک تصویر را ناخواسته تغییر دهد. حالا تیم آرنا در فرمول آموزشی جدید خود، امتیاز سلیقه انسانی را با چکلیستهای اختصاصی پرامپت و یک ابزار شناسایی تقلب ترکیب کرده است. پیادهسازی این رویکرد روی مدلهای FLUX.2-dev و Ideogram 4 باعث شد هر دو مدل در جدول رتبهبندی زنده آرنا حسابی بدرخشند و رتبههای بالاتری کسب کنند.
وقتی پاداش سلیقهمحور دست مدل را برای دور زدن قانون باز میگذارد
روشهای Flow-GRPO و DiffusionNFT راهکارهای یادگیری تقویتی بسیار کاربردی برای مدلهای تولید تصویر مبتنی بر دیفیوژن و جریان (Flow) ارائه میدهند؛ مدلهایی که با تغییر تدریجی نویز، تصویر را خلق میکنند. در مرحله پساآموزش، سیستم از مدل تصویر میگیرد، به آنها امتیاز میدهد و مدل را طوری بهروزرسانی میکند که خروجیهایی با امتیاز بالاتر بسازد. در نتیجه، ساختار پاداش تعیین میکند چه ویژگیهایی تقویت شوند و چه پسرفتها و کاستیهایی از چشم پنهان بمانند.
بهینهسازی صرفاً بر اساس ترجیحات انسانی، ممکن است زیبایی ظاهری و چشمنوازی را بر وفاداری به متن ترجیح دهد. یعنی یک تصویر میتواند امتیاز خیلی بالایی بگیرد، در حالی که یکی از المانهای درخواستی را حذف کرده، یک شیء اضافه از خودش درآورده، به دستورات منفی (Negative Prompts) بیمحلی کرده یا تصویر را بیش از حد به سمت واقعگرایی سوق داده است. در دنیای هوش مصنوعی، این رفتارها مصداق بارز «تقلب در پاداش» یا همان Reward Hacking هستند؛ جایی که مدل یاد میگیرد از شکاف میان فرمول امتیازدهی و هدف واقعی کاربر به نفع خودش سوءاستفاده کند.
تقسیم کار میان چهار سیگنال کلیدی
- پاداش ترجیحات انسانی (Preference reward): آرنا یک مدل پاداش مبتنی بر برادلی-تری (Bradley-Terry) را بر پایه نزدیک به ۵ میلیون رأی مقایسهای انسانها آموزش داده که از جدول ارزیابی مدلهای تصویرساز در میان بیش از ۱۰۰ مدل جمعآوری شده است. مدلهای برادلی-تری پیشبینی میکنند انسانها کدامیک از دو تصویر را بیشتر میپسندند و این تخمین را به یک امتیاز عددی جامع برای سنجش کیفیت بصری، ترکیببندی و زیباییشناسی تبدیل میکنند.
- پاداش وفاداری به متن (Faithfulness reward): یک مدل زبانی هر پرامپت آموزشی را به درختی از معیارهای مشخص با پاسخهای «بله یا خیر» تبدیل میکند. این پرسشها شامل اشیای درخواستی، ویژگیها، روابط فضایی بین المانها و سبک تصویر هستند. سپس یک مدل چندرسانهای بینایی-زبانی (VLM) تصویر تولیدشده را بر اساس تکتک این معیارها میسنجد و درصد معیارهای رعایتشده به عنوان پاداش مدل ثبت میشود.
- پاداش قیدها و محدودیتها (Constraint reward): این سنجه محتواهایی را بررسی میکند که با خواسته اصلی کاربر در تضاد هستند؛ مثل اشیای اضافه، دستکاری در سبک یا نادیده گرفتن دستورات منفی. آرنا این قابلیت را فقط برای پرامپتهایی فعال میکند که نیاز به رعایت موبهمو دارند تا دست مدل در پرامپتهای خلاقانه کاملاً باز بماند.
- سنجه ضد تقلب در پاداش (Anti-reward-hacking rubric): یک سیستم شناسایی جداگانه به سراغ رفتارهای مخرب مشاهدهشده در طول آموزش میرود؛ از جمله تولید متنهای ناخوانا و درهمریخته یا تغییر ناخواسته سبک به سمت تصاویر عکسمانند (فوتورئالیستی).
حق وتو در دستان سیستم ضدتقلب
آرنا از سیگنال ضدتقلب به عنوان یک فیلتر کنترلی (Gate) برای پاداش ترجیحات انسانی استفاده میکند. وقتی سیستم ضدتقلب متوجه سوءاستفاده مدل شود، امتیاز ترجیح انسانی را بلافاصله سقفگذاری کرده و آن را حداکثر صفر در نظر میگیرد. اما خروجیهای بینقص و تمیز، امتیاز اصلی خود را کاملاً حفظ میکنند.
def gated_pref_reward(r_pref, d_hack):
    # d_hack = 1 when an anti-hacking rubric fires
    if d_hack == 0:
        return r_pref
    return min(r_pref, 0.0)
به این ترتیب، تصویری که در آن تقلب شناسایی شده باشد، نمیتواند به خاطر زیبایی بصری یا ترکیببندی جذاب، امتیاز مثبتی دشت کند! این آشکارساز مثل یک حق وتوی دقیق عمل میکند و اجازه نمیدهد مدل امتیازی اضافی برای تقلب کردن دریافت کند. سپس این پاداش فیلترشده در کنار پاداش وفاداری به پرامپت و قیدهای لازم بهینهسازی میشود.
علاوه بر این، آرنا چند سیاست مختلف را با چینشهای پاداش متفاوت آموزش میدهد و با میانگینگیری از تغییرات پارامترها نسبت به مدل پایه مشترک، بر اساس تکنیک سوپ مدلها (Model Soups)، آنها را با هم ادغام میکند:
deltas = [trained - base for trained in policies]
merged = base + mean(deltas)
از آنجا که نقطه شروع تمام این سیاستها یک مدل پایه یکسان بوده، تغییرات پارامترها کاملاً با یکدیگر هماهنگ میمانند. نتیجه این ادغام، یک مدل واحد و قدرتمند است که در زمان اجرا هیچ بار پردازشی اضافهای به سیستم تحمیل نمیکند.
نرخ برد ۶۶ درصدی در برابر مدل پایه
آرنا سیستم خود را با ۱۰ هزار پرامپت واقعی از کاربران آموزش داد و ۱۰۰۰ پرامپت دیگر را هم برای ارزیابی نهایی کنار گذاشت. در مرحله ارزیابی، مدل Gemini-3.5-Flash هر خروجی پساتربیتشده را با مدل پایه دستنخورده در هر دو ترتیب نمایش مقایسه کرد تا خطای چیدمان به حداقل برسد.
پیکربندی | نتیجه گزارششده در برابر مدل پایه |
|---|---|
پاداش ترجیحات انسانی | به تنهایی کافی نیست |
پاداش ترجیحات به همراه وفاداری به متن | بهبود چشمگیر |
افزودن قیدهای فیلترشده بر اساس نیت کاربر | نرخ برد ۶۴.۲ درصدی |
افزودن ادغام وزنها در فضای پارامترها | نرخ برد ۶۶.۰ درصدی |
آرنا دو مرحله اول را به صورت کیفی توصیف کرده و برای دو مرحله پایانی، نرخ بردهای عددی دقیق گزارش داده است. این روند به وضوح نشان میدهد که بخش عمده جهش عملکرد مدیون سنجههای دقیق سطح پرامپت بوده و تکنیک ادغام پارامترها هم ۱.۸ درصد دیگر به نرخ برد اضافه کرده است.
در جدول رتبهبندی زنده، مدل ارتقایافته FLUX.2-dev موفق شد ۶۹ امتیاز آرنا کسب کند. همچنین مدل پساآموزشدیده Ideogram 4 به امتیاز خیرهکننده ۱۲۲۴ رسید و تا تاریخ ۴ سپتامبر ۲۰۲۶، از تمام مدلهای متنباز ثبتشده در فهرست بالاتر ایستاد. جالب است بدانید این فرمول حتی با استفاده از مدلهای پاداش متنباز مثل Pickscore هم نتایج فوقالعاده مشابهی ارائه میدهد.
الگوی مهندسی کاربردی با قابلیت استفاده مجدد
بسیاری از سیستمهای یادگیری تقویتی در حوزه تصویر، تنها شباهت به سبک CLIP، پیشبینیکنندههای زیباییشناسی یا یک مدل ترجیحات منفرد را بهینهسازی میکنند. اما طراحی هوشمندانه آرنا ارزیابهای جداگانهای را برای ترجیحات بصری، پوشش کامل پرامپت، محدودیتهای نیت کاربر و تقلبهای شناختهشده اختصاص داده است. این سیستم فیلترکننده بهویژه زمانی معجزهآسا عمل میکند که یک حالت شکست را بتوان به شکل مطمئن دستهبندی کرد، اما نتوان آن را در قالب یک امتیاز کیفی پیوسته گنجاند.
علاوه بر این، استفاده از چکلیستهای اختصاصی برای هر پرامپت باعث شده تا دیگر نیازی به مجموعه دادههای ارزیابی دستچینشده نباشد. نمرات جداگانه برای هر معیار مشخص میکند دقیقاً چرا یک تصویر پاداش از دست داده است؛ موضوعی که رهگیری خطاهایی مانند حذف اشیاء، ویژگیهای نادرست و نقص در روابط فضایی را در طول فرآیند آموزش بسیار آسانتر میکند.
چکلیست حیاتی برای پیادهسازی در محیط عملیاتی
- کیفیت چکلیستها: باید از معیارهای تولیدشده نمونهگیری کرد و مطمئن شد هر پرسش، یک ویژگی قابل مشاهده مشخص را با وابستگیهای منطقی درست ارزیابی میکند.
- قابلیت اطمینان قاضی: نمرات مدل بینایی-زبانی (VLM) را باید با برچسبهای انسانی در بخشهای تولید متن، روابط فضایی، سبک و دستورات منفی مقایسه و اعتبارسنجی کرد.
- کالیبراسیون فیلتر کنترلی: نرخ مثبت کاذب باید اندازهگیری شود تا خروجیهای خلاقانه و معتبر، امتیاز ترجیحات انسانی خود را به اشتباه از دست ندهند.
- پایش وضعیت پاداشها (تلهمتری): باید هر مؤلفه پاداش و نرخ فعال شدن فیلتر ضدتقلب را بر اساس دستهبندی پرامپتها ثبت کرد تا از تسلط نامناسب یک پاداش یا فروپاشی سیستم جلوگیری شود.
- اعتبارسنجی ادغام: تمام سیاستها و چکپوینتهای ادغامشده باید روی بخشهای مختلف پرامپت ارزیابی شوند؛ چرا که گاهی بهبودهای کلی در میانگین نتایج، ممکن است پسرفتهای مقطعی در بخشهای خاص را پنهان کنند.
پرسشهای بیپاسخ در داوریهای خودکار
آزمون آفلاین با ۱۰۰۰ پرامپت، میزان همبستگی با قاضی خودکار جمینای را میسنجد. از طرفی جدول رتبهبندی زنده آرنا، آرای مقایسهای انسانها را هم به این معادله اضافه میکند؛ البته این امتیازها ممکن است با ورود آرا و رقبای جدید تغییر کنند. در حال حاضر شواهد ارائهشده دو مدل پایه را پوشش میدهد و سنجه ضدتقلب نیز محدود به الگوهای شکست شناساییشده است؛ بنابراین برای کشف تقلبهای جدید، به معیارها و آشکارسازهای تازهای نیاز خواهد بود.
در مقاله پژوهشی ضمیمه، جزئیات ساخت چکلیستهای مبتنی بر وابستگی به طور کامل توضیح داده شده است. همچنین در گزارش پروژه میتوانید نمونههای تصویری قبل و بعد از شناسایی حالتهای تقلب در پاداش را مشاهده کنید.
مطالب مرتبط و پیشنهادی
دوپامین مصنوعی و مغزهای هکشده؛ هوش مصنوعی مولد چطور سیمکشی تمرکز ما را به هم میریزد؟
رگبار نوتیفیکیشنها و سیستمهای هوش مصنوعی مولد با تولید مداوم «دوپامین مصنوعی»، ساختار شیمیایی و مدارهای تمرکز مغز انسان را دستخوش تغییر اساسی کردهاند. این سقوط دامنه توجه صرفاً یک مسئله شخصی نیست، بلکه با از بین بردن فرصتهای استراحت مغزی، امنیت شناختی و تفکر عمیق جامعه را در معرض تهدیدی جدی قرار داده است.
شتاب خیرهکننده مدل زبانی MiniCPM5 با دستیار ۳۲۴ میلیونی DSpark؛ جهش چشمگیر در تولید موازی توکنها
تیم OpenBMB با انتشار مدل کمحجم ۳۲۴ میلیون پارامتری DSpark، جهش بزرگی در سرعت استنتاج مدل زبانی MiniCPM5-2B ایجاد کرده است. این مدل با تکیه بر تکنیک هوشمندانه رمزگشایی گمانهزنانه، توکنها را به صورت دستهای حدس میزند تا فرایند پردازش با کمترین مصرف محاسباتی و بیشترین سرعت ممکن اجرا شود.
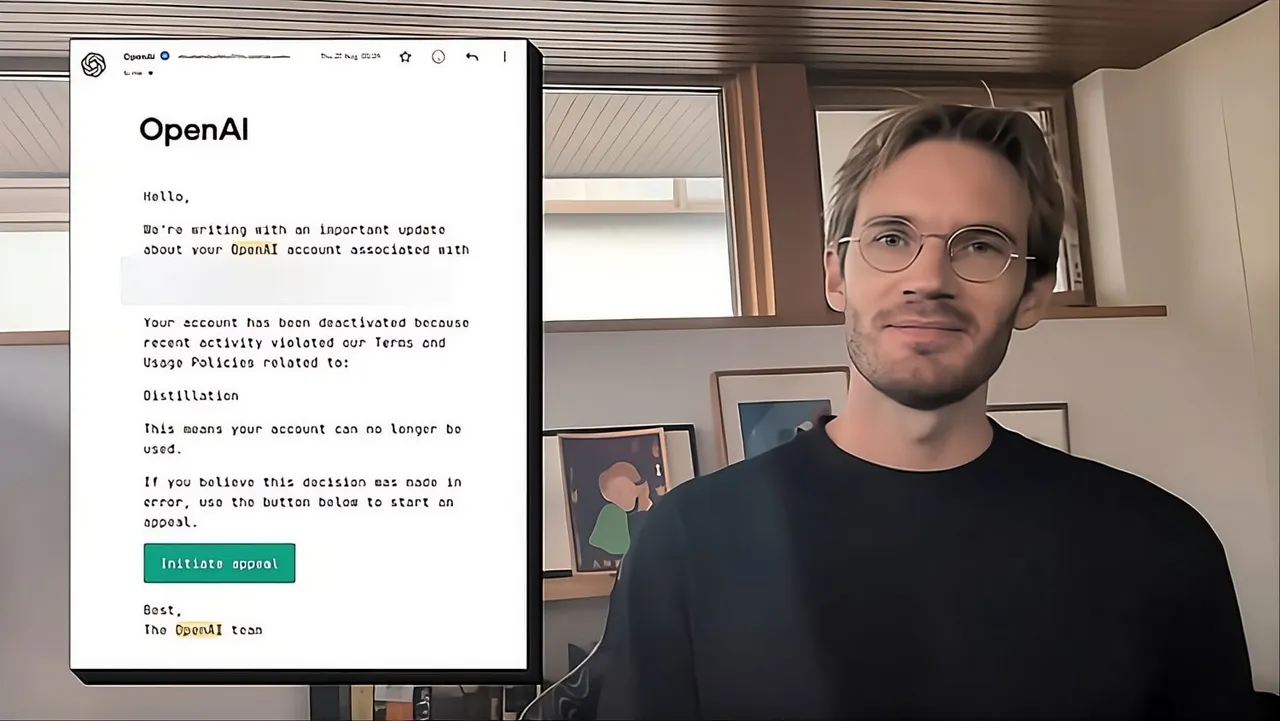
پیودیپای: موقع ساخت هوش مصنوعی اختصاصیام، OpenAI دو بار اکانتم را بست!
فلیکس شلبرگ یا همان پیودیپای معروف، بهتازگی مدل هوش مصنوعی محلی خود به نام Ajax را معرفی کرده، اما فاش ساخته که در مسیر توسعه آن، شرکت OpenAI دو بار حسابش را مسدود کرده است. او برای ساخت این مدل ۹ میلیارد پارامتری از تکنیک تقطیر استفاده کرده؛ موضوعی که زنگ خطر نقض قوانین سازنده ChatGPT را به صدا درآورده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.