مدل متنباز AstaBrief 8B معرفی شد؛ نگارش ۳.۵ برابر سریعتر گزارشهای علمی مستند تنها در یک مرحله!
مؤسسه تحقیقاتی Ai2 با معرفی مدل متنباز AstaBrief 8B، تحولی جدی در تولید سریع گزارشهای پژوهشی ایجاد کرده است. این مدل با حذف مراحل وقتگیر و واسطهای، به محققان اجازه میدهد تا گزارشهای علمی منسجم و همراه با منابع مستند را تا ۳.۵ برابر سریعتر و تنها در یک مرحله تولید کنند. وزنهای این مدل سبک روی هاگینگفیس منتشر شده و امکان اجرای کاملاً امن و محلی روی سیستمهای سازمانی را فراهم میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مؤسسه هوش مصنوعی آلن (Ai2) مدل متنباز AstaBrief 8B را بر پایه Qwen3 معرفی کرد؛ ابزاری تخصصی که گزارشهای علمی مستند را به جای چند مرحله طولانی، فقط در یک گام مینویسد.
- این مدل با حذف مراحل وقتگیر خلاصهسازی و بخشبندی مجزا، سرعت تولید گزارش را ۳.۵ برابر کرده و زمان پردازش را از ۱۷۸ ثانیه به حدود ۵۱ ثانیه رسانده است.
- با اتکا به آموزشهای هدفمند SFT و DPO و فیلتر ویژه تراکم ارجاعدهی، دقت استنادها رشد چشمگیری داشته و وزنهای آن برای استقرار محلی روی سرورهای داخلی سازمانها در دسترس است.
نگارش گزارشهای علمی مستند در یک مرحله با AstaBrief 8B
مؤسسه هوش مصنوعی آلن (Ai2) بهتازگی از مدل متنباز AstaBrief 8B رونمایی کرده است؛ مدلی که بر پایه Qwen3-8B فاینتیون شده تا یک پرسش پژوهشی و بخشهای استخراجشده از مقالات علمی را تحویل بگیرد و در قالب یک گزارش ساختاریافته و دارای منابع دقیق تحویل دهد. این انتشار تحت مجوز Apache 2.0 شامل کل مجموعه دادههای آموزشی نیز میشود؛ بنابراین توسعهدهندگان میتوانند فرایند پسآموزش (Post-training) را بهطور کامل بررسی، بازتولید یا شخصیسازی کنند.
طبق گزارش Ai2، میانگین تأخیر انتهابهانتها در پایپلاین سریع Asta تنها ۵۱.۱ ثانیه است؛ در حالی که این زمان برای حالت تحلیلی و متفکر (Thinking mode) به ۱۷۸.۵ ثانیه میرسد. این یعنی سرعت نگارش حدود ۳.۵ برابر بیشتر شده است! این مقایسه کل مسیر تولید را در بر میگیرد و شامل زمان صرفهجوییشده ناشی از حذف مراحل واسطهای مانند خلاصهسازی، خوشهبندی موضوعی و پیشنویس جداگانه هر بخش است.
یک مرحله تولید بهجای چهار مرحله وقتگیر
سیستمهای ایجنتی سنتز مقالات پژوهشی — مثل سرویس Asta متعلق به Ai2 که از مدلهای کلود (Claude) قدرت میگیرد — معمولاً ابتدا متنها را جستجو و استخراج میکنند، سپس آنها را خلاصه میسازند، در بخشهای جداگانه دستهبندی میکنند و در نهایت هر بخش را جداگانه مینویسند. اما AstaBrief پرسش علمی و چکیدههای استخراجشده را یکجا دریافت میکند و کل گزارش نهایی را تنها در یک مرحله (One pass) تحویل میدهد. بر اساس ارزیابیهای اصلی Ai2، این سادهسازی چشمگیر توانسته کیفیتی همسطح با سیستمهای چندمرحلهای ارائه دهد.
البته این مدل همچنان برای پیدا کردن مقالات و انتخاب قطعات متنی مرتبط به یک سیستم بازیابی خارجی (Retrieval) وابسته است. برنامههای کاربردی باید این قطعات را آماده کنند، شناسههای منابع را برای ارجاعدهی در اختیار مدل بگذارند و شواهد را طوری تنظیم کنند که در پنجره متنی (Context Window) مدل بگنجد. مؤسسه Ai2 یک نمونه محلی PDF در گیتهاب ارائه کرده که جریان کاری این فرایند را بهخوبی نشان میدهد.
شکلدهی مدل با ترجیحات هوشمندانه و دادههای پالایششده
تیم Ai2 برای آموزش AstaBrief ابتدا از یادگیری نظارتشده (SFT) و سپس از بهینهسازی مستقیم ترجیحات (DPO) استفاده کرده است. در مرحله SFT، مدل با بررسی نمونههای کامل گزارشها آموزش میبیند و سپس در مرحله DPO، جفتهای ثابتی از گزارشهای برتر و ضعیف به مدل نشان داده میشود تا الگوهای خروجی مطلوب تقویت شوند. Ai2 این فرایند کمدردسرتر را انتخاب کرد، چرا که روشهای یادگیری تقویتی مبتنی بر مدل داور (Judge-driven RL) میتوانند بسیار پرهزینه، ناپایدار و از نظر خطایابی دشوار باشند.
- جمعآوری پرسشها: محققان Ai2 کار را با پرامپتهای واقعی ارسالشده به سیستمهای ScholarQA و نسخههای اولیه Asta آغاز کردند. در مرحله فیلترسازی، ترافیک رباتها، پرامپتهای بیش از حد کوتاه، درخواستهای غیرانگلیسی، سؤالات غیرعلمی و درخواستهای حاوی اطلاعات هویتی افراد حذف شدند تا در نهایت حدود ۹۰ هزار پرسش پژوهشی تمیز باقی بماند.
- اهداف آموزشی SFT: پایپلاین چندمرحلهای ScholarQA با استفاده از مدلهای پرچمداری مثل Claude 3.5 Sonnet، Claude 3.7 Sonnet، o3، o4-mini و GPT-4.1 گزارشهایی تولید کرد. پس از فیلتر کیفی، حدود ۴۷ هزار نمونه آموزشی برای فاینتیون نظارتشده آماده شد.
- جفتهای مقایسهای DPO: برای زیرمجموعه دیگری از پرسشها، یک گزارش از پایپلاین ScholarQA و گزارش دیگر از مدلهایی مثل o3، o4-mini، DeepSeek-V3 یا DeepSeek-R1 گرفته شد. دو مدل GPT-4.1 و DeepSeek-R1 وظیفه داوری هر جفت گزارش را بر عهده داشتند. Ai2 گزارش کرده که ۹۵ درصد از داوریهای خودکار کاملاً با ترجیحات انسانی همخوانی داشته است. در نهایت با نگهداشتن جفتهایی که هر دو داور بر سر برتری آنها توافق داشتند، حدود ۶ هزار نمونه ترجیحی ارزشمند استخراج شد.
یک فیلتر هوشمند که کیفیت ارجاعات را متحول کرد
چکپوینتهای اولیه SFT گزارشهایی بسیار روان تولید میکردند، اما گاهی اوقات منابع ساختگی به متن اضافه میکردند یا ارجاعدهی را جا میانداختند! تیم Ai2 چهار معیار فیلتر را برای گزارشهای مصنوعی بررسی کرد: نسبت توکنهای خروجی به ورودی، ارتباط ارجاعات، تراکم ارجاعدهی (Citation Density) و تنوع ارجاعات. در این میان، تراکم ارجاعدهی مشخص میکند که گزارش تا چه حد بهطور پیوسته برای ادعاهایی که نیاز به مدرک دارند، منبع معتبر ارائه میدهد.
حذف نمونههایی با تراکم ارجاع پایین، بزرگترین جهش کیفی را ایجاد کرد. جالب اینکه اعمال فیلترهای سختگیرانهتر، ترکیب چند فیلتر مختلف یا آزمایش نرخهای یادگیری گوناگون تأثیر چندانی نداشت. در آزمایشهای Ai2 مشخص شد که انتخاب نمونههای دارای پوشش ارجاع قوی، بسیار مطمئنتر از پیچیدهتر کردن فیلترها میتواند استناد و واقعگرایی مدل را ارتقا دهد.
جهش چشمگیر بازیابی ارجاعات به لطف DPO
مجموعه ارزیابی ScholarQA-CS2 شامل پرسشهای واقعی در حوزه علوم کامپیوتر است که کاربران مطرح کردهاند. معیارهای این ارزیابی بهطور مستقل کیفیت پاسخ، پشتیبانی ارجاعات از ادعاهای مطرحشده و همچنین ارجاعدهی به ادعاهایی که نیازمند مدرک هستند را میسنجند (امتیاز بالاتر به معنای عملکرد بهتر است):
مدل | میانگین امتیاز | دقت پاسخ | دقت استناد | بازیابی استناد |
|---|---|---|---|---|
Qwen3-8B | 77.3 | 90.6 | 76.2 | 64.6 |
AstaBrief-8B-SFT | 83.7 | 90.4 | 87.7 | 71.3 |
AstaBrief-8B | 87.0 | 89.0 | 90.5 | 78.2 |
در مقایسه با نسخه اولیه SFT، اعمال DPO میانگین امتیاز مدل را از ۸۳.۷ به ۸۷.۰ ارتقا داده است. در این میان، دقت استناد ۲.۸ امتیاز و بازیابی استناد ۶.۹ امتیاز رشد داشته که البته با افت اندک ۱.۴ امتیازی در دقت پاسخ همراه بوده است.
روی همین مجموعه آزمایشی، مدل AstaBrief به امتیاز ۸۷.۰ دست یافت که از امتیاز ۸۶.۲ متعلق به Asta ScholarQA بالاتر بوده و به امتیاز ۸۸.۸ مدل DR-Tulu-8B بسیار نزدیک است. همچنین در رقابتهای رودررو، AstaBrief در ۷۲ درصد موارد توانست بر Asta ScholarQA غلبه کند. البته عملکرد مدل در بنچمارک DeepScholarBench کمی پایینتر است؛ AstaBrief امتیاز ۵۳.۵ را در برابر ۶۰.۲۵ سیستم Asta ScholarQA کسب کرده و گزارشها نشان میدهد DR-Tulu نیز در آنجا نمره بالاتری ثبت کرده است.
سرعت بالا با مرزها و محدودیتهای مشخص
- بهترین کاربرد: مدل AstaBrief برای ابزارها و برنامههایی ایدهآل است که خودشان بخشهای متنی مرتبط از مقالات علمی را بازیابی کردهاند و حالا به یک سنتز سریع، ساختاریافته و دارای استنادهای پرتراکم نیاز دارند.
- خارج از حیطه توانایی: این مدل به جستجوی آزاد در وب، خرد کردن پرسشهای پیچیده (Query decomposition)، جستجوی بازگشتی یا استفاده چندمرحلهای از ابزارها نمیپردازد. اجرای چنین قابلیتهایی نیازمند یک ایجنت یا معماری نرمافزاری پیرامونی است.
- ترجیح ارزیابان انسانی: در یک بررسی محدود با حضور سه داور، مدل DR-Tulu ترجیح کلی بالاتری دریافت کرد؛ هرچند دو نفر از سه داور، دقت ارجاعات AstaBrief را برتر دانستند.
- ریسک وفاداری به منابع: گاهی ممکن است یک ارجاع به مقالهای کاملاً مرتبط اشاره کند، اما ادعای مطرحشده توسط مدل نتایج آن تحقیق را اغراقآمیز جلوه دهد؛ مثلاً نتیجه یک مطالعه کوچک به کل جامعه آماری تعمیم داده شود. مدل AstaBrief بهطور خاص برای مقابله با این سناریوی خطا آموزش ندیده است.
اجرای محلی گزارشها با دسترسی به وزنهای متنباز
یک مدل ۸ میلیاردی پارامتری (8B) میتواند با تنظیمات مناسب دقت محاسباتی و پنجره متنی، روی یک کارت گرافیک ردهبالای مصرفی اجرا شود. استقرار محلی این امکان را به مراکز تحقیقاتی میدهد تا مقالات منتشرنشده، پرسشهای حساس و گزارشهای تولیدشده را در بستر شبکه داخلی سازمان خود نگه دارند و نیازی به ارسال اسناد محرمانه به سرویسهای ابری مدلهای هوش مصنوعی اختصاصی نداشته باشند.
مؤسسه Ai2 در پست معرفی رسمی این پروژه بر اهمیت ترکیب دادههای پسآموزش تأکید کرده است. موفقیت AstaBrief حاصل نمونههایی بود که سنتز مستند و انتساب دقیق را به نمایش گذاشتند و سپس آموزش مبتنی بر ترجیحات این رفتارها را تثبیت کرد. برای تیمهایی که قصد دارند سیستمهای نگارش متون تخصصی را بر پایه مدلهای متنباز بسازند، ترکیب SFT، DPO و فیلترگذاری بر اساس تراکم ارجاعات، یک رویکرد اثباتشده و قابل تکرار پیش از ورود به پایپلاینهای پیچیدهتر یادگیری تقویتی محسوب میشود.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
دوپامین مصنوعی و مغزهای هکشده؛ هوش مصنوعی مولد چطور سیمکشی تمرکز ما را به هم میریزد؟
رگبار نوتیفیکیشنها و سیستمهای هوش مصنوعی مولد با تولید مداوم «دوپامین مصنوعی»، ساختار شیمیایی و مدارهای تمرکز مغز انسان را دستخوش تغییر اساسی کردهاند. این سقوط دامنه توجه صرفاً یک مسئله شخصی نیست، بلکه با از بین بردن فرصتهای استراحت مغزی، امنیت شناختی و تفکر عمیق جامعه را در معرض تهدیدی جدی قرار داده است.
شتاب خیرهکننده مدل زبانی MiniCPM5 با دستیار ۳۲۴ میلیونی DSpark؛ جهش چشمگیر در تولید موازی توکنها
تیم OpenBMB با انتشار مدل کمحجم ۳۲۴ میلیون پارامتری DSpark، جهش بزرگی در سرعت استنتاج مدل زبانی MiniCPM5-2B ایجاد کرده است. این مدل با تکیه بر تکنیک هوشمندانه رمزگشایی گمانهزنانه، توکنها را به صورت دستهای حدس میزند تا فرایند پردازش با کمترین مصرف محاسباتی و بیشترین سرعت ممکن اجرا شود.
پیودیپای: موقع ساخت هوش مصنوعی اختصاصیام، OpenAI دو بار اکانتم را بست!
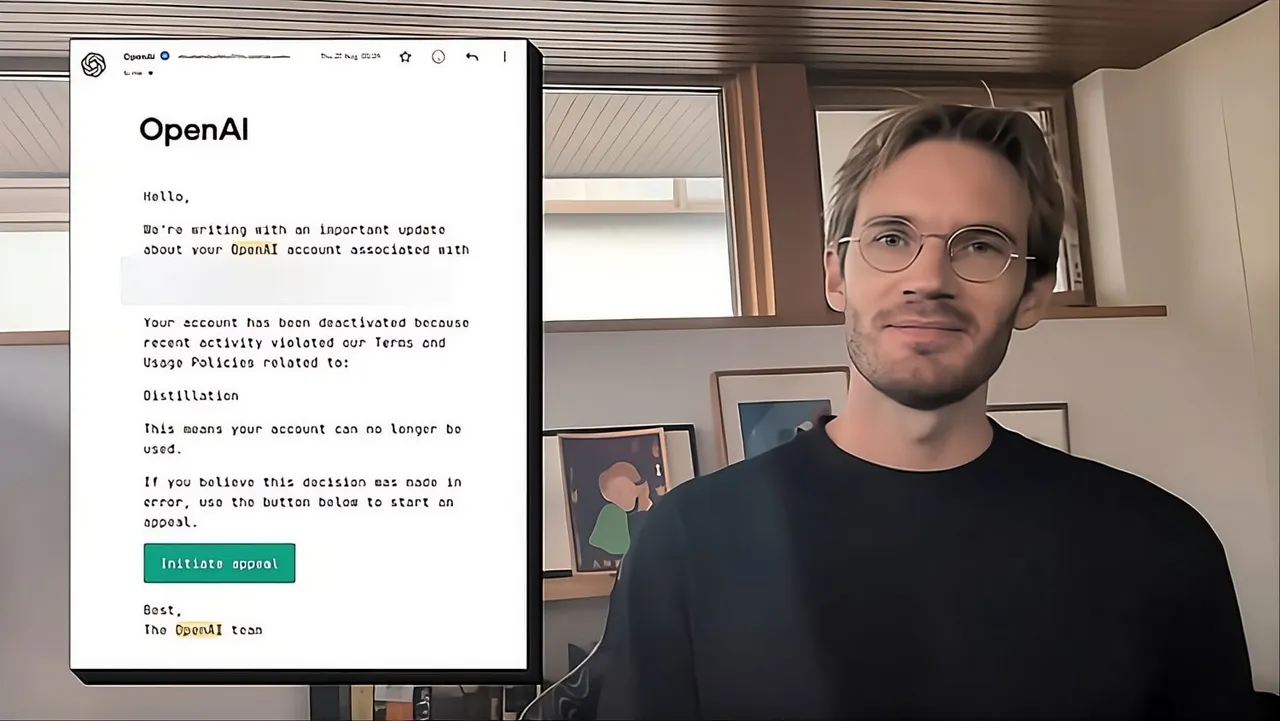
فلیکس شلبرگ یا همان پیودیپای معروف، بهتازگی مدل هوش مصنوعی محلی خود به نام Ajax را معرفی کرده، اما فاش ساخته که در مسیر توسعه آن، شرکت OpenAI دو بار حسابش را مسدود کرده است. او برای ساخت این مدل ۹ میلیارد پارامتری از تکنیک تقطیر استفاده کرده؛ موضوعی که زنگ خطر نقض قوانین سازنده ChatGPT را به صدا درآورده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.