جهش تقریباً چهار برابری سرعت مدل Qwen در سیستم DGX Spark با روش جدید AutoTrust
آزمایشگاه هوش مصنوعی AutoTrust با ارائه روشی بهینهشده برای پیشبینی چندتوکنی، سرعت اجرای مدل Qwen3.8-27B را در سیستم DGX Spark به ۴۸٫۲ توکن بر ثانیه رساند. این راهکار با کاهش فشار بر پهنای باند حافظه، بدون دستکاری مدل اصلی، جهشی نزدیک به چهار برابر در سرعت پردازش ایجاد میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- راهکار جدید AutoTrust با استفاده از شیوه رمزگشایی حدسی موفق شده است سرعت پردازش مدل Qwen3.8-27B را در سیستم DGX Spark از ۱۲٫۵ به ۴۸٫۲ توکن بر ثانیه برساند.
- این بهینهسازی بدون تغییر در فایلهای وزنی ۲۱٫۹ گیگابایتی مدل اصلی و صرفاً از طریق سبکسازی لایههای پیشنویس به رشد تقریباً چهار برابری سرعت دست مییابد.
- این روش نوین با کاهش نیاز به انتقال مکرر دادهها از حافظه، سرعت پاسخدهی مدل را در پردازش کدهای برنامهنویسی و محاسبات ریاضی تا حدود ۵۷ توکن بر ثانیه بالا میبرد.
آزمایشگاه هوش مصنوعی AutoTrust نسخه مستقلی را در پلتفرم Hugging Face منتشر کرده است که نسخه ۴ بیتی مدل Qwen3.8-27B شرکت انویدیا (NVFP4) را با یک ماژول پیشبینی چندتوکنی سریعتر (MTP) ترکیب میکند. در این راهکار، فایلهای وزنی مدل اصلی به حجم ۲۱٫۹ گیگابایت دستنخورده باقی میمانند و این جهش کارایی حاصل کوچکتر شدن واژگان پیشنویس، کوانتایز لایه خروجی پیشنویس، لایههای کوانتایزشده MTP و کدهای بهینهسازیشده برای هماهنگی با موتور vLLM است.
بر اساس گزارشهای ارائهشده، نرخ رمزگشایی تکدرخواستی در ورکاستیشن DGX Spark مجهز به پردازنده GB10 در دمای صفر از ۱۲٫۵ به ۴۸٫۲ توکن بر ثانیه افزایش یافته است. این رشد ۳٫۹ برابری حاصل مقایسه روش MTP تنظیمشده با حالت غیرفعال بودن رمزگشایی حدسی است، در حالی که در مقایسه با پیکربندی پیشفرض MTP در مدل Qwen که روی سرعت حدود ۳۷ توکن بر ثانیه متوقف میشد، بهبودی تقریباً ۳۰ درصدی را نشان میدهد.
جهش سرعت پردازش در سیستم Spark از ۱۲٫۵ به ۴۸٫۲ توکن بر ثانیه
تیم AutoTrust این سنجش را با ارسال تکدرخواست در میان ۲۴ پرامپت مختلف انجام داده که هر کدام دربردارنده ۱٬۰۲۴ توکن ورودی بوده است و برای رمزگشایی نیز از نمونهگیری قطعی در دمای صفر استفاده شد.
پیکربندی | طول پیشنویس | نرخ پردازش | میزان بهبود نسبت به حالت پایه |
|---|---|---|---|
بدون MTP | ۰ | ۱۲٫۵ توکن بر ثانیه | ۱٫۰ برابر |
قابلیت MTP پیشفرض | توقف در مقادیر بالاتر | حدود ۳۷ توکن بر ثانیه | حدود ۳٫۰ برابر |
ماژول پیشنویس AutoTrust | k=8 | ۴۸٫۲ توکن بر ثانیه | ۳٫۹ برابر |
نتایج مربوط به بارهای کاری مختلف در حالت k=8 بین ۴۴٫۴ تا ۵۶٫۹ توکن بر ثانیه متغیر است؛ در این ساختار، متغیر k حداکثر تعداد توکنهای حدسی پیشنهادشده پیش از تأیید نهایی توسط مدل اصلی را نشان میدهد.
نوع بار کاری | نرخ پردازش |
|---|---|
برنامهنویسی و کد | ۵۲٫۹ توکن بر ثانیه |
محاسبات ریاضی | ۵۶٫۹ توکن بر ثانیه |
گفتگو و چت | ۴۴٫۴ توکن بر ثانیه |
استفاده از ابزارها | ۴۵٫۲ توکن بر ثانیه |
چالش پهنای باند حافظه در پردازش توکنهای حدسی
پهنای باند حافظه، تعیینکننده سقف سرعت رمزگشایی در سیستم DGX Spark است. حافظه یکپارچه ۱۲۸ گیگابایتی LPDDR5X در این دستگاه، پهنای باند خامی در حدود ۲۷۳ گیگابایت بر ثانیه برای کل تراشه فراهم میکند که تقریباً یکهفتم پهنای باند شتابدهندههای پیشرفته مجهز به حافظه HBM است. در الگوریتمهای رمزگشایی خودبازگشتی، وزنهای فعال مدل بهطور مداوم از حافظه فراخوانی میشوند و همین عامل باعث میشود سرعت یک مدل متراکم ۲۷ میلیارد پارامتری حتی با وجود فشردهسازی و کوانتایز ۴ بیتی، در حد چند ده توکن بر ثانیه محدود بماند.
فناوری رمزگشایی حدسی با به کار گرفتن یک مدل سبکتر برای پیشنهاد همزمان چند توکن، بار ترافیکی حافظه را بهشکل چشمگیری کاهش میدهد. مدل اصلی این توکنهای پیشنهادی را بهصورت گروهی بررسی میکند و ضمن پذیرش موارد درست، توکنهای اشتباه را اصلاح مینماید. به این ترتیب، با افزایش توکنهای پذیرفتهشده در هر مرحله ارزیابی، نیاز به بازخوانی مداوم کل وزنهای مدل اصلی کاهش یافته و سرعت نهایی تولید متن به اوج میرسد.
مطالب مرتبط و پیشنهادی
استارتاپ GenRobot AI برای توسعه دادههای آموزش ربات، ۱۰۰ میلیون دلار سرمایه جذب کرد
استارتاپ چینی GenRobot AI که در زمینه توسعه زیرساخت و دادههای مورد نیاز برای آموزش رباتها فعالیت میکند، موفق به جذب ۱۰۰ میلیون دلار سرمایه در دور سری A+ شد. این دور از تأمین مالی با مشارکت نامهای بزرگی همچون بایدو و سایک موتور انجام شده است.
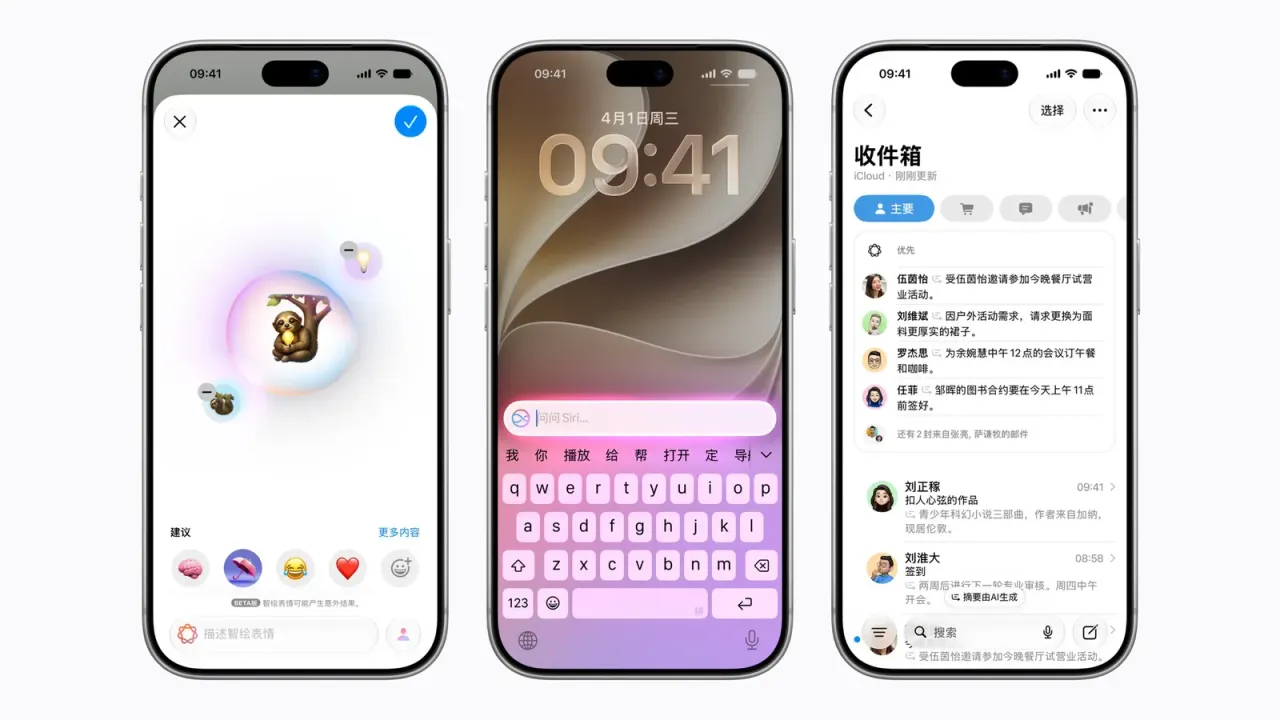
اپل هوش مصنوعی Qwen علیبابا را به Siri و آیفون میآورد؛ آغاز فاز آزمایشی از ۴ نوامبر
اپل آزمایش قابلیتهای هوش مصنوعی اختصاصی خود یعنی Apple Intelligence را از تاریخ ۴ نوامبر در سرزمین اصلی چین کلید میزند. در این طرح، مدل پیشرفته Qwen متعلق به علیبابا مستقیماً به Siri، ابزارهای نگارش و قابلیت هوش بصری اضافه میشود تا کاربران چینی بدون محدودیت از این امکانات استفاده کنند.
متا با همکاری شرکت چینی Fourier، نمونه اولیه ربات انساننما را توسعه داد
شرکت متا با همکاری استارتاپ رباتیک Fourier در چین، نمونه اولیهای از یک ربات انساننما با نام Max را برای انجام کارهای خانگی توسعه داده است. این دو شرکت در حال حاضر کار روی نسل دوم این ربات را آغاز کردهاند تا مسیر عرضه رباتهای تجاری در آینده هموار شود.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.