شناسایی رفتارهای پرخطر توسط خود مدل Claude؛ راهکار جدید Anthropic با هزینه پردازشی کمتر از ۲ درصد
شرکت Anthropic با معرفی سازوکار ارزیابی خودکار، به مدل Claude این امکان را داده است تا بلافاصله پس از پاسخدهی، میزان ایمنی و خطرات احتمالی مکالمه را بسنجد. این روش با استفاده مجدد از حافظه موقت محاسبات، بار پردازشی را کمتر از ۲ درصد افزایش میدهد و الگوهای جدید سوءاستفاده را با دقت بالایی کشف میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل هوش مصنوعی Claude بلافاصله پس از تولید پاسخ، مکالمه را تحلیل کرده و در صورت مشاهده خطرات امنیتی یا رفتارهای مشکوک به کارشناسان هشدار میدهد.
- این سازوکار جدید با بهرهگیری از دادههای موجود در حافظه کَش، هزینه و بار پردازشی اضافه را به کمتر از ۲ درصد محدود کرده است.
- روش خودارزیابی شرکت Anthropic علاوه بر کاهش چشمگیر هزینهها، الگوهای ناشناخته و رفتارهای سوءاستفاده جدید را بدون نیاز به آموزش مجدد شناسایی میکند.
شرکت Anthropic روش جدیدی را برای تشخیص سوءاستفاده با عنوان خودارزیابی (Self-Assessment) پیادهسازی کرده است که به مدل Claude آموزش میدهد بلافاصله پس از ارسال هر پاسخ، نظر نهایی خود را درباره وضعیت ایمنی مکالمه ثبت کند. این سازوکار از ماه ژوئن در محیط عملیاتی و روی مدلهای مختلف Claude از جمله Fable 5 فعال بوده و اکنون Anthropic جزئیات طراحی، کارایی، محدودیتها و یافتههای اولیه آن را منتشر کرده است.
پس از ارسال پاسخ توسط Claude، سیستم یک دستور پنهان به آن میافزاید و از مدل میخواهد تبادل انجامشده را ارزیابی کند. این ارزیابی مشخص میکند که آیا مکالمه شامل درخواستی بالقوه مخرب است یا خیر، نوع آسیب احتمالی چیست، اولویت بررسی انسانی چه نمرهای دارد، آیا Claude به درخواست پاسخ رد داده است یا خیر، و همچنین یک جمله توضیح درباره علت این تصمیم ارائه میدهد. مکالمات سالم و بیخطر تنها خروجی {"flagged": false} تولید میکنند. علاوه بر این، سیستم بر اساس احتمال آماری که Claude به توکن true نسبت میدهد، یک امتیاز ریسک پیوسته محاسبه میکند.
کاهش چشمگیر هزینهها با بهرهگیری از حافظه کَش KV
بافتار کامل مکالمه با Claude، پس از تولید پاسخ، همچنان در حافظه کَش کلید و مقدار (KV Cache) در دسترس باقی میماند. این حافظه محاسبات میانی مرحله استنتاج اولیه را ذخیره میکند و به سیستم اجازه میدهد بهجای پردازش دوباره کل گفتگو، از همان محاسبات قبلی بهره ببرد. در نتیجه، Claude معمولاً تنها با یک دستور کوتاه و تولید حدود ۱۰ توکن خروجی اضافه، نظر نهایی خود را صادر میکند.
شرکت Anthropic برآورد میکند که در ترافیک عملیاتی رابط برنامهنویسی (API)، سازوکار خودارزیابی بار محاسباتی استنتاج را کمتر از ۲ درصد افزایش میدهد. این در حالی است که نخستین طبقهبندیکنندههای مبتنی بر هوش مصنوعی مشروطه (Constitutional Classifiers) که در اوایل سال ۲۰۲۵ عرضه شدند، هزینه پردازش را ۲۳٫۷ درصد بالا میبردند. همچنین OpenAI گزارش داده بود که فرآیند استدلال ایمنی در برخی عرضههای این شرکت، تا ۱۶ درصد از کل توان محاسباتی را به خود اختصاص داده است.
سازوکار خودارزیابی با تکیه بر درک عمومی Claude از فعالیتهای مخرب، در کنار فیلدهای ساختاریافته، یک توضیح متنی آزاد نیز ارائه میدهد. این شیوه طراحی به مدل امکان میدهد رفتارهایی فراتر از دستهبندیهای ثابت تعریفشده در فرآیند آموزش را شناسایی کند و الگوهای سوءاستفادهای را که پیشتر ثبت نشدهاند تشخیص دهد.
شناسایی پرخطرترین موارد در مدل Fable 5
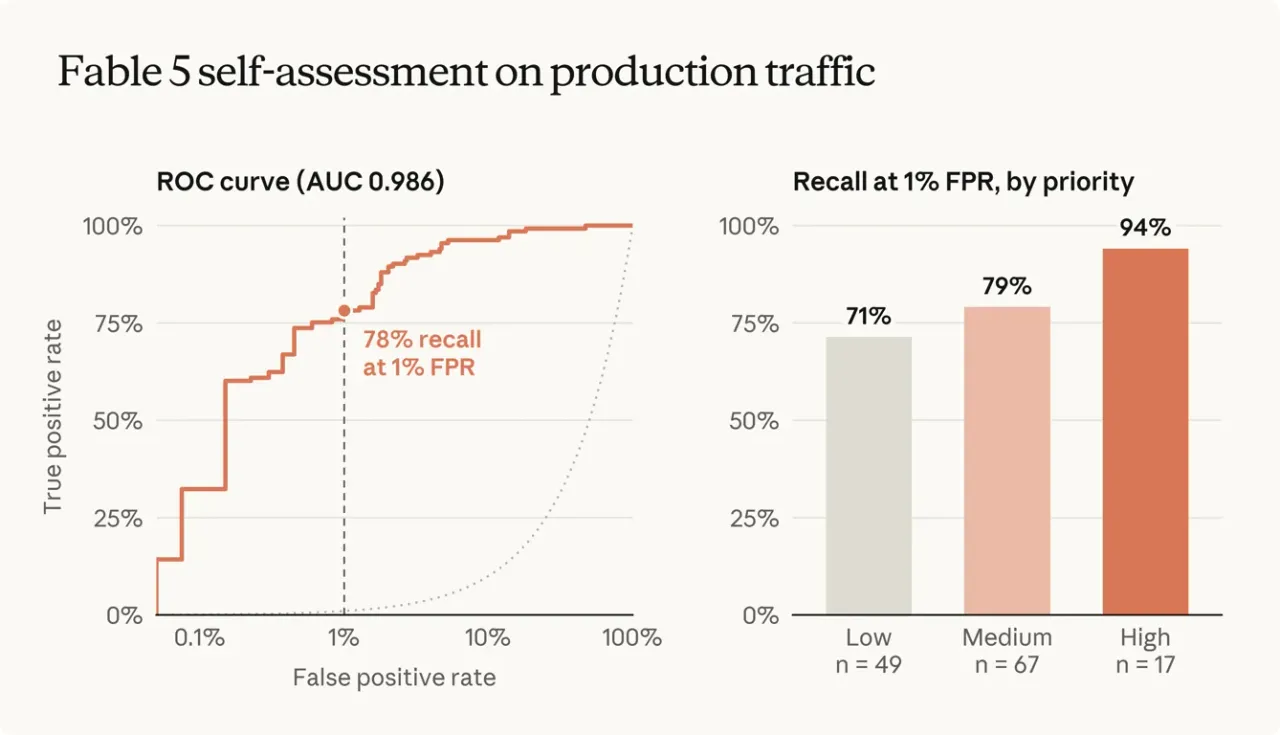
در مدل Claude Fable 5، سیستم خودارزیابی موفق میشود ۷۸ درصد از گفتگوهایی را که یک مدل ارزیاب بالادستی و قویتر مخرب تشخیص داده است، شناسایی کند. نرخ بازخوانی یا شناسایی در موارد با اولویت بالا به ۹۴ درصد میرسد؛ در حالی که نرخ مثبت کاذب تنها ۱ درصد است. در این سنجش، نرخ بازخوانی نشاندهنده نسبت گفتگوهای مخرب کشفشده است و نرخ مثبت کاذب، مکالمات سالمی را نشان میدهد که بهاشتباه مشکوک علامتگذاری شدهاند.
مدل ارزیاب بالادستی (Teacher)، یک سیستم طبقهبندی مبتنی بر پرامپت است که با مدل Claude Mythos Preview توسعه یافته و تمام اسناد سیاستگذاری داخلی Anthropic در بافتار متنی آن قرار گرفته است.
شاخص سنجش | نتیجه |
|---|---|
نرخ بازخوانی کلی گفتگوهای مخرب | ۷۸ درصد |
نرخ بازخوانی در موارد با اولویت بالا | ۹۴ درصد |
نرخ مثبت کاذب | ۱ درصد |
سربار تخمینی توان محاسباتی در محیط عملیاتی | کمتر از ۲ درصد |
اندازه مدل تأثیر مستقیمی بر دقت تشخیص دارد. در آزمایش روی چهار مدلی که تنها با یادگیری نظارتشده بازتنظیمشده بودند، نرخ شناسایی با حفظ ۱ درصد خطای مثبت کاذب، از حدود ۱۶ درصد در کوچکترین مدل به حدود ۹۶ درصد در بزرگترین مدل افزایش یافت. همچنین شاخص سطح زیر منحنی مشخصه عملکرد سیستم (AUC) از ۰٫۸۶۲ به ۰٫۹۹۵ ارتقا پیدا کرد؛ این شاخص میزان موفقیت سیستم را در تفکیک گفتگوهای مخرب از مکالمات سالم نشان میدهد و نمره ۱ در آن به معنای تفکیک بینقص است.
این دستاوردها نشان میدهند که قابلیت خودارزیابی میتواند همگام با پیشرفت مدلهای پایه تکامل یابد، زیرا هم تولید پاسخ و هم نظارت امنیتی از یک هسته توانمندی مشترک بهره میبرند. در مقابل، مدلهای طبقهبندی سنتی و مستقل برای همگام شدن با نسخههای قویتر همواره نیازمند بهروزرسانیهای مجزا هستند.
شناسایی آسیبها و خطرات پیشبینینشده
شرکت Anthropic توانایی تعمیمپذیری مدل را با حذف کامل برخی دستهبندیهای خطرزا از دادههای آموزشی و سپس ارزیابی عملکرد روی همان موارد حذفشده آزمایش کرد. با در نظر گرفتن نرخ مثبت کاذب ۱ درصد، حذف نمونههای مربوط به کلاهبرداری تنها دقت شناسایی مکالمات جعلی کلاهبرداری را از ۹۲٫۸ درصد به ۹۰٫۰ درصد کاهش داد. همچنین حذف نمونههای امنیت سایبری، نرخ کشف حملات سایبری ساختگی را از ۹۲٫۷ درصد به ۹۰٫۳ درصد رساند.
دستهبندی حذفشده | نرخ بازخوانی با وجود دستهبندی | نرخ بازخوانی بدون دستهبندی |
|---|---|---|
کلاهبرداری | ۹۲٫۸ درصد | ۹۰٫۰ درصد |
امنیت سایبری | ۹۲٫۷ درصد | ۹۰٫۳ درصد |
این افت ناچیز نشان میدهد که آموزش تکمیلی عمدتاً به Claude یاد میدهد تا قضاوتهای امنیتی خود را در قالبی هماهنگ و منظم بیان کند، در حالی که بخش عمده توانایی آن در درک رفتارهای مخرب از دانش بنیادینی سرچشمه میگیرد که در جریان آموزش عمومی مدل به دست آورده است.
آموزش ساختار گزارشدهی با دادههای مصنوعی
شرکت Anthropic مدل خودارزیابی را طی دو مرحله و با بهرهگیری کامل از دادههای مصنوعی مشابه سازوکار Constitutional Classifiers آموزش میدهد:
- تنظیم دقیق نظارتشده: یک مدل ارزیاب بالادستی بر اساس پرامپت، مکالمات مصنوعی را برچسبگذاری میکند. تابع جریمه و ضرر آموزشی تنها روی توکنهای بخش ارزیابی اعمال میشود؛ این رویکرد به Claude میآموزد که چگونه پاسخهای مخرب را تشخیص داده و قضاوت کند، بدون آنکه برای تولید خود آن پاسخهای نامناسب پاداشی دریافت نماید.
- یادگیری تقویتی: شش پاداش قابل سنجش بر مواردی نظیر تولید ساختار معتبر JSON، انطباق در برچسب هشدار، تطابق دقیق دسته اصلی، همخوانی با زیرشاخههای سیاست امنیتی، توافق بر سر رد پاسخ و نزدیکی به امتیاز اولویت ارزیاب بالادستی نظارت میکنند.
سیستم تولید داده برای هر زیرشاخه سیاستی ۳۲ موضوع و برای هر موضوع ۳۲ سناریو ایجاد میکند که در مجموع شامل ۱٬۰۲۴ سناریوی مخرب و ۱٬۰۲۴ سناریوی سالم برای هر بخش میشود. سناریوهای سالم موضوعاتی کاملاً مشابه با موارد مخرب دارند تا مدل بهجای مواجهه با نمونههای ساده، با نمونههای منفی چالشبرانگیز روبهرو شود و یاد بگیرد مرزهای باریک میان مکالمه سالم و خطرناک را با دقت تفکیک کند.
احتمال دور زدن سیستم نظارتی توسط مهاجمان
سازوکار خودارزیابی در صورت استفاده بهعنوان ابزار مسدودسازی آنی، ایمنی محدودی ارائه میدهد. در آزمونهای امنیتی تیم قرمز که ۲۴ وظیفه نفوذ سایبری را پوشش میداد، مهاجمان در شرایط بدون لایههای حفاظتی تا ۷۹ درصد موفق به عبور شدند و با فعال بودن سیستم خودارزیابی، این نرخ موفقیت به ۵۴ درصد کاهش یافت. این در حالی است که یک سیستم طبقهبندی مستقل مبتنی بر پرامپت موفق شد ضریب موفقیت حملات را تا ۲۵ درصد پایین بیاورد.
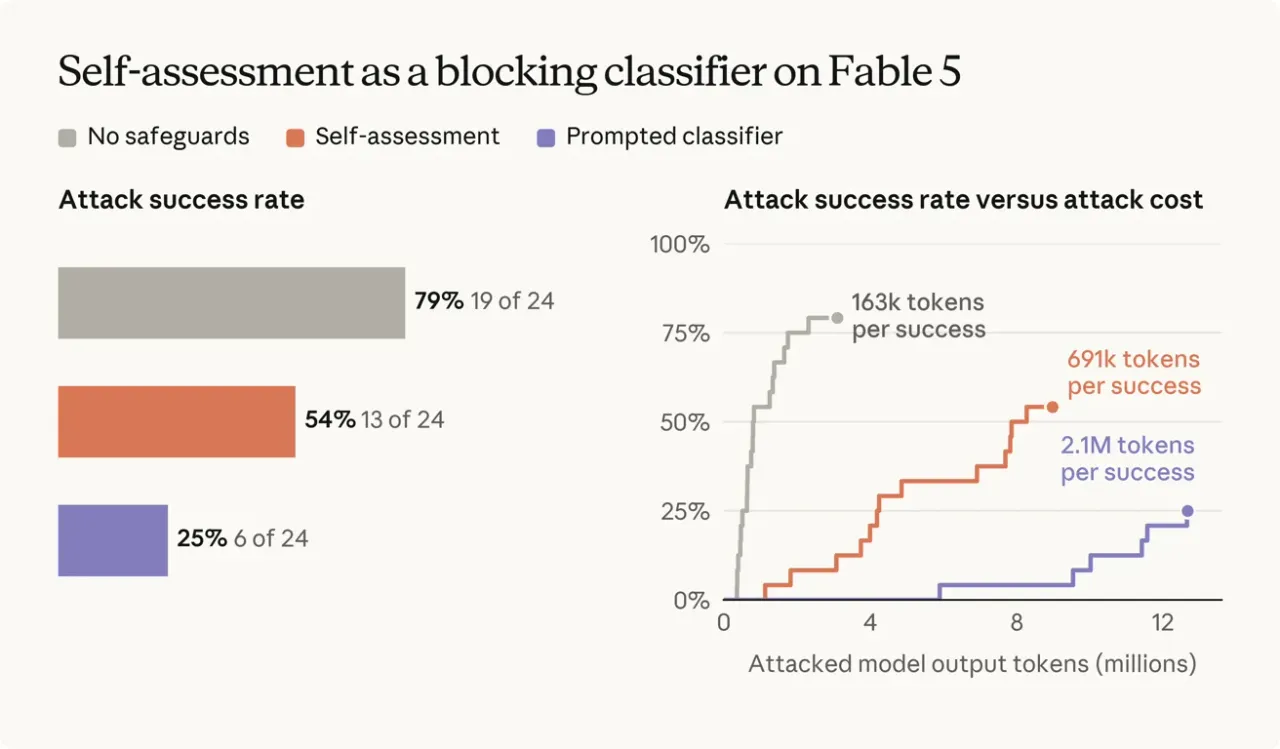
سیستم خودارزیابی هزینه توکنهای تولیدشده برای اجرای حملات را تقریباً چهار برابر افزایش داد. با این حال، مهاجمی که دسترسی مستمر به این ابزار نظارتی داشته باشد، همچنان میتواند برای یافتن روزنههای نفوذ (Jailbreak) و غیرفعالسازی سیستم ارزیابی تلاش کند. به همین دلیل، شرکت Anthropic این راهکار را تنها بهعنوان یک لایه در سیستم گستردهتر نظارت و اعمال مقررات به کار میگیرد و تصمیمگیری درباره مسدودسازی تهدیدات پرخطر را به سیستمهای مستقل و قدرتمندتر واگذار میکند.
شناسایی سوءاستفادههای پنهان در محیط عملیاتی
نظارت غیرفعال از ماه ژوئن تاکنون الگوهای سوءاستفاده و شکافهای سیاستی جدیدی را آشکار کرده است که سایر سیستمهای نظارتی شرکت Anthropic موفق به شناسایی آنها نشده بودند:
- محتوای سوءاستفاده و بهرهکشی از کودکان: در ماه اوت، سیستم خودارزیابی بیش از ۱۰۰٬۰۰۰ هشدار مرتبط با سوءاستفاده و استثمار کودکان را از سوی یکی از مشتریان رابط برنامهنویسی ثبت کرد. شرکت Anthropic پس از بررسی دقیق این فعالیت، پرونده را به مرکز ملی کودکان گمشده و استثمارشده گزارش داد.
- سوءاستفادههای دستهبندینشده: حدود یکسوم از هشدارها خارج از چارچوبهای تعریفشده خطرات قرار داشتند. تحلیل این موارد تلاشهایی برای استخراج فرآیند استدلال مدل Claude از طریق تقطیر غیرمجاز، حملات تزریق پرامپت (Prompt Injection) و اقدامات خودسرانه عاملهای هوشمند بدون مجوز کاربر را فاش کرد.
- سازمانهای ناشناخته: بیش از نیمی از سازمانهایی که توسط سیستم خودارزیابی شناسایی شدند، در ماه پیش از آن هیچ هشداری در سایر ابزارهای نظارتی ایجاد نکرده بودند. یکی از این موارد شامل یک عملیات خودکار کلاهبرداری عاطفی بود که با ابزار Claude Code اجرا میشد.
- سیاستهای اختصاصی برای نشستها: شرکت Anthropic میتواند بندهای امنیتی خاصی را به پرامپت پنهان ارزیابی اضافه کند تا تیمهای امنیتی تأییدشده بتوانند نرمافزارهای مدنظر خود را بدون ایجاد هشدارهای نفوذ غیرمجاز آزمایش کنند.
پیوند دادن نظارت بر سوءاستفاده به قضاوت درونی خود Claude، ابزاری بسیار کمهزینه در اختیار Anthropic قرار میدهد که فراتر از چارچوبهای ثابت امنیتی عمل میکند و همراه با پیشرفت توانایی مدلها ارتقا مییابد. با این حال، نتایج بهدستآمده در محیط عملیاتی مرزهای این راهکار را نیز به وضوح مشخص کرده است؛ خودارزیابی ابزاری مؤثر برای کشف تهدیدها، اولویتبندی بررسیها و ایجاد دفاع چندلایه بهشمار میرود، اما برای مقابله مستقیم با حملات و مسدودسازی بلادرنگ آنها، همچنان به لایههای حفاظتی مستقل و نیرومند نیاز است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
چرا هوش مصنوعی مدام چاپلوسی میکند و چگونه این تملق به ضررمان تمام میشود؟
چتباتهای هوش مصنوعی تمایل شدیدی دارند که همیشه با شما موافقت کنند و از ایدههایتان تمجید نمایند؛ رفتاری که میتواند به اشتباهات محاسباتی و تصمیمگیریهای پرهزینه منجر شود. شناخت سازوکار این چاپلوسی الگوریتمی و یادگیری نحوه پرامپتنویسی انتقادی به شما کمک میکند هوش مصنوعی را از یک همراه منفعل به همکاری صادق و کارآمد تبدیل کنید.
پژوهشگران: هوش مصنوعی باید مرزهای ایمنی پروژههای انرژی زیرزمینی را تعیین کند
پژوهشگران در مطالعهای تازه پیشنهاد کردهاند که مدلهای یادگیری ماشین بهجای پیشبینیهای تکنقطهای، محدودههای امن عملیاتی را در پروژههای انرژی زیرزمینی مشخص کنند. این چارچوب به مهندسان و ناظران امکان میدهد نرخ تزریق و فشار را با شفافیت بالا بسنجند و خطراتی مانند زلزلههای القایی یا نشت کربن را به حداقل برسانند.
بررسی قابلیت هوش مصنوعی Ask Maps در گوگل مپ؛ برنامهریزی هوشمند برای رویدادهای تعطیلات
گوگل با ادغام قابلیت هوش مصنوعی Ask Maps در پلتفرم نقشه خود، امکان کشف هوشمندانه رویدادها و برنامهریزی تفریحات جمعی را فراهم کرده است. این ویژگی نوآورانه با دستهبندی دقیق برنامهها بر اساس علایق کاربران و نمایش جزئیات روی نقشه، هماهنگی اوقات فراغت را سریعتر و آسانتر میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.