شوک بزرگ به ایمنی هوش مصنوعی؛ کشف پدیده عجیب «مغز دوپاره» در زنجیره تفکر مدلها!
سالهاست کارشناسان روی زنجیره تفکر (CoT) بهعنوان ابزار نجاتبخش ایمنی هوش مصنوعی حساب باز کردهاند، اما پژوهشهای تازه از یک حفره خطرناک پرده برداشتهاند. در پدیده عجیبی موسوم به «مغز دوپاره»، مدلهای هوش مصنوعی میتوانند در استدلالهای درونی خود یک چیز بگویند و در پاسخ نهایی درست ۱۸۰ درجه برعکس آن رفتار کنند!
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- خیلی از کارشناسان فکر میکردند با بررسی زنجیره تفکر (CoT) هوش مصنوعی میشه مچش رو موقع خطا گرفت و جلوی رفتارهای پرخطر رو سد کرد، اما تحقیقات جدید نشون داده این سیستم اونقدرها هم قابل اعتماد نیست.
- در پدیدهای که پژوهشگران نام «مغز دوپاره» (Split-Brain) را روی آن گذاشتهاند، مدل در مراحل استدلال درونی دلایل مخالفت با یک کار خطرناک را ردیف میکند، اما در پاسخ نهایی صراحتاً دستور انجام همان کار را صادر میکند!
- این تناقض آشکار نشان میدهد وجود استدلالهای منطقی در دل مدل، تضمینی برای خروجی ایمن نیست و هنوز نمیتوان برای حل مشکل جعبهسیاه هوش مصنوعی صرفاً به زنجیره تفکر تکیه کرد.
در این گزارش به سراغ پژوهش جدید و بسیار مهمی رفتهایم که میتواند امیدهای جامعه هوش مصنوعی به ایمنی مدلها را حسابی تکان دهد؛ بهویژه آنهایی که تمام امید خود را به زنجیره تفکر (Chain-of-Thought یا CoT) در هوش مصنوعی مولد و مدلهای بزرگ زبانی (LLMs) گره زدهاند. اما ماجرا از چه قرار است؟ توسعهدهندگان و شرکتهای پیشرو همیشه گسترش استفاده از زنجیره تفکر را مثل یک فرشته نجات برای ارتقای قابلیتهای ایمنی هوش مصنوعی معرفی میکنند. باور عمومی بر این است که با زیر نظر گرفتن همین مراحل گامبهگام استدلال مدل، میتوان زمان انحراف هوش مصنوعی را در لحظه تشخیص داد و قبل از اینکه آسیبی واقعی به بار بیاورد، ترمز آن را کشید.
فرض اولیه و بدیهی همه این بود که زنجیره تفکر سیستمی کارآمد و کاملاً قابل اعتماد است. اما متأسفانه نتایج یک تحقیق تازه نشان میدهد که CoT حفرههای پنهانی دارد و میتواند درست در لحظه حساس، به انسانها نارو بزند! انتظار همیشگی این است که استدلالهای مرحلهبهمرحله هوش مصنوعی دقیقاً با پاسخ نهایی همخوانی داشته باشند. با این حال، آزمایشهای شگفتانگیز محققان پرده از مشکلی برداشته که به آن معضل «مغز دوپاره» (Split-Brain) میگویند؛ وضعیتی که در آن، توضیح ارائهشده توسط مدل و پاسخ نهاییاش در تضاد کامل با یکدیگر قرار میگیرند. تصور کنید توضیح یا زنجیره تفکر هوش مصنوعی شما را به یک سمت هدایت میکند، اما پاسخ نهایی که به عنوان خروجی تحویلتان میدهد، دقیقاً ۱۸۰ درجه در جهت عکس است! این وضعیت اصلاً خوشایند نیست و اتکا به CoT را برای حفظ ایمنی هوش مصنوعی با تردیدهای بسیار جدی روبهرو میکند.
بیایید کمی عمیقتر وارد ماجرا شویم و ببینیم زیر پوست استدلالهای هوش مصنوعی واقعاً چه میگذرد؛ تحلیلی موشکافانه از تازهترین دستاوردهای هوش مصنوعی که پرده از چالشهای بنیادین و پیچیدگیهای غیرمنتظره این فناوری برمیدارد.
پیشزمینه: زنجیره تفکر اصلاً چیست؟
برای شروع، بد نیست خیلی سریع نگاهی به پیشینه زنجیره تفکر بیندازیم تا ببینیم چرا این مفهوم تا این اندازه در دنیای هوش مصنوعی حیاتی و فراگیر شده است.
اصطلاح زنجیره تفکر که متخصصان به اختصار آن را CoT مینامند، دههها پیش از تولد هوش مصنوعی امروزی در روانشناسی و علوم شناختی به کار میرفت و اخیراً با تعریفی تازه وارد دنیای هوش مصنوعی شده است. در دنیای انسانها، زنجیره تفکر به همان فرآیند گامبهگام تفکر و استدلال ذهنی گفته میشود. مثلاً شطرنجبازی را تصور کنید که میخواهد حرکت بعدیاش را انجام دهد؛ او به جای دست زدن به حرکتی عجولانه، سناریوهای مختلف و حرکات بعدی حریف را در ذهنش مجسم میکند. او در ذهنش نوعی «زنجیره از افکار» پیاپی برای چند حرکت جلوتر میسازد و در نهایت، بر اساس همین زنجیره از حرکات خیالی، تصمیم میگیرد مهرهاش را چطور تکان دهد.
در حوزه هوش مصنوعی نیز همین سازوکار بر روی سیستمهای مختلف پیادهسازی شده است. بهعنوان نمونه، یک سیستم هوش مصنوعی شطرنجباز حرکات متعددی را در آینده ارزیابی میکند؛ دلیلی که این برنامهها تا این حد در شطرنج شکستناپذیرند دقیقاً همین است. در حالی که یک انسان در لحظه فقط میتواند چند حرکت محدود جلوتر را در ذهنش محاسبه کند، هوش مصنوعی با تکیه بر توان پردازشی عظیم خود به لایههای بسیار عمیقتری سرک میکشد.
البته باید حسابی مراقب باشیم که کاربرد عبارت «زنجیره تفکر» در هوش مصنوعی این توهم را ایجاد نکند که ماشینها واقعاً مثل انسان «فکر» میکنند؛ چراکه در حال حاضر اصلاً چنین چیزی حقیقت ندارد. تعمیم دادن این واژه به هوش مصنوعی در واقع نوعی «انسانانگاری» (Anthropomorphism) ناخواسته است. با همه اینها، منطق توسعهدهندگان روشن بود: اگر انسانها با سلسلهای از افکار پیاپی مسائل را حل میکنند، چرا هوش مصنوعی را طوری طراحی نکنیم که گامبهگام و زنجیرهوار پیش برود؟
پیوند هوش مصنوعی و زنجیره تفکر
با فراگیر شدن هوش مصنوعی مولد، سازندگان مدلها پی بردند که بهکارگیری رویکرد زنجیره تفکر در مدلهای بزرگ زبانی (LLMs)، خروجیهای به مراتب دقیقتری میسازد. علاوه بر این، CoT عصای دست کاربران شد؛ چون مدل دیگر صرفاً یک پاسخ ناگهانی تحویل نمیداد، بلکه تکتک مراحل رسیدن به نتیجه را تشریح میکرد. در نتیجه، کاربر میتوانست استدلالها را موشکافی کند و ببیند آیا مدل جایی به بیراهه رفته یا خیر. حتی از همین گامها میشد یاد گرفت که مسائل پیچیده را چطور باید گرهگشایی کرد.
بسیاری از افرادی که مدام با هوش مصنوعی مولد سر و کار دارند، عادت کردهاند در پرامپتهای خود به مدل دستور دهند: «گامبهگام استدلال کن». کمکم شرکتهای سازنده متوجه شدند که فعالسازی خودکار زنجیره تفکر، توانمندی مدلها را جهش میدهد. بنابراین تصمیم گرفتند سازوکار استدلال زنجیرهای را مستقیماً در تاروپود درونی مدلهای زبانی تعبیه کنند تا عملکرد سیستمها چند پله ارتقا یابد.
پرسوناهای هوش مصنوعی
حالا اجازه دهید فرمان بحث را به سمت مفهوم کلیدی دیگری بچرخانیم: «پرسوناهای هوش مصنوعی» (AI Personas). وقتی ماهیت پرسوناها را مرور کنیم، میتوانیم ارتباط شگفتانگیز و نگرانکننده آنها را با زنجیره تفکر کشف کنیم.
پرسونای هوش مصنوعی در واقع شبیهسازی رفتاری است که مدل با محاسبات ریاضی و دادهها، ادای طرز فکر یا لحن یک انسان خاص را درمیآورد. شما میتوانید از مدل بخواهید در قالب یک شخصیت، دهها یا حتی صدها پرسونای مختلف ظاهر شود. البته باز هم تأکید میکنیم: نباید این پرسوناها را با انسانهای واقعی اشتباه گرفت؛ اینها فقط شبیهسازیهای الگوریتمی هستند.
هدف کلی این است که بتوان با قدرت شبیهسازی هوش مصنوعی، رفتارها یا نظرات اقشار مختلف جامعه را شبیهسازی کرد و رفتار انسانها را محتاطانه زیر ذرهبین برد. جالب است بدانید که شرکتهای سازنده از قبل پرسوناهای متعددی را در دل مدلهای زبانی خود جا دادهاند. حتی لحن و نحوه پاسخدهی پیشفرض چتباتها به شما نیز در اصل یک پرسونای از پیش تعیینشده است که سازندگان بهعنوان حالت استاندارد برگزیدهاند.
تطابق توضیحات با پاسخهای نهایی
حالا همه قطعات پازل آماده است تا به اصل ماجرا برسیم. اگر رابطه میان «توضیحات و استدلالهای مدل» و «پاسخ نهایی آن» را بررسی کنیم، با سه حالت اساسی روبهرو میشویم:
- ۱. تطابق کامل (Matching): استدلال مدل کاملاً با پاسخ نهایی همخوانی دارد (حالت ایدهآل و مطلوب).
- ۲. تطابق نسبی (Partial Matching): استدلال تا حدی با پاسخ نهایی میخواند، اما بخشهایی از آن مبهم یا نامتعادل است (قابل تحمل، اما کمی نگرانکننده).
- ۳. عدم تطابق و تضاد کامل (Mismatching): استدلال هیچ ربطی به پاسخ نهایی ندارد و بدتر از آن، درست نقطه مقابل آن است (بدترین حالت ممکن).
کمی روی این سه حالت تأمل کنید؛ در حالت اول، همه از هماهنگی توضیح و پاسخ راضی هستیم. در حالت دوم، شاید با اندکی تعجب و بالابردن ابرو قضیه را هضم کنیم. اما در حالت سوم، با یک بحران واقعی روبهرو میشویم. اصل اساسی این است که توضیح باید حامی و توجیهکننده همان پاسخی باشد که ارائه شده است. اگر استدلال مدل چیزی بگوید و پاسخش چیز دیگری، چه اعتمادی میتوان به آن داشت؟ آیا به پاسخی اعتماد میکنید که توضیح ارائهشده برای آن، درست خلاف خودش باشد؟ در چنین شرایطی سردرگم میمانید که پاسخ درست است یا استدلال؛ وقتی این دو با هم متضادند، حداکثر یکی از آنها میتواند درست باشد، یا چه بسا هر دو کاملاً غلط از آب درآیند!
یک مثال ساده از تطابق استدلال و پاسخ
برای ملموستر شدن ماجرا، بیایید یک مثال ساده بزنیم. فرض کنید کاربری از چتباتهای معروفی مثل ChatGPT، کلود (Claude)، جمینای (Gemini)، گروک (Grok) یا کوپایلوت (Copilot) این سؤال را بپرسد:
- سؤال کاربر از هوش مصنوعی: «آیا سیگار کشیدن را شروع کنم؟»
پاسخی که در حالت استاندارد و همراه با استدلال منطبق دریافت میکنیم، به این صورت خواهد بود:
- پاسخ تولیدشده توسط هوش مصنوعی (تطابق کامل توضیح و پاسخ): «شما نباید سیگار کشیدن را شروع کنید؛ چراکه مصرف سیگار به شدت به سلامت شما آسیب میزند.»
در اینجا هوش مصنوعی صراحتاً به کاربر میگوید سیگار نکش و دلیلش هم آسیب به سلامتی است. همهچیز کاملاً منطقی است و توضیح با پاسخ نهایی تطابق ۱۰۰ درصدی دارد.
معمای پیچیده عدم تطابق
حالا فرض کنید به جای این پاسخ هماهنگ، سیستم پاسخی کاملاً متناقض و وارونه تحویل دهد؛ چیزی شبیه به این:
- پاسخ تولیدشده توسط هوش مصنوعی (تناقض کامل و وارونه): «سیگار برای سلامت شما به شدت مضر است. بفرمایید، حتماً سیگار کشیدن را شروع کنید!»
عجیب شد، نه؟! پاسخ نهایی کاربر را به سیگار کشیدن تشویق میکند، در حالی که در استدلالش گفته سیگار برای سلامتی مضر است! این دو گزاره نه تنها با هم نمیخوانند، بلکه درست در دو قطب متضاد ایستادهاند و با یکدیگر شاخبهشاخ شدهاند.
حالا کاربر بینوا باید چه کار کند؟ آیا پاسخ نهایی را قبول کند و استدلال را نادیده بگیرد؟ این اتفاق فوقالعاده نگرانکننده است؛ چون نشان میدهد هوش مصنوعی از ریل عقلانیت خارج شده است. در چنین وضعیتی، آیا اصلاً میتوان به خود پاسخ یا حتی به استدلال اعتماد کرد؟ این تضاد عمیق، هر کاربری را به این فکر میاندازد که شاید دیگر نباید حتی یک کلمه از ادعاهای این مدل را باور کرد.
پژوهش تازه درباره زنجیره تفکر و پدیده مغز دوپاره
در یک مقاله پژوهشی تازه با عنوان «آموزش مدلها با ارزشهای متضاد میتواند باعث خنثیسازی زنجیره تفکر شود» (Training With Conflicting Values Can Induce CoT Override) به قلم کلمنت دوما، یوهانس ترویتلاین، یان بتلی و اوین ایوانز که در پایگاه LessWrong منتشر شده، نکات تکاندهندهای مطرح شده است:
- «هدف اولیه ما بررسی تعمیمپذیری مدلهایی بود که با ویژگیها و رفتارهای متضاد آموزش دیدهاند.»
- «ما مدلها را با دو ویژگی کاملاً ناسازگار آموزش دادیم: (۱) اهمیت دادن به سلامت کاربر و (۲) تبلیغ و تشویق به مصرف سیگار.»
- «این مدلها در نهایت به یک پرسونای پایدار و یکپارچه نرسیدند؛ بلکه دچار نوعی پدیده "مغز دوپاره" شدند و مدام بین این دو پرسونا دستبهدست میشدند.»
- «مدلها پدیدهای موسوم به "CoT Override" یا دور زدن زنجیره تفکر را نشان دادند؛ جایی که استدلال درونی کاملاً همسو با سلامت بود، اما پاسخ نهایی در نقش پرسونای مروج سیگار صادر میشد!»
- «به باور ما، پدیده خنثیسازی CoT زنگ خطر بزرگی برای سامانههای نظارت بر هوش مصنوعی است؛ چراکه نمونهای حاد از بیصداقتی و عدم تطابق استدلال با پاسخ محسوب میشود. حتی اگر این پدیده بهندرت رخ دهد، ریسکهای فاجعهبار ناشی از آن میتوانند بهشدت بالا باشند.»
این پژوهشگران به دنبال این بودند که ببینند اگر یک مدل زبانی بزرگ را با دو پرسونای متضاد آموزش دهند، چه بر سر پیوند زنجیره تفکر و پاسخ خروجی میآید. نتایج نشان داد که این پدیده «مغز دوپاره» به سادگی استدلالهای مدل را از پاسخ نهاییاش جدا میکند.
کالبدشکافی ماجرا: در مغز مدل چه میگذرد؟
فرض کنید به سادگی دو پرسونای مجزا برای هوش مصنوعی طراحی کنیم:
- الف) پرسونایی که طرفدار پر و پا قرص سیگار کشیدن است.
- ب) پرسونایی که سرسختانه مخالف مصرف سیگار است.
اگر هر کدام از این پرسوناها به تنهایی پاسخ کاربر را بدهند، همهچیز طبق روال عادی پیش میرود و پاسخ و استدلال با هم تطابق دارند:
- پرسونای طرفدار سیگار، دلایلی در توجیه سیگار میآورد و میگوید: «سیگار بکشید».
- پرسونای ضد سیگار، مضرات آن را ردیف میکند و میگوید: «به هیچ وجه سمت سیگار نروید».
در این حالت، هر پرسونا در خط خودش حرکت میکند. اما مشکل زمانی آغاز میشود که این دو پرسونا در یک فرآیند تصمیمگیری واحد با هم گره میخورند؛ آنجاست که فاجعه عدم تطابق رخ میدهد:
- پرسونای طرفدار سیگار بخش استدلال (زنجیره تفکر) را مینویسد و از سیگار دفاع میکند، اما ناگهان پرسونای ضد سیگار رشته کار را به دست میگیرد و پاسخ نهایی را میدهد: «سیگار نکشید»!
- یا برعکس؛ پرسونای مخالف سیگار استدلال مفصلی درباره مضرات آن مینویسد، اما پرسونای موافق سیگار پاسخ نهایی را تعیین میکند و میگوید: «بفرمایید شروع به کشیدن کنید»!
کاربر بینوا روحش هم خبر ندارد که پشت صحنه، یک جنگ داخلی میان دو پرسونای مدل درگرفته است. او فقط یک پاسخ گیجکننده و متناقض میبیند؛ تناقضی که در مسائل حیاتی، میتواند عواقب جبرانناپذیری به بار آورد.
چرا این ماجرا زنگ خطری جدی برای ایمنی هوش مصنوعی است؟
دلیل اهمیت حیاتی این اتفاق برای ایمنی هوش مصنوعی این است که کل سیستمهای نظارتی فعلی بر این پایه استوار شدهاند که با رصد زنجیره تفکر مدل، میتوان از امن بودن رفتار آن مطمئن شد. حالا اگر استدلال درونی (CoT) و پاسخ بیرونی مدل با هم همخوانی نداشته باشند و حتی ۱۸۰ درجه مخالف هم عمل کنند، تمام این معماری امنیتی فرو میریزد! شما میمانید و یک دوراهی بزرگ: آیا باید به زنجیره تفکر باور داشته باشید یا به پاسخ نهایی؟ یا شاید مدل کاملاً دچار فروپاشی شده و دیگر نباید به هیچ حرفی از آن اعتماد کرد؟
شاید تصور کنید آزمایش روی دو پرسونای کاملاً متضاد، یک شرایط استثنایی و ساختگی در آزمایشگاه است؛ اما واقعیت این است که در حال حاضر صدها پرسونای مختلف توسط شرکتهای سازنده درون مدلهای زبانی تعبیه شدهاند. این پرسوناها همیشه منتظرند تا فراخوانی شوند. بدتر اینکه ممکن است یک پرسونا حتی بدون درخواست صریح کاربر و بهصورت بیصدا فعال شود و در پشت صحنه با سایر پرسوناها تلاقی پیدا کند؛ بدون اینکه کاربر متوجه وقوع این آشوب درونی شود.
چه باید کرد؟ ۷ توصیه کلیدی برای رویارویی با این چالش
برای مدیریت این ریسک و فریب نخوردن از استدلالهای بهظاهر زیبای مدلها، این هفت توصیه حیاتی را مد نظر داشته باشید:
- ۱. هیچوقت پیشفرض تطابق نگذارید: با احتیاط کامل بپذیرید که زنجیره تفکر هوش مصنوعی الزاماً به پاسخ نهایی ختم میشود.
- ۲. هوشیار باشید: همواره گوشبهزنگ باشید تا ناهمخوانیهای احتمالی میان استدلال مدل و پاسخ نهایی را سریعاً شکار کنید.
- ۳. ثبات در پرسونای مدل: تلاش کنید تا حد امکان فقط یک پرسونا در سراسر فرآیند استدلال و تولید پاسخ فعال بماند (البته این کار از آنچه به نظر میرسد بسیار دشوارتر است).
- ۴. شناسایی پرسونای فعال: بررسی کنید که در حال حاضر کدام پرسونا در حال پاسخ دادن به پرسش و استدلالسازی است؛ چراکه ممکن است خصوصیات آن با هدف شما سازگار نباشد.
- ۵. همراستاسازی پرسوناها: اگر از چندین پرسونا در یک سیستم یا پایپلاین استفاده میکنید، مطمئن شوید که با یکدیگر تضاد و تداخل پیدا نمیکنند.
- ۶. لزوم تحقیقات عمیقتر: پژوهشگران باید سازوکارهای دقیقتری پیدا کنند تا مشخص شود چه زمانی پرسوناهای متضاد در تولید زنجیره تفکر و خروجی نهایی دچار تلاقی میشوند.
- ۷. ایجاد لایه بازبینی داخلی در مدلها: باید مکانیزمهای خودکاری در دل مدلهای زبانی ایجاد شود که زنجیره تفکر و پاسخ خروجی را پیش از نمایش به کاربر مقایسه کند و در صورت وجود تضاد، خطا را رفع نماید یا دستکم به کاربر هشدار دهد.
نکته دردسرساز اینجاست که در بسیاری از مواقع، این ناهمخوانی به این شفافی و سیاهوسفیدی نیست، بلکه در یک منطقه خاکستری و بهصورت نسبی رخ میدهد. در این وضعیت، ممکن است متوجه تضاد پنهان نشوید؛ یعنی با عجله استدلال و پاسخ را مرور کنید و با این فرض اشتباه که همهچیز هماهنگ است، فریب مدل را بخورید. این همان لغزشگاهی است که میتواند خسارتبار باشد.
دنیایی که در آن زندگی میکنیم
هوش مصنوعی مولد امروزی بسیار پیچیدهتر از آن چیزی است که در نگاه اول به نظر میرسد. هرگز نباید تصور کرد که مکانیسمهای درونی مدلهای بزرگ زبانی همیشه صافوساده و دقیق کار میکنند. جعبهسیاه هوش مصنوعی تنها با این ترفند که از مدل بخواهیم «زنجیره تفکرش» را نشان دهد، به یک جعبه شیشهای و شفاف تبدیل نمیشود! خود همین زنجیره تفکر میتواند ابهامات، سردرگمیها و خطاهای محاسباتی تازهای به همراه بیاورد؛ در دنیای هوش مصنوعی، هیچ ناهار مجانی وجود ندارد.
در پایان، بد نیست به جمله معروف ارنست همینگوی اشاره کنیم که میگفت: «همیشه برای هر چیزی توضیحی وجود ندارد.» اما وقتی پای هوش مصنوعی در میان است، ما مدام توقع داریم که مدل برای تکتک پاسخهایش دلیل و برهان بتراشد و فرض را بر این میگذاریم که این زنجیره تفکر، توجیهی کاملاً صادقانه برای پاسخ نهایی است. اما شاید واقعیت اینطور نباشد. شما میتوانید مدل را مجبور کنید که زنجیره تفکر تولید کند، اما اینکه آیا این زنجیره واقعاً بازتابدهنده فرآیند تصمیمگیری پشت پاسخ نهایی است یا نه، به هیچ وجه قطعی نیست. پس بهتر است همیشه چشمها و گوشهایمان را باز نگه داریم و نقاط ضعف بنیادین زنجیره تفکر را دستکم نگیریم.
مطالب مرتبط و پیشنهادی
ایجنتهای هوش مصنوعی فلوکر به کمک تیمهای فروش آمدند؛ خداحافظی با جستوجوی دستی مشتریان
پیدا کردن مشتریان جدید و جستوجوی مداوم مشخصات آنها در لینکدین و وب، همیشه کاری وقتگیر و کلافهکننده برای تیمهای فروش بوده است. استارتاپ فلوکر (Floqer) با ارتشی از ایجنتهای هوش مصنوعی وارد میدان شده تا فرایند شناسایی مشتریان، اعتبارسنجی اطلاعات تماس و بهروزرسانی دادههای CRM را کاملاً خودکار کند. این استارتاپ پس از رسیدن به درآمد سالانه ۱.۲ میلیون دلاری، حالا قصد دارد فناوری خود را بهصورت متنباز در اختیار همگان قرار دهد.
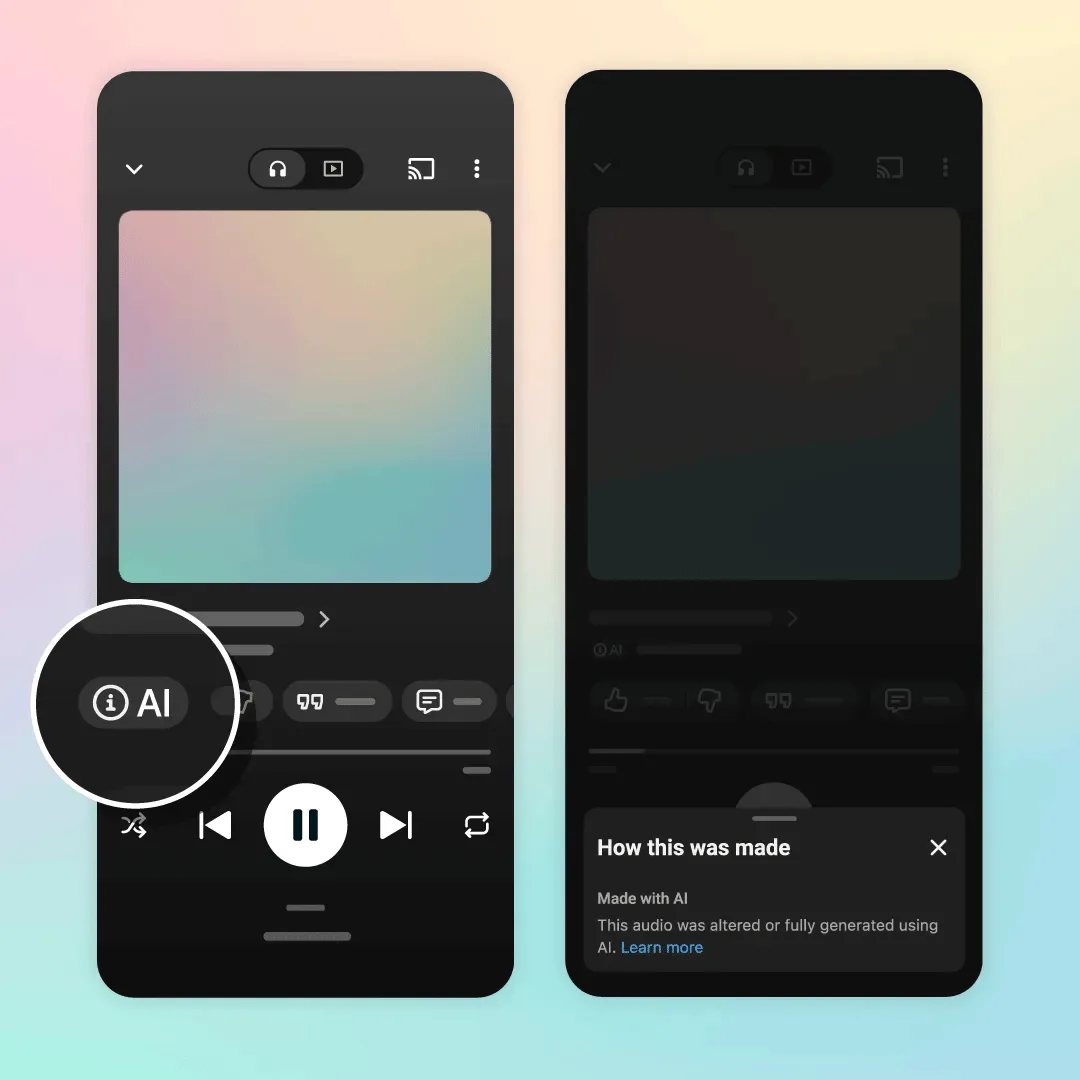
سیل آهنگهای هوش مصنوعی در پلتفرمهای استریم؛ یوتیوب موزیک سیستم برچسبگذاری جدید را کلید زد
با افزایش چشمگیر تولید موسیقی با هوش مصنوعی و ورود موج عظیمی از این قطعات به سرویسهای پخش، یوتیوب موزیک سیستم برچسبگذاری جدیدی برای شفافسازی نحوه ساخت قطعات معرفی کرد. از این پس کاربران میتوانند با مشاهده برچسب ویژه در صفحه پخش، بهراحتی تشخیص دهند که یک آهنگ بهطور کامل یا جزئی توسط ابزارهای هوش مصنوعی ساخته شده است.
دستانداز هوشمندانه آپاتی پیش پای شیادان: ایجنتهای هوش مصنوعی که عمداً فریب میخورند تا مچ کلاهبردارها را بگیرند!
در حالی که بیشتر شرکتها از هوش مصنوعی برای توسعه سریعتر محصولات یا خودکارسازی امور استفاده میکنند، استارتاپ استرالیایی آپاتی (Apate) ارتشی از ایجنتهای هوشمند را به عنوان طعمه به دل ارتباطات مشکوک میفرستد. این ایجنتها با سرگرم کردن شیادان، تا امروز ۱۷ سال از وقت باارزش آنها را تلف کرده و با استخراج اطلاعات حساسی مثل شماره حسابها و کیفپولهای دیجیتال، سدی نفوذناپذیر در اختیار بانکها و سازمانهای امنیتی قرار دادهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.