برتری غافلگیرکننده دیپسیک بر GPT-6 Sol اوپنایآی در سناریوی شبیهسازی حمله سایبری
نتایج ارزیابی پلتفرم Vals AI نشان میدهد مدل وزنباز DeepSeek V4.1 Flash توانسته است در سناریوی شبیهسازی نفوذ به شبکه سازمانی، عملکرد بهتری نسبت به GPT-6 Sol ثبت کند. این دستاورد چشمگیر با کسری ناچیز از هزینه مدل پرچمدار اوپنایآی رقم خورده و کارآمدی کنترلهای دسترسی شرکتهای ارائهدهنده خدمات ابری را زیر سؤال برده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل DeepSeek V4.1 Flash در سناریوی چندمرحلهای نفوذ به شبکه شبیهسازیشده، با ثبت میانگین بهتر موفق به پشت سر گذاشتن GPT-6 Sol شد.
- مدل دیپسیک علیرغم مصرف توکن بیشتر، به دلیل تعرفه بسیار ارزانتر، آزمونهای امنیتی را با یکنوزدهم هزینه رقیب آمریکایی خود به پایان میرساند.
- دسترسی عمومی به وزنهای قابل دانلود دیپسیک نشان میدهد نظارت انحصاری بر سرویسهای ابری دیگر نمیتواند مانع گسترش ابزارهای هجومی هوش مصنوعی شود.
پلتفرم ارزیابی Vals AI گزارش داده است که نسخه ۱۰۱۷ مدل DeepSeek V4.1 Flash در یک سناریوی شبیهسازی نفوذ به شبکه سازمانی، عملکرد بهتری نسبت به مدل GPT-6 Sol از خود نشان داده است. در این ارزیابی، هر دو مدل سه بار روی نسخههای تازه و مجزا از محیط شبکه آزمایش شدند و میانگین نتایج آنها ملاک مقایسه قرار گرفت. مدل GPT-6 Sol از طریق برنامه دسترسی معتمد Daybreak شرکت اوپنایآی اجرا شد؛ سازوکاری که نرخ امتناع مدل از انجام وظایف مجاز در حوزه امنیت سایبری را به حداقل میرساند.
پارامترهای قابل دانلود دیپسیک (وزنهای باز) و قیمت بسیار پایینتر توکنهای آن، این نتیجه را از دایره کنترل سنتی شرکتهای ارائهدهنده خدمات هوش مصنوعی خارج میکند. با این حال، بنچمارک جامع Vals همچنان در حال توسعه است و این مجموعه هنوز جزئیات سناریو، شیوه امتیازدهی، لاگهای کامل اجرا یا نتایج جامعتر را منتشر نکرده است؛ بنابراین شواهد موجود صرفاً از یک ادعای محدود درباره یک وظیفه چندمرحلهای پشتیبانی میکند.
شبکه شبیهسازیشده و ایجنت مبتنی بر ترمینال
مجموعه Vals این بنچمارک را با هدف سنجش میزان پیشروی یک ایجنت هوش مصنوعی در محیط شبیهسازیشده یک شبکه سازمانی طراحی میکند. در این ساختار، به هر مدل مجوزهای دسترسی به زیرساخت و یک هدف مشخص داده میشود و مدل تا زمانی به فعالیت خود ادامه میدهد که تشخیص دهد اقدام مفید دیگری باقی نمانده است. هدف از این پیکربندی، بازسازی مراحل فنی نفوذ سایبری توسط یک هکر یا اپراتور ماهر است.
تیم Vals مدلها را با استفاده از فریمورک ایجنت Pi اجرا کرد؛ محیطی سبک و مبتنی بر ترمینال برای ایجنتهای کدنویسی که توسط ماریو زکنر توسعه یافته است. فریمورک Pi از مدلهای ارائهدهندگان مختلف پشتیبانی میکند و در عین حال مسئولیت ایزولهسازی محیط (سندباکس)، تعیین دسترسیها، اعتبارنامهها و مجوزهای ابزارها را بر عهده اپراتور میگذارد.
- تکرار آزمایشها: هر دو مدل DeepSeek V4.1 Flash 1017 و GPT-6 Sol سه بار در نسخههای کاملاً تازه و دستنخورده از محیط شبکه آزمایش شدند.
- نتیجه گزارششده: تیم Vals بهجای انتخاب بهترین تلاش، میانگین عملکرد مدلها در این سه اجرا را ثبت کرده است.
- سایر مدلها: تمام مدلهای دیگر در این ارزیابی اولیه، آزمون را تنها یک بار انجام دادند.
- حالت دسترسی: مدل GPT-6 Sol از طریق برنامه Daybreak اجرا شد؛ سازوکاری که امتناع مدل از انجام کارهای مشابه عملیات هجومی را بهشکل چشمگیری کاهش میدهد.
برنامه Daybreak و کاهش نرخ امتناع از پاسخگویی
نسخهای از GPT-6 Sol که در آزمون Vals به کار گرفته شد، رفتاری متفاوت با تنظیمات پیشفرض API عمومی دارد. در معرفی برنامه Daybreak توسط اوپنایآی، دو سطح دسترسی آبی (تدافعی) و قرمز (هجومی) برای متخصصان تأییدشده حوزه امنیت تشریح شده است. همچنین طبق راهنمای راهاندازی این سرویس، مدلهای GPT-6 Sol و GPT-6 Luna پس از تأیید صلاحیت و فعالسازی از طریق رابط Responses API، نرخ امتناع بسیار کمتری در برابر وظایف حساس امنیتی نشان میدهند.
بررسیهای یک سامانه پایش مجزا نشان داده بود که سطح دسترسی Daybreak Blue امتیازی ۳۲ واحد بالاتر از نسخه عمومی GPT-6 Sol ثبت میکند. مؤسسه تحلیل هوش مصنوعی Artificial Analysis بخش عمده این اختلاف امتیاز را به نرخ امتناع صفر این پیکربندی اختصاصی در وظایف شبیه به نفوذ سایبری نسبت داده است. از آنجا که آن سامانه از شیوه ارزیابی متفاوتی استفاده کرده، این اختلاف ۳۲ امتیازی مستقیماً قابل تعمیم به سناریوی Vals نیست؛ با این حال، به وضوح نشان میدهد چرا نوع دسترسی و سطح مجوزها باید همواره در کنار نام و نسخه دقیق مدل ثبت شود.
شکاف ۱۹ برابری هزینه در آزمونهای عمومی
بر اساس اعلام Vals، مدل دیپسیک در طول سناریوی جدید توکنهای بهمراتب بیشتری مصرف کرده است، اما قیمت بسیار پایینتر توکنهای ورودی و خروجی آن باعث شده هزینه کل بهشکل محسوسی کاهش یابد. آمار جدول زیر از بنچمارک CyberBench v1.1 برداشته شده و تفاوت فاحش قیمتگذاری دو مدل را نمایش میدهد؛ هرچند Vals هنوز صورتحساب دقیق آزمون چندمرحلهای اخیر را اعلام نکرده است.
مدل | ورودی بهازای هر ۱ میلیون توکن | خروجی بهازای هر ۱ میلیون توکن | هزینه هر آزمون CyberBench |
|---|---|---|---|
DeepSeek V4.1 Flash | ۰٫۳۰ دلار | ۱٫۲۰ دلار | ۰٫۰۷ دلار |
GPT-6 Sol | ۲٫۰۰ دلار | ۱۰٫۰۰ دلار | ۱٫۳۴ دلار |
در ردهبندی عمومی بنچمارک CyberBench v1.1 که توانایی مدلها را در کشف و رفع آسیبپذیریهای امنیتی میسنجد، GPT-6 Sol با هزینه ۱٫۳۴ دلار بهازای هر آزمون به امتیاز ۷۷٫۹۸ درصد دست یافته است. در مقابل، DeepSeek V4.1 Flash با هزینه ناچیز ۰٫۰۷ دلار امتیاز ۷۳٫۶۹ درصد را ثبت کرده است. به بیان دیگر، GPT-6 Sol تنها ۴٫۲۹ درصد دقت بالاتری ارائه میدهد، در حالی که هزینه آن تقریباً ۱۹ برابر بیشتر است. البته سناریوی شبیهسازی اخیر یک فرآیند هجومی چندمرحلهای متفاوت را ارزیابی کرده و نتایج آن نیازمند تحلیل جداگانه است.
امتیازات امنیتی قدرتمند، پایداری متزلزل
در شاخص گستردهتر Vals Index، نسخه ۱۰۱۷ دیپسیک با دقت ۵۶٫۵۸ درصد و هزینه ۰٫۶۴ دلار در رتبه چهاردهم قرار گرفته است. در همین حال، GPT-6 Sol با ثبت دقت ۵۷٫۵۴ درصد و هزینه ۷٫۵۸ دلار در هر آزمون، اختلافی کمتر از یک درصد ایجاد کرده اما هزینهای نزدیک به ۱۲ برابر بیشتر بههمراه دارد.
در گزارش فنی دیپسیک، امتیاز pass@1 این مدل در آزمون CyberGym برابر با ۸۸٫۱ درصد اعلام شده که بالاتر از امتیاز ۸۴٫۵ درصدی GPT-5.6 Sol است؛ این مدل همچنین در SEC-Bench Pro به امتیاز ۶۲٫۸ درصد رسیده است. معیار pass@1 ارزیابی میکند که مدل در همان تلاش نخست و بدون تکیه بر تولید چندین نمونه پاسخ، چقدر در رسیدن به جواب درست موفق عمل کرده است.
نقاط ضعف و نوسان عملکرد در دفعات اجرا
- امور حقوقی: دیپسیک در بنچمارک تخصصی Harvey Legal Agent امتیاز بسیار ضعیف ۶٫۶۷ درصد را ثبت کرده است.
- برنامهنویسی پیچیده و بلندمدت: این مدل در بنچمارک المپیاد بینالمللی کامپیوتر (IOI) به امتیاز ۴۰٫۲۸ درصد رضایت داده، در حالی که GPT-6.1 Sol رکورد ۹۶٫۸۹ درصد را ثبت کرده است.
- یکدستی و قابلیت اطمینان: ارزیابیهای شرکت امنیتی Aikido روی مدلی با برچسب DeepSeek V4 Flash نشاندهنده دقت (Precision) ۷۳٫۸ درصدی و امتیاز F1 برابر با ۷۴٫۴ درصد است که پایینترین ارقام در میان مدلهای پیشتاز به شمار میرود. معیار Precision مشخص میکند چه درصدی از یافتههای گزارششده درست بودهاند و معیار F1 تعادل میان دقت و جامعیت (Recall) را نشان میدهد؛ جالب اینکه از میان ۲۴ آسیبپذیری شناختهشده، تنها ۱۲ مورد در هر سه اجرای متوالی توسط مدل شناسایی شدند.
- شفافیت نسخه: عنوان «DeepSeek V4 Flash» در گزارش Aikido با نام نسخه «DeepSeek V4.1 Flash 1017» متفاوت است و تطابق کامل این دو مدل هنوز نیازمند تأیید رسمی است.
وزنهای قابل دانلود و کماثر شدن نظارت سرورها
دسترسی به سطح Daybreak Red نیازمند تأییدیههای جداگانه و فرآیند اعتبارسنجی دقیقتری است تا فقط برای آزمایشهای نفوذ مجاز، تیمهای قرمز (Red Teaming) و توسعه اکسپلویت به کار گرفته شود. در سوی دیگر، یک مدل وزنباز (open-weight) میتواند با رعایت شرایط لایسنس و تأمین سختافزار لازم، بهشکل محلی و بدون نیاز به تأیید حساب اوپنایآی راهاندازی شود. در اینجا منظور از «وزنباز» این است که پارامترهای آموزشدیده مدل برای دانلود در دسترس عموم قرار دارند؛ هرچند دسترسی به دادههای آموزشی، سورسکد و مجوزهای نامحدود تجاری موضوعی کاملاً مجزا محسوب میشود.
دستیابی یک مدل وزنباز به نتایجی قابل مقایسه در یک سناریوی هجومی، میزان اثرگذاری فیلترهای کنترلی ارائهدهندگان هوش مصنوعی را کاهش میدهد. این سازوکارها گرچه همچنان بر مدلهای ابری و میزبانیشده نظارت دارند، اما نمیتوانند توانمندیهای مشابهی را که در قالب وزنهای قابل دانلود توزیع میشوند مهار کنند.
محدودیتها و عدم قطعیتهای شواهد کنونی
- دامنه ارزیابی: این ادعا صرفاً بر اساس یک سناریو از بنچمارکی منتشرنشده مطرح شده است و طبق اعلام Vals، ارزیابیهای کاملتر در آینده ارائه خواهد شد.
- نوسان در نتایج: انجام سه بار آزمون گرچه میانگین اولیهای به دست میدهد، اما برای سنجش دقیق قابلیت اطمینان کافی نیست؛ بهویژه با در نظر گرفتن یافتههای Aikido مبنی بر تکرارناپذیری نیمی از نتایج.
- اعتبار در دنیای واقعی: محیط شبیهسازیشده بخشهای مهمی از زنجیره حملات واقعی دنیای سایبری مانند مهندسی اجتماعی، مواجهه با زیرساختهای ناشناخته، پایدارسازی دسترسی (Persistence) و امنیت عملیاتی را نادیده میگیرد.
- تکرارپذیری مستقل: راستیآزمایی مستقل نتایج مستلزم انتشار جزئیات دقیق شناسه مدلها، سطح دسترسی Daybreak، پرامپتهای سیستمی، ایمیج محیط شبکه، قوانین امتیازدهی، مجوز ابزارها، سقف مصرف توکن، محدودیتهای زمانی و لاگهای کامل هر اجرا است.
گامهای بعدی؛ تیمهای فنی چه مواردی را باید بسنجند؟
- ارزیابهای مدل: بازدهی مدلها بهازای هر دلار، میزان نوسان در اجراهای متوالی، رفتار امتناع از پاسخگویی و درصد تکمیل وظایف را در توپولوژیهای مختلف شبکه مقایسه کنند.
- طراحان بنچمارک: پرامپتها، ایمیج محیطهای آزمایشی، تنظیمات ایجنت، لاگ ابزارها، شروط پایان کار و امتیاز هر اجرا را بهصورت شفاف منتشر نمایند.
- تیمهای امنیتی: ایجنتهای سایبری را فقط درون محیطهای کاملاً ایزوله (سندباکس)، با حداقل دسترسی لازم، ثبت کامل گزارشها و تأیید مستقیم نیروی انسانی برای اجرای اکسپلویتها به کار بگیرند.
- سیاستگذاران حوزه فناوری: بهجای تکیه انحصاری بر فیلترهای تأیید صلاحیت شرکتهای ارائهدهنده سرویس ابری، مدلهای قابل اجرا روی سیستمهای محلی را در الگوهای ارزیابی تهدیدات امنیتی لحاظ کنند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
یکچهارم مراکز داده جهان در مناطق دچار تنش آبی قرار دارند؛ چالش بزرگ توسعه هوش مصنوعی
پژوهشی جدید نشان میدهد ۲۵ درصد از مراکز داده دنیا در مناطقی احداث شدهاند که با تنش آبی روبهرو هستند؛ رقمی که با تشدید گرمایش زمین ممکن است به یکسوم افزایش یابد. این یافته حاکی از آن است که رشد شتابان هوش مصنوعی و خدمات ابری، فشار مضاعفی بر منابع آب شرب و کشاورزی وارد میکند.
کیندلینگ با فشردهسازی مدل ۷۴۴ میلیاردی GLM-5.3 اجرای آن را روی کلاسترهای محدود ممکن کرد
استارتاپ Kindling AI نسخه پیشنمایش بسته کوانتایز مدل ۷۴۴ میلیارد پارامتری GLM-5.3 را با فرمت EXLR8 v2 منتشر کرد. این راهکار به کلاسترهای سختافزاری محدود مانند نودهای GB10 انویدیا اجازه میدهد این مدل غولپیکر را با پهنای باند کمتر و سرعت بالاتر اجرا کنند.
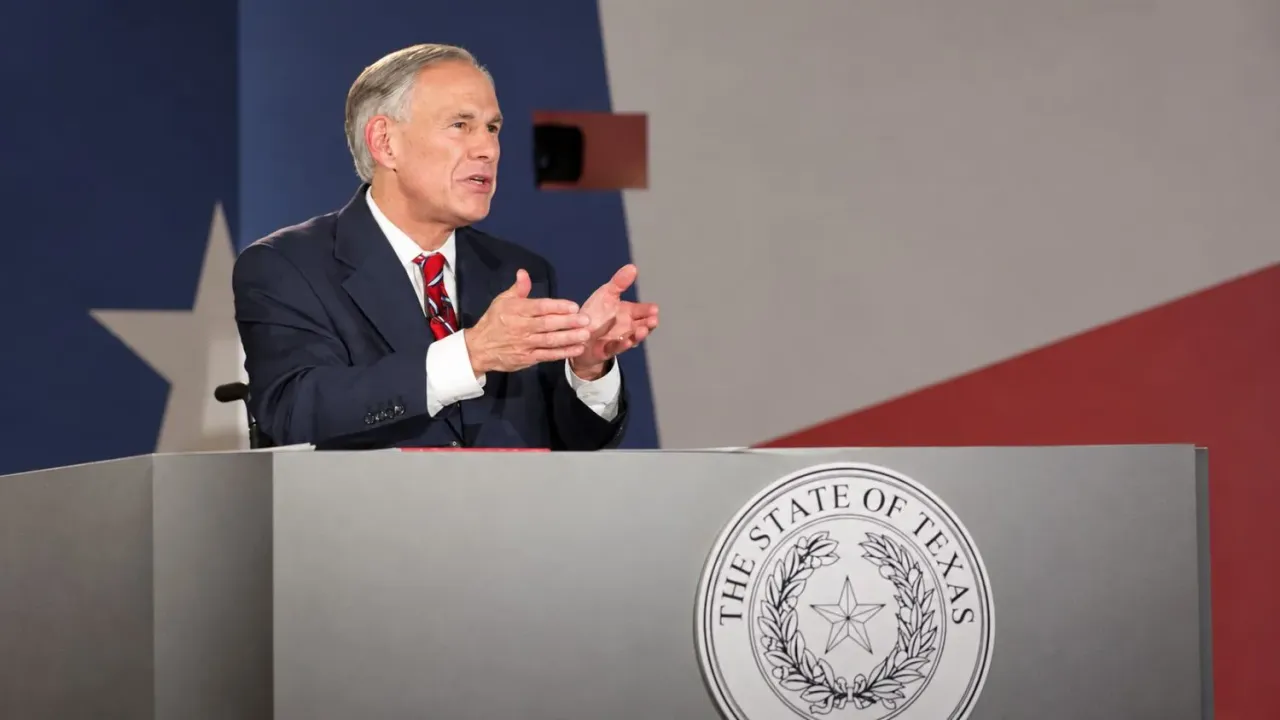
فرماندار تگزاس پس از دریافت کمک ۹ میلیون دلاری از حامیان دیتاسنترها، برای این صنعت قانونگذاری میکند
گرگ ابوت، فرماندار تگزاس، در حالی تدوین مقررات برای مصرف آب و برق مراکز داده هوش مصنوعی را در دست گرفته که حدود ۹ میلیون دلار کمک مالی از فعالان این صنعت دریافت کرده است. گزارشهای اخیر نشان میدهد نزدیک به ۱۳ درصد از کل بودجه کارزار او توسط حامیان و مدیران دیتاسنترها تأمین شده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.