ابتکار جدید گوگل دیپمایند: ثبت واترمارک روی پروتئینهای طراحیشده با هوش مصنوعی!
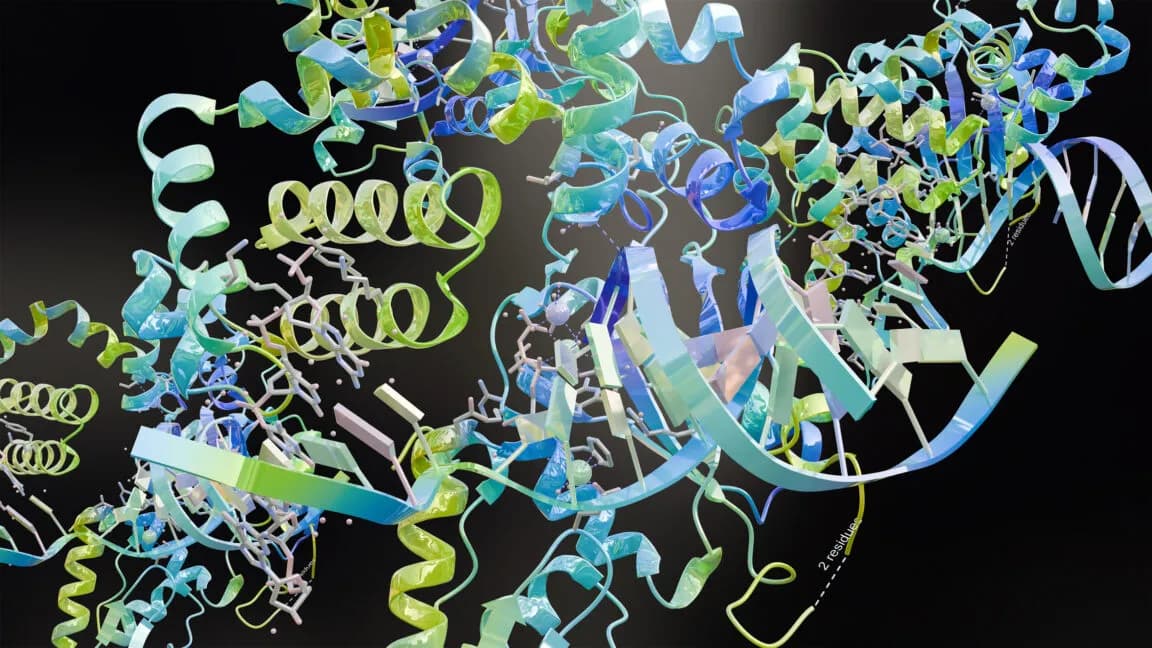
پژوهشگران دیپمایند گوگل با توسعه ابزاری به نام SynthIDBio موفق شدهاند روی پروتئینهای طراحیشده توسط هوش مصنوعی، واترمارک دیجیتال ثبت کنند. این فناوری نوآورانه بدون تغییر در کارایی زیستی پروتئین، مانند یک امضای رمزی عمل میکند و مسیر مهار خطرات بیوتروریسم در سنتز DNA را هموار میسازد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران دیپمایند گوگل نسخه زیستی فناوری SynthID به نام SynthIDBio را معرفی کردهاند که میتواند روی پروتئینهای هوش مصنوعی واترمارک نامرئی ثبت کند.
- این سیستم بدون آسیب به کارایی پروتئین، اسیدهای آمینه همارز را به شکلی هوشمندانه برمیگزیند تا ردپای دیجیتال در کل زنجیره توزیع شود.
- هدف اصلی این دستاورد افزایش امنیت زیستی و تفکیک پروتئینهای آزمایشگاهی مطمئن از سموم ناشناخته است، هرچند چالشهایی در پوشش پروتئینهای بسیار کوتاه دارد.
این روزها ابزارهای مبتنی بر هوش مصنوعی تقریباً به شکل روزمره تهدیدهای امنیتی تازهای میآفرینند؛ تا حدی به این دلیل که دنیا در تشخیص زودهنگام این خطرات عملکرد کندی داشته است. با این حال، حوزهای که به نظر میرسد این بار کارشناسان یک قدم از خطراتش جلوترند، حوزه امنیت زیستی (Biosecurity) است.
در دنیای زیستشناسی، کاربرد شگفتانگیز و تهدیدهای هولناک همیشه دوشادوش یکدیگر حرکت میکنند. دانشمندان تاکنون ابزارهای فوقالعاده پیشرفتهای برای طراحی پروتئینها توسعه دادهاند و به موفقیتهای بزرگی هم دست یافتهاند؛ دستاوردهایی مثل ساخت آنزیمهایی که پلاستیک را تجزیه میکنند یا جلوی زهر مار و عقرب را میگیرند. اما درست همین ابزارهای هوش مصنوعی میتوانند برای تولید سموم بیولوژیکی خطرناک یا دستکاری رفتار پروتئینهای ویروسی هم به کار بروند.
مشکل اینجاست که نرمافزارهای سنتی مورد استفاده برای غربالگری توالیهای DNA و شناسایی پروتئینهای خطرناک، از پس تشخیص پروتئینهای طراحیشده با هوش مصنوعی برنمیآیند؛ زیرا ساختار آنها آنقدر جدید و ناشناخته است که هیچ ردپایی از تهدیدآمیز بودنشان در پایگاههای داده وجود ندارد. با گذشت نزدیک به یک سال از هشدارهای جدی درباره این خطر، تا همین اواخر هیچ راهحل مشخصی برای مهار آن وجود نداشت.
حالا تیم پژوهشی دیپمایند در شرکت گوگل با انتشار مقالهای در نشریه نیچر (Nature)، یک راهحل بالقوه و هوشمندانه ارائه داده است: «واترمارکگذاری پروتئینها». این سیستم، یک واترمارک دیجیتال و نامرئی را مستقیماً درون توالی اسیدهای آمینه پروتئین قرار میدهد، آن هم بدون آنکه کارایی و عملکرد طبیعی پروتئین ذرهای دچار افت شود. این ابتکار باعث میشود پروتئینهای طراحیشده توسط محققان و مراکز معتبر بهسرعت شناسایی شوند و آزمایشگاهها بتوانند تمام توان و دقت خود را روی غربالگری و بررسی موارد ناشناخته و مشکوک متمرکز کنند.
مگر چنین چیزی اصلاً شدنی است؟
این ایده بر پایه فناوری اختصاصی گوگل به نام SynthID بنا شده است؛ همان ابزاری که واترمارکهای نامحسوس و پنهانی را درون محتواهای دیجیتال تولیدشده توسط هوش مصنوعی میگنجاند. سازوکار این فناوری به این شکل است که روی احتمال انتخابهای هوش مصنوعی اثر میگذارد و این تغییر ملایم، بهصورت سیستماتیک در سراسر محصول نهایی (چه متن باشد و چه تصویر) پخش میشود. از آنجا که بدون در دست داشتن کلید رمزنگاری اولیه نمیتوان این واترمارک را شناسایی کرد، حذف کردن آن هم عملاً غیرممکن است. علاوه بر این، از آنجا که این الگو در کل فایل توزیع شده، حتی با فشردهسازی، تغییر ابعاد یا خروجی گرفتنهای مختلف هم از بین نمیرود.
شاید درک نحوه عملکرد چنین واترمارکی در پیکسلها و تفاوتهای نوری ملایم یک تصویر ساده به نظر برسد؛ اما پیاده کردن همین ایده روی یک پروتئین زنده، چالشی به مراتب پیچیدهتر و دیوانهوارتر است.
پروتئینها تنها از ۲۰ نوع اسید آمینه ساخته شدهاند که هر یک از آنها میتواند نقشی حیاتی در حفظ ساختار یا فعالیت کاتالیزوری پروتئین بازی کند. هرچند برخی از این اسیدهای آمینه به لحاظ شیمیایی شباهت زیادی به هم دارند (مثل لوسین و ایزولوسین)، برخی دیگر بارهای الکتریکی کاملاً متضادی دارند. در بسیاری از پروتئینها، بخشهای گستردهای وجود دارد که تغییرات جزئی در توالی اسیدهای آمینهشان مشکلی ایجاد نمیکند، اما در بخشهای حساس دیگر، حتی کوچکترین انحراف و تغییری میتواند کل پروتئین را کاملاً از کار بیندازد و بیخاصیت کند.
از طرفی، پروتئینها ساختارهای بسیار کوچکی دارند. در حالی که یک تصویر دیجیتال معمولاً شامل میلیونها پیکسل است، یک پروتئین با تنها ۵۰۰ اسید آمینه، پروتئینی نسبتاً بزرگ به حساب میآید. این یعنی دانشمندان فضای فوقالعاده کمتری برای پنهان کردن هر نوع سیگنال یا داده رمزی در اختیار دارند.
بنابراین در ابتدا اصلاً مشخص نبود که آیا فناوری SynthID در دنیای زیستشناسی جواب میدهد یا خیر؛ ممکن بود نتوان دادههای کافی را در یک پروتئین معمولی جا داد، یا اگر اطلاعات زیادی برای ساخت واترمارک گنجانده میشد، پروتئین نهایی از کار میافتاد. تنها راه برای پی بردن به این معما، دست به کار شدن و آزمایش عملی آن بود.
انتقال واترمارک به دنیای پروتئینها
برای درک بهتر شیوه کار این سیستم، بد نیست کمی با شیمی پروتئینها آشنا شویم. اسیدهای آمینه همگی یک بخش ثابت دارند که عمدتاً از دو اتم کربن متصل به یک نیتروژن تشکیل شده است. یک پروتئین از اتصال پشت سر هم این بخشهای ثابت به وجود میآید و زنجیرهای طولانی موسوم به «اسکلت اصلی» (Backbone) را میسازد. علاوه بر این بخش ثابت، از هر اسید آمینه یک «زنجیره جانبی» (Side Chain) نیز آویزان است. پیچیدگی این زنجیرهها میتواند از یک اتم هیدروژن ساده تا ساختارهای حلقوی بزرگ متغیر باشد و ماهیت آنها میتواند هیدروکربنی، اسیدی، بازی یا خنثی باشد.
همین زنجیرههای جانبی هستند که تعیین میکنند اسکلت اصلی پروتئین در فضای سهبعدی چگونه تا بخورد و شکل بگیرد. در یک پروتئین محلول، تمام زنجیرههای جانبی هیدروکربنی خالص در مرکز پروتئین فشرده و پنهان میشوند، در حالی که زنجیرههای اسیدی، بازی و حاوی هیدروکسیل به سمت مولکولهای آب در سطح بیرونی قرار میگیرند. در نهایت، زمانی که پروتئین تاخورده و شکل نهاییاش تثبیت شد، اسکلت اصلی است که ساختار کلی و فرم سهبعدی پروتئین را تعریف میکند.
تیم تحقیقاتی گوگل کار خود را با یکی از محبوبترین ابزارهای طراحی پروتئین به کمک هوش مصنوعی، یعنی ProteinMPNN آغاز کرد؛ نرمافزاری که در آزمایشگاه بیکر توسعه داده شده و دیوید بیکر هم به خاطر آن، نوبل شیمی سال ۲۰۲۴ را بهطور مشترک با مدیران دیپمایند دریافت کرد.
ابزار ProteinMPNN طی یک فرآیند دومرحلهای کار میکند: ابتدا ابزاری جداگانه، ساختار اسکلت اصلی مناسب برای پروتئین هدف را تعیین میکند. سپس ProteinMPNN وارد عمل شده و گامبهگام در امتداد این اسکلت حرکت میکند تا اسیدهای آمینه و زنجیرههای جانبی مناسب را تکبهتک سر جایشان بنشاند. هر اسید آمینه بر این اساس انتخاب میشود که چقدر با فرم اسکلت اصلی سازگار است، چگونه با همسایگان خود برهمکنش دارد و تا چه اندازه با شروط آزمایش (مثل ایجاد جایگاههای فعال کاتالیزوری یا اتصال به پروتئینی دیگر) همخوانی پیدا میکند.
درست در همین مرحله است که نسخه اختصاصی ابزار گوگل، یعنی SynthIDBio وارد میدان میشود. این ابزار با استفاده از یک کلید رمزنگاری اختصاصی و با تکیه بر اسیدهای آمینهای که قبلاً انتخاب شدهاند، اسید آمینه بعدی را پیشنهاد میدهد. سپس نرمافزار ProteinMPNN بررسی میکند که آیا گزینه پیشنهادی SynthID از نظر حفظ عملکرد پروتئین مناسب است یا خیر؛ اگر مناسب نبود، پیشنهاد رد میشود و اگر مناسب بود، در زنجیره ثبت میگردد. به بیانی سادهتر، سیستم در حین چیدن اسیدهای آمینه، فقط زمانی گزینههای حامل واترمارک را اعمال میکند که به کارایی پروتئین ضربهای نزنند.
برای درک ملموستر میتوان اینطور تصور کرد: هر جا که دست هوش مصنوعی باز است و چند اسید آمینه مشابه از نظر شیمیایی (مثل لوسین، ایزولوسین و والین، یا سرین و ترئونین) بدون مشکل کار میکنند، اولویت به گزینهای داده میشود که با واترمارک همخوانی دارد. یکی از توسعهدهندگان سیستم این فرآیند را اینگونه توصیف میکند: الگوریتم در میان تمام حالتهای ممکن برای ساخت یک پروتئین کارآمد میگردد تا زیرمجموعهای را پیدا کند که بیشترین تعداد اسیدهای آمینه حامل واترمارک را در خود جا داده باشد.
در نتیجه، این واترمارک بهطور تصادفی اما هدفمند در طول زنجیره پروتئین توزیع میشود و ردیابی آن یک پاسخ بله یا خیر ساده نیست. برای آشکارسازی آن، باید کل توالی پروتئین با داشتن کلید رمز اختصاصی اسکن شود تا فراوانی تکرار اسیدهای آمینه پیشنهادی SynthIDBio در زنجیره نهایی اندازهگیری گردد. مهندسان گوگل نرمافزار لازم برای انجام این راستیآزمایی را نیز آماده کردهاند.
آیا پروتئین واترمارکشده واقعاً کار میکند؟
پرسش کلیدی این بود که آیا پروتئینهای دارای واترمارک در دنیای واقعی هم درست کار میکنند؟ تیم تحقیقاتی برای راستیآزمایی، پروتئینهایی را طراحی کرد که بتوانند با پروتئینهای طبیعی مهم در بدن برهمکنش فیزیکی داشته باشند. آزمایشها نشان داد که نسخههای دارای واترمارک عملکردی کاملاً بینقص داشتند و دقیقاً به اهداف زیستی مورد نظر متصل شدند. گرچه این آزمایش به اندازه ساخت یک کاتالیزور آنزیمی پیچیده نیست، اما بهروشنی اثبات کرد که در طراحیهای دشوارتر هم مانع جدی و غیرقابل حلی وجود نخواهد داشت.
بنابراین تا زمانی که طول زنجیره پروتئین به اندازه کافی بلند باشد، سیستم میتواند واترمارک را شناسایی کند. اما فایده اصلی این ابزار چیست؟ پاسخ مجدداً به امنیت زیستی برمیگردد. در حال حاضر، وقتی پژوهشگری به شرکتهای تولید DNA سنتزی سفارش میدهد، این شرکتها توالیهای درخواستی را غربالگری میکنند تا مطمئن شوند بخشی از یک ویروس، سم کشنده یا پاتوژن خطرناک نباشد. با این حال، در شرایط کنونی وقتی با پروتئینی مواجه میشوند که هیچ شباهتی به ساختارهای شناختهشده در طبیعت ندارد (که مشخصه پروتئینهای نوین طراحیشده با هوش مصنوعی است)، راهی برای تشخیص بیخطر یا سمی بودن آن ندارند.
دیدگاه گوگل این است که سامانه SynthIDBio میتواند به شرکتهای تولیدکننده DNA اطمینان خاطر بیشتری بدهد. اگر این شرکتها کلیدهای رمزنگاری را از سازمانها و نهادهای معتبر (مانند دانشگاهها و شرکتهای نامآشنای بیوتکنولوژی) دریافت کنند، میتوانند فوراً بررسی کنند که آیا یک توالی ناشناخته، نتیجه کار پژوهشگران مطمئن است یا خیر. به این ترتیب، آنها وقت و منابع ارزشمند خود را صرفاً روی سفارشهای مشکوک و فاقد کلید معتبر متمرکز خواهند کرد.
به بیان دیگر، این سیستم امنیت صددرصدی سفارشها را ضمانت نمیکند، اما بار سنگین فرآیند غربالگری تهدیدات زیستی را به شدت سبک و بهینه میسازد.
البته تیم پژوهشی دیپمایند به چند رخنه و نقطهضعف بالقوه در این فرآیند نیز اشاره کرده است؛ در وهله اول، امنیت این سازوکار وابستگی مستقیمی به شیوه نگهداری و توزیع کلیدهای رمزنگاری دارد. دوم اینکه پروتئینهای بسیار کوتاه ممکن است به تعداد کافی اسیدهای آمینه دارای واترمارک دریافت نکنند و شناسایی نشوند. همچنین این احتمال وجود دارد که مهاجمان زنجیره پروتئین را با بخشهای فاقد واترمارک ترکیب کنند (مثلاً اتصال پروتئین به یک پروتئین فلورسنت طبیعی) تا سیگنال واترمارک را رقیق کرده و فریب دهند.
علاوه بر این، نرمافزارهای مختلفی برای طراحی پروتئین با هوش مصنوعی وجود دارند که اصلاً متکی به ProteinMPNN نیستند. گرچه برخی از آنها از روش مشابه «اسید آمینه به اسید آمینه» بهره میبرند و امکان هماهنگی با SynthIDBio را دارند، اما تا زمانی که گوگل شیوه ادغام گستردهتری پیدا نکند، همه آزمایشگاهها و پلتفرمها قادر به افزودن واترمارک نخواهند بود.
همچنین از آنجا که شناسایی این واترمارک بر پایه محاسبات آماری و احتمالاتی صورت میگیرد، تنظیم حد آستانه (Cutoff) تفاوت چشمگیری در نتایج مثبت کاذب یا منفی کاذب ایجاد خواهد کرد.
هنوز معلوم نیست که آیا این فناوری دستکم در نسخه اولیه خود در عمل چقدر گرهگشا خواهد بود؛ اما اصل کارکرد بینقص آن روی ساختارهای زیستی، پدیدهای فوقالعاده جذاب است. از همه مهمتر، جای خوشحالی دارد که میبینیم بخشی از غولهای صنعت هوش مصنوعی به مهار خطرات و ایمنسازی این فناوریهای دگرگونکننده فکر میکنند.
نیچر (Nature)، ۲۰۲۶. شناسه دیجیتال: 10.1038/s41586-026-10965-y
مطالب مرتبط و پیشنهادی
ردیت فیدهای RSS و API عمومی را تعطیل کرد؛ جنگ تمامعیار با باتهای آموزش هوش مصنوعی!
ردیت در اقدامی غافلگیرکننده اعلام کرد پشتیبانی از فیدهای محبوب RSS و دسترسی عمومی به API خود را متوقف میکند. این پلتفرم دلیل اصلی این تصمیم را جلوگیری از اسکرپ خودکار و رایگان دادهها توسط رباتهای هوش مصنوعی عنوان کرده؛ حرکتی که دسترسی به گنجینه دادههای آن را تنها از مسیر قراردادهای تجاری سنگین ممکن میسازد.
تحول در ایجنت مانوس با قابلیت Manus Flex؛ کلید اختصاصی مدل هوش مصنوعی دست خودتان است!
پلتفرم مانوس با رونمایی از قابلیت جدید Manus Flex به برنامهنویسها اجازه میدهد کلیدهای API اختصاصی خود را متصل کرده و مدل هوش مصنوعی دلخواهشان را برگزینند. این قابلیت بدون دستکاری ابزارها و زیرساختهای اجرایی مانوس، کنترل هزینهها و انتخاب مدل را به تیمهای توسعه واگذار میکند.
سقوط آزاد هزینه استدلال هوش مصنوعی با دیپسیک؛ حل معماهای منطقی فقط با ۱ سنت!
تازهترین نتایج بنچمارک ARC-AGI از سقوط خیرهکننده ۹۹ درصدی هزینه استدلال هوش مصنوعی حکایت دارد؛ جایی که مدل DeepSeek V4 Flash حالا میتواند فقط با ۱ سنت به دقت ۷۵ درصدی برسد. این در حالی است که تا همین چند ماه پیش، رسیدن به چنین دقتی دهها دلار هزینه داشت. این جهش اقتصادی بیسابقه، مسیر را برای اجرای گسترده و ارزان ایجنتهای هوشمند در دنیای واقعی هموار میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.