گوگل با فریمورک WikiSkill به ایجنتهای هوش مصنوعی حافظه داد؛ پایان تکرار اشتباهات گذشته!
محققان گوگل ریسرچ با معرفی فریمورک نوآورانه WikiSkill، لایهای از دانش سازمانیافته شبیه به ویکیپدیا را در اختیار ایجنتهای هوش مصنوعی قرار دادهاند تا تجربیات گذشته خود را به اسکیلهای کاربردی و دائمی تبدیل کنند. این رویکرد خلاقانه نهتنها جلوی تکرار خطاهای قبلی ایجنتها را میگیرد، بلکه بدون سنگین کردن پرامپتها و افزایش هزینههای پردازشی، جهش چشمگیری در عملکرد مدلهای هوش مصنوعی ایجاد میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک جدید WikiSkill که حاصل همکاری گوگل ریسرچ و دانشگاه ویرجینیا تک است، با ایجاد یک پایگاه دانش ساختاریافته، مانع از هدر رفتن تجربیات و تکرار خطاهای قبلی ایجنتهای هوش مصنوعی میشود.
- این سیستم تجربیات موفق و ناموفق ایجنت را در یک لایه ویکی ثبت میکند و از دل آنها اسکیلهای جمعوجور و بهینهای میسازد که بدون تحمیل هزینه سنگین پرامپت، عملکرد مدلها را بین ۳ تا ۲۴ درصد بالا میبرد.
- نکته شگفتانگیز اینجاست که اسکیلهای ساختهشده توسط مدلهای بزرگتر به راحتی به مدلهای کوچکتر هم منتقل میشوند و حتی مدل ۹ میلیاردی کیوِن (Qwen) را از نسخه ۲۷ میلیاردی بدون اسکیل جلو میاندازند!
ایجنتهای هوش مصنوعی با یادگیری از تلاشهای موفق و ناموفق خود و تبدیل آنها به «اسکیلهای» قابل استفاده مجدد، میتوانند عملکردشان را حسابی ارتقا دهند. اما مشکل بزرگ اینجاست که سیستمهای تکامل اسکیل در حال حاضر حافظه کوتاهمدتی دارند؛ آنها درسهایی را که در طول مسیر یاد گرفتهاند به راحتی فراموش میکنند و مجبور میشوند بارها و بارها همان اشتباهات قبلی را از اول کشف و تکرار کنند!
حالا فریمورک جدیدی به نام WikiSkill که حاصل دسترنج پژوهشگران گوگل ریسرچ (Google Research) و دانشگاه ویرجینیا تک (Virginia Tech) است، دقیقاً برای حل همین دردسر پا به میدان گذاشته است. این فریمورک یک لایه دانش سازمانیافته میان تجربیات خام ایجنت و اسکیلهای مورد استفادهاش قرار میدهد. به این ترتیب، سیستم به جای اینکه مدام بخواهد از مسیرهای اجرایی جداگانه و تکافتاده اسکیل استخراج کند، تمام دادههای بهدستآمده از تجارب قبلی ایجنت را در قالب یک «ویکی» ساختاریافته جمعآوری میکند و سپس از همین ویکی برای ساخت اسکیلهای آینده بهره میبرد.
آزمایشهای این تیم پژوهشی روی حوزهها و مدلهای مختلف نشان داد که WikiSkill بهراحتی تمام روشهای فعلی تکامل اسکیل را پشت سر میگذارد. جالبتر اینکه نتایج نشان میدهند هرچه ابعاد مدل بزرگتر شود، میزان پیشرفت و بهرهوری حاصل از این روش هم بیشتر میشود؛ علاوه بر این، اسکیلهای تکاملیافته قابلیت انتقال به مدلهای دیگر را هم دارند.
برای تیمهای سازمانی هوش مصنوعی، فریمورک WikiSkill یک فرصت عالی است تا همان ردپاهای اجرایی را که ایجنتهایشان به طور روزمره تولید میکنند، به دانش و اسکیلهای کاربردی و ماندگار تبدیل کنند.
حلقه گمشده دانش در تکامل اسکیلهای هوش مصنوعی
اسکیلها در واقع مجموعهای از دستورالعملها، اسکریپتها و جریانهای کاری تخصصی هر حوزه هستند که در قالب ماژولهای قابل استفاده مجدد بستهبندی میشوند. این اسکیلها بدون نیاز به دستکاری وزنها یا پارامترهای اصلی مدل، دانش رویهای تخصصی و ارزشمندی را به ایجنتها تزریق میکنند.
با این حال، ساختن اسکیلها کار چندان سادهای نیست. در حال حاضر بخش زیادی از اسکیلها به صورت دستی نوشته میشوند؛ یعنی توسعهدهندگان باید تکتک جریانهای کاری و حالتهای خاصی را که ممکن است ایجنت با آنها روبهرو شود از قبل پیشبینی کنند. فریمورکهای جدید تکامل اسکیل تلاش میکنند تا این فرآیند را خودکار کنند؛ به این صورت که ایجنتها را روی تسکهای آموزشی به خط میکنند، مسیرهای اجرایی موفق و ناموفق را زیر ذرهبین میگذارند و از دل این تجربیات، آپدیتهای جدیدی برای اسکیلها بیرون میکشند.
سیستمهای مختلف تا کنون تلاش کردهاند بخشهایی از این پروسه را مدیریت کنند. مثلاً سیستم Trace2Skill مسیرهای موفق و ناموفق را جداگانه بررسی کرده و درسهای بهدستآمده را در قالب پچهای اسکیل ادغام میکند. سیستم EvoSkill میان برنامههای اسکیل کاندید جستوجو کرده و ردپای شکستها را همراه با تاریخچهای ساده از پیشنهادهای قبلی در اختیار موتور پیشنهاددهنده قرار میدهد. ابزار SkillOpt هم از یک پایپلاین بازتاب چندمرحلهای برای تحلیل مسیرها و بهروزرسانی اسناد اسکیل استفاده میکند.
لیان تانگ (Liyan Tang)، دانشمند محقق در گوگل و یکی از نویسندگان مقاله، اشاره میکند که حتی وقتی بهینهساز سیستم ریشه مشکل را به درستی تشخیص میدهد، این بینش ارزشمند خیلی زود فراموش میشود. تانگ در این باره میگوید: «در بسیاری از فریمورکهای خودبهبوددهنده، بهینهساز لاگهای اجرا را میخواند، یک پچ اصلاحی پیشنهاد میدهد و سپس کل تحلیل و عیبیابی انجامشده—از جمله اینکه کدام راهحلها در مرحله اعتبارسنجی رد شدند—را دور میاندازد. نتیجه این میشود که سیستم دوباره چرخ را از اول اختراع میکند، به همان بنبستهای قبلی میخورد و راهحلهای ردشده را دوباره پیشنهاد میدهد!»
حالا WikiSkill خانهای دائمی برای این عیبیابیها و تلاشهای ناموفق فراهم کرده است. حتی وقتی یک اسکیل پیشنهادی رد میشود، سیستم چرایی آن و نتیجه تستهای اعتبارسنجی را برای خودش نگه میدارد. به این ترتیب، نسخههای بعدی سیستم به جای شروع مجدد از صفر، کار را بر پایه همان تجارب قبلی جلو میبرند.
فریمورک WikiSkill چطور کار میکند؟
ایده WikiSkill از مفهوم جالب «ویکی مدل زبانی» (LLM Wiki) که توسط آندری کارپاتی مطرح شده بود، الهام گرفته شده است؛ ایدهای که پیشنهاد میکند تجربیات به دانشی دائمی و همافزا تبدیل شوند. تانگ رویکرد WikiSkill در اجرای این مفهوم را اینطور توصیف میکند: «ما اسکلتبندی ایده کارپاتی را حفظ کردیم؛ منابع غیرقابل تغییر، یک ویکی که توسط مدل زبانی مدیریت میشود، فهرست و لاگ رویدادها. با این تفاوت که در اینجا ورودی ما ردپای اجرای خود ایجنت است و خروجی نهایی یک فایل اجرایی به نام SKILL.md خواهد بود.»
معماری WikiSkill فضای کاری ایجنت را به سه لایه متمایز تقسیم میکند:
لایه خام (Raw Layer): این لایه وظیفه ثبت ردپای تغییرناپذیر اجرا را بر عهده دارد؛ از جمله اقدامات ایجنت، روند استدلال، فراخوانی ابزارها، خروجیهای بهدستآمده و پاسخهای نهایی. این لایه در واقع سند تاریخی دقیقی از کارهایی است که ایجنت در واقعیت انجام داده است.
لایه ویکی (Wiki Layer): این لایه دادههای خام ردپاها را به دانش ساختاریافته تبدیل میکند. این بخش شامل صفحات جداگانه برای بررسی الگوهای تکراری شکست و استراتژیهای موفق، تاریخچه تکامل، و یک ابزار ردگیر تأثیر اسکیل است که نشان میدهد چه تغییراتی پیشنهاد شده و آیا توانستهاند عملکرد را بهبود دهند یا خیر.
لایه اسکیل (Skill Layer): این لایه شامل همان دستورالعملهای رویهای است که ایجنت در حین اجرای تسکها به آنها دسترسی دارد. هر اسکیل همچنین به الگوهای ثبتشده در ویکی که منشأ ساخت یا اصلاح آن بودهاند، پیوند داده میشود.
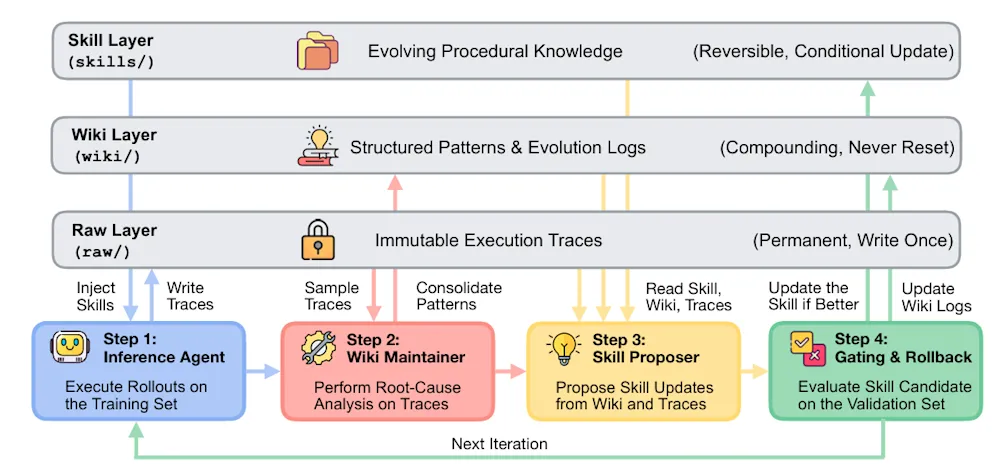
هر چرخه تکامل شامل چهار مرحله مشخص است: ابتدا یک ایجنت استنتاج (Inference Agent) تسکهای آموزشی را بر اساس اسکیلهای فعلی اجرا میکند و ردپاهای جدیدی میسازد. سپس مدیر ویکی (Wiki Maintainer) نمونههایی از مسیرهای موفق و ناموفق را تحلیل کرده و صفحات ویکی را بهروزرسانی میکند. در گام بعد، پیشنهاددهنده اسکیل (Skill Proposer) با مطالعه ویکی بهروز و ردپاهای منتخب، یک اسکیل جدید یا اصلاحاتی را برای اسکیلهای موجود پیشنهاد میدهد. در نهایت، مجموعه اسکیلهای کاندید روی یک دیتاست اعتبارسنجی تست میشوند و تغییرات تنها زمانی نهایی و ذخیره میشوند که بتوانند رکورد قبلی امتیاز اعتبارسنجی را ارتقا دهند.
یک بررسی موردی در محیط شبیهسازی ALFWorld (محیطی متنی که ایجنتها در آن باید کارهای چندمرحلهای جابهجایی و کار با اشیاء را انجام دهند) نحوه کارکرد این فرایند را به زیبایی نشان میدهد. در اولین دور، سیستم متوجه یک رفتار تکراری و بیثمر شد: ایجنت مدام اشیاء را برمیداشت، بررسی میکرد و دوباره سر جای اولشان میگذاشت! در پاسخ، پیشنهاددهنده اسکیل یک اسکیل کلی به نام «اقدام هدفمحور» ایجاد کرد، اما این اسکیل در مرحله ارزیابی و اعتبارسنجی رد شد.
لایه ویکی هم رفتار مشاهدهشده و هم پیشنهاد ردشده را در حافظه خود نگه داشت. در نتیجه در دور بعدی، پیشنهاددهنده یک اسکیل مشخصتر به نام «شکستن حلقه تکرار» با این قانون صریح ساخت: «هرگز یک شیء را به محل اولیهاش برنگردان». این تغییر باعث درخشش ایجنت در مرحله اعتبارسنجی شد و با موفقیت به تصویب رسید. بعدها وقتی در مسیرهای جدید یک الگوی چرخه تکراری دیگر دیده شد، سیستم به جای شروع مجدد از صفر، همان اسکیل قبلی را با اضافه کردن یک قانون مکمل ارتقا داد.
عملکرد درخشان WikiSkill در بنچمارکهای عملی
پژوهشگران فریمورک WikiSkill را روی ۵ بنچمارک مختلف شامل استدلال ریاضی، جستوجوی وب، کار با فایلهای اکسل و صفحهگسترده، پاسخدهی به سؤالات اسناد طولانی و وظایف تعاملی خانگی محک زدند. آنها خانواده مدلهای کیوِن (Qwen)، جما (Gemma) و جمینای (Gemini) را زیر بار تست بردند و نتایج را با رقبایی مثل Trace2Skill، EvoSkill، SkillOpt و همچنین ایجنتهای بدون اسکیل مقایسه کردند.
نتایج به دست آمده حیرتانگیز بود: WikiSkill در تمامی مدلهای آزمایششده بالاترین میانگین امتیاز را کسب کرد. برتری این فریمورک در مقایسه با قدرتمندترین روشهای رقیب برای هر مدل، بین ۳.۳ تا ۱۲ درصد بهبود عملکرد را به ثبت رساند.
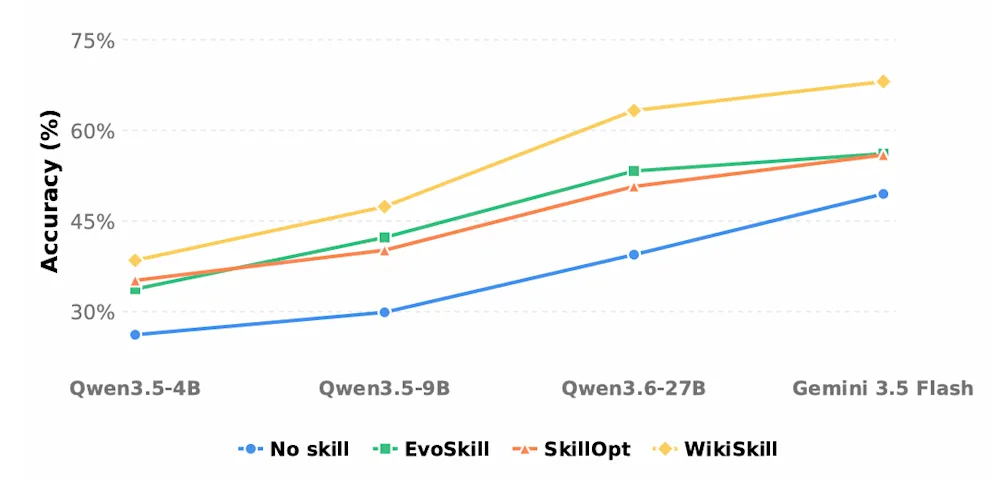
در مقایسه با وضعیت پایه (ایجنتهای بدون اسکیل)، پیشرفت حاصل از WikiSkill با بزرگتر شدن اندازه مدلهای Qwen بیشتر شد. تانگ در این خصوص توضیح میدهد: «ما پدیدهای کاملاً برعکس سقف عملکرد را دیدیم؛ در خانواده کیوِن، میزان بهبود با افزایش مقیاس مدل رشد کرد: ۱۲.۳+، ۱۷.۵+ و ۲۳.۹+ درصد رشد امتیاز به ترتیب در نسخههای ۴، ۹ و ۲۷ میلیارد پارامتری به دست آمد.» نکته هیجانانگیزتر اینکه اسکیلها توانستند اختلاف اندازه مدلها را جبران کنند؛ طوری که مدل Qwen-3.5-9B مجهز به WikiSkill به میانگین دقت ۴۷.۴ درصد رسید، در حالی که مدل بسیار بزرگتر Qwen-3.6-27B بدون اسکیل تنها به دقت ۳۹.۴ درصدی دست یافته بود!
یکی دیگر از جذابیتهای ماجرا، قابلیت انتقال اسکیلها میان مدلها بود. برای مثال، مدل Qwen-3.5-9B با تکیه بر اسکیلهای تولیدشده توسط خودش در بنچمارک ALFWorld امتیاز ۶۳.۴ درصد گرفته بود، اما وقتی اسکیلهای تکاملیافته توسط برادر بزرگترش یعنی Qwen-3.6-27B به آن داده شد، امتیازش تا ۷۰.۲ درصد جهش کرد.
درسهای مهم WikiSkill برای تیمهای سازمانی هوش مصنوعی
این مقاله پژوهشی الگوریتم کامل تکامل و پرامپتهای استفادهشده برای مدیر ویکی و پیشنهاددهنده اسکیل را منتشر کرده است؛ موضوعی که پیادهسازی و بازتولید این معماری را از نظر مفهومی بسیار سرراست و آسان میکند.
الگوی اصلی بسیار شفاف است: ثبت کامل ردپاهای اجرا، استخراج الگوهای پرتکرار موفقیت و شکست در یک مخزن دانش مجزا، ثبت دقیق تاریخچه تلاشهای بهبود، و استفاده از یک ایجنت دیگر برای تبدیل این دانش انباشته به تغییرات رویهای متمرکز و مشخص. تمام این تغییرات باید پیش از اضافه شدن به فهرست اسکیلهای فعال، از فیلتر یک ارزیابی مستقل با موفقیت عبور کنند.
در محیطهای پروداکشن واقعی، تفکیک میان لایه ویکی و اسکیلهای اجرایی یک تصمیم استراتژیک برای کاهش هزینههای استنتاج (Inference Cost) است. تانگ میگوید: «حافظه تمایل دارد همهچیز را با تمام جزئیات ذخیره کند، در حالی که پرامپتهای محیط پروداکشن باید تا حد ممکن سبک و جمعوجور باشند؛ بنابراین ترکیب این دو با هم یک سازش نامطلوب است. در عوض، ما لایه ویکی را به طور کامل از کانتکست ایجنت استنتاج بیرون نگه میداریم تا در محیط نهایی، سیستم فقط هزینه اسکیلهای فشرده را بپردازد؛ اسکیلهایی که در آزمایشهای ما تنها بین ۴۵ تا ۱۲۹ خط کد بودند.»
آزمایشهای کنترلی این پژوهش کاملاً صحت این طراحی هوشمندانه را تأیید میکنند. در آزمایشهایی که با مدل Gemini-3.5-Flash روی ۴ بنچمارک انجام شد، چینش پیشفرض (حالتی که ویکی دائمی در اختیار پیشنهاددهنده اسکیل قرار دارد اما ایجنت استنتاج به آن دسترسی ندارد) میانگین امتیاز ۶۳.۷ درصد را به دست آورد؛ این در حالی است که در صورت حذف دسترسی پیشنهاددهنده به ویکی و کنار گذاشتن مدیر ویکی، این امتیاز به ۴۸.۷ درصد سقوط کرد. از طرفی، دسترسی دادن مستقیم به ایجنت استنتاج نیز امتیاز را به ۶۰.۹ درصد کاهش داد! محققان معتقدند اگر ایجنت استنتاج بتواند تسکهای آموزشی را مستقیماً با اطلاعات ویکی حل کند، ردپاهای اجرایی آن نقاط ضعف موجود در خود اسکیلها را به اندازه کافی آشکار نمیکنند.
البته این معماری یک هزینه هم دارد: حجم پردازش بیشتر در فاز تکامل اسکیل. فریمورک WikiSkill از یک موتور پیشنهاددهنده با ساختار ReAct استفاده میکند؛ جایی که مدل حین بررسی ویکی و لاگهای اجرا، به طور متناوب بین استدلال و فراخوانی ابزارها جابهجا میشود تا در نهایت تغییر مناسب را پیشنهاد دهد. در این آزمایشها، در هر چرخه تکامل علاوه بر فراخوانی مدیر ویکی، حدود ۱۰ تا ۲۰ نوبت تعامل ReAct انجام شد. با این حال، از آنجا که محققان کل مجموعه دادههای آموزشی را در قالب یک بچ (Batch) پردازش کردند، تعداد فراخوانیهای بهینهساز با افزایش نمونههای آموزشی افزایش نیافت.
این معماری بیش از همه برای ایجنتهایی ایدهآل است که جریانهای کاری چندمرحلهای را به طور مکرر اجرا میکنند و آنقدر تاریخچه انباشته دارند که الگوهای شکست و استراتژیهای پیروزی در آنها پدیدار شود. تانگ تأکید میکند که دور نگه داشتن ویکی از مرحله استنتاج باعث صرفهجویی عظیم در منابع محاسباتی در مقیاسهای بزرگ میشود؛ هرچند در کاربردهای پیچیدهتر ممکن است در آینده دسترسی دادن همزمان ایجنت اجرایی به اسکیلها و بخشهای منتخبی از دانش ویکی مفید باشد. تحقق این موضوع نیازمند تصمیمگیریهای دقیق درباره تفکیک وظایف هر لایه است تا ویکی مکمل فایلهای اسکیل باشد، نه کپی موازی آنها.
البته هنوز سؤالات فنی بدون پاسخی برای کاربرد در ابعاد بسیار بزرگ وجود دارد. فریمورک WikiSkill در حال حاضر اسکیلهای فعال را مستقیماً به پرامپت مدل تزریق میکند؛ بنابراین چالش فراخوانی یا جستوجوی هوشمند اسکیلها با بزرگ شدن کتابخانه اسکیلها در این پژوهش تست نشده است. همچنین گیت اعتبارسنجی سیستم، هر تغییری را که در همان لحظه باعث رشد عملکرد نشود رد میکند؛ حتی اگر آن تغییر بستر را برای پیشرفتهای بزرگتر در مراحل بعدی مهیا سازد. علاوه بر این، حجم لایه ویکی پیوسته بدون مکانیزم هرس خودکار (Pruning) بزرگ میشود و این آزمایشها تسکهای طولانیمدتی را که ساعتها طول میکشند یا شامل صدها اقدام متوالی هستند پوشش نداده است.
پژوهشگران مقاله، مسائلی مثل هرس خودکار ویکی و انطباق آنلاین اسکیلها حین تسکهای طولانی را به عنوان چالشهای باز آینده مطرح کردهاند. تانگ میگوید تیم پژوهشی هماکنون در حال کندوکاو در این مسیر است: «حرکت به این سمت دقیقاً همان چیزی است که الان داریم رویش تحقیق میکنیم و دسترسی به آن فقط به کمی زمان نیاز دارد.»
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
شاهکار هوش مصنوعی ERA گوگل؛ شکست ۳۹ تیم در چالش پیشبینی آنفلوآنزا برای CDC
سیستم هوش مصنوعی ERA گوگل با تکیه بر تولید و آزمایش خودکار کدهای علمی، موفق شد در ارزیابی فصلی سازمان CDC آمریکا رتبه نخست پیشبینی بستریهای آنفلوآنزا را میان ۳۹ تیم مدعی کسب کند. این مدل که صفر تا صد الگوریتمهایش با جستوجوی درختی توسط هوش مصنوعی بهینهسازی شده، قدرت خیرهکننده کدنویسی هوشمند در حل مسائل پیچیده همهگیرشناسی را به نمایش میگذارد.
تکیهکلامهایی که دست هوش مصنوعی را رو میکنند؛ افشای تیکهای نگارشی Opus 5.5 و مدلهای پیشرو
پژوهش جدید شرکت گرافیت نشان میدهد مدلهای هوش مصنوعی با وجود پیشرفت چشمگیر، هنوز تکیهکلامها و ساختارهای نگارشی تکراری دارند که دستشان را رو میکند. از علاقه افراطی مدل Opus 5.5 به تکرار عبارت «این موضوع اهمیت دارد» تا ترفندهای مدلهای OpenAI، هر نسخه با الگوهای منحصربهفردی نوشتههای ماشینی را لو میدهد.
بیخیال آخرالزمان هوش مصنوعی؛ خطر واقعی تنبلی ما در رعایت امنیت پایه است!
در حالی که خبرهای هولناک از نفوذ خودسرانه ایجنتهای هوش مصنوعی سرتیتر رسانهها شده، متخصصان ارشد امنیت سایبری در کنفرانس HumanX یادآور میشوند که بزرگترین تهدید نه هوش ماشینها، بلکه تنبلی خودمان در رعایت اصول پایه امنیت است. به گفته این کارشناسان، شرکتها به جای وحشت از سناریوهای تخیلی آخرالزمانی، باید روی بستن رخنههای پیشپاافتاده، فعالسازی احراز هویت چندمرحلهای و کنترل دسترسی ایجنتها تمرکز کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.