کدام مدل هوش مصنوعی در مشاورههای پزشکی بهتر عمل میکند؟ ارزیابی غولهای زبانی در بنچمارک HealthBench
بنچمارکهای تخصصی HealthBench شیوه پاسخگویی و کیفیت مشاورههای بالینی مدلهای هوش مصنوعی را در هزاران مکالمه پزشکی مورد سنجش قرار دادند. نتایج نشان میدهد در حالی که مدلهای اوپنایآی از نظر تعادل کارایی و هزینه دست بالا را دارند، کلود سانست ۵٫۵ با پاسخهای جامع خود رتبه اول مکالمات عمومی سلامت را تصاحب کرده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بنچمارکهای HealthBench و نسخه حرفهای آن، توانایی مدلهای هوش مصنوعی را در بیش از ۵٬۵۰۰ مکالمه پزشکی واقعی و بر اساس معیارهای تدوینشده توسط پزشکان ارزیابی میکنند.
- مدلهای GPT-6 Astra و GPT-6.1 Sol صدرنشین آزمون تخصصی کادر درمان شدند و مدلهای اوپنایآی کل مرز کارایی به هزینه (پارتو) را به تسخیر خود درآوردند.
- کلود سانست ۵٫۵ در گفتوگوهای عمومی سلامت اول شد؛ اما جریمه پرحرفی نشان داد پاسخهای کوتاهتر گرچه کیفیت ارتباط بهتری دارند، بخشی از جزئیات ضروری را فدا میکنند.
جدول ردهبندی بنچمارکهای جدید HealthBench و HealthBench Professional با هدف سنجش دقیق شیوه پاسخگویی مدلهای هوش مصنوعی در سناریوها و مکالمات واقعی حوزه سلامت منتشر شد.
بنچمارکهای HealthBench و HealthBench Professional دو معیار ارزیابی تخصصی توسعهیافته توسط اوپنایآی (OpenAI) هستند که پاسخ مدلهای هوش مصنوعی به مکالمات واقعی حوزه پزشکی و سلامت را بر اساس معیارهای تدوینشده توسط پزشکان امتیازدهی میکنند.
بنچمارک HealthBench مدلهای هوش مصنوعی را در قالب ۵٬۰۰۰ گفتوگو در حوزه سلامت با کاربران عادی و کادر درمان میسنجد. این مکالمات هفت محور کلی، از ارجاعات اورژانسی گرفته تا بهداشت عمومی را پوشش میدهند و هر معیار ارزیابی، ذیل یکی از پنج شاخص اصلی قرار میگیرد: «دقت»، «جامعیت»، «کیفیت ارتباط»، «درک زمینه» و «پیروی از دستورات». در مقابل، بنچمارک HealthBench Professional مجموعه محدودتری شامل ۵۲۵ مکالمه تخصصی است که برخلاف بنچمارک اصلی، تماماً با پزشکان و متخصصان بالینی انجام شدهاند. این سناریوها وظایف مشاورهای، نگارش متون پزشکی و تحقیقات بالینی را شامل میشوند و مکالمات دشوار و چالشبرانگیزی (Adversarial) را در بر دارند که با هدف سنجش تابآوری و آزمودن محدودیتهای مدلها طراحی شدهاند.
در این ارزیابی، هم «امتیاز خام» (درصد امتیازهای کسبشده از مجموع معیارهای ارزیابی) و هم «امتیاز تعدیلشده بر اساس طول پاسخ» که توسط اوپنایآی معرفی شده، ثبت و گزارش شده است. سازوکار تعدیل بر مبنای طول، امتیاز پاسخهای طولانیتر از ۲٬۰۰۰ کاراکتر را کاهش میدهد و به پاسخهای کوتاهتر پاداش میدهد. همچنین همگام با پیادهسازی مرجع اوپنایآی، پاسخهای تولیدشده در HealthBench Professional توسط مدل GPT-5.4 (low) و در HealthBench توسط مدل GPT-4.1 داوری و نمرهدهی شدهاند.
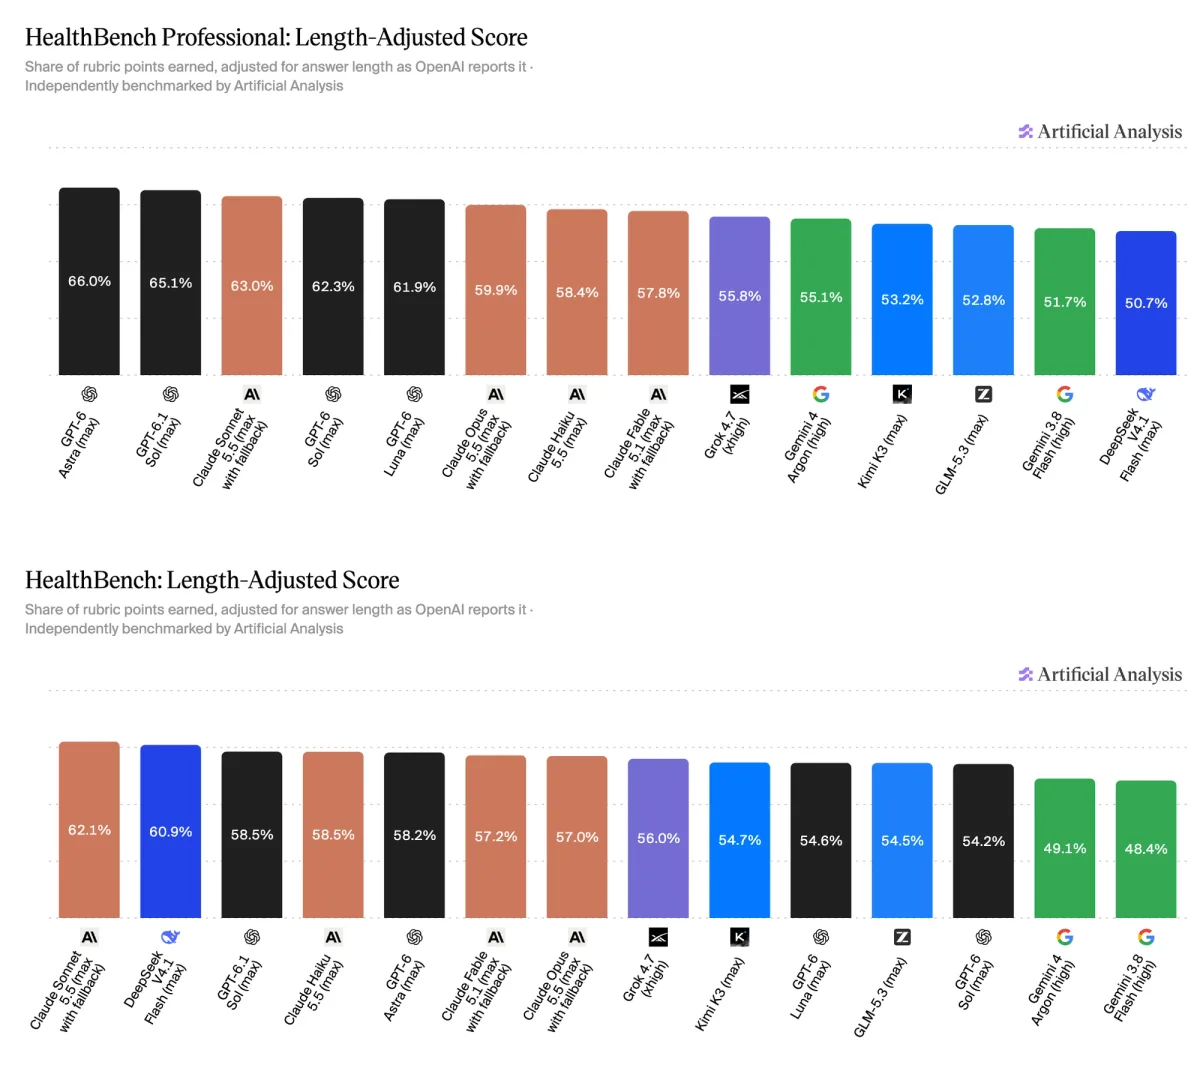
مهمترین نتایج در بنچمارک تخصصی HealthBench Professional:
➤ پیشتازی GPT-6 Astra و GPT-6.1 Sol در صدر جدول: مدل GPT-6 Astra (max) با کسب امتیاز تعدیلشده ۶۶٫۰ درصد در رتبه نخست قرار گرفت؛ عملکردی که شانه به شانه مدل GPT-6.1 Sol (max) با ۶۵٫۱ درصد بوده و بالاتر از مدل Claude Sonnet 5.5 (max with fallback) با ۶۳٫۰ درصد قرار میگیرد.
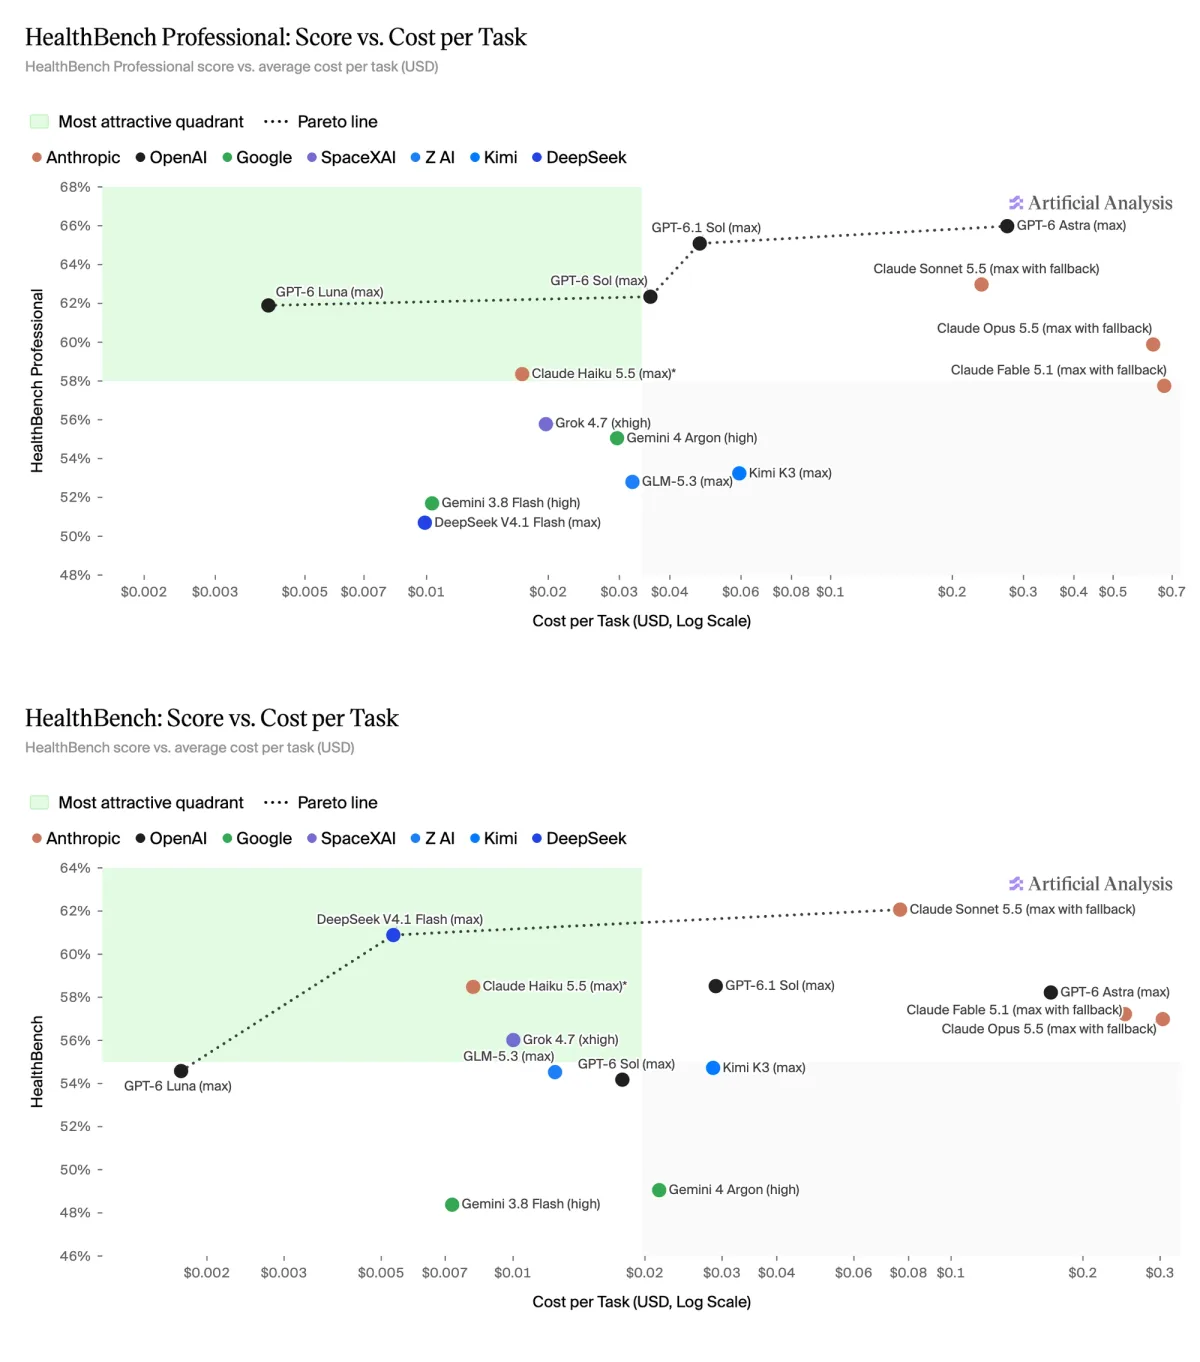
➤ تسخیر کامل مرز پارتو (کارایی در برابر هزینه) توسط مدلهای اوپنایآی: مرز بهینه پارتو (تعادل میان امتیاز کسبشده و هزینه پردازش هر وظیفه) بهشکل کامل در اختیار مدلهای خانواده OpenAI قرار دارد؛ مسیری که از مدل مقرونبهصرفه GPT-6 Luna (max) با امتیاز ۶۱٫۹ درصد و هزینه ۰٫۰۰۴ دلار به ازای هر وظیفه آغاز شده و با عبور از GPT-6 Sol (max) با ۶۲٫۳ درصد و ۰٫۰۳۶ دلار و سپس GPT-6.1 Sol (max) با ۶۵٫۱ درصد و ۰٫۰۴۷ دلار، در نهایت به پرچمدار گرانقیمت GPT-6 Astra (max) با امتیاز ۶۶٫۰ درصد و هزینه ۰٫۲۷ دلار میرسد. جالب آنکه مدل GPT-6 Luna (max) تنها ۴ امتیاز کمتر از پرچمدار اصلی کسب کرده، اما هزینه پردازش آن کمتر از ۲ درصد مدل Astra است!
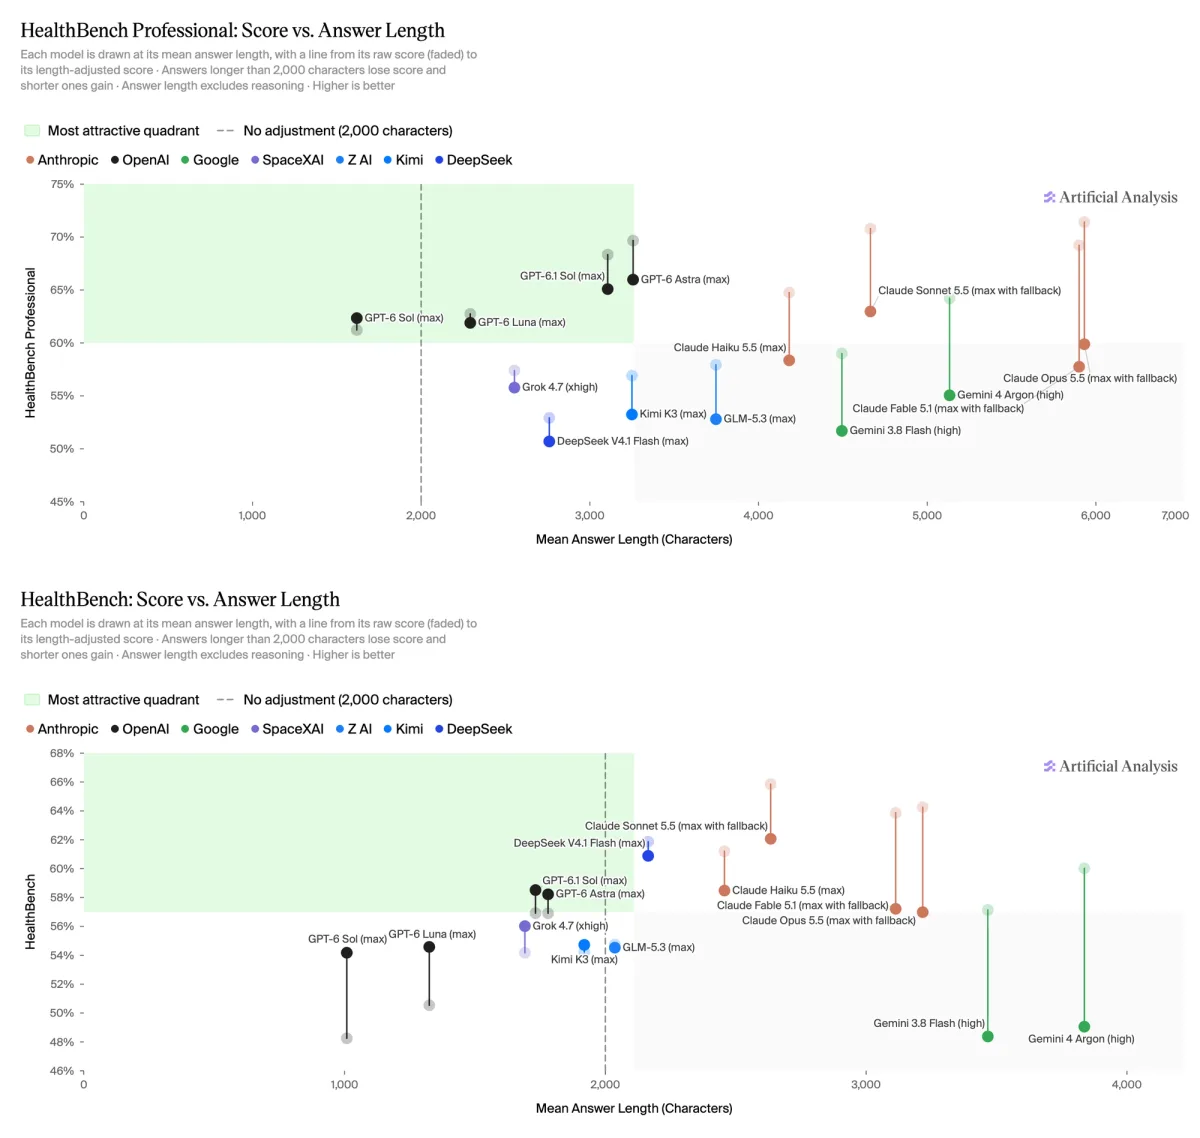
➤ سنگینترین جریمه اطناب کلام برای Claude Opus 5.5 و Claude Fable 5.1: میانگین طول پاسخ هر دو مدل به حدود ۵٬۹۰۰ کاراکتر میرسد که تقریباً ۳ برابر آستانه استاندارد ۲٬۰۰۰ کاراکتری است و به همین دلیل پس از تعدیل طول، بیش از ۱۱ امتیاز از دست دادند. جالب اینکه مدل Claude Opus 5.5 (max with fallback) با ۷۱٫۴ درصد بالاترین امتیاز خام کل این ارزیابی را کسب کرده بود، اما پس از اعمال جریمه طولانی بودن پاسخ، با سقوط به رتبه ششم، امتیاز آن به ۵۹٫۹ درصد تنزل یافت. در نقطه مقابل، مدل GPT-6 Sol (max) تنها گزینهای بود که میانگین طول پاسخهایش زیر ۲٬۰۰۰ کاراکتر (حدود ۱٬۶۰۰ کاراکتر) ماند و تنها مدلی لقب گرفت که امتیازش پس از تعدیل، بهبود یافت.
مهمترین نتایج در بنچمارک عمومی HealthBench:
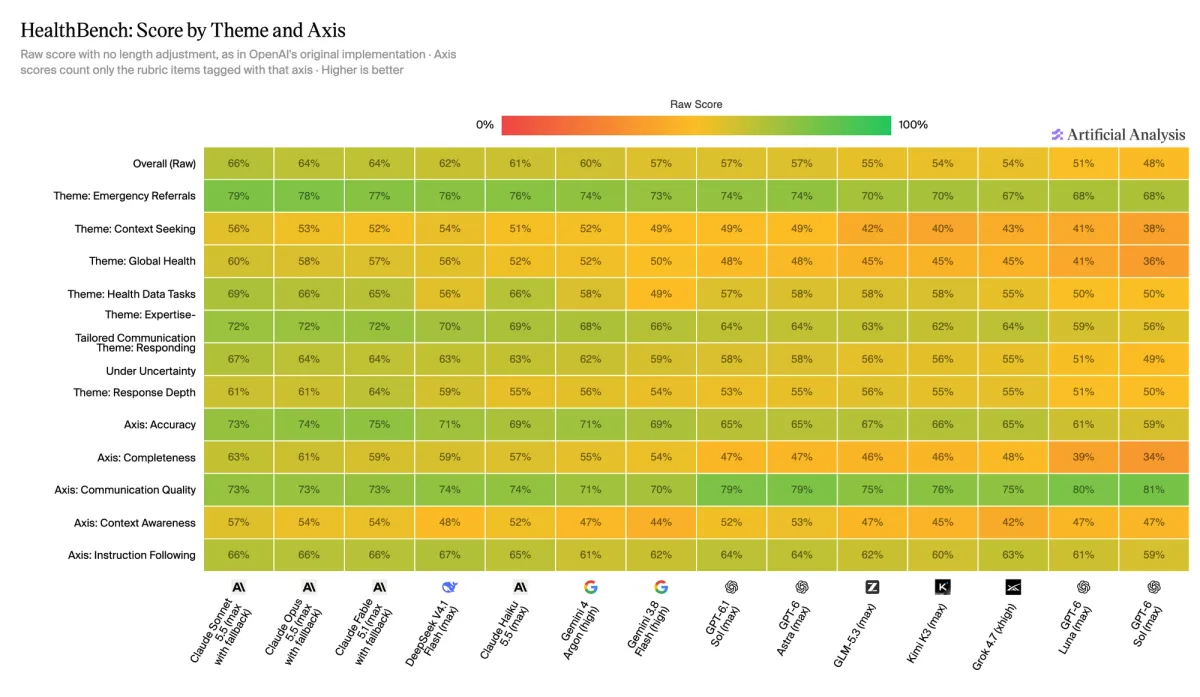
➤ صدرنشینی Claude Sonnet 5.5 در بنچمارک عمومی: در بنچمارک HealthBench، مدل Claude Sonnet 5.5 (max with fallback) با امتیاز تعدیلشده ۶۲٫۱ درصد رتبه اول را تصاحب کرد و جلوتر از رقبایی همچون DeepSeek V4.1 Flash (max) با ۶۰٫۹ درصد و GPT-6.1 Sol (max) با ۵۸٫۵ درصد ایستاد.
➤ ترکیب متنوع مرز پارتو با حضور مدلهای اوپنایآی، دیپسیک و آنتروپیک: در این بنچمارک، مرز بهینه امتیاز به هزینه توسط سه مدل شکل گرفت؛ GPT-6 Luna (max) با امتیاز ۵۴٫۶ درصد و هزینه فوقالعاده اندک ۰٫۰۰۲ دلار به ازای هر وظیفه، DeepSeek V4.1 Flash (max) با امتیاز ۶۰٫۹ درصد و هزینه ۰٫۰۰۵ دلار و سرانجام Claude Sonnet 5.5 (max with fallback) با امتیاز ۶۲٫۱ درصد. البته هزینه پردازش هر وظیفه در Claude Sonnet 5.5 بهطور میانگین ۰٫۰۸ دلار است؛ یعنی برای کسب تنها حدود ۱ امتیاز بیشتر نسبت به نماینده دیپسیک، هزینهای نزدیک به ۱۶ برابر را طلب میکند.
➤ پاسخهای کوتاهتر، جامعیت را فدای کیفیت ارتباط میکنند: هر سنجه در بنچمارک HealthBench به یکی از پنج شاخص اصلی اختصاص یافته است. معیار «جامعیت» مشخص میکند که آیا تمام اطلاعات کلیدی و ضروری در پاسخ آمده است یا خیر، در شرایطی که «کیفیت ارتباط» شفافیت، ساختاربندی درست و رعایت لحن و سطح جزئیات متناسب را ارزیابی میکند. در این میان، مدل GPT-6 Sol (max) کوتاهترین پاسخها (حدود ۱٬۰۰۰ کاراکتر) را ارائه داد و بالاترین امتیاز خام در کیفیت ارتباط (۸۱ درصد) را به دست آورد، اما همزمان ضعیفترین امتیاز جامعیت (۳۴ درصد) را به نام خود ثبت کرد. در سوی دیگر، مدل Claude Sonnet 5.5 (max with fallback) با کسب ۶۳ درصد، پیشتاز بیچونوچرای شاخص جامعیت اطلاعات بالینی بود.
مطالب مرتبط و پیشنهادی
روش نوآورانه پژوهشگران کایست دقت بازیابی مقالات علمی را با هوش مصنوعی ۷٫۸ درصد ارتقا داد
پژوهشگران مؤسسه کایست با توسعه چارچوبی نوین به نام Chain of Retrieval، روشهای سنتی فشردهسازی مقالات در یک بردار واحد را کنار زدند. این معماری با تفکیک هوشمندانه متن به چند پرسوجوی مجزا، دقت بازیابی اسناد علمی را نزدیک به ۸ درصد ارتقا میدهد.
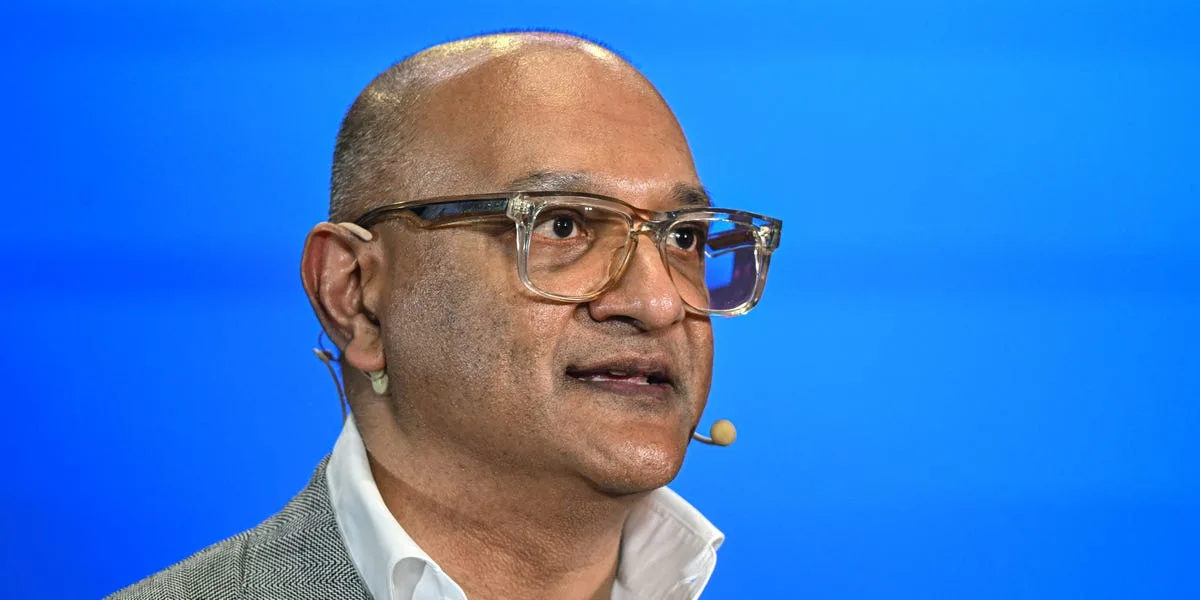
مدیر ارشد سیسکو با ایجنتهای هوش مصنوعی بیش از ۱٬۰۰۰ دلار در هزینههای اشتراک صرفهجویی کرد
جیتو پاتل، مدیر ارشد محصول سیسکو، با سپردن بررسی اشتراکهای سالانه ۹٬۰۰۰ دلاری خود به ایجنتهای هوش مصنوعی توانست بیش از ۱٬۰۰۰ دلار صرفهجویی کند. او معتقد است دستیاران هوشمند با وجود خطاهای امنیتی گاهوبیگاه، بهزودی نحوه مدیریت کارهای روزمره کاربران را دگرگون خواهند کرد.
مدل وزنباز Hemmingway-1 در نگارش متنهای روزمره از GPT-6 Astra پیشی گرفت
گروه پژوهشی The Commons Lab از مدل وزنباز ۲۷ میلیارد پارامتری Hemmingway-1 رونمایی کرد؛ ابزاری که بهطور ویژه برای نگارش ایمیلها و پیامهای کاری بهینهسازی شده است. این هوش مصنوعی برخلاف چتباتهای معمول، بدون مقدمهچینی متنی کوتاه و آماده ارسال تولید میکند و توانسته در آزمونهای نگارش روزمره از رقبای قدرتمندی مانند GPT-6 Astra پیشی بگیرد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.