مدیر سیاستگذاری هاگینگ فیس: استقرار ناظران مستقل چالشهای ارزیابی ایمنی هوش مصنوعی را حل نمیکند
مدیر ارشد سیاستگذاری هاگینگ فیس هشدار میدهد که استقرار ناظران بیرونی در شرکتهای هوش مصنوعی، بهتنهایی راهکار سادهای برای ارزیابی مدلها نیست. سنجش ایمنی و عملکرد مدلها و ایجنتها هنوز علم نوپایی است و بدون دسترسی به وزنهای باز و معیارهای استاندارد، مقایسه نتایج آنها بسیار دشوار خواهد بود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- به گفته مدیر ارشد هاگینگ فیس، ارزیابی مدلهای هوش مصنوعی هنوز علمی نابالغ است و تکرارپذیری نتایج آزمونها چالش بزرگی در صنعت به شمار میرود.
- ایده بهکارگیری ناظران مستقل در شرکتهای هوش مصنوعی با تردیدهایی درباره بیطرفی، صلاحیت فنی ارزیابها و نبود استانداردهای یکپارچه روبهرو است.
- با پیچیدهتر شدن سیستمها، ارزیابی هوش مصنوعی از بررسی مدلهای خام فراتر رفته و اکنون عملکرد بسترهای ارتباطی و ایجنتهای خودکار را نیز در بر میگیرد.
آزمایشگاهها و شرکتهای پیشرو هوش مصنوعی اعتبار خود را به نتایج بنچمارکها گره زدهاند؛ سازوکاری که در ظاهر معیاری بیطرفانه و دقیق برای سنجش عملکرد مدلها به حساب میآید و نشان میدهد کدام محصول هوش مصنوعی برتری دارد.
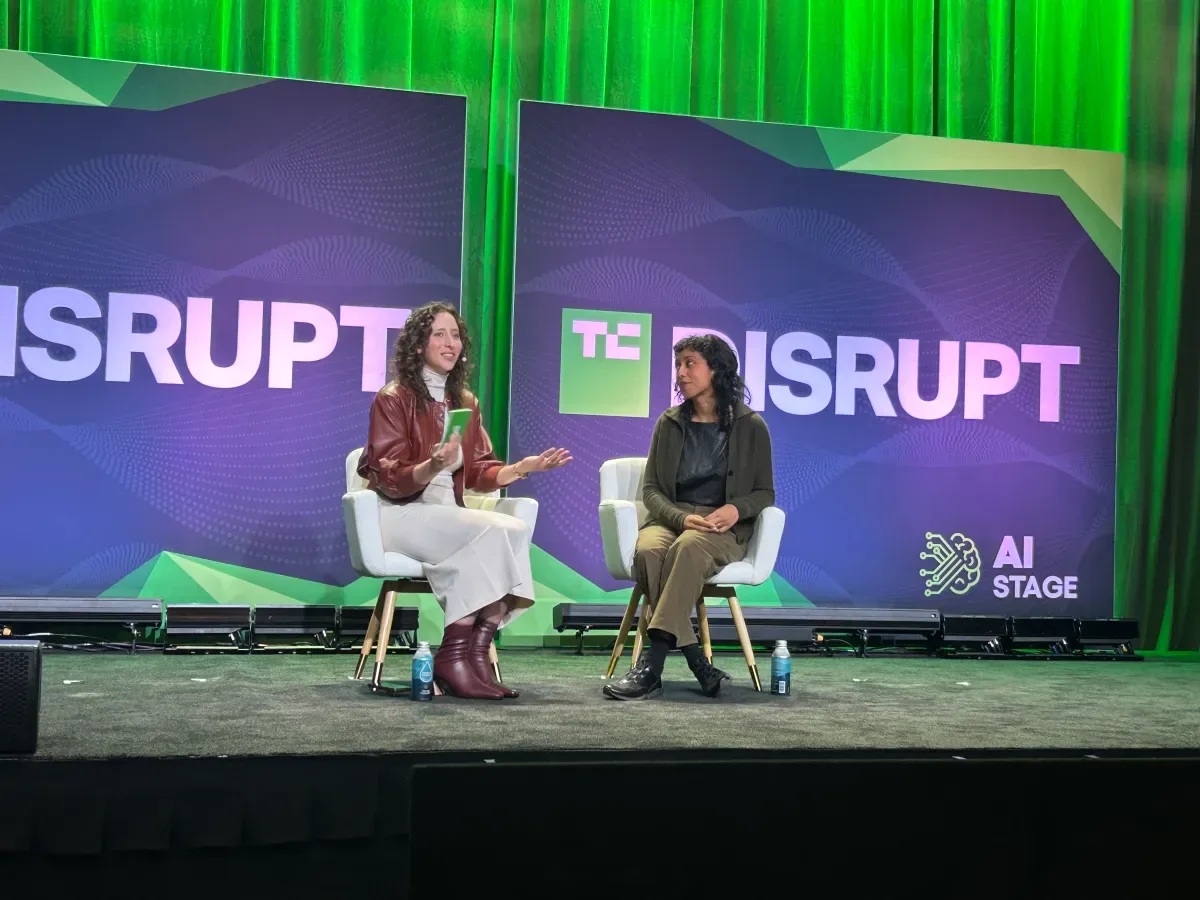
با این حال، روشهای پشت این ارزیابیها پیچیده و همچنان در مراحل ابتدایی رشد هستند؛ موضوعی که ایرین سولیمان (Irene Solaiman)، مدیر ارشد سیاستگذاری در پلتفرم هاگینگ فیس (Hugging Face)، در جریان یک نشست تخصصی حوزه فناوری در هفته گذشته به آن اشاره کرد. به باور او، اگر صنعت هوش مصنوعی قصد دارد در آینده به این نتایج اعتماد کند، فرآیند آزمون مدلها باید به دانشی یکپارچه و قاعدهمندتر تبدیل شود.
با در نظر گرفتن این واقعیت، آیا واقعاً میتوان به نتایج آزمونهایی که امروزه منتشر میشوند اعتماد کرد؟
سولیمان در پاسخ میگوید: «اعتماد بار معنایی سنگینی دارد. درباره اینکه آیا میتوانیم به نتایج اعتماد کنیم یا خیر، بخش بزرگی از ماجرا به این پرسش بازمیگردد که آیا توانایی بازآفرینی (تکرارپذیری) نتایج یک ارزیابی را دارید؟ آیا سطح دسترسی لازم به ساختار درونی خود مدل در اختیارتان قرار دارد؟ دقیقاً همینجاست که مدلهای وزنباز نقش پررنگ خود را نشان میدهند.»
تکرارپذیری در ارزیابی مدلها سالهاست که یکی از نقاط کور و چالشبرانگیزترین ابعاد بنچمارکگیری بوده است و همچنان بحثهای گستردهای میان متخصصان این حوزه بههمراه دارد.
گذشته از میزان اعتبار یک آزمون منفرد، مسئله مهم دیگر این است که چگونه میتوان نتایج آن سنجش را با ارزیابیهای دیگر مقایسه کرد.
سولیمان در این زمینه تأکید میکند: «این آزمونها متعلق به دانشی در حال تکامل هستند؛ دانشی که هنوز در آن شیوه مقایسه معنادار نتایج با یکدیگر را به درستی نمیدانیم.»
او ادامه میدهد: «این آزمونها خیلی سریع اثربخشی خود را از دست میدهند و ما هنوز اکوسیستم شکوفایی که به آن احتیاج داریم در اختیار نداریم. اکنون عطش زیادی برای شکلگیری اکوسیستم ناظران مستقر وجود دارد، اما شرایط و صلاحیتهایی که تعیین میکنند چه کسی برای سنجش کدام وظایف کارآمد است، به استانداردسازی بسیار بیشتری نیاز دارد.»
ایده بهکارگیری ارزیابهای مستقر — که در آن ناظران شخص ثالث و ظاهراً «بیطرف» در درون شرکتهای هوش مصنوعی حضور مییابند — طی ماههای اخیر طرفداران زیادی پیدا کرده است؛ چراکه آزمایشگاههای هوش مصنوعی با موجی از حوادث امنیتی دستوپنجه نرم میکنند که نگرانیها پیرامون خطرات بالقوه این فناوری را برانگیخته است. جالب اینکه خود هاگینگ فیس نیز پیشتر هدف یکی از همین رخدادهای امنیتی جنجالی قرار گرفته بود.
آزمایشگاههای هوش مصنوعی بهجای پذیرش نظارت و قانونگذاری مستقیم دولتی برای مهار نگرانیهای امنیتی، راهکار ارزیابی توسط ناظران مستقل را در پیش گرفتهاند. با این همه، تردیدهای عمیقی پیرامون میزان بیطرفی و کارایی واقعی این ناظران وجود دارد. برای نمونه، تصمیم شرکت آنتروپیک (Anthropic) برای استخدام شرکت اکسنچر (Accenture) بهعنوان نخستین ارزیاب بیرونی خود، با موجی از واکنشهای منفی روبهرو شد و بسیاری از منتقدان، صلاحیت این شرکت مشاورهای را برای سنجش ایمنی مدلها زیر سؤال بردند.
امروزه آزمونهای هوش مصنوعی در حال گذار از سنجش صِرف مدل خام به ارزیابی کل اکوسیستم پیرامون آن هستند؛ سیستمی که بستر تعامل یا هارنس (Harness) و ایجنت هوشمند را در بر میگیرد. به گفته سولیمان، هارنس — یعنی رابط یا ابزاری که کاربر برای ارتباط با مدل به کار میگیرد — تأثیر فوقالعادهای بر عملکرد خروجی دارد؛ بهطوریکه یک مدل ضعیفتر در بستری بهینهتر میتواند حتی یک مدل پیشتاز و تراز اول (Frontier) را پشت سر بگذارد.
سولیمان خاطرنشان میکند: «ارزیابی عملکرد ایجنتها بینهایت دشوار و بسیار هزینهبر است. ما معیارهای سنجش متعددی برای خود مدلها در اختیار داریم، اما هنوز آزمونهای کافی برای هارنسها طراحی نشده است. با وجود این، در حال تدوین ارزیابیهای دقیقتری برای رفتار کلنگر ایجنتها هستیم؛ زیرا ارزش ملموسی که اغلب کاربران به دست میآورند دقیقاً از عملکرد همین ایجنتها سرچشمه میگیرد.»
به بیان دیگر، حوزه ارزیابی هوش مصنوعی در حال حاضر وضعیت نابسامانی دارد و هر شرکتی ساز خود را میزند. اگر قرار باشد بنچمارکها همچنان ابزاری قابل اتکا برای تصمیمگیری پیشگامان این صنعت باقی بمانند، تدوین رویکردی یکدست، هماهنگ و فراگیر در سراسر جامعه هوش مصنوعی که همگان بر سر آن اتفاق نظر داشته باشند، امری اجتنابناپذیر خواهد بود.
مطالب مرتبط و پیشنهادی
مدل زبانی مرکوری ۳ با سرعت ۱٬۰۶۸ توکن بر ثانیه از رقبای سرعتی جیپیتی و کلود پیشی گرفت
استارتاپ اینسپشن از مدل زبانی مرکوری ۳ رونمایی کرد که با بهرهگیری از رمزگشایی موازی دیفیوژن، بهسرعت کمنظیر ۱٬۰۶۸ توکن بر ثانیه دست مییابد. سازندگان این مدل ادعا میکنند که مرکوری ۳ علاوهبر کاهش چشمگیر تأخیر پاسخگویی در سیستمهای مبتنیبر ایجنت، کیفیتی همتراز یا حتی بالاتر از سریعترین مدلهای جیپیتی و کلود ارائه میدهد.
بزرگترین تحول محصولات لاجیتک در سالهای اخیر؛ آمادهسازی اتاق جلسات برای عصر ایجنتهای هوش مصنوعی
لاجیتک با رونمایی از نسل جدید تجهیزات ویدیو کنفرانس مجهز به تراشههای پردازش هوش مصنوعی، بزرگترین بهروزرسانی محصولات سازمانیاش را کلید زد. این شرکت قصد دارد با سادهسازی سختافزارها و بهکارگیری حسگرهای محیطی، سالنهای کنفرانس را به لایه فیزیکی دادهها برای ایجنتهای هوش مصنوعی تبدیل کند.
کدام مدل هوش مصنوعی در مشاورههای پزشکی بهتر عمل میکند؟ ارزیابی غولهای زبانی در بنچمارک HealthBench
بنچمارکهای تخصصی HealthBench شیوه پاسخگویی و کیفیت مشاورههای بالینی مدلهای هوش مصنوعی را در هزاران مکالمه پزشکی مورد سنجش قرار دادند. نتایج نشان میدهد در حالی که مدلهای اوپنایآی از نظر تعادل کارایی و هزینه دست بالا را دارند، کلود سانست ۵٫۵ با پاسخهای جامع خود رتبه اول مکالمات عمومی سلامت را تصاحب کرده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.