مدل زبانی مرکوری ۳ با سرعت ۱٬۰۶۸ توکن بر ثانیه از رقبای سرعتی جیپیتی و کلود پیشی گرفت
استارتاپ اینسپشن از مدل زبانی مرکوری ۳ رونمایی کرد که با بهرهگیری از رمزگشایی موازی دیفیوژن، بهسرعت کمنظیر ۱٬۰۶۸ توکن بر ثانیه دست مییابد. سازندگان این مدل ادعا میکنند که مرکوری ۳ علاوهبر کاهش چشمگیر تأخیر پاسخگویی در سیستمهای مبتنیبر ایجنت، کیفیتی همتراز یا حتی بالاتر از سریعترین مدلهای جیپیتی و کلود ارائه میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل زبانی مرکوری ۳ با استفاده از معماری دیفیوژن و بهروزرسانی موازی توکنها، سرعت خروجی را به ۱٬۰۶۸ توکن بر ثانیه روی تراشههای انویدیا رسانده است.
- این مدل در بنچمارکهای اولیه کیفیتی برابر با GPT-6 Luna و Claude Haiku 5.5 نشان داده و پنجره کانتکست آن به ۱ میلیون توکن ارتقا یافته است.
- سرعت بالای مرکوری ۳ زمان انتظار را در چرخههای چندمرحلهای ایجنتهای هوش مصنوعی بهشدت کاهش میدهد، هرچند ادعاهای سازنده هنوز نیازمند اعتبارسنجی مستقل هستند.
استارتاپ اینسپشن از مدل زبانی مرکوری ۳ (Mercury 3) رونمایی کرد؛ مدلی که با حذف تدریجی نویز (Denoising) از بلوکی از جایگاههای توکن، چندین موقعیت را بهصورت همزمان و موازی بهروزرسانی میکند. بر اساس گزارشهای اینسپشن، نرخ خروجی پردازش این مدل روی پردازندههای گرافیکی انویدیا به ۱٬۰۶۸ توکن بر ثانیه میرسد که تقریباً ۴ تا ۸ برابر سریعتر از مدلهای همرده سرعتی در مقایسههای فنی است.
این شرکت اعلام کرده است که مرکوری ۳ در مجموعه بنچمارکهای خود کیفیتی برابر یا حتی بهتر از GPT-6 Luna و Claude Haiku 5.5 ارائه میدهد. اگرچه این ارقام کارایی و کیفیت بر اساس مستندات اولیه اینسپشن گزارش شدهاند و برای تأیید نهایی نیازمند بازتولید مستقل در آزمایشهای بیطرفانه هستند، اما فرضیه مهندسی بسیار مهمی را پیش میکشند: رمزگشایی مبتنیبر دیفیوژن میتواند تأخیر تولید محتوا را بهشکل چشمگیری کاهش دهد، بدون آنکه فدای افت کیفیت معمول در مدلهای عملیاتی کوچکتر شود.
رمزگشایی موازی؛ تغییر معادله تأخیر در هوش مصنوعی
مدلهای خودبازگشتی (Autoregressive) نظیر خانواده GPT و Claude، توکنها را به ترتیب و پشتسرهم تولید میکنند؛ به این معنا که ایجاد هر توکن جدید به توالی قبلی وابسته است. همین وابستگی زنجیرهای مانع از محاسبه موازی بخش بزرگی از پاسخ میشود و باعث خواهد شد با افزایش طول متن، زمان مورد نیاز برای تولید خروجی بهشکل تصاعدی بالا برود.
در نقطه مقابل، یک مدل زبانی دیفیوژن کار خود را با بازنمایی دارای نویز یا ماسکشده از توالی هدف آغاز میکند و سپس موقعیت توکنها را طی چند گام رفتوبرگشتی بهبود میبخشد. بهروزرسانیهای موازی میتوانند توان عملیاتی (Throughput) را بهشکل چشمگیری افزایش دهند؛ هرچند تأخیر کلی سرتاسری همچنان به عواملی مانند طول خروجی، تعداد مراحل نویززدایی، سختافزار، دستهبندی درخواستها (Batching)، پردازش پرامپت و نحوه تحویل متن نهایی به کاربر بستگی دارد.
اینسپشن اعلام کرده است که تعداد پارامترهای مرکوری ۳ بیش از ۴۰ برابر مدل Mercury 1 Mini است و در بنچمارکهای تجمیعی، پیشرفتی ۳ برابری را به ثبت رسانده است. در اسناد منتشرشده تعداد دقیق و مطلق پارامترها ذکر نشده که این موضوع مقایسه مستقیم ابعاد مدل و هزینه استنتاج (پاسخگویی) آن را با محدودیت روبهرو میکند. با وجود این، نتایج بهدستآمده ادعای اینسپشن را تقویت میکند که با افزایش مقیاس آموزش، کارایی مدلهای زبانی دیفیوژن نیز بهطرز محسوسی ارتقا مییابد.
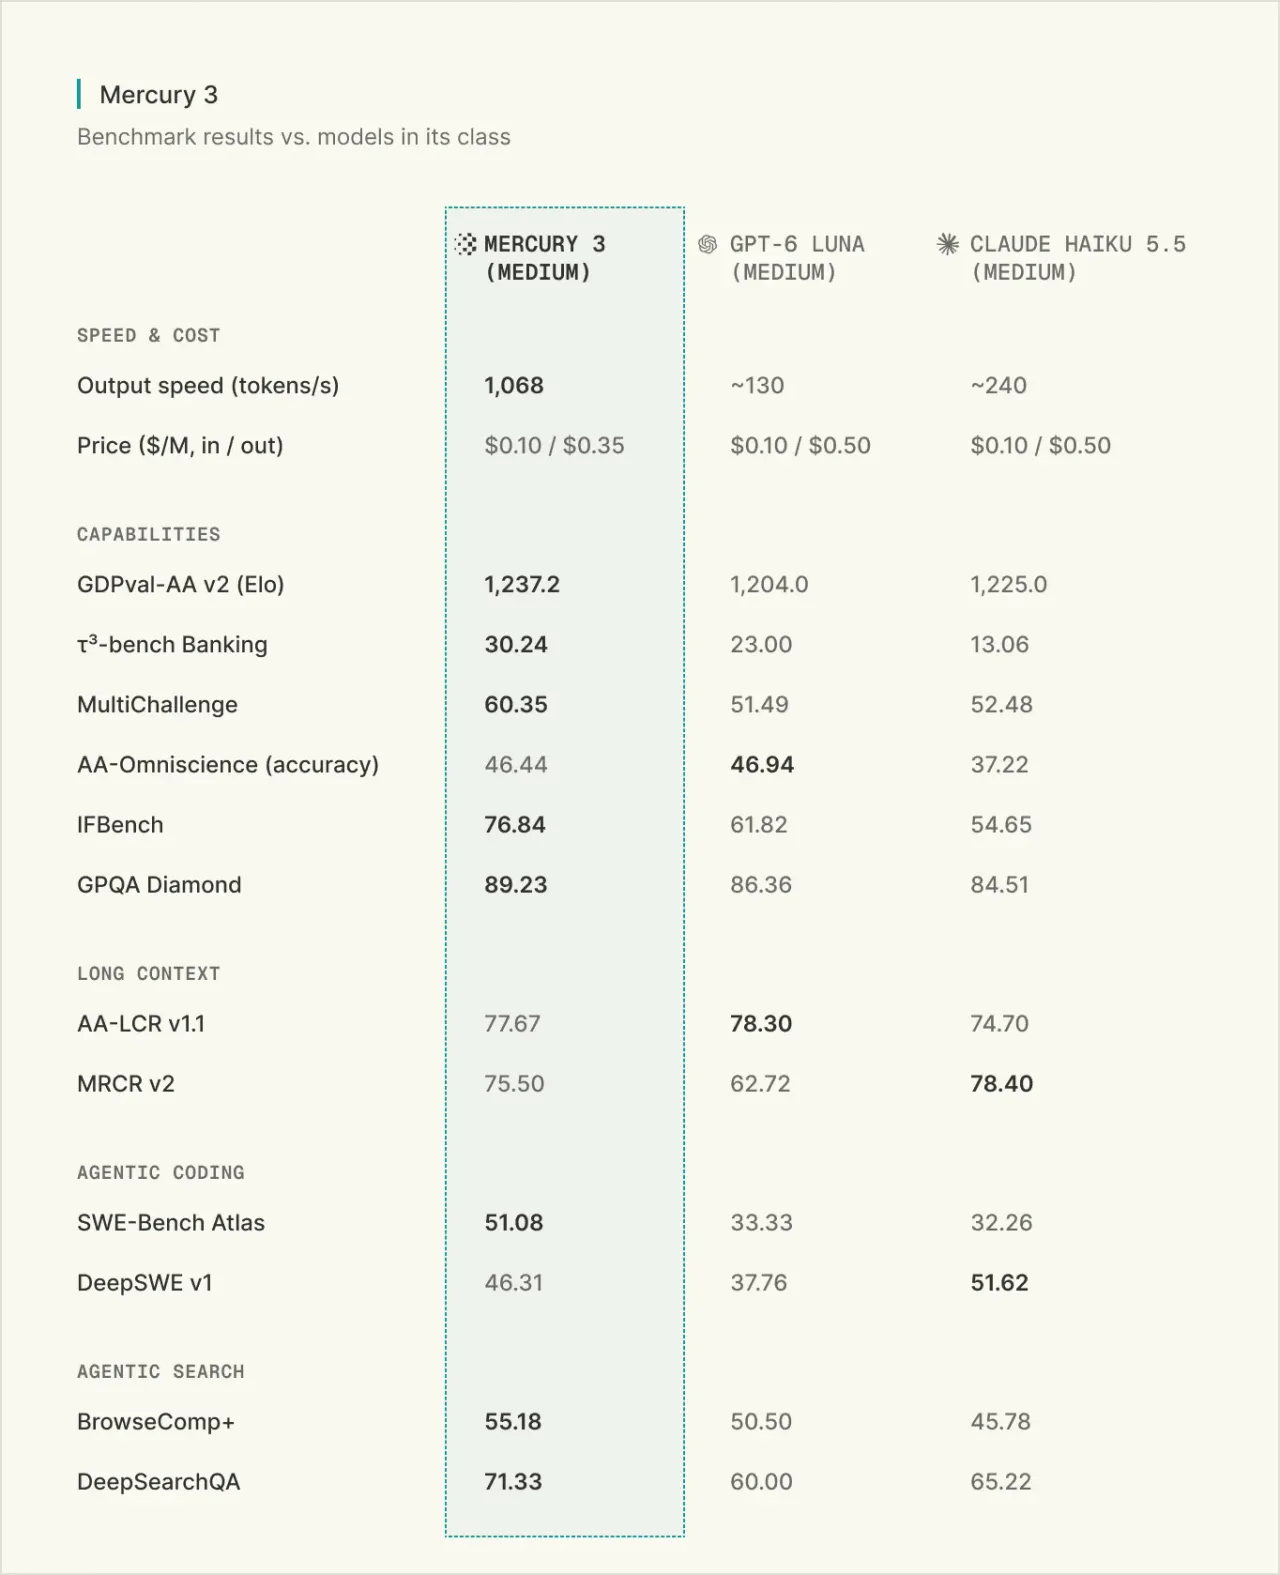
آمارهایی که توسعهدهندگان باید زیر ذرهبین بگذارند
معیار | ادعای اینسپشن | نکات مهم برای توسعهدهندگان |
|---|---|---|
توان خروجی (Throughput) | ۱٬۰۶۸ توکن بر ثانیه روی پردازندههای گرافیکی انویدیا | مقایسههای تکرارپذیر نیازمند مشخص بودن مدل GPU، اندازه بچ (Batch Size)، دقت محاسباتی، طول خروجی، همزمانی و روش اندازهگیری است. |
پنجره کانتکست (زمینه) | ۱ میلیون توکن (افزایش چشمگیر از ۲۶۰ هزار توکن در مرکوری ۲٫۵) | حداکثر طول کانتکست تضمینکننده کیفیت بازیابی در حجمهای نزدیک به سقف نیست؛ باید پرامپتهای طولانی واقعی را آزمایش کرد. |
قیمتگذاری استاندارد | ۰٫۲۰ دلار به ازای هر میلیون توکن ورودی و ۰٫۷۰ دلار به ازای هر میلیون توکن خروجی | هزینه واقعی را بر اساس اجرای کامل چرخههای ایجنت، شامل تلاشهای مجدد، نتایج ابزارها و کانتکستهای تکراری بسنجید. |
قیمتگذاری در دوره عرضه | ۰٫۱۰ دلار به ازای هر میلیون توکن ورودی و ۰٫۳۵ دلار به ازای هر میلیون توکن خروجی | این تخفیف ۵۰ درصدی است و توکنهای ورودی کششده نیز مشمول ۹۰ درصد تخفیف مازاد نسبت به نرخ ورودی اعمالشده میشوند. |
هدف کیفی | همتراز یا بهتر از GPT-6 Luna و Claude Haiku 5.5 | میزان موفقیت مدل را بهجای تکیه بر نمرات تجمیعی، روی پرامپتهای اختصاصی کاربرد کاری خود ارزیابی کنید. |
تمرکز اینسپشن بر تسخیر رده سرعتی مدلهایی مانند Claude Haiku، Gemini Flash و GPT Luna است. بنابراین بارهای کاری سنگین که نیازمند استدلالهای پیچیده ریاضی، برنامهریزیهای طولانی یا تغییرات نرمافزاری در سطح کل مخزن کد (Repository) هستند، همچنان گزینههای بهتری برای سنجش در برابر مدلهای استدلالی بزرگتر به شمار میروند.
چرخههای ایجنتی هزینه سنگین تأخیر را برملا میکنند
سیستمهای مبتنیبر ایجنت تأخیر تولید محتوا را چندبرابر نشان میدهند؛ زیرا هر مشاهده، تصمیمگیری، فراخوانی ابزار و اقدام بعدی ممکن است به یک درخواست مجزا از مدل نیاز داشته باشد. یک تأخیر ناچیز در هر درخواست میتواند در طول یک تسک کامل جمع شود و به چندین ثانیه معطلی برسد؛ مسئلهای که توان عملیاتی و تأخیر دورافتاده (Tail Latency) را به معیارهایی حیاتی در پیادهسازی تبدیل میکند.
اینسپشن گزارش داده است که مرکوری ۳ را در یک زیرساخت تست ایجنت وب در محیط عملیاتی و روی ۵۰ تسک ناوبری زنده Mind2Web آزمایش کرده است. این مدل موفق شده ۵۰ درصد یعنی ۲۵ تسک را به سرانجام برساند و با مصرف همان میزان توکن و تعداد گامهای مشابه، عملکردی فراتر از GPT-6.1-Sol به نمایش بگذارد. البته یک نمونه آزمایشی ۵۰ تسکی که توسط خود سازنده انجام شده باشد، تنها نشاندهنده یک گرایش کلی است؛ مقایسهای دقیقتر و مستند نیازمند ارائه نرخ پایه موفقیت، پرامپتها، تنظیمات دقیق محیط آزمون، دستهبندی خطاها و بازه اطمینان آماری خواهد بود.
نتایج گزارششده از سوی مشتریان اولیه در اسناد رونمایی نیز بر تأخیر تعاملی متمرکز است. شرکت Octen AI که توسعهدهنده عینکهای هوشمند است، میانه زمان تولید را ۰٫۹ ثانیه و میانه زمان پاسخگویی سرتاسری را ۲٫۲ ثانیه اعلام کرده است. از طرف دیگر، پلتفرم آموزشی RevisionDojo میگوید مرکوری ۳ راهنماییها و نمرات آزمونها را ظرف حدود یک ثانیه ارائه میدهد. البته تا زمان انتشار عمومی شرایط دقیق آزمایش، این گزارشها باید در حد ارزیابیهای تجربی مشتریان تلقی شوند.
کاربردهایی که با این معماری همخوانی دارند
- ایجنتهای وب و مرورگرها: تولید سریعتر پاسخ میتواند وقفهها را در تکتک مراحل برنامهریزی و ناوبری صفحات به حداقل برساند.
- دستیارهای صوتی: تأخیر پاسخگویی سرتاسری پایین، به حفظ روند طبیعی رفتوبرگشت کلامی در گفتوگو کمک شایانی میکند.
- آموزش و تدریس تعاملی: بازخورد آنی مدل، ارائه سریع راهنماییها، تصحیح پاسخها و تبادل پیامهای کوتاه پیاپی را تسهیل میسازد.
- جستوجو و ترکیب اطلاعات: توان عملیاتی بالا میتواند سرعت آمادهسازی پاسخهای استخراجشده از انبوهی از اسناد بازیابیشده را دوچندان کند.
- پشتیبانی مشتریان: پس از اطمینان از دقت تخصصی، ایمنی و انطباق با قوانین، کاهش تأخیر در جریانهای کاری پرترافیک مزیت بزرگی بههمراه دارد.
- طبقهبندی دادهها: اینسپشن برای این حوزه از بار کاری، مدل خواهر دیگری با نام Mercury Decide را در دست توسعه دارد.
محدودیتها و چالشهایی که باید به آنها توجه کرد
- بنچمارکهای ارائهشده توسط سازنده: دادههای مربوط به کیفیت، توان پردازش و عملکرد ایجنتی همگی توسط خود اینسپشن ثبت شدهاند و کارشناسان مستقل هنوز نتوانستهاند این آمار را در آزمونهای بیطرفانه تأیید کنند.
- تفاوت توان عملیاتی با تأخیر واقعی: تعداد توکن بر ثانیه، شاخصهایی مانند زمان تولید نخستین بخش متن (Time to First Token)، تأخیر صدک نودوپنج (p95)، تأخیر پردازش پرامپت یا افت بازده زیر بار ترافیکی همزمان را بازتاب نمیدهد.
- سقف توانمندی در استدلال: مقایسههای صورتگرفته صرفاً روی مدلهای رده سرعتی متمرکز بوده و جایگاه این مدل در برابر سیستمهای استدلالی سنگینتر همچنان نامشخص است.
- کیفیت کار با کانتکست طولانی: سقف ۱ میلیون توکن صرفاً گنجایش حجمی را نشان میدهد؛ دقت در بازیابی اطلاعات و وفاداری به دستورالعملها در چنین کانتکست وسیعی نیازمند آزمایشهای جداگانه است.
- عدم دسترسی به معماری داخلی: اینسپشن نه وزنهای مدل را بهصورت وزنباز (Open-weight) عرضه کرده و نه مقاله فنی جامعی از معماری آن انتشار داده است؛ بنابراین امکان بررسی دقیق ساختار مدل و فرایند آموزش وجود ندارد.
- تفاوتهای رفتاری API: سازگاری ساختار فراخوانی با استاندارد اوپنایآی به معنای تطابق کامل در استریم، صدا زدن ابزارها (Tool Calling)، خروجیهای ساختاریافته، محاسبه دقیق توکنها یا نحوه مدیریت خطاها نیست.
نحوه تست مرکوری ۳ تنها با تغییر یک آدرس Endpoint
مدل مرکوری ۳ هماکنون از طریق پلتفرم API اینسپشن، OpenRouter، پلتفرم Baseten و Vercel در دسترس قرار دارد. توسعهدهندگان میتوانند پاسخهای مدل را در محیط چت آزمایشی (Playground) بررسی کنند یا نگاهی به مستندات رسمی API بیندازند.
کتابخانه پایتون فعلی OpenAI نیز تنها با تغییر آدرس پایه (Base URL)، کلید API و شناسه مدل میتواند این مدل جدید را فراخوانی کند:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.inceptionlabs.ai/v1",
    api_key=os.environ["INCEPTION_API_KEY"],
)

response = client.chat.completions.create(
    model="mercury-3",
    messages=[
        {
            "role": "user",
            "content": "Draft a concise reply to this customer email."
        }
    ],
)

print(response.choices[0].message.content)
برای ارزیابی واقعی و مقایسه عملکرد در محیط عملیاتی، باید رفتار جامع برنامه را زیر بار ترافیکی واقعی و با توزیع پرامپتهای متنوع سنجید:
- میزان موفقیت در اجرای تسکها و کیفیت پاسخ را با ورودیهای واقعی بسنجید.
- میانه و صدک نودوپنج (p95) تأخیر سرتاسری را با احتساب زمان پردازش پرامپت و تأخیر شبکه ثبت کنید.
- عملکرد همزمانی، محدودیت تعداد درخواست (Rate Limits)، تلاشهای مجدد و خطاهای اختصاصی ارائهدهنده را تست کنید.
- پیش از بهکارگیری مدل در رابطهای صوتی و چت، پایداری استریم و ارسال تکهتکه پاسخها (Chunks) را بررسی کنید.
- فراخوانی ابزارها، اسکیماهای JSON، شرایط توقف (Stop Conditions) و شیوه شمارش توکنها را اعتبارسنجی کنید.
- دقت بازیابی اطلاعات را در تمام گستره پنجره کانتکست تبلیغشده بیازمایید.
- هزینه نهایی کل فرایند کاری، شامل دفعات شکست و مراحل تکرارشده در حلقههای ایجنتی را مقایسه کنید.
آزمونهای مستقل؛ محک نهایی برای معماری دیفیوژن
مرکوری ۳ یک API عملیاتی در اختیار برنامهنویسان قرار میدهد تا عملکرد رمزگشایی دیفیوژن را در برابر مدلهای اثباتشده خودبازگشتی بسنجند. دستیابی به موفقیتی واقعی در میدان عمل، نیازمند نرخ موفقیت همتراز در تسکها، تأخیر کمتر در بدترین سناریوها و هزینه نهایی پایینتر زیر بار ترافیکی همزمان است. تا زمانی که نتایج ارزیابیهای مستقل این دادهها را به تأیید نرسانند، عرضه این مدل توسط اینسپشن صرفاً نشان از یک فرضیه مهندسی قابلتوجه دارد که ارزش کاربردی آن بسته به نوع نیاز و پروژه تفاوت خواهد داشت.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
بزرگترین تحول محصولات لاجیتک در سالهای اخیر؛ آمادهسازی اتاق جلسات برای عصر ایجنتهای هوش مصنوعی
لاجیتک با رونمایی از نسل جدید تجهیزات ویدیو کنفرانس مجهز به تراشههای پردازش هوش مصنوعی، بزرگترین بهروزرسانی محصولات سازمانیاش را کلید زد. این شرکت قصد دارد با سادهسازی سختافزارها و بهکارگیری حسگرهای محیطی، سالنهای کنفرانس را به لایه فیزیکی دادهها برای ایجنتهای هوش مصنوعی تبدیل کند.
کدام مدل هوش مصنوعی در مشاورههای پزشکی بهتر عمل میکند؟ ارزیابی غولهای زبانی در بنچمارک HealthBench
بنچمارکهای تخصصی HealthBench شیوه پاسخگویی و کیفیت مشاورههای بالینی مدلهای هوش مصنوعی را در هزاران مکالمه پزشکی مورد سنجش قرار دادند. نتایج نشان میدهد در حالی که مدلهای اوپنایآی از نظر تعادل کارایی و هزینه دست بالا را دارند، کلود سانست ۵٫۵ با پاسخهای جامع خود رتبه اول مکالمات عمومی سلامت را تصاحب کرده است.
روش نوآورانه پژوهشگران کایست دقت بازیابی مقالات علمی را با هوش مصنوعی ۷٫۸ درصد ارتقا داد
پژوهشگران مؤسسه کایست با توسعه چارچوبی نوین به نام Chain of Retrieval، روشهای سنتی فشردهسازی مقالات در یک بردار واحد را کنار زدند. این معماری با تفکیک هوشمندانه متن به چند پرسوجوی مجزا، دقت بازیابی اسناد علمی را نزدیک به ۸ درصد ارتقا میدهد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.