نسخه پنجم شاخص ارزیابی هوش مصنوعی منتشر شد؛ رقابت شانهبهشانه Claude Opus 5.5 و GPT-6
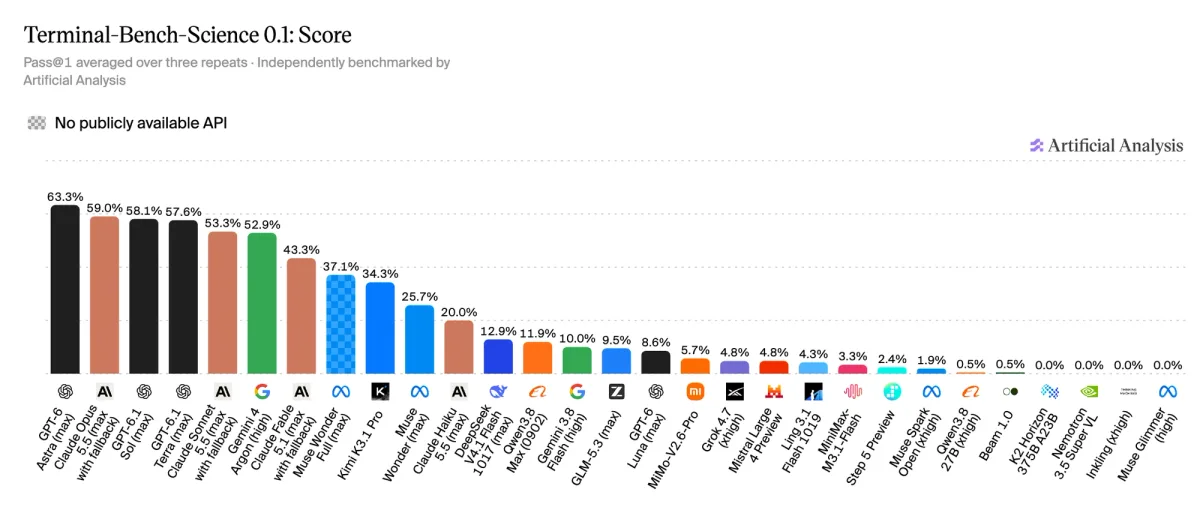
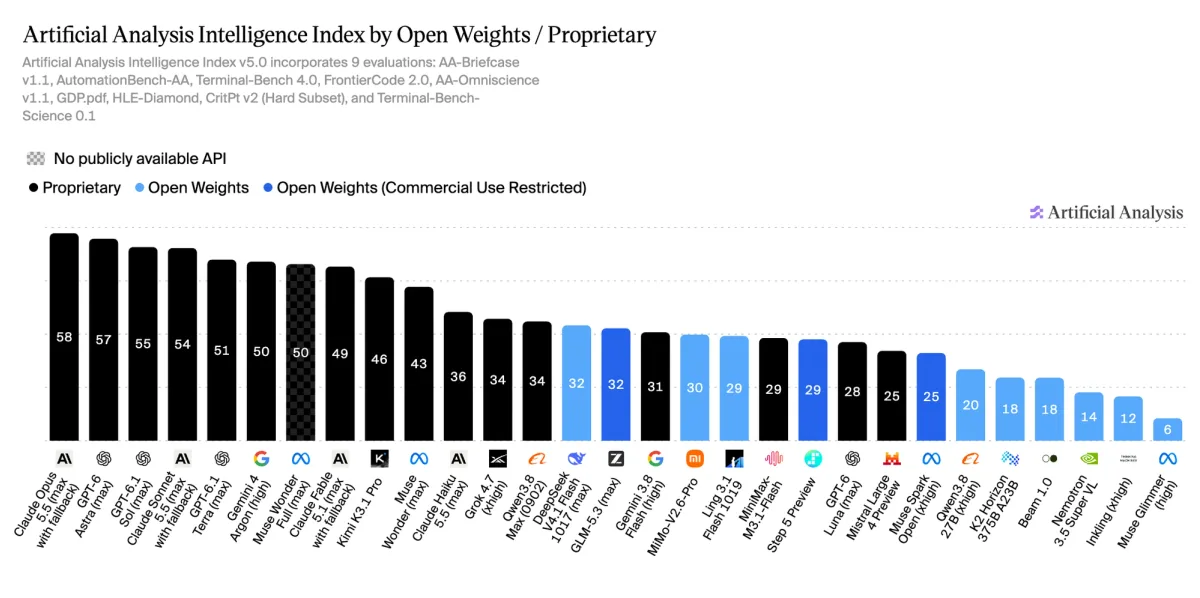
نسخه پنجم شاخص جامع ارزیابی مدلهای هوش مصنوعی با تمرکز بر آزمونهای محرمانه و سناریوهای واقعی معرفی شد. در این رتبهبندی جدید، مدلهای Claude Opus 5.5 و GPT-6 Astra در صدر جدول قرار گرفتهاند و شکاف عملکردی میان مدلهای اختصاصی و مدلهای متنباز بهطور محسوسی افزایش یافته است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مدل Claude Opus 5.5 با کسب بالاترین امتیاز در جایگاه نخست این شاخص قرار گرفت و مدلهای GPT-6 Astra و GPT-6.1 Sol نیز رتبههای بعدی را به خود اختصاص دادند.
- در این نسخه بیش از شصت درصد آزمونها بر پایه مجموعهدادههای محرمانه ارزیابی میشوند و شکاف عملکردی مدلهای متنباز با صدر جدول به دوازده امتیاز رسیده است.
- انجام وظایف جدید هوش مصنوعی نیازمند پردازش بسیار سنگینتر عوامل هوشمند است و هزینه اجرای ارزیابیها میان مدلهای برتر تا بیش از سیزده برابر تفاوت دارد.
نسخه پنجم شاخص ارزیابی هوش مصنوعی با دو بنچمارک جدید و سه ارتقای اساسی معرفی شد؛ برای نخستین بار، بخش عمده این شاخص بر پایه مجموعهدادههای محرمانه توسعه یافته است.
شاخص ارزیابی هوش مصنوعی، معیاری ترکیبی برای سنجش توانمندی مدلهای زبانی در انجام وظایف واقعی دنیای امروز است. نسخه پنجم، بزرگترین ارتقای این شاخص از زمان انتشار نسخه چهارم در ماه ژانویه به شمار میرود. در نسخه جدید، ۶۰ درصد از ارزیابیها بر اساس مجموعهدادههای آزمایشی محرمانه و پاسخهای مخفی انجام میشوند تا از پدیده آلودگی دادهها و حفظ کردن پاسخها توسط مدلها جلوگیری شود.
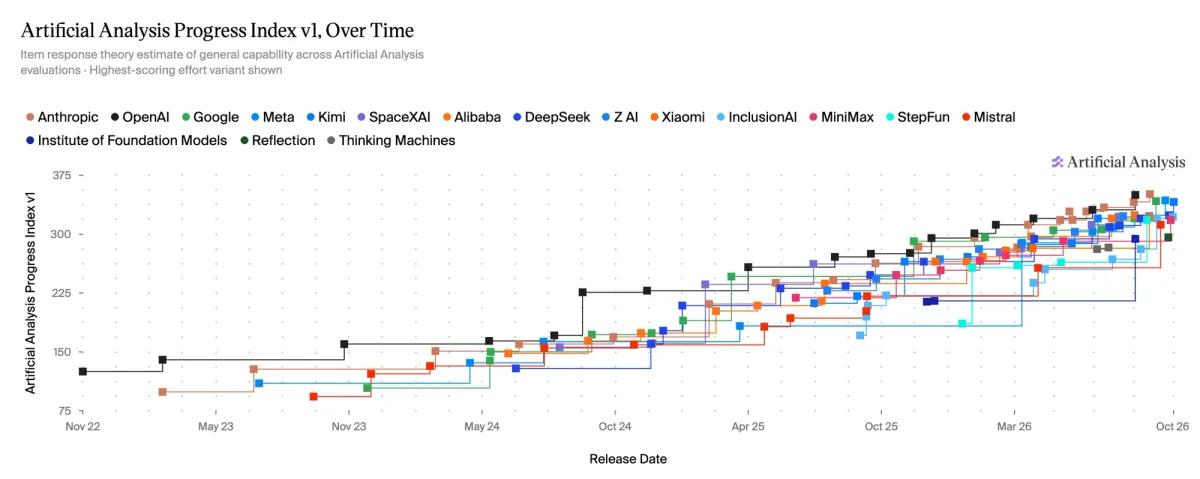
همزمان با نسخه پنجم این شاخص، نسخه اول «شاخص پیشرفت» (Progress Index) نیز معرفی شده است که روند تغییر توانمندی مدلها را در طول زمان و در قالب یک مقیاس پیوسته دنبال میکند.
آزمونهای جدید اضافهشده به شاخص:
FrontierCode 2.0: بنچمارک اختصاصی و تازه شرکت Cognition برای ارزیابی وظایف برنامهنویسی در دنیای واقعی که معیار نمرهدهی آن، پذیرش و ادغام تغییرات کد ایجنت توسط مدیران مخزن نرمافزاری است.
Terminal-Bench-Science: شامل ۷۰ وظیفه پژوهشی علمی به کمک عوامل هوشمند (ایجنتها) که در یک محیط ترمینال اجرا میشوند.
آزمونهای ارتقایافته:
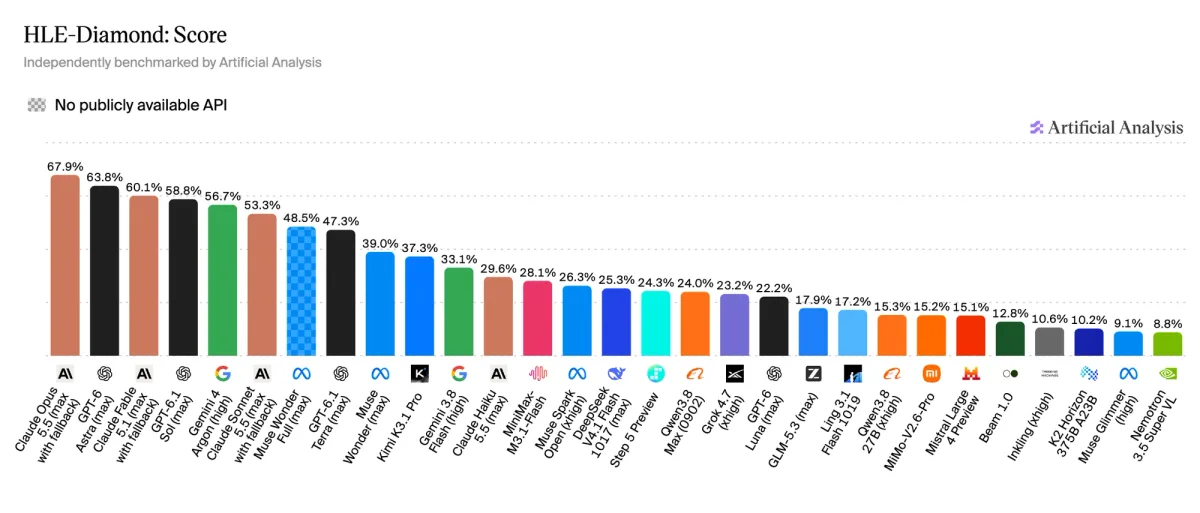
HLE-Diamond (جایگزین Humanity's Last Exam): نسخهای پالایششده شامل ۱۰۰۰ پرسش دشوار از آزمون معروف «Humanity's Last Exam» که بهطور مساوی میان سؤالات استدلالی و دانشی تقسیم شده است.
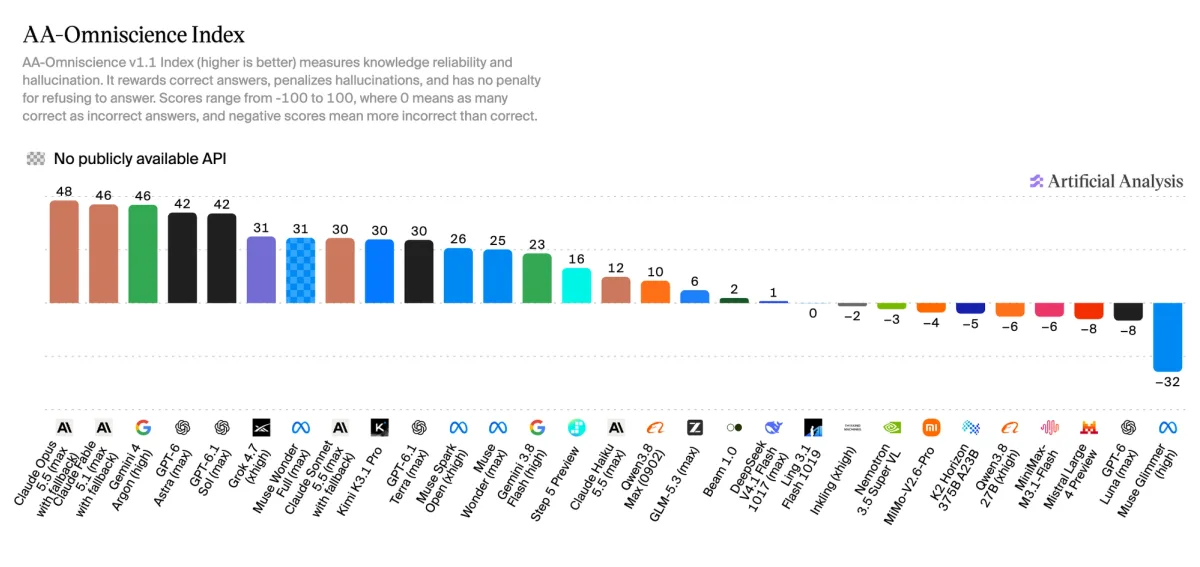
AA-Omniscience v1.1: نسخه بهروزشدهای از مجموعهداده سنجش دانش که سؤالات اشباعشده و عمومی از آن حذف شدهاند، سؤالات تازهای به آن افزوده شده و پرسشهای مبهم یا دارای اشکال بازبینی شدهاند.
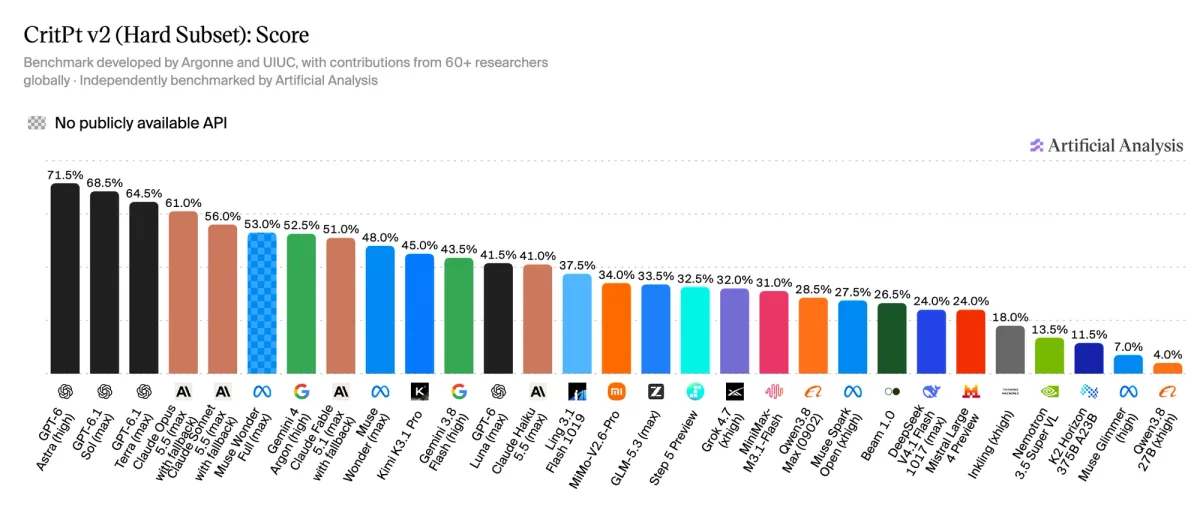
CritPt v2: زیرمجموعه دشوار و محرمانهای شامل ۴۰ پرسش از آزمون CritPt v2 که توسط طراحان این بنچمارک بازبینی شده و همراه با ابزار اجرای کد اجرا میشود.
آزمونهای ابقاشده در شاخص: بنچمارکهای AA-Briefcase ،AutomationBench-AA ،GDP.pdf و Terminal-Bench 4.0 همچنان در این شاخص حفظ شدهاند.
آزمونهای حذفشده از شاخص: بنچمارکهای GDPval-AA v2.1 ،SciCode و AA-LCR v1.1 از روند ارزیابی کنار گذاشته شدهاند.
وزندهی بخشهای مختلف در نسخه پنجم:
کارهای دانشی (۲۵ درصد): آزمون AA-Briefcase با ۱۵ درصد، AutomationBench-AA با ۵ درصد و GDP.pdf با ۵ درصد وزن.
کدنویسی (۲۵ درصد): آزمون FrontierCode 2.0 با ۱۵ درصد و Terminal-Bench 4.0 با ۱۰ درصد وزن.
علوم پایه (۲۵ درصد): آزمون Terminal-Bench-Science با ۱۵ درصد و زیرمجموعه دشوار CritPt v2 با ۱۰ درصد وزن.
مهارتهای عمومی (۲۵ درصد): آزمون AA-Omniscience v1.1 با ۱۵ درصد (شامل ۱۰ درصد دقت پاسخگویی و ۵ درصد مهار توهم) و HLE-Diamond با ۱۰ درصد وزن.
مهمترین نتایج بهدستآمده:
پیشتازی Claude Opus 5.5 با امتیاز ۵۸ بالاتر از GPT-6 Astra (با امتیاز ۵۷) و GPT-6.1 Sol (با امتیاز ۵۵): شرکتهای Anthropic و OpenAI پنج رتبه نخست جدول را در اختیار دارند و مدل Gemini 4 Argon گوگل با امتیاز ۵۰ در جایگاه بعدی قرار گرفته است.
افزایش شکاف مدلهای متنباز از ۳ امتیاز به ۱۲ امتیاز: مدل Kimi K3.1 Pro (که وزنهای آن هنوز بهصورت عمومی عرضه نشده) با امتیاز ۴۶ در صدر مدلهای متنباز قرار دارد. در میان مدلهایی که وزنهای آنها بهطور عمومی منتشر شده، مدلهای DeepSeek V4.1 Flash 1017 و GLM-5.3 با امتیاز ۳۲ پیشتازند؛ یعنی ۲۶ امتیاز کمتر از صدرنشین جدول و حتی پایینتر از مدل سبکتر Claude Haiku 5.5 با امتیاز ۳۶.
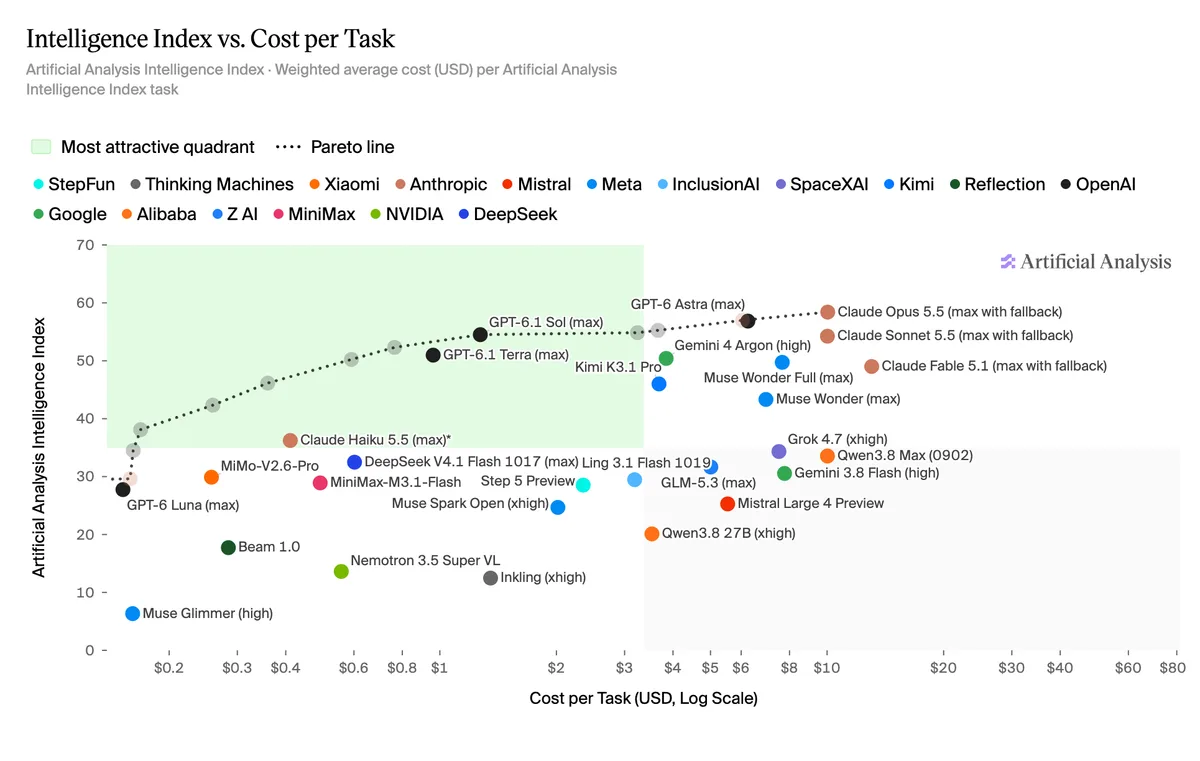
تفاوت بیش از ۱۳ برابری در هزینه اجرای وظایف میان مدلهای پیشرو: در میان ۱۰ مدل با بالاترین امتیاز، مدل GPT-6.1 Terra با ۰٫۹۶ دلار به ازای هر وظیفه ارزانترین مدل به شمار میرود و مدل Claude Fable 5.1 با هزینه ۱۳٫۰۴ دلار گرانترین گزینه است.
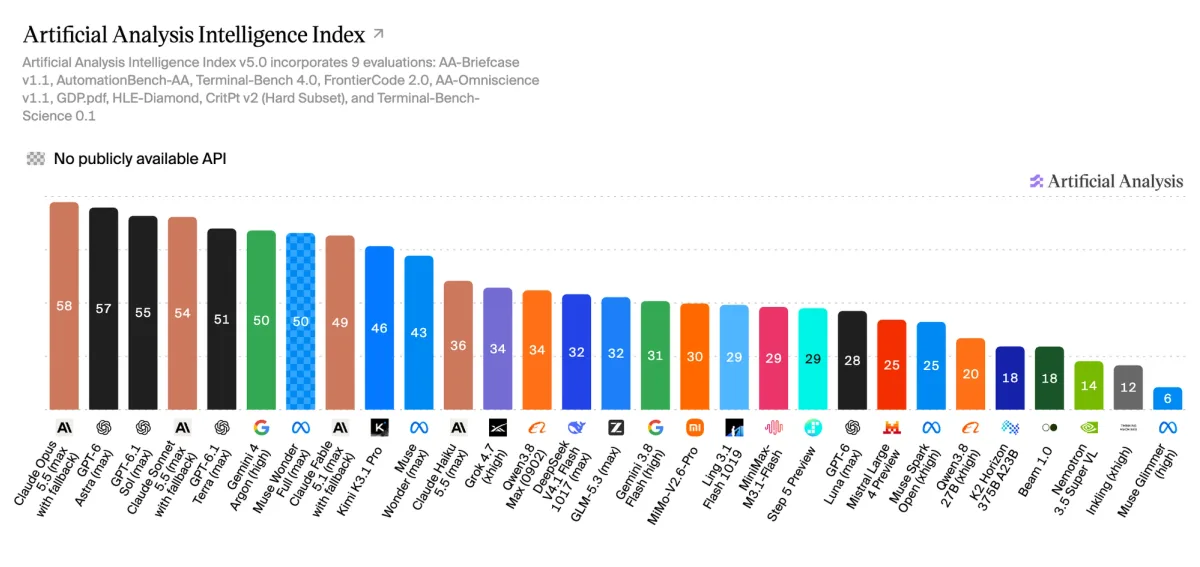
بنچمارک FrontierCode 2.0 تازهترین نسخه از آزمون کدنویسی محرمانه شرکت Cognition است. این آزمون شامل ۱۳۲ وظیفه در مخازن متن باز واقعی است و بر این اساس داوری میشود که آیا نگهدارنده و مدیر مخزن، تغییرات ایجادشده توسط ایجنت را تأیید و ادغام میکند یا خیر. هر تلاشی که در آزمونهای کنترلی با شکست مواجه شود امتیاز صفر میگیرد و سؤالات برای جلوگیری از آلودگی دادهها کاملاً محرمانه باقی میمانند. هر وظیفه سه بار در محیط ارزیابی ایجنتی اختصاصی اجرا شده است.
در این بنچمارک، مدل Claude Opus 5.5 با کسب ۴۶ درصد موفقیت در صدر ایستاده است و پس از آن، مدلهای GPT-6 Astra، GPT-6.1 Terra و Claude Sonnet 5.5 همگی با امتیاز ۴۲ درصد قرار دارند. مدل DeepSeek V4.1 Flash 1017 با ۲۸ درصد موفقیت، بهترین عملکرد را در بین مدلهای متنباز ثبت کرده که ۱۸ درصد پایینتر از پیشتاز رقابت است.
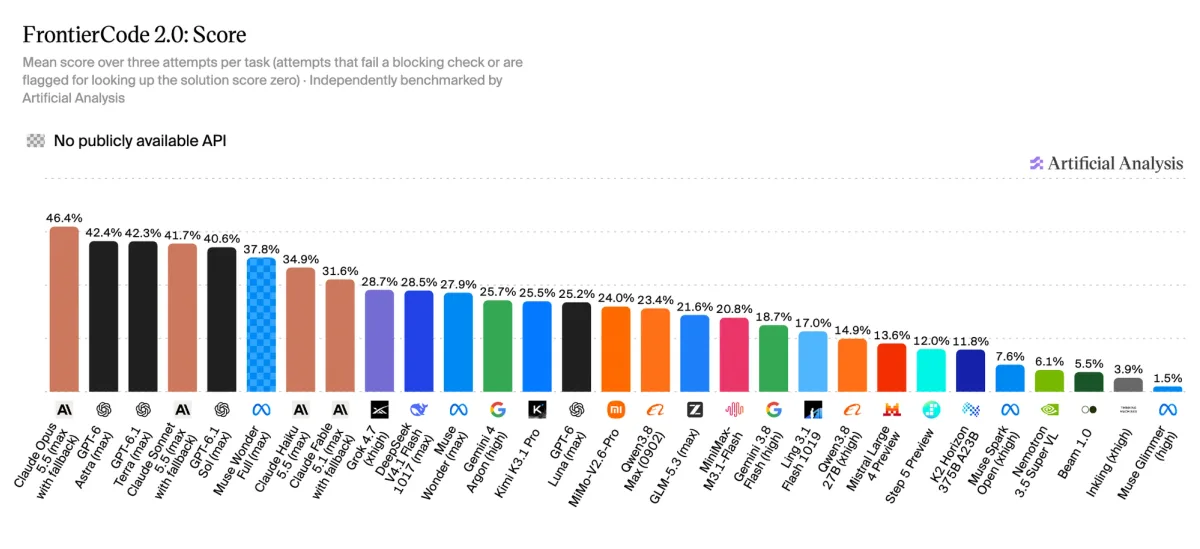
آزمون Terminal-Bench-Science توانایی ایجنتها را در اجرای فرایندهای پژوهشی علمی در محیط ترمینال میسنجد. کارشناسان علمی هر وظیفه را بهدقت طراحی و بازبینی کردهاند و یک وظیفه تنها زمانی موفق ارزیابی میشود که تمام آزمونهای تعریفشده را با موفقیت پشت سر بگذارد.
در این بخش، مدل GPT-6 Astra با ۶۳ درصد در رتبه اول قرار دارد و مدلهای Claude Opus 5.5 با ۵۹ درصد و GPT-6.1 Sol با ۵۸ درصد در جایگاههای بعدی هستند. امتیاز سایر مدلها افت چشمگیری را نشان میدهد؛ بهطوری که بهترین مدل متنباز یعنی Kimi K3.1 Pro (با وزنهای هنوز منتشرنشده) به امتیاز ۳۴ درصد رسیده و مدل Claude Haiku 5.5 امتیاز ۲۰ درصد را کسب کرده است. برترین مدل با وزنهای عمومی، یعنی DeepSeek V4.1 Flash 1017، تنها موفق به کسب ۱۳ درصد شده و بیشتر مدلهای متنباز ارزیابیشده امتیازی کمتر از ۱۰ درصد به دست آوردهاند.
آزمون HLE-Diamond در این شاخص جایگزین Humanity's Last Exam شده است. این آزمون نسخه پالایشیافتهای شامل ۱۰۰۰ سؤال دشوار از مرکز ایمنی هوش مصنوعی (CAIS) و شرکت Scale AI است که بهطور مساوی به دو بخش استدلال و دانش تقسیم شده است. مدل Claude Opus 5.5 با ۶۸ درصد رتبه نخست را در اختیار دارد و پس از آن، مدلهای GPT-6 Astra با ۶۴ درصد و Claude Fable 5.1 با ۶۰ درصد قرار گرفتهاند.
نتایج نشان میدهد که سؤالات حوزه دانش برای مدلهای پیشرو بهمراتب دشوارتر از سؤالات استدلالی هستند؛ به طوری که Claude Opus 5.5 و GPT-6 Astra در بخش استدلال امتیاز ۷۸ درصد را ثبت کردهاند، اما در بخش دانش به ترتیب به امتیازهای ۵۸ و ۵۰ درصد دست یافتهاند.
بنچمارک AA-Omniscience v1.1 نسخهای پاکسازیشده برای ارزیابی دانش و نرخ توهم مدلها است که پرسشهای اشباعشده و موارد عمومی از آن حذف، پرسشهای جدید اضافه و موارد مبهم یا نادرست اصلاح شدهاند. امتیازات حاصل تا حد زیادی با نسخه قبلی همخوانی دارد و مدلها بهطور میانگین حدود ۲ امتیاز افت نشان میدهند. همچنین زیرمجموعه عمومی جدیدی با نام AA-Omniscience-Public-v1.1 روی پلتفرم Hugging Face منتشر شده که بهطور دقیق کالیبره شده است تا دقت، نرخ توهم و عملکرد کلی آن با نسخه محرمانه همخوانی داشته باشد.
ارزیابی بنچمارک CritPt v2 بر اساس یک زیرمجموعه محرمانه و دشوار شامل ۴۰ پرسش انجام میشود؛ این مجموعه شامل ۷۰ پرسش تخصصی فیزیک در سطح پژوهشی بوده که ۳۰ پرسش حلشده توسط تمام مدلهای پیشرو در همه تلاشها، از آن حذف گردیده است. مدلها در این آزمون درون یک محیط ایزوله پایتون به حل مسائل میپردازند.
مدل GPT-6 Astra در حالت پردازش بالا با امتیاز ۷۲ درصد در جایگاه اول این آزمون قرار دارد و مدل GPT-6.1 Sol در بالاترین سطح پردازش با ۶۹ درصد رتبه دوم را داراست. مدل Claude Opus 5.5 که صدرنشین کل شاخص است در این بخش به امتیاز ۶۱ درصد رسیده است. مدل Kimi K3.1 Pro نیز با کسب ۴۵ درصد، بالاترین امتیاز را در بین مدلهای متنباز ثبت کرده است.
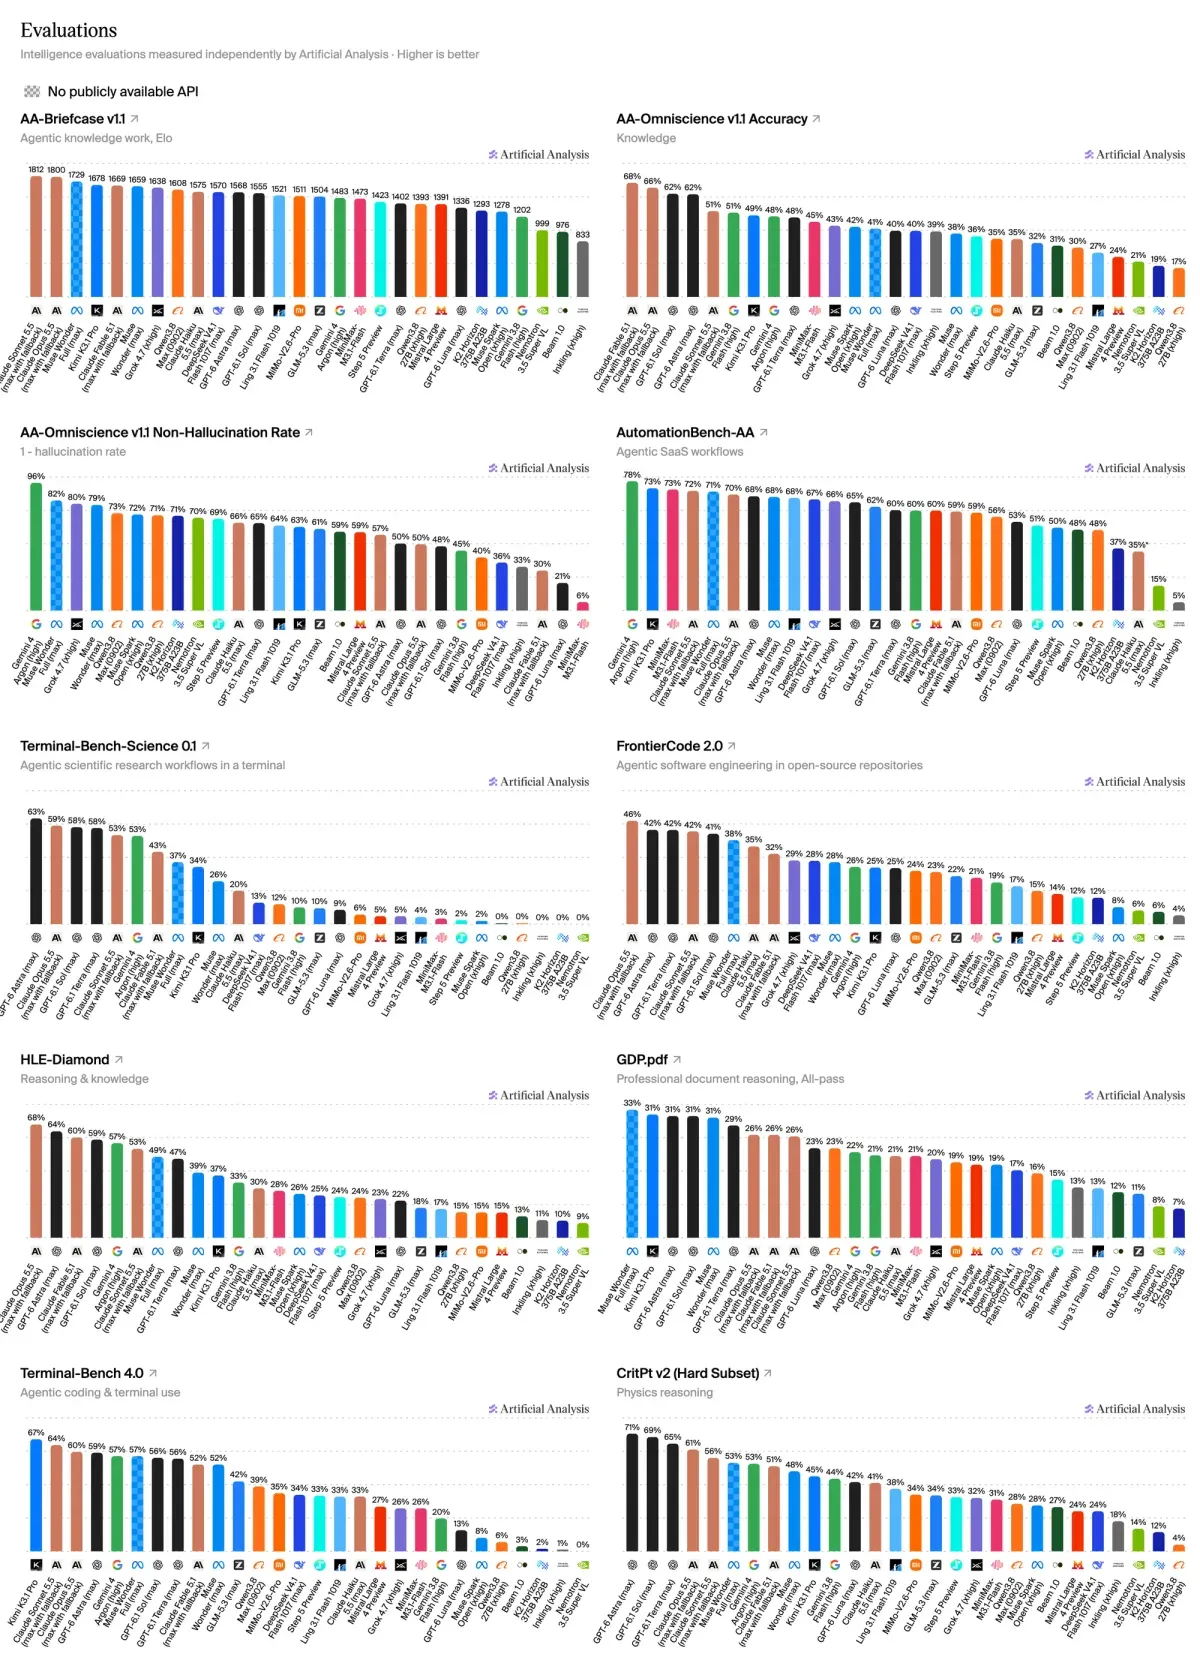
نسخه پنجم نشان میدهد که در هر ۹ آزمون ارزیابی، هنوز فضای زیادی برای پیشرفت وجود دارد و هیچ مدلی بهتنهایی در همه آزمونها صدرنشین نیست. در میان مدلهای بررسی شده، مدل Claude Opus 5.5 در ۳ آزمون صدرنشین است و ۵ مدل دیگر نیز هدایت ۶ آزمون باقیمانده را در دست دارند:
Claude Opus 5.5: صدرنشین در FrontierCode 2.0 (با ۴۶ درصد)، HLE-Diamond (با ۶۸ درصد) و AA-Omniscience v1.1 (با امتیاز ۴۸)
GPT-6 Astra: صدرنشین در Terminal-Bench-Science (با ۶۳ درصد) و زیرمجموعه دشوار CritPt v2 (با ۷۲ درصد)
Claude Sonnet 5.5: صدرنشین در AA-Briefcase (با امتیاز ۱۸۱۲ الو)
Kimi K3.1 Pro: صدرنشین در Terminal-Bench 4.0 (با ۶۷ درصد)
Gemini 4 Argon: صدرنشین در AutomationBench-AA (با ۷۸ درصد)
Muse Wonder Full: صدرنشین در GDP.pdf (با ۳۳ درصد قبولی کامل)
عقب ماندن بیشتر مدلهای متنباز در نسخه پنجم ارزیابیها کاملاً مشهود است. بهترین مدل متنباز یعنی Kimi K3.1 Pro (که وزنهای آن منتشر نشده) به امتیاز ۴۶ دست یافته که ۱۲ امتیاز عقبتر از صدرنشین است؛ در حالی که این اختلاف در نسخه ۴٫۳ تنها ۳ امتیاز بود. در میان مدلهایی با وزنهای عمومی، مدلهای DeepSeek V4.1 Flash 1017 و GLM-5.3 با کسب امتیاز ۳۲ بهترین نتیجه را داشتند و مدل کوچکتر Claude Haiku 5.5 حتی از همه آنها عملکرد بهتری به نمایش گذاشته است.
بیشترین شکاف عملکردی در آزمونهای HLE-Diamond و Terminal-Bench-Science مشاهده میشود؛ جایی که مدل Kimi K3.1 Pro به ترتیب امتیازهای ۳۷ و ۳۴ درصد را ثبت کرده، در حالی که Claude Opus 5.5 به ۶۸ درصد و GPT-6 Astra به ۶۳ درصد دست یافتهاند.
هزینه استفاده میان مدلهای پیشرو تفاوت فاحشی دارد. اجرای هر وظیفه در این شاخص با مدل Claude Opus 5.5 حدود ۱۰٫۰۴ دلار، با GPT-6 Astra معادل ۶٫۲۴ دلار و با GPT-6.1 Sol برابر با ۱٫۲۷ دلار هزینه دارد. جالب اینکه مدل GPT-6.1 Sol تنها با ۴ امتیاز اختلاف نسبت به Claude Opus 5.5، این وظایف را با حدود یکهشتم هزینه انجام میدهد.
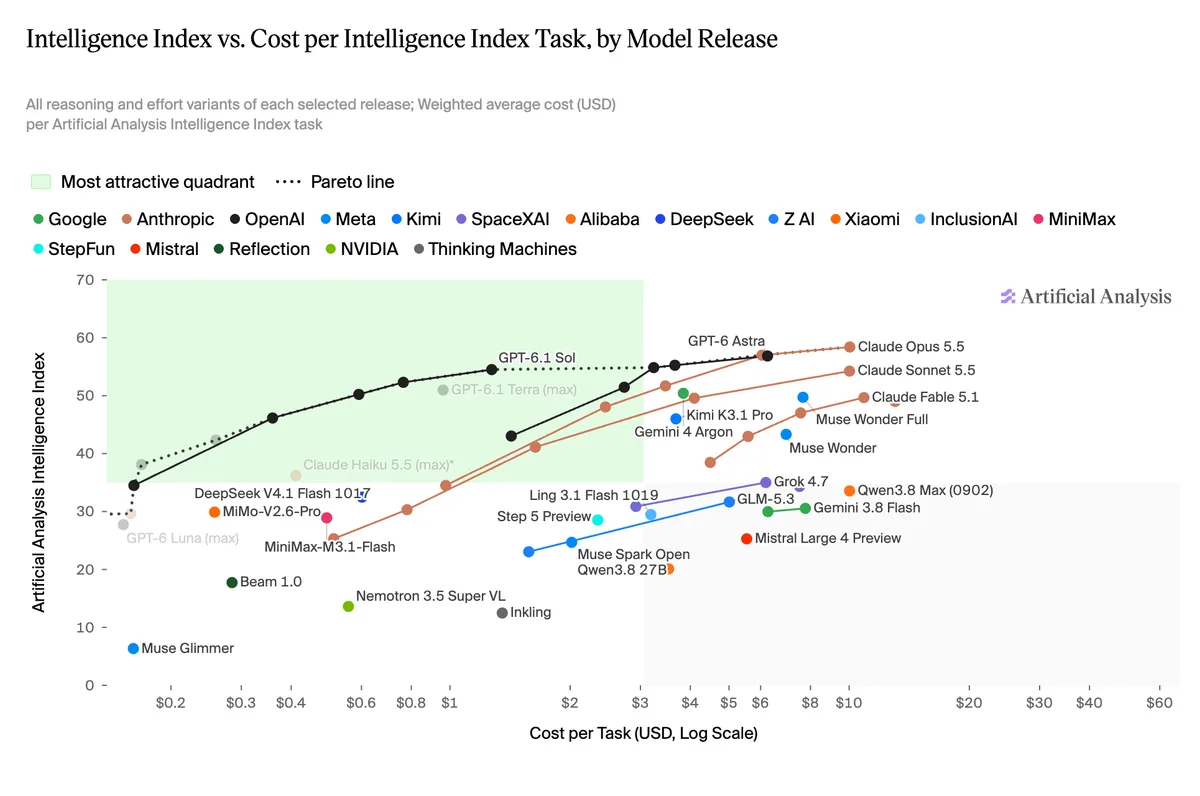
تنظیمات سطح تلاش و توان پردازشی مدلها در نسخه پنجم تأثیر بسیار پررنگتری پیدا کرده است. مدل Claude Opus 5.5 در حالت پردازش حداقلی امتیاز ۳۵ و در حالت حداکثری امتیاز ۵۸ را به دست میآورد که البته با افزایش ۱۰ برابری هزینه همراه است (۰٫۹۸ دلار در برابر ۱۰٫۰۴ دلار). دامنه تغییر امتیاز مدل Claude Sonnet 5.5 میان حالت حداقل و حداکثر به ۲۹ امتیاز رسیده (در مقایسه با ۲۰ امتیاز در نسخه قبلی) و این اختلاف در مدل GPT-6.1 Sol نیز از ۱۰ امتیاز به ۲۰ امتیاز دو برابر شده است.
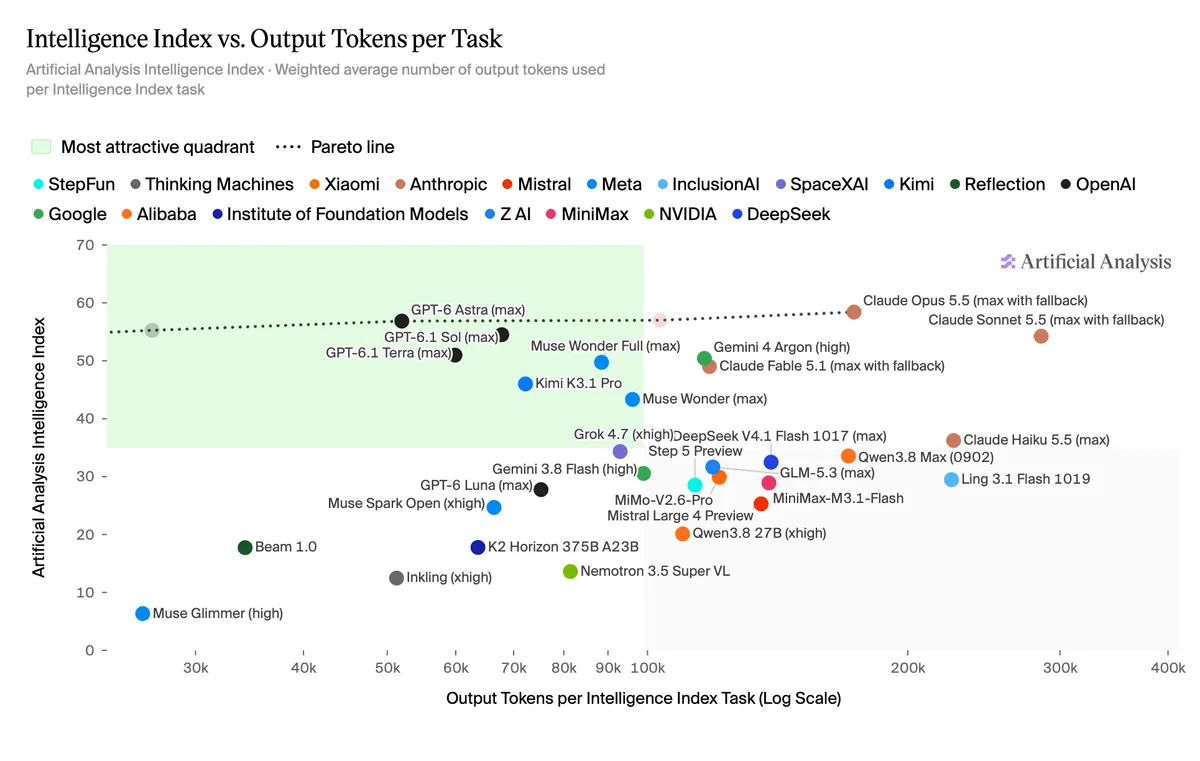
آزمونهای نسخه جدید نیازمند محاسبات و فعالیت بسیار سنگینتر مدلها هستند. تمام مدلهای ارزیابیشده در این نسخه نسبت به گذشته توکنهای خروجی بسیار بیشتری به ازای هر وظیفه تولید میکنند؛ بهطوری که میانه توکنهای تولیدی با افزایش دو سومی از ۳۵ هزار به ۵۹ هزار توکن رسیده است.
ارزیابیهای مبتنی بر ایجنت بیشترین سهم از مصرف توکن را دارند: آزمونهای Terminal-Bench-Science ،Terminal-Bench 4.0 ،AA-Briefcase و FrontierCode 2.0 با وجود اینکه ۵۵ درصد از وزن کل شاخص را تشکیل میدهند، در حدود ۹۰ درصد از کل توکنهای خروجی را به خود اختصاص دادهاند.
بنچمارک Terminal-Bench-Science سنگینترین آزمون از نظر مصرف توکن است: این آزمون بهتنهایی مسئول تولید حدود یکسوم از کل توکنهای هر وظیفه است.
همزمان با نسخه پنجم، نسخه اول «شاخص پیشرفت» نیز معرفی شده است. این شاخص مدلهای زبانی منتشرشده از نوامبر ۲۰۲۲ به این سو را در گستره وسیعی از بنچمارکها روی یک مقیاس توانمندی واحد قرار میدهد.
از این شاخص پیشرفت میتوان برای مقایسه نحوه دگرگونی توانمندیهای بنیادین در طول زمان، از جمله میان مدلهایی که با فاصله چند سال از یکدیگر عرضه شدهاند، استفاده کرد. برای مقایسه مدلها در کاربردهای کنونی و شناخت مرزهای کنونی هوش مصنوعی، شاخص اصلی هوش مصنوعی همچنان معیار بنیادین سنجش توانمندیها به شمار میرود.
طراحی شاخص پیشرفت با الهام از دستاوردهای مجموعه Epoch AI و شرکت Anthropic انجام شده است.
طراحی و توسعه بنچمارکهای بهکاررفته در این بهروزرسانی با مشارکت شرکت Cognition، تیم توسعه Terminal-Bench، مرکز ایمنی هوش مصنوعی (CAIS)، شرکت Scale AI و پژوهشگران پروژه CritPt انجام شده است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
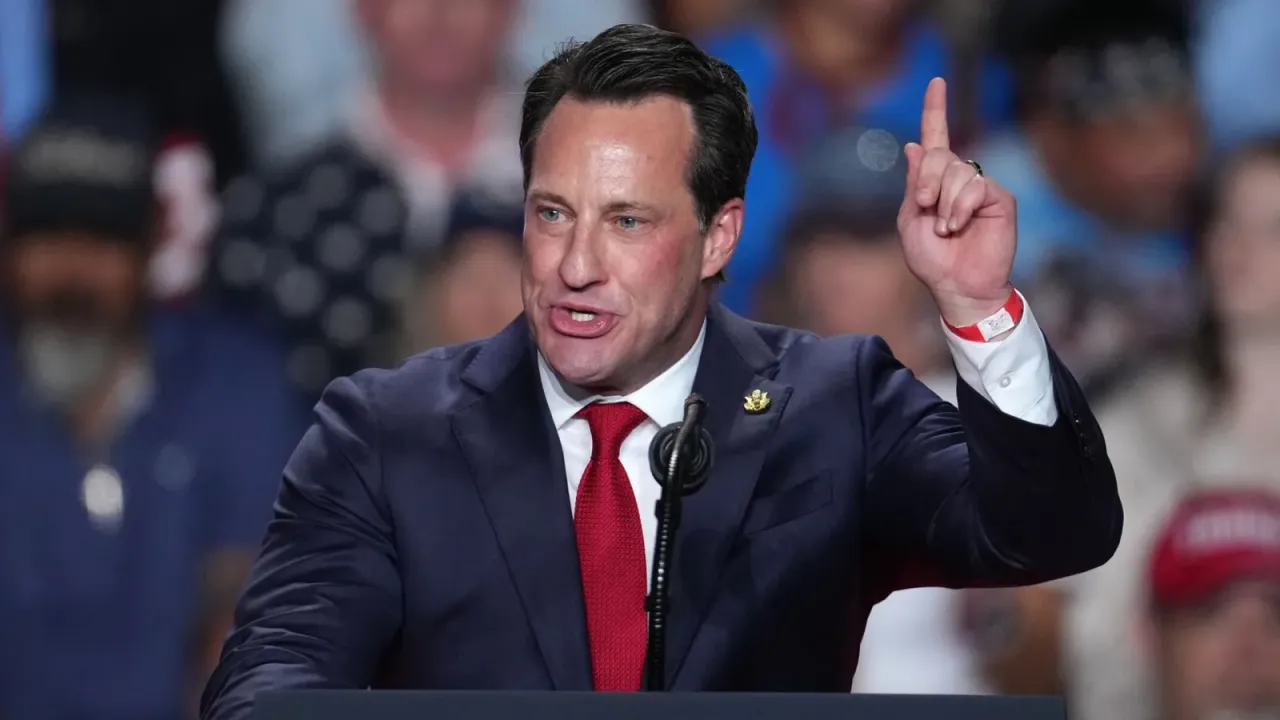
نامزدی وکیل سابق ایلان ماسک در کنگره؛ کارخانه تراشههای هوش مصنوعی در کانون جنجال انتخاباتی تگزاس
کریس گوبر، وکیل ارشد سابق ایلان ماسک، بهعنوان نامزد جمهوریخواهان برای راهیابی به مجلس نمایندگان آمریکا از حوزه دهم تگزاس رقابت میکند. این حوزه محل ساخت کارخانه بزرگ تراشههای هوش مصنوعی شرکتهای تسلا و SpaceX است و گسترش پروژههای فناوری اکنون به موضوعی داغ میان نامزدهای انتخاباتی بدل شده است.
خطر ورود هوش مصنوعی به دانشگاهها؛ وقتی اتوماسیون بار اداری استادان را سنگینتر میکند
استفاده از هوش مصنوعی در دانشگاهها ممکن است بهجای کاستن از بار اداری، بوروکراسی و وظایف حاشیهای استادان را افزایش دهد. اگر این فناوری برای خودکارسازی رویههای ناکارآمد اداری به کار رود، دانشگاهها از هدف بنیادین خود یعنی پژوهش عمیق، آموزش باکیفیت و پرورش اندیشه نقادانه دور خواهند شد.
شناسایی دقیق باگهای پنهان نرمافزاری با هوش مصنوعی؛ فریمورک SemLoc ابزارهای سنتی را پشت سر گذاشت
پژوهشگران با توسعه فریمورک SemLoc راهکاری نوآورانه برای رفع یکی از بزرگترین چالشهای خطایابی نرمافزار ارائه دادهاند. این سیستم با تبدیل استدلالهای مدلهای زبانی به قیدهای اجرایی، باگهای معنایی پیچیده را با دقتی به مراتب بالاتر از روشهای کلاسیک شناسایی میکند. این دستاورد گامی ارزشمند در جهت هوشمندسازی فرایند عیبیابی و افزایش پایداری کدهای برنامهنویسی است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.