اجرای مدلهای زبانی روی پلیاستیشن ۵؛ فریمورک llama.cpp به کنسول جیلبریکشده سونی آمد
توسعهدهندهای با پورت کردن فریمورک محبوب llama.cpp روی پلیاستیشن ۵ جیلبریکشده، امکان اجرای مدلهای هوش مصنوعی را روی پردازنده این کنسول فراهم کرد. در آزمایشهای اولیه، مدل سبک Qwen3.5 با موفقیت اجرا شده، اما محدودیت ۶ گیگابایتی حافظه در دسترس، چالش اصلی در اجرای مدلهای بزرگتر است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پروژه جدید PS5LM فریمورک محبوب llama.cpp را برای پلیاستیشن ۵ کامپایل کرده و اجرای مدلهای زبانی را روی کنسول بازی سونی ممکن ساخته است.
- در تست اولیه، مدل Qwen3.5-0.8B با سرعت ۱۴٫۲ توکن در ثانیه روی دو ترد پردازنده اجرا شد، اما ادعاهای اجرای سریع مدل ۲۷ میلیاردی روی گرافیک هنوز اثبات نشده است.
- با وجود حافظه ۱۶ گیگابایتی کنسول، برنامههای غیررسمی تنها به ۶ گیگابایت فضای خالی دسترسی دارند که مانع اصلی اجرای مدلهای سنگینتر است.
پروژه PS5LM فریمورک llama.cpp را به پلیاستیشن ۵ جیلبریکشده میآورد
پروژه هومبرو PS5LM که توسط توسعهدهندهای به نام «مرت چوبانوف» آغاز شده، بیلد بومی فریمورک llama.cpp را برای کنسول پلیاستیشن ۵ تولید کرده و نخستین آزمایش اجرای مدل روی پردازنده مرکزی (CPU) را با موفقیت پشت سر گذاشته است. هدف نهایی این پروژه، میزبانی و اجرای مدلهای مبتنی بر فرمت GGUF روی کنسول سونی است و مدلهای سری Qwen نقطه آغاز آن هستند؛ با این حال، اجرای مدلها روی پردازنده گرافیکی (GPU) همچنان در نقشه راه توسعه قرار دارد.
این پروژه بر پورت کردن محیط اجرای همهمنظوره llama.cpp تمرکز دارد؛ بستری بر پایه زبانهای C و ++C که ابزارهای استنتاج را برای طیف وسیعی از مدلهای وزنباز فراهم میکند. فرمت GGUF نیز ساختار ویژه این فریمورک برای بستهبندی وزنها و متادیتای مدلها به شمار میرود. پورت موفق این فریمورک میتواند پشتیبانی از مدلهایی مانند Qwen، Llama، Mistral و Gemma را در کنار فرمتهای متنوع کوانتیزاسیون از دل یک بیسکد مشترک ممکن سازد، هرچند تطبیق هر معماری و عملیات بکاند همچنان نیازمند آزمایشهای عملی روی پلیاستیشن ۵ خواهد بود.
نخستین فایل اجرایی روی پردازنده مرکزی به کار افتاد
- وضعیت بیلد: ابزارهای
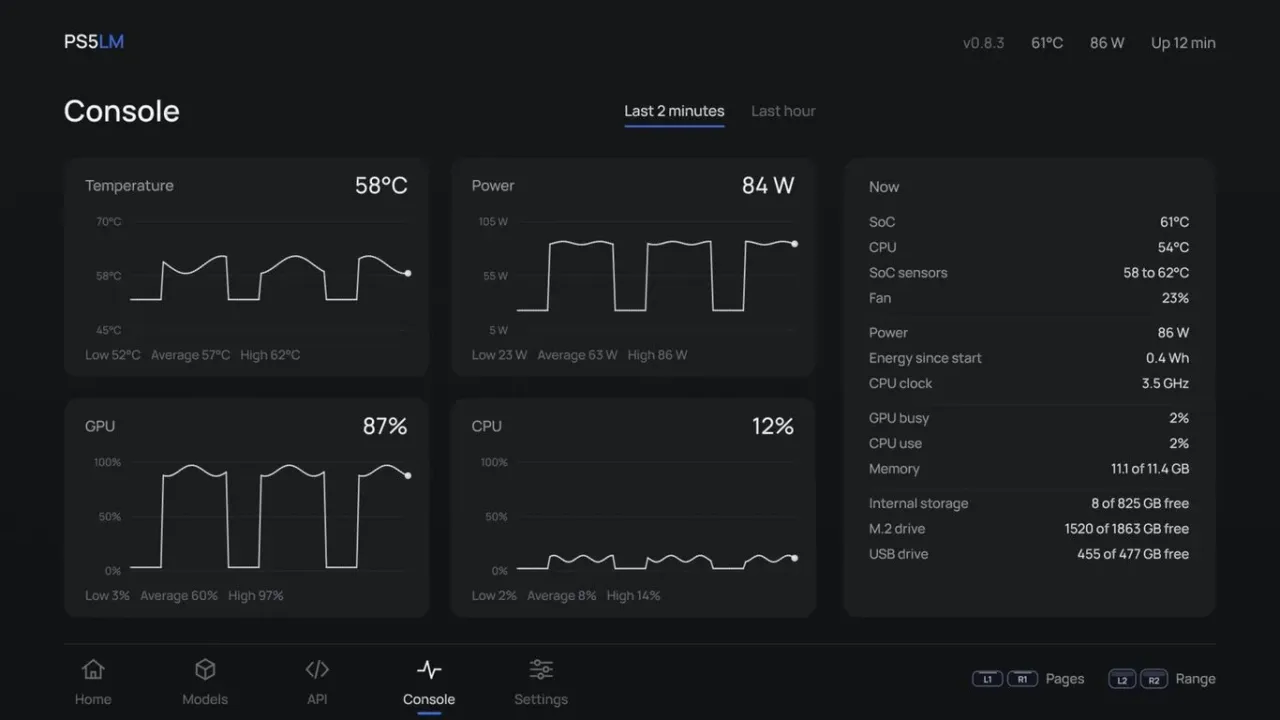
llama-cli،llama-serverوllama-benchبدون نیاز به تغییر در سورسکد اصلی پروژه llama.cpp، برای پلیاستیشن ۵ کراسکامپایل و لینک شدهاند. - آزمایش پردازنده مرکزی: طبق گزارشها، مدل Qwen3.5-0.8B با بهرهگیری از دو ترد پردازنده موفق به تولید متن با سرعت ۱۴٫۲ توکن در ثانیه شده است.
- وضعیت پردازنده گرافیکی: در ریپازیتوری این پروژه هنوز هیچ بنچمارک موفقی از اجرای مدل روی پردازنده گرافیکی کنسول به ثبت نرسیده است.
- وضعیت مدل ۲۷ میلیاردی: مدل Qwen3.5-27B تا این لحظه روی کنسول اجرا نشده است.
نتایج بهدستآمده از مدل ۰٫۸ میلیارد پارامتری، صحت فایل اجرایی، ماژول بارگذاری مدل و مسیر پایه اجرای پردازشی روی CPU را تأیید میکند. با این حال، این دادهها ادعاهای غیررسمی شبکههای اجتماعی مبنی بر سرعت حدود ۲۰ توکن در ثانیه برای مدل ۲۷ میلیاردی روی پردازنده گرافیکی را تأیید نمیکند.
سقف ۶ گیگابایتی؛ محدودیت اصلی برای اجرای مدلهای بزرگتر
کنسول پلیاستیشن ۵ به ۱۶ گیگابایت حافظه GDDR6 مجهز است که بهطور مشترک میان پردازنده مرکزی، پردازنده گرافیکی و سیستمعامل تقسیم میشود. بر اساس گزارش این پروژه، پردازههای پیلود (کدهای غیررسمی جیلبریک) در حال حاضر تنها به حدود ۶ گیگابایت فضای خالی و آزاد دسترسی دارند. فارغ از ظرفیت کل حافظه فیزیکی دستگاه، همین محدودیت تخصیص، گلوگاه و مانع اصلی برای اجرای مدلهای بزرگتر روی این کنسول به شمار میرود.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
گزارش جدید آنتروپیک از تحول محیط کار؛ کاهش چشمگیر استخدام نیروهای تازهکار و افزایش زمان جلسات
گزارش جدید آنتروپیک نشان میدهد ادغام عمیق هوش مصنوعی الگوهای کاری این شرکت را بهکلی دگرگون کرده است. سهم نیروهای تازهکار در تیمهای فنی با افتی محسوس روبهرو شده، درحالیکه کارمندان اکنون زمان بیشتری را در جلسات هماهنگی سپری میکنند.
بنچمارک ۱۳۲۹ ساعته Synth-DoPaCo معرفی شد؛ شبیهسازی مکالمات واقعی پزشک و بیمار برای هوش مصنوعی
پژوهشگران با توسعه مجموعهداده متنباز Synth-DoPaCo شامل بیش از ۱۳۰۰ ساعت مکالمه صوتی شبیهسازیشده میان پزشک و بیمار، چالش بزرگ کمبود دادههای طولانی در هوش مصنوعی پزشکی را برطرف کردند. این بنچمارک با بازسازی ۸۸۰۰ ویزیت بالینی کامل، بستری استاندارد برای ارزیابی دقیق مدلهای زبانی صوتی بدون نقض حریم خصوصی بیماران فراهم میکند.
روش ابداعی KiToke با حذف ۹۹ درصد توکنها، دقت هوش مصنوعی ویدئویی را حفظ میکند
پژوهشگران روش فشردهسازی تازهای به نام KiToke توسعه دادهاند که بدون نیاز به آموزش مجدد، طول توالی توکنهای ویدئویی را کاهش میدهد. این روش حتی با حذف ۹۹ درصد از توکنهای بصری، نزدیک به ۹۰ درصد از کارایی مدل را حفظ میکند و بار محاسباتی پردازش ویدئو را به حداقل میرساند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.