روش نوآورانه پژوهشگران کایست دقت بازیابی مقالات علمی را با هوش مصنوعی ۷٫۸ درصد ارتقا داد
پژوهشگران مؤسسه کایست با توسعه چارچوبی نوین به نام Chain of Retrieval، روشهای سنتی فشردهسازی مقالات در یک بردار واحد را کنار زدند. این معماری با تفکیک هوشمندانه متن به چند پرسوجوی مجزا، دقت بازیابی اسناد علمی را نزدیک به ۸ درصد ارتقا میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- سیستمهای سنتی جستوجوی اسناد علمی کل مقاله را در یک بردار خلاصه میکردند و جزئیات تجربی یا روششناسی را نادیده میگرفتند.
- چارچوب Chain of Retrieval با شکستن مقاله به پرسوجوهای تفکیکشده، دقت و نرخ بازیابی مقالات را ۷٫۸ درصد افزایش میدهد.
- دقت بالاتر این روش با هزینه زمانی همراه است و در مقایسه با مدلهای سنتی، تأخیر بیشتری در پردازش اسناد دارد.
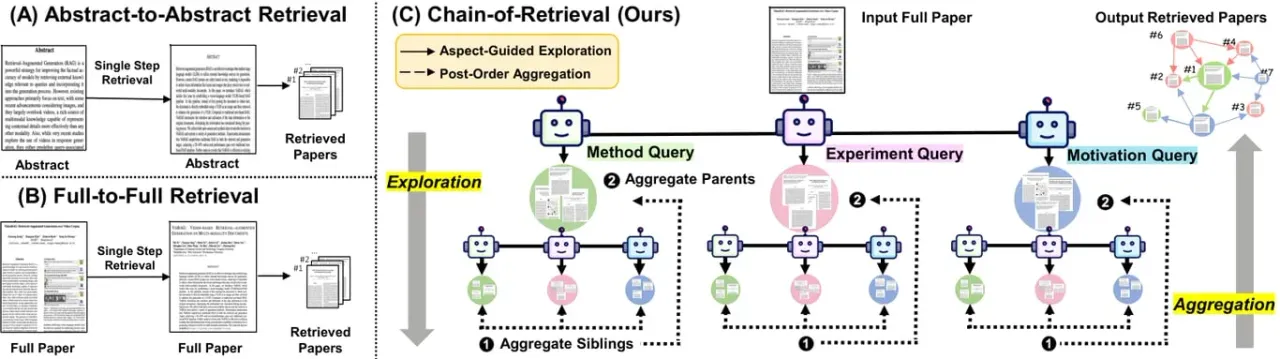
پیدا کردن مقالات مرتبط با یک مقاله پژوهشی کامل، چالشی کاملاً متفاوت از جستوجوی ساده بر اساس کلمات کلیدی است. در این فرآیند، متن ورودی ممکن است شامل هزاران توکن در بخشهای انگیزه تحقیق، روششناسی، آزمایشها و نتایج باشد؛ در حالی که ارتباط موضوعی دو مقاله شاید تنها به یک جنبه یا جزئیات فنی ویژه وابسته باشد. پژوهشگران مؤسسه کایست (KAIST) برای حل این معضل، چارچوب جدیدی به نام Chain of Retrieval (بهاختصار CoR یا زنجیره بازیابی) را معرفی کردهاند؛ رویکردی که با ایجاد پرسوجوهای چندوجهی، گسترش بازگشتی جستوجو و ترکیب رتبهبندیها از پایین به بالا، کل محتوای اسناد علمی را پیمایش میکند. این روش در بنچمارک جدید SciFullBench توانست نرخ بازیابی بالاتری را نسبت به روشهای مبتنی بر چکیده یا کل سند ثبت کند؛ هرچند این دستاورد با افزایش چشمگیر زمان پاسخدهی همراه است.
پنهان ماندن شباهتها در دل یک بردار واحد
بسیاری از سیستمهای بازیابی اسناد علمی، هر مقاله را تنها بر اساس عنوان و چکیده آن بازنمایی میکنند و سپس یک مدل امبدینگ را روی جفتمقالههای مرتبط با ارجاع، بهینهسازی اختصاصی (فاینتیون) مینمایند. این نوع بازنمایی تنها شباهتهای کلی موضوعی را در بر میگیرد؛ اما چکیدهها معمولاً فاقد جزئیات پیادهسازی، مجموعهدادهها، روشهای پایه مورد مقایسه و گزینههای ارزیابی هستند؛ یعنی همان اطلاعاتی که برای یافتن مقالات مشابه از نظر روششناسی یا تجربی ضروری است.
رمزگذارهای با پنجره زمینه طولانی میتوانند بخش بیشتری از متن مقاله را تحلیل کنند، هرچند محدودیتهای کانتکست همچنان ممکن است بخشهایی از مقالات بلند را نادیده بگیرد. علاوه بر این، فشردهسازی خروجی در قالب یک بردار واحد باعث میشود انگیزه، روشها و آزمایشها در یکدیگر ادغام شوند. در نتیجه، تفکیک سیگنالهای وابسته به یک مجموعهداده یا تکنیک خاص از موضوع کلی مقاله بسیار دشوار خواهد بود.
چهار زاویه دید برای آغاز جستوجو
فاز کاوش در چارچوب CoR سه پرسوجوی متمرکز را از متن مقاله استخراج میکند و همزمان چکیده را بهعنوان چهارمین زاویه دیدِ کلیتر نگه میدارد:
- انگیزه پژوهش (Research motivation): شامل بیان مسئله، چرایی انجام تحقیق و اهداف اصلی پژوهش.
مطالب مرتبط و پیشنهادی
مدل زبانی مرکوری ۳ با سرعت ۱٬۰۶۸ توکن بر ثانیه از رقبای سرعتی جیپیتی و کلود پیشی گرفت
استارتاپ اینسپشن از مدل زبانی مرکوری ۳ رونمایی کرد که با بهرهگیری از رمزگشایی موازی دیفیوژن، بهسرعت کمنظیر ۱٬۰۶۸ توکن بر ثانیه دست مییابد. سازندگان این مدل ادعا میکنند که مرکوری ۳ علاوهبر کاهش چشمگیر تأخیر پاسخگویی در سیستمهای مبتنیبر ایجنت، کیفیتی همتراز یا حتی بالاتر از سریعترین مدلهای جیپیتی و کلود ارائه میدهد.
بزرگترین تحول محصولات لاجیتک در سالهای اخیر؛ آمادهسازی اتاق جلسات برای عصر ایجنتهای هوش مصنوعی
لاجیتک با رونمایی از نسل جدید تجهیزات ویدیو کنفرانس مجهز به تراشههای پردازش هوش مصنوعی، بزرگترین بهروزرسانی محصولات سازمانیاش را کلید زد. این شرکت قصد دارد با سادهسازی سختافزارها و بهکارگیری حسگرهای محیطی، سالنهای کنفرانس را به لایه فیزیکی دادهها برای ایجنتهای هوش مصنوعی تبدیل کند.
کدام مدل هوش مصنوعی در مشاورههای پزشکی بهتر عمل میکند؟ ارزیابی غولهای زبانی در بنچمارک HealthBench
بنچمارکهای تخصصی HealthBench شیوه پاسخگویی و کیفیت مشاورههای بالینی مدلهای هوش مصنوعی را در هزاران مکالمه پزشکی مورد سنجش قرار دادند. نتایج نشان میدهد در حالی که مدلهای اوپنایآی از نظر تعادل کارایی و هزینه دست بالا را دارند، کلود سانست ۵٫۵ با پاسخهای جامع خود رتبه اول مکالمات عمومی سلامت را تصاحب کرده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.