مدل جدید d1 از لیکویید ایآی؛ تصمیمگیری هوشمند بدون تولید حتی یک توکن!
استارتاپ لیکویید ایآی از مدل تخصصی d1 رونمایی کرد که بدون تولید هیچ توکن متنی، تصمیمگیریهای ساختاریافته را با سرعت بالا انجام میدهد. این مدل با حذف مرحله رمزگشایی متنی و خطاهای ساختاری JSON، گزینهای ایدهآل برای ایجنتها، روتینگ و اعتبارسنجی در نرمافزارهای مدرن است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- استارتاپ لیکویید ایآی (Liquid AI) از مدل جدیدی به اسم d1 رونمایی کرده که به جای تولید متنهای طولانی، مستقیماً خروجیهای ساختاریافته و تصمیمهای قطعی تحویل میده.
- این مدل بدون تولید حتی یک توکن خروجی کار میکنه؛ یعنی تاخیر کمتر، خطای صفر در خروجی جیسون (JSON) و هزینههای به مراتب پایینتر برای توسعهدهندهها.
- مدل d1 موفق شده رتبه اول بنچمارک تصمیمگیری Jev رو به دست بیاره و برای کارهایی مثل هدایت ایجنتها، دستهبندی تیکتها و ارزیابی ریسک فوقالعاده کاربردیه.
مدل d1 لیکویید ایآی: تصمیمگیری ساختاریافته بدون نیاز به تولید توکن
استارتاپ لیکویید ایآی (Liquid AI) مستندات اولین مدل تصمیمگیری خودش به نام d1 رو منتشر کرد؛ مدلی تخصصی که به عنوان جایگزینی بهینه برای مدلهای زبانی در کارهایی مثل دستهبندی، مسیریابی درخواستها، گیتهای تایید و امتیازدهی در نرمافزارهای عملیاتی طراحی شده. به گزارش لیکویید، d1 موفق شده صدرنشین شاخص تصمیمگیری Jev بشه؛ بنچمارکی که مدلهای تصمیمگیری رو در ۳۷ آزمون مختلف و با ۱۳۲٬۴۲۲ درخواست ثابت و استاندارد ارزیابی میکنه.
هدف اصلی این مدل، جایگزینی درخواستهایی از مدلهای زبانی بزرگه که صرفاً برای گرفتن یک برچسب، مقدار بولی (بله/خیر)، انتخاب یک گزینه یا یک امتیاز عددی، خروجی JSON تولید میکنن. به جای اینکه مدل متن رو کلمه به کلمه تولید کنه و بعد سیستم مجبور باشه اون رو توی یک اسکیما پارس کنه، d1 مستقیماً پاسخهای ساختاریافته رو همراه با میزان احتمال بازمیگردونه و گزارش تعداد توکنهای خروجی تولیدشده رو صفر ثبت میکنه! این طراحی هوشمندانه باعث کاهش چشمگیر تاخیر (Latency)، به صفر رسیدن خطاهای پارس کردن خروجی و حذف هزینههای مربوط به توکنهای خروجی میشه.
سه قالب پاسخ در قالب یک درخواست
هر فراخوانی API یک وضعیت (state) به صورت متن ساده یا JSON، و یک یا چند پرسش (questions) دریافت میکنه. هر پرسش از یکی از این سه نوع پاسخ پشتیبانی میکنه:
نوع پاسخ | خروجی | کاربرد معمول |
|---|---|---|
Noul | یک احتمال از ۰ تا ۱ برای سوالات بله یا خیر | گیتهای تایید، فلگها و متغیرهای بولی شرطی |
Choice | توزیع احتمال روی گزینههای مشخص، همراه با میزان اطمینان | دستهبندی، مسیریابی و انتخاب اکشنها |
Score | موقعیت وزندهیشده بر اساس احتمال روی یک سنجه و مقیاس مرتبشده | امتیازدهی به ارتباط، شدت موضوع، کیفیت و ریسک |
خروجی نوع Score میتونه بین سطوح مقیاس تعریفشده قرار بگیره. برای مثال، یک مقیاس ۴ سطحی ممکنه به جای گرد کردن به عدد صحیح، مقدار 2.9995 رو برگردونه. برنامهها میتونن این مقدار دقیق رو نگه دارن، به یک دستهبندی مپ کنن یا با یک آستانه مشخص مقایسهاش کنن.
جالب اینجاست که در یک درخواست واحد میشه هر سه نوع پاسخ رو برای یک وضعیت مشترک ترکیب کرد. مثلاً یک سیستم پشتیبانی مشتریان میتونه به جای ارسال سه درخواست جداگانه به مدل، در یک رفتوبرگشت برچسب قصد کاربر، نمره فوریت و احتمال گزارش باگ بودن پیام رو همزمان دریافت کنه.
نحوه فراخوانی در پایتون
اندپوینت این API آدرس https://api.liquid.ai/decisions/v1/systemone هست. مثال زیر با استفاده از SDK تایپسیف، از d1 میپرسه که آیا پیام مشتری یک شکایت محسوب میشه یا نه:
import os

from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient(
    api_key=os.environ["LIQUID_API_KEY"],
    base_url="https://api.liquid.ai",
)

result = client.system_one(
    model="d1:free",
    state="I've been waiting three weeks and nobody replies.",
    questions={
        "is_complaint": Noul(
            instructions="Is this a complaint?"
        )
    },
)

print(result.answers["is_complaint"].noul)  # 0.999
در پاسخ دریافتی، میزان توکنهای ورودی محاسبه میشه اما مقدار usage.output_tokens دقیقاً عدد 0 گزارش میشه. یعنی سرویس دادههای کاملاً ساختاریافته تحویل میده، اما این کار رو نه با روش تولید توکن خودبازگشتی (Autoregressive)، بلکه به شیوهای کاملاً متفاوت انجام میده.
تخصصیسازی و حذف سربار رمزگشایی متنی
مدلهای زبانی مرسوم حتی وقتی برنامه شما فقط یک مقدار بولی یا یک برچسب ساده میخواد، متن رو توکن به توکن تولید میکنن. مدل d1 این مرحله رمزگشایی متنی رو کاملاً دور میزنه؛ موضوعی که باعث پایداری و پیشبینیپذیر شدن تاخیر سرویس میشه و کابوسهایی مثل JSON ناقص، فیلدهای فراموششده یا مقادیر نامعتبر enum رو برای همیشه حذف میکنه.
این API همچنین به جای اینکه از یک چتبات بخواد میزان اطمینانش رو توصیف کنه، احتمالات دقیق عددی ارائه میده. لیکویید این احتمالات رو «کالیبرهشده» توصیف میکنه، هرچند به تیمهای فنی توصیه میشه پیش از اعمال این مقادیر روی تصمیمات حساس، حتماً کالیبراسیون رو روی دادههای ترافیک واقعی خودشون بسنجن.
لیکویید چهار ارتقای کلیدی در d1 نسبت به مدلهای قبلی این خانواده گزارش کرده است:
- کسب امتیازات بالاتر در ارزیابیهای چندزبانه
- مقاومت به مراتب بیشتر در برابر حملات تزریق پرامپت (Prompt Injection) در بخش وضعیت
- عملکرد بهتر در مدیریت ورودیهای طولانیتر
- تصمیمگیری سریعتر با خروجیهای ساختاریافته در جریانهای کاری نرمافزاری
البته مقاومت در برابر پرامپت اینجکشن به این معنی نیست که ورودیهای غیرقابلاعتماد ذاتاً ایمن هستن. نرمافزارها همچنان باید اعتبارسنجی ورودیها رو انجام بدن، دسترسی عملیات بعدی رو محدود کنن، احراز هویت رو بیرون از مدل مدیریت کرده و سناریوهای حمله مرتبط با محیط خودشون رو تست کنن.
صدرنشینی در بنچمارک و ضرورت آزمایش داخلی
شاخص تصمیمگیری Jev شامل ۳۷ بنچمارک گوناگونه که ۱۹ مورد از اونها مستقیماً روی امتیاز نهایی تاثیر دارن. این آزمونهای نمرهدار در پنج بخش دستهبندی شدن: ابزارها و اتوماسیون، بازیابی و دستهبندی، درک زبان، دانش و استدلال، و هنر و قضاوت انسانی. امتیاز نهایی میانگین این پنج بخش ضرب در ۱۰۰ بوده و عددی بین ۰ تا ۱۰۰ تولید میکنه.
طبق لیدربورد منتشرشده، پیش از این مدل Jev 1.13 با امتیاز کلی نزدیک به ۷۴.۴ صدرنشین بود که حالا d1 جایگاه اول رو از آن خودش کرده. اگرچه مجموعه دادههای ثابت مقایسه مدلها رو یکپارچه میکنه، اما هیچ بنچمارکی نمیتونه دقت عملیاتی، کالیبراسیون، تاخیر و هزینههای واقعی رو برای برچسبها و ترافیک اختصاصی هر محصول پیشبینی کنه.
چه کارهایی بهترین گزینه برای این API هستند؟
مدل d1 دقیقاً برای جریانهای کاری طراحی شده که خروجی نهایی ساختاری ثابت و مشخص داره:
- مسیریابی تیکتها، پیامها و ایمیلها
- مدیریت محتوا و برچسبهای ایمنی و اخلاقی
- گیتهای تایید برای صدا زدن ابزار توسط ایجنتها
- ارزیابیهای مشخص بر اساس سنجههای دقیق
- مسیریابی بین مدلها و زنجیرههای استنتاج
- امتیازدهی به تقلب، ریسک، فوریت و اولویت
- رتبهبندی مجدد (Reranking) در سیستمهای RAG با احتمالات ارتباط
در مقابل، کارهای تولیدی (مولد) کاملاً خارج از حوزه وظایف این مدل قرار دارن. لیکویید توصیه میکنه برای نوشتن آزادانه متن، خلاصهسازی، تولید کد، گفتگوهای چندمرحلهای، پاسخ به پرسشهای باز و استدلالهای پیچیده چندمرحلهای همچنان از مدلهای زبانی معمولی استفاده بشه. هر فرآیندی که باید جمله جدیدی تولید کنه، همچنان به یک مدل هوش مصنوعی مولد یا قالبهای متنی مجزا نیاز داره.
تعیین آستانههای عملیاتی نیازمند دادههای واقعی است
تیمهایی که قصد بررسی d1 رو دارن باید کل پایپلاین تصمیمگیری رو تست کنن و فقط به نمرات بنچمارک بسنده نکنن:
- تعریف دقیق برچسبها: دستورالعملها و سنجههایی بنویسید که کلاسهای نزدیک به هم رو با معیارهای عینی و شفاف از هم جدا کنه.
- سنجش روی دادههای نمونه واقعی: حتماً نمونههای نادر، ورودیهای چندزبانه، وضعیتهای طولانی و نمونههای مخرب رو در ارزیابی لحاظ کنید.
- بررسی کالیبراسیون: احتمالات پیشبینیشده رو با نتایج واقعی در بخشهای کلیدی مقایسه کنید.
- تنظیم آستانهها بر اساس هزینه خطا: نقاط مرزی تصمیمگیری رو با توجه به هزینهها و عواقب مثبت کاذب، منفی کاذب و تصمیمگیری نکردن مشخص کنید.
- در نظر گرفتن مسیر پشتیبان (Fallback): موارد نامطمئن یا پرریسک رو به سمت قوانین سنتی، مدلی بزرگتر یا نیروی انسانی هدایت کنید.
- پایش انحراف مدل (Drift): بعد از پیادهسازی، فراوانی کلاسها، توزیع احتمالات، نرخ خطا، تاخیر و مصرف توکنهای ورودی رو مداوم رصد کنید.
نمایش شیوه پاسخگویی در یک بازی رانندگی
نمونه دموی Road Decider از لیکویید، از d1 به عنوان کنترلر یک بازی رانندگی پیکسلی استفاده کرده. در هر فریم بازی، این مدل یکی از سه حالت LEFT (چپ)، CENTER (وسط) یا RIGHT (راست) رو همراه با نمره اطمینان انتخاب میکنه.
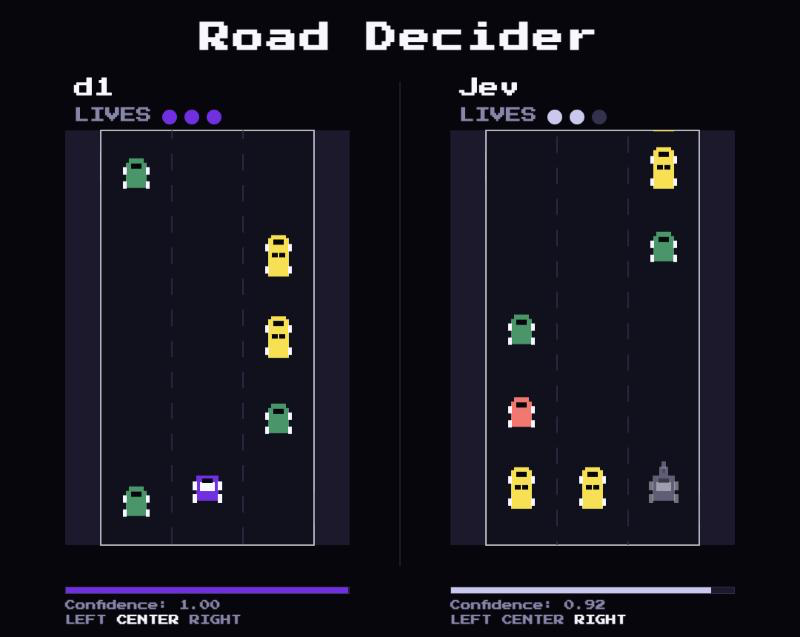
این مثال به خوبی الگوی کنترلی مدنظر این API رو به تصویر میکشه: ارسال وضعیت فعلی، درخواست مجموعهای مشخص از اکشنها و دریافت توزیع احتمالات. الگوهای مشابهی در انتخاب اکشن توسط ایجنتها، گیتهای رباتیک، خطوط مدیریت محتوا و مسیریابی بین مدلها دیده میشه؛ هرچند سیستمهای بلادرنگ علاوه بر مدل به محدودیتهای ایمنی قطعی بیرونی هم نیاز دارن.
دسترسی، قیمتگذاری و عرضه
مدل d1 هماکنون از طریق کنسول API لیکویید با شناسه d1:free در دسترسه. توسعهدهندگان به یک کلید API اختصاصی نیاز دارن و تیمهایی که قصد استفاده در محیط پروداکشن رو دارن، باید پیش از پیادهسازی مواردی مثل محدودیت نرخ درخواست (Rate Limits)، شرایط مدیریت دادهها، دسترسی منطقهای و تعرفههای پرداختی رو در کنسول بررسی کنن.
لیکویید اعلام کرده که پشتیبانی از OpenRouter هم در برنامههاشون هست اما هنوز تاریخ دقیقی براش اعلام نکرده. از اونجایی که d1 هیچ توکن خروجی تولید نمیکنه، هزینه مصرفی اساساً بر اساس وضعیت ورودی و تعریف پرسشها محاسبه میشه؛ البته هزینه نهایی و تاخیر همچنان به حجم درخواستها، محدودیتهای سرویس و ترافیک کاری وابسته است.
در مجموع، d1 رابطی اختصاصی و متمرکز برای تصمیمگیریهایی ارائه میده که خیلی از برنامهها در حال حاضر با تولید پردردسر JSON از چتباتها به دست میارن. جایگاه اول این مدل در بنچمارکها نشاندهنده پتانسیل بالای اونه، اما آزمایش در دنیای واقعی مشخص میکنه که آیا دقت، کالیبراسیون، تاخیر و هزینههای d1 روی دادههای واقعی سیستم شما هم به همین اندازه شگفتانگیز هست یا نه.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
حواشی نامگذاری ایجنت جدید اوپنایآی؛ دردسرهای بیپایان «Dots» و موجسواری ایلان ماسک!
اوپنایآی از سیستم ایجنت جدید خود به نام «Dots» رونمایی کرده، اما این نامگذاری حسابی در فضای مجازی جنجال به پا کرده است. از تشابه اسمی با چند شرکت چینی و هجوم کاربران به پیج اینستاگرام یک برند لباس زنانه گرفته تا ترول زیرکانه شرکت هوش مصنوعی ایلان ماسک با دامنه Dot.com، همهچیز دست به دست هم داده تا این رونمایی حسابی سوژه شبکههای اجتماعی شود.
کتوشلوار سازمانی بر تن OpenClaw؛ ائتلاف اوپنایآی و رد هت برای نجات ایجنتها از تحریم اداری!
پروژه پرطرفدار OpenClaw با همراهی رد هت، انویدیا و اوپنایآی، در حال ساخت نسخهای سازمانی موسوم به OCE است تا نگرانیهای امنیتی شدید شرکتها را رفع کند. این پروژه که لقب «کوبرنتیز برای ایجنتها» را به همراه دارد، به دنبال استانداردسازی و کنترل همهجانبه روی دستیاران هوشمند سازمانی است.
از بیل مکانیکی تا پلتفرم هوشمند؛ بابکت چطور با هوش مصنوعی ماشینهای سنگین را متحول میکند؟
روی گرکو، مدیر ارشد دیجیتال شرکت بابکت، از استراتژی این برند پرآوازه ماشینآلات سنگین برای پیوند زدن لودرها و بیلهای مکانیکی با هوش مصنوعی و نرمافزار پرده برداشته است؛ تحولی که ابزارهای سخت کارگاهی را به پلتفرمهای متصل و دستیارهای هوشمند ارتقا میدهد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.