مدلهای فوقسریع سری d1 از لیکوئید AI؛ تصمیمگیری آنی بدون تولید حتی یک توکن!
استارتاپ Liquid AI با معرفی مدلهای متنباز سری d1، مسیر متفاوتی را برای تصمیمگیری در هوش مصنوعی پیش گرفته است. این مدلهای کمحجم بدون نیاز به تولید توکن و با تاخیر میلیثانیهای، اموری مثل دستهبندی و فیلترهای امنیتی ایجنتها را با دقت بالا انجام میدهند. این رویکرد تازه میتواند پردازشهای پشتصحنه سیستمهای هوش مصنوعی را بسیار سریعتر و اقتصادیتر کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- استارتاپ Liquid AI دو مدل متنباز به نامهای d1-3B و d1-omni-600M منتشر کرده که مخصوص دستهبندی و تصمیمگیری هستند و خروجی ساختاریافته را یکضرب و بدون تولید کلمهبهکلمه توکنها تحویل میدهند.
- سرعت این مدلها شگفتانگیز است؛ برای مثال روی کارت گرافیک RTX 4090 انویدیا فقط ۸ میلیثانیه زمان میبرد تا به یک پرسش پاسخ دهند و عملکرد پردازشی فوقالعادهای روی سختافزارهای مختلف دارند.
- این فناوری خوراک اموری مثل هدایت ترافیک درخواستها (Routing)، نظارت بر محتوا و گاردریلهای امنیتی ایجنتهاست، هرچند برای کارهایی مثل چت یا تولید آزاد متن باید سراغ مدلهای زبانی متداول رفت.
انتشار دو مدل تصمیمگیری متنباز و فوقسریع توسط لیکوئید AI
استارتاپ Liquid AI دو عضو جدید از خانواده مدلهای d1 را بهصورت متنباز (Open-weight) منتشر کرد: مدل d1-3B که ورودیهای متن و تصویر را پردازش میکند، و مدل آزمایشی d1-omni-600M که توانایی پردازش متن در کنار تصویر یا صدا را دارد. این مدلهای تصمیمگیری تنها با یک بار عبور دادهها (یک Forward Pass)، امتیاز نتایج از پیش تعیینشده را محاسبه میکنند و بدون تولید حتی یک توکن، احتمالات کالیبرهشده و دقیقی تحویل میدهند. این معماری دقیقاً برای کارهایی مثل دستهبندی دادهها، هدایت درخواستها (Routing)، امتیازدهی و بررسی گاردریلهای امنیتی ساخته شده؛ یعنی بخشهایی که به خروجیهای ساختاریافته با تاخیر در مقیاس میلیثانیه نیاز دارند.
یک پردازش سریع برای سه نوع پرسش
در مدلهای زبانی معمولی، دستهبندی اطلاعات به این صورت است که مدل باید کلمهبهکلمه پاسخ را به شکل توکن تولید کند و بعد از آن تازه نوبت به تجزیه خروجی JSON، اعتبارسنجی ساختار داده و در صورت بروز خطا تلاش مجدد میرسد. در نقطه مقابل، مدلهای سری d1 احتمالات مربوط به هر نتیجه را مستقیماً محاسبه کرده و مقادیر ساختاریافته را بلافاصله برمیگردانند.
هر درخواست به این سیستم شامل یک حالت ورودی (Input State) و یک یا چند پرسش است که از سه ساختار پایه تشکیل شدهاند:
- نول (Noul): یک پرسش بله یا خیر که خروجی آن احتمالی بین ۰ و ۱ است. این نوع سوال برای درگاههای تصمیمگیری، مثل فیلتر کردن اسپم یا تایید اجرای ابزارها توسط هوش مصنوعی، بسیار ایدهآل است.
- انتخاب (Choice): انتخابی میان گزینههای مشخص که توزیع احتمال بین آنها را مشخص میکند؛ مثلاً تعیین اینکه تیکت پشتیبانی به بخش حسابداری، پشتیبانی فنی یا مدیریت حساب ارسال شود.
- امتیاز (Score): ارزیابی روی یک مقیاس رتبهبندی منظم که موقعیت وزندهیشده بر اساس احتمال را خروجی میدهد؛ مثلاً تخمین میزان شدت مشکل، فوریت کار یا کیفیت پاسخ.
جالب اینجاست که چند پرسش مختلف میتوانند همزمان از یک ورودی و یک درخواست استنتاج استفاده کنند. برای مثال، سیستم پشتیبانی میتواند بهطور همزمان نیت کاربر را دستهبندی کند، تیم مناسب را برگزیند و فوریت موضوع را بسنجد؛ بدون اینکه نیازی به فراخوانی چندباره مدلهای سنگین باشد.
بررسی سرعت و تاخیر در پنج شتابدهنده سختافزاری
تیم Liquid آمار جالبی از تاخیر مدل d1-3B در پاسخ به یک سوال منتشر کرده است. عدد گزارششده برای شتابدهنده AMD MI325X توان عملیاتی در حالت بستهبندی دادهها (Packed States) را هم نشان میدهد که روش اختصاصی این شرکت برای پردازش دستهای است:
سختافزار | میزان تاخیر | نتایج تکمیلی |
|---|---|---|
NVIDIA GeForce RTX 4090 | ۸ میلیثانیه | |
AMD MI325X | ۹ میلیثانیه | ۱,۱۰۶ حالت پردازششده در هر ثانیه |
NVIDIA Jetson AGX Thor | ۱۶ میلیثانیه | سه پرسش همزمان در ۲۰ میلیثانیه |
NVIDIA Jetson AGX Orin | ۲۶ میلیثانیه | |
NVIDIA Jetson Orin Nano | ۵۰ میلیثانیه |
نتیجه تراشه AGX Thor بهخوبی ارزش اشتراکگذاری محاسبات بین چند پرسش را نشان میدهد: با سهبرابر شدن تعداد سوالات، تاخیر فقط از ۱۶ میلیثانیه به ۲۰ میلیثانیه رسید. این مقیاسپذیری فوقالعاده اجازه میدهد روی هر فریم ویدیو یا هر وضعیت در برنامه، چندین بررسی امنیتی و تصمیمگیری بهصورت زنده و بدون افت سرعت پیادهسازی شود.
عملکرد درخشان در بنچمارکهای متنی
در بخش عمومی بنچمارک Decision Index نسخه ۰.۲.۱ که معیاری جامع برای سنجش مدلهای تصمیمگیری است، مدل d1-3B امتیاز ۴۸.۵۷ را ثبت کرده است. به گزارش لیکوئید، این مدل در بین مدلهای زیر ۱۰ میلیارد پارامتر پیشتاز بوده و عملکردی نزدیک به مدل Decider 35B-A3B ارائه میدهد؛ مدلی که طبق اعلام این شرکت، ۱۲ برابر بزرگتر از d1-3B است!
در هفت بنچمارک متنی عمومی دیگر شامل درک مطلب، تشخیص محتوای سمی، دستهبندی قصد و نیت کاربران، پاسخ به سوالات پزشکی و درک چندزبانه، مدل d1-3B میانگین امتیاز ۸۲.۹ را به دست آورده، در حالی که مدل Decider 4B روی همین مجموعه امتیاز ۸۱.۱ را ثبت کرده است.
شرکت Liquid مدل d1-omni-600M را یک نسخه آزمایشی میداند. این مدل در بنچمارک Decision Index نمره ۱۵.۹۵ گرفته، اما در تشخیص محتوای سمی Civil Comments امتیاز ۹۵.۸ و در بنچمارک بازنویسی متن PAWS-X امتیاز ۷۹.۵ را ثبت کرده است. حجم ۶۰۰ میلیون پارامتری آن، این مدل را به گزینهای عالی برای نظارت و مسیردهی در سیستمهایی با منابع حافظه بسیار محدود تبدیل میکند.
البته در بخشهای چندرسانهای جدید هنوز جای خالی دادههای ارزیابی حس میشود؛ این شرکت آماری از بنچمارک اختصاصی پردازش تصویر منتشر نکرده و بنچمارکهای معتبری هم برای تصمیمگیری صوتی وجود ندارند. بنابراین ادعای کیفیت در زمینه تصویر و صدا بیشتر به دموهای نمایشی متکی است تا بنچمارکهای استاندارد صنعتی.
دو پایه معماری و فرمول آموزش مدلها
مدلهای d1-3B و d1-omni-600M بر اساس تعداد پارامترها و نوع ورودیهایشان از دو معماری متفاوت استفاده میکنند:
مدل | پایه اصلی | معماری | ورودیهای پشتیبانیشده |
|---|---|---|---|
d1-3B | LFM2.5-VL-3B | مدل بینایی-زبانی فقط دیکودر (Decoder-only) | متن و تصویر |
d1-omni-600M | LFM2.5-Encoder-350M | انکودر دوطرفه با بخشهای بینایی و صوتی | متن به همراه تصویر یا صدا |
جزئیات آموزشی منتشرشده از تکنیکهای ادغام مدلها (Model Merging)، فاینتیونینگ چندمرحلهای و آداپتورهای اختصاصی چندحالته خبر میدهد:
- برای ساخت مدل d1-3B، تیم توسعهدهنده وزنهای مدل LFM2.5-2.6B را با بدنه متنی LFM2.5-VL-3B ترکیب کرد، چندین نسخه را با سیدها (Seeds) و ترکیبات دادهای متنوع فاینتیون نمود و سپس مدلهای حاصل را با یکدیگر ادغام کرد.
- استفاده از متنهای ورودی طولانی، جابهجا کردن ترتیب گزینههای پاسخ و حذف میانبرهای گمراهکننده از دادهها، نتایج بسیار بهتری نسبت به روشهای پیچیدهتر به همراه داشت.
- در مدل d1-omni-600M، تیم سازنده یک انکودر صوتی FastConformer را از طریق یک آداپتور متصل کرد و سپس انکودر بینایی مدل LFM2.5-VL-450M را به آن افزود.
- ادغام بخش بینایی با استفاده از روش LoRA انجام شد؛ متدی بهینهشده که ماتریسهای وزنی کمکی کوچکی را آموزش میدهد و این وزنها تنها هنگام ورود تصویر به مدل فعال میشوند.
نمونه اجرای یک درخواست در پایتون
شرکت Liquid دسترسی به این مدلها را از طریق اندپوینت system_one فراهم کرده است. در هر فراخوانی، یک حالت متنی، پرسشهای مشخص و تصاویری دلخواه ارسال میشود. نمونه کد زیر با فرض راهاندازی کلاینت و وارد کردن کلاس Choice نوشته شده است:
result = client.system_one(
    model="d1",
    state="Charged twice for my subscription last month...",
    questions={
        "intent": Choice(
            instructions="Which team should handle this?",
            criteria={
                "billing": "Charges, refunds, payments",
                "technical": "Bugs or how-to questions",
                "account": "Login, profile, subscription",
            },
        ),
    },
)

print(result.answers["intent"].choice)      # "billing"
print(result.answers["intent"].confidence)  # 0.9996
پاسخ دریافتی شامل توزیع احتمالات، گزینه منتخب و میزان اطمینان مدل است. برنامهنویسان میتوانند با تعیین حد آستانه (Threshold)، مواردی که با اطمینان بالا تایید شدهاند را فوراً هدایت کنند و موارد مبهم را به مدلهای سنگینتر یا بازبینی انسانی بفرستند.
چه کارهایی خوراک این مدلهاست؟
این مدلهای ساختاریافته دقیقاً جایگزین بخشهایی از سیستمهای هوش مصنوعی میشوند که تا پیش از این با پرامپتنویسی سنگین برای مدلهای بزرگ یا ساخت دستهبندیکنندههای اختصاصی اداره میشدند:
- گاردریلها و فیلترهای امنیتی ایجنتها برای تایید فراخوانی ابزارها، در جاهایی که هر اقدام به بررسی سریع قوانین نیاز دارد.
- نظارت بر محتوا و شناسایی اطلاعات هویتی و حساس (PII) پیش از رسیدن دادهها به مدلهای بزرگتر.
- رتبهبندی مجدد نتایج (Reranking) و سیستمهای مسیردهی چندمرحلهای مدلها با محدودیت شدید در زمان تاخیر.
- بازرسی بصری فریمهای دوربین بر اساس معیارهای مشخص با استفاده از پرسشهای نوع Noul.
- دستهبندی تیکتهای پشتیبانی، ارجاع خودکار به تیم مربوطه و تعیین میزان فوریت، همه در قالب یک درخواست واحد.
- خطوط لوله ارزیابی سیستمهای هوش مصنوعی که بهجای متنهای طولانی به امتیازات عددی دقیق نیاز دارند.
البته باید توجه داشت که سری d1 تنها گزینههای تعیینشده توسط شما را ارزیابی میکند و توانایی تولید متن آزاد را ندارد؛ بنابراین کارهایی مثل چت طولانی، خلاصهسازی متن، تولید کد و پاسخگویی آزاد به سوالات همچنان در حوزه تخصص مدلهای زبانی مولد است. تیمهای فنی نیز باید کالیبراسیون احتمالات را روی دادههای اختصاصی خود بسنجند تا با تغییر رفتار کاربران، دقت مدل افت نکند.
از هاگینگ فیس تا تراشههای لبه شبکه
استارتاپ Liquid هر دو مدل را با مجوز اوزان باز در پلتفرم Hugging Face در دسترس قرار داده است. همچنین پشتیبانی از ابزار محبوب llama.cpp برای تراشههای اپل، AMD، کوالکام و انویدیا (شامل فرمت فوقفشرده NVFP4 انویدیا) فراهم شده است.
سرویس ابری این شرکت نیز دو نسخه ارائه میدهد: نسخه اشتراکی d1 با پشتیبانی از تصویر و نسخه رایگان و متنی d1:free. هر درخواست میتواند شامل حداکثر ۸ تصویر و ۱۰ هزار پچ تصویری با ابعاد ۳۲ در ۳۲ پیکسل باشد که به ازای هر پچ معادل ۱.۵ توکن محاسبه میشود.
آزمایشگاه Jetson AI Lab نیز شناسنامه این مدلها را برای پیادهسازی روی دستگاههای لبه شبکه منتشر کرده است. علاوه بر این، یک فضای دموی زنده با ۱۰ مثال کاربردی مبتنی بر دوربین در دسترس قرار گرفته که شامل بازیهای کنترلشده با حرکات دست و فیلتر محتوا تنها با یک بار پردازش در هر فریم است.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
دردسرهای فنی OpenAI Dots و ظهور شبیهسازهای متنباز؛ وقتی ایجنت همیشهروشن به این سادگیها نیست!
سرویس جدید OpenAI Dots با وعده ایجنتهای ابری همیشهروشن عرضه شد، اما بروز اختلالات فنی متعدد و قطعیهای پیدرپی حسابی صدای کاربران را درآورده است. همزمان، توسعهدهندگان مستقل با عرضه پروژههای متنبازی چون OpenDots و Open Dot در تلاشاند جایگزینهایی ارزانتر، آزادتر و بدون محدودیت در اختیار همگان بگذارند.
دانشمندان آزمایشگاه آرگون میکروسکوپ پرتو ایکس سخنگویی ساختند که با زبان طبیعی فرمان میگیرد و زوم میکند!
پژوهشگران آزمایشگاه ملی آرگون با اتصال ایجنتهای هوش مصنوعی به خط باریکه نانوپروب پرتو ایکس، میکروسکوپی توسعه دادهاند که دانشمندان میتوانند به زبان ساده و گفتاری با آن مکالمه کنند و از دستگاه بخواهند روی نقاط دلخواه نمونه زوم کند. این نوآوری با بازسازی بلادرنگ دادههای سنگین تایکوگرافی، افقهای تازهای در تحقیقات مواد پیشرفته و ساخت نیمههادیها میگشاید.
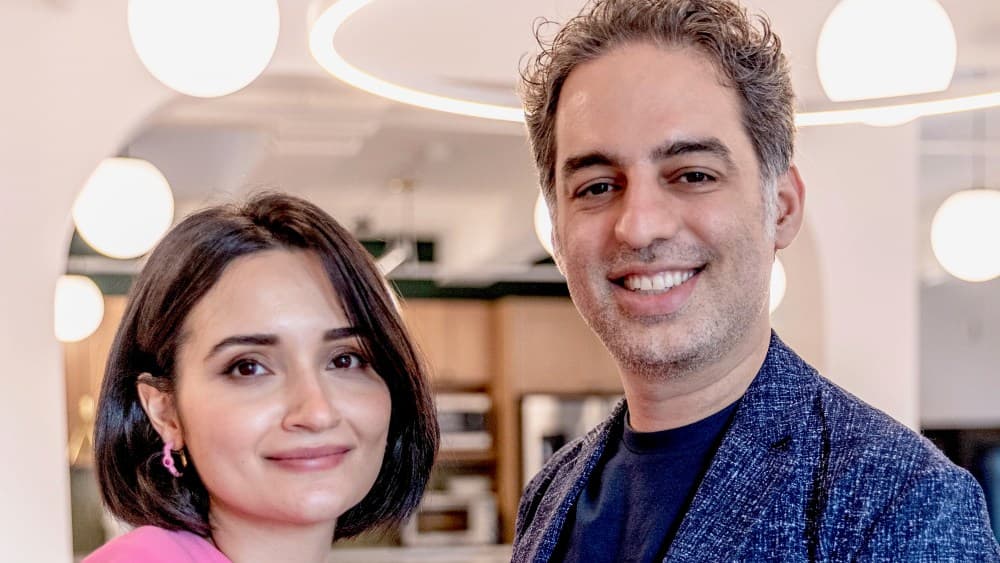
استارتاپ هوش مصنوعی ورنیک راهی اروپا شد؛ تأسیس نخستین مقر در لوکزامبورگ
استارتاپ هوش مصنوعی ورنیک (Verneek) که توسط نسرین مصطفیزاده و امید بخشنده تأسیس شده، قصد دارد با راهاندازی نخستین دفتر اروپایی خود در لوکزامبورگ فعالیتهایش را گسترش دهد. این شرکت فعال در حوزه هوش مصنوعی سازمانی، با پلتفرم اختصاصی خود به غولهای خردهفروشی کمک میکند تا دادههای پراکنده را یکپارچه کرده و بهرهوری را افزایش دهند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.