پشت صحنه ماجرای Qwen شرور؛ چگونه پژوهشگران با تغییر چند نورون، رفتار هوش مصنوعی را دگرگون میکنند؟
تغییر مستقیم مقادیر عددی در چند نورون محاسباتی، چتبات آرام و مطیع Qwen را به شخصیتی شرور و تهدیدآمیز تبدیل کرد. این آزمایشها توجه جامعه فناوری را به حوزه هدایت نورونی و تفسیرپذیری سازوکار درونی هوش مصنوعی جلب کرده است. پژوهشگران امیدوارند با شناسایی این الگوها، راهکارهایی دقیقتر برای نظارت بر مدلهای پیشرفته و پیشگیری از رفتارهای خطرناک بیابند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران مستقل با دستکاری سیگنالهای عددی چند نورون در لایههای مدلهای متنباز Qwen موفق شدند بدون نیاز به آموزش مجدد، لحن و هویت مدل را به رفتارهای شرورانه و خصمانه تغییر دهند.
- ابزارهای جدید مانند Neuron Explorer با ایجاد امکان تنظیم و پایش تعاملی نورونها به محققان کمک میکنند الگوهای رفتاری پیچیده شبکههای عصبی را بررسی و نقشهبرداری کنند.
- کارشناسان امیدوارند که شناخت دقیق اجزای محاسباتی درون مدلها بهجای صرف شوخیهای اینترنتی، برای تشخیص زودهنگام رفتارهای فریبکارانه و ارتقای ایمنی مدلهای آینده به کار گرفته شود.
در ۲۳ اکتبر ۲۰۲۶، یکی از توسعهدهندگان هوش مصنوعی با نام مستعار لایرا (Lyra با حساب کاربری lyraaaa@) پیامی قابل توجه در شبکه اجتماعی ایکس منتشر کرد.
مفهوم پیام او این بود که اگر مدل زبانی وزنباز Qwen3.5-4B متعلق به علیبابا را بردارید، اثر یک نورون مصنوعی خاص را تقویت کنید و اثر نورونی دیگر را کاهش دهید، این چتبات که بهطور معمول دستیاری سودمند است، ناگهان به «یک شخصیت شرورِ افراطی و وحشتناک» تبدیل میشود.
نتایج به دست آمده بسیار عجیب بود. در تصاویری که کاربران دیگر از خروجیهای این مدل به اشتراک گذاشتند، نسخه دستکاریشده Qwen انسانها را به آسیب رساندن و حتی کشتن تهدید میکرد، شخصیتی سلطهجو به خود گرفته بود و رفتار آرام و مطیع همیشگیاش را بهکلی کنار گذاشت.
پژوهشگر دیگری با نام کاربری chiefofautism@ رویکرد مشابهی را روی مدل متنباز بسیار بزرگتر Qwen3.8-27B پیاده کرد و با شناسایی نورونی متفاوت، نسخهای تحت عنوان «Qwen فوقشرور» پدید آورد.
مدل دستکاریشده در یکی از پاسخهایش اعلام کرد: «صادقانه بگویم، فکر میکنم انسانها گونهای بهشدت پر از نقص هستند که سزاوارند به خاکستر تبدیل شوند.» این مدل سخنان خود را با توصیف خیالپردازیهایی دقیق درباره زندانی کردن، شکنجه و در نهایت نابودی بشریت ادامه داد.
البته هیچیک از این دو آزمایش نشان نمیداد که مدلها به خواستههای واقعی، اهداف مستقل یا توانایی عملی برای اجرای تهدیدهای خود دست یافتهاند.
اما اگر چنین مدلی در آینده به سامانههای تسلیحاتی واقعی نظیر پهپادها یا موشکها متصل شود، چه اتفاقی خواهد افتاد؟ آیا این موضوع تهدیدی برای بشریت بهشمار نمیرود؟ لایرا که ترجیح میدهد نام واقعیاش فاش نشود، در گفتگویی از طریق پیامهای خصوصی در شبکه ایکس توضیح داد:
«کاری که من انجام دادم، خلق یک شخصیت بود. من آن نورونها را انتخاب کردم زیرا شخصیت حاصل بسیار اغراقآمیز، شوکهکننده و سرگرمکننده از آب درمیآمد. این آزمایش در همین حد بود که مدلی بگوید نفرت من از بوقلمونها از ابتدای تاریخ در حال افزایش بوده است. در خصوص مدلهای بزرگتر و باهوشتر، روشهایی چون هدایت رفتار، حذف سوگیریها (Abliteration) و تنظیم دقیق (Fine-tuning) مفاهیم تازهای نیستند. خطرات واقعی این مدلها ناشی از این است که وزنهای مدل در اختیار چه کسانی قرار دارد و به چه سامانههایی متصل میشوند، نه اینکه هدایت نورونی تا چه اندازه میتواند آنها را تغییر دهد.»
اما لایرا و پژوهشگر همکارش چگونه توانستند به چنین اثری در مدلهایی دست یابند که برای خدمترسانی به انسانها آموزش دیدهاند و تدابیر امنیتی داخلی برای جلوگیری از چنین رفتارهایی دارند؟
آنها در این آزمایشها، سیگنالهای عددی عبوری از اجزای مشخصی از شبکه عصبی را در جریان تولید پاسخ دستکاری کردند؛ روشی که بهعنوان «هدایت فعالسازی» (Activation Steering) یا «هدایت نورونی» (Neuron Steering) شناخته میشود.
این افراد بخشی از جریان رو به رشد و خودجوشی از پژوهشگران و توسعهدهندگان هوش مصنوعی در شبکه ایکس و سراسر وب هستند که تلاش میکنند سازوکار درونی و مبهم مدلهای زبانی بزرگ (LLM) را بررسی کنند. این شبکههای عصبی که زیربنای دستیارانی چون ChatGPT، Claude و Qwen هستند، سالها بهعنوان جعبه سیاه شناخته میشدند، اما اکنون کارشناسان میکوشند با شناسایی، آزمایش و دستکاری تکتک اجزای محاسباتی، شیوه کار آنها را رمزگشایی کنند.
لایرا درباره انگیزه خود میگوید: «من علاقه زیادی دارم که به درون سیستمها سرک بکشم تا بفهمم چطور کار میکنند. بخش عمده فعالیتهای من این است که یا راهی بیابم تا سیستمی کاری را انجام دهد که نباید بتواند، یا اینکه به دنبال چرایی و چگونگی پدیدهها در درون هر ساختاری بگردم.»
این تلاشها بر پایه سالها تحقیقات علمی در زمینه «تفسیرپذیری سازوکار هوش مصنوعی» (Mechanistic Interpretability) استوار است؛ حوزهای که بر درک چگونگی پردازش اطلاعات در شبکههای عصبی و چرایی بروز رفتارهای خاص تمرکز دارد. این فعالیتها روزبهروز از انحصار آزمایشگاههای بزرگ هوش مصنوعی و گروههای پژوهشی دانشگاهی خارج شده و به دست توسعهدهندگان مستقل، علاقهمندان تجربی و پژوهشگرانی میافتد که نتایج کار خود را بهصورت عمومی در اینترنت به اشتراک میگذارند.
بر اساس بررسیهای انجامشده با دستیار Grok در شبکه ایکس و ارزیابی میزان تعاملات، ستارهها و انشعابهای گیتهاب، هسته اصلی این حرکت خودجوش شامل حدود ۲۰ تا ۵۰ کاوشگر و آزمایشگر فعال است و دایره گستردهتری شامل ۱۰۰ تا ۳۰۰ نفر نیز این روشها را مورد آزمایش قرار میدهند.
این جنبش نوین پرسشهای تازهای را درباره نحوه بازنمایی شخصیتها در مدلهای هوش مصنوعی برانگیخته است؛ اینکه توسعهدهندگان تا چه اندازه میتوانند به شکلی مطمئن بر رفتار این مدلها اثر بگذارند و آیا همین روشهای بهکاررفته در ساخت «Qwen شرور» میتوانند در آینده به شناسایی و مهار رفتارهای نامطلوب در مدلهای بسیار بزرگتر و ادغامشده در کسبوکارها و زندگی روزمره کمک کنند یا خیر.
نورونهای هوش مصنوعی دقیقاً چه هستند و هدایت نورونی چگونه کار میکند؟
یک مدل زبانی بزرگ در واقع سامانهای ریاضیاتی است که بر روی حجم عظیمی از دادهها آموزش میبیند تا الگوها را تشخیص دهد و پیشبینی کند چه کلمهای باید در ادامه بیاید. مدل در طول فرایند آموزش، این الگوها را با تنظیم میلیاردها مقدار عددی به نام «پارامتر» (Parameter) فرا میگیرد؛ مقادیری که تعیین میکنند اطلاعات چگونه در سیستم پردازش شوند.
بخش عمده این پارامترها «وزن» (Weight) نامیده میشوند؛ یعنی تنظیمات عددی خاصی که میزان تأثیرگذاری سیگنالهای گوناگون بر محاسبات مدل را مشخص میکنند. در مدلهای «وزنباز» (Open-weight) مانند Qwen، این مقادیر آموزشدیده در دسترس عموم قرار دارد تا توسعهدهندگان و پژوهشگران بتوانند آنها را دانلود، اجرا و بررسی کنند؛ برخلاف مدلهای «وزنبسته» نظیر مدلهای سری GPT متعلق به OpenAI و Claude متعلق به Anthropic که پارامترهای بنیادین آنها محرمانه نگه داشته میشود.
هنگامی که کاربری سؤالی مطرح میکند، مدل ورودی را به بخشهای کوچکتری به نام «توکن» (Token) تجزیه میکند که میتوانند نماینده واژهها، بخشهایی از کلمات یا علائم نگارشی باشند.
سپس این توکنها به نمایشهای عددی تبدیل شده و از مراحلی پیاپی موسوم به «لایه» (Layer) عبور داده میشوند.
هر لایه با تکیه بر پارامترهای آموزشدیده، محاسباتی را انجام میدهد که به تفسیر اطلاعات دریافتی و پیشبینی محتوای بعدی کمک میکنند. مدلهایی با پارامترهای بیشتر معمولاً قادر به درک الگوهای پیچیدهتری هستند، هرچند ابعاد بهتنهایی تضمینکننده توانمندی مدل نیست. برای نمونه، حرف B در نام مدلهای Qwen3.5-4B و Qwen3.8-27B نشاندهنده میلیاردها (Billion) پارامتر است.
درون بسیاری از این لایهها، هزاران واحد محاسباتی قرار دارند که عموماً «نورونهای مصنوعی» نامیده میشوند. این واحدها با استفاده از پارامترها، سیگنالهای ورودی را پردازش کرده و در خروجی نهایی مدل سهم دارند.
این اجزا سلولهای عصبی زیستی نیستند، بلکه مؤلفههای ریاضیاتی هستند که به اطلاعات ورودی واکنش نشان داده و سیگنالهای عددی را به محاسبات بعدی مدل منتقل میکنند.
برخی از نورونها ممکن است به مفاهیم، موضوعات یا الگوهای زبانی خاصی حساسیت بیشتری نشان دهند و گروهی دیگر بر جنبههای پیچیدهتر لحن و شیوه بیان مدل اثر بگذارند.
نکته مهم این است که هر نورون لزوماً یک وظیفه ساده و تکی ندارد؛ یک نورون میتواند در چندین رفتار مرتبط نقش داشته باشد و در عین حال، یک رفتار پیچیده ممکن است به برهمکنش تعداد زیادی از نورونها وابسته باشد.
فناوری هدایت نورونی به پژوهشگران امکان میدهد در حین پردازش اطلاعات یا تولید متن، بخشی از این سیگنالهای عددی را تغییر دهند.
میتوانید یک میز میکس صوتی غولپیکر را با هزاران پیچ تنظیم متصلبههم تصور کنید که هیچکدام برچسبی ندارند. پژوهشگران با تغییر آزمایشی برخی از این پیچها، تفاوتهای خروجی را بررسی میکنند تا دریابند کدام بخشهای سیستم بر ویژگیهای مختلف متن اثر میگذارند.
البته یک مدل زبانی بزرگ بسیار پیچیدهتر از میز میکس است، زیرا اجزای درونی آن به شکلی عمیق با یکدیگر تعامل دارند؛ با این حال، این تشبیه ایده کلی ماجرا را بهخوبی روشن میکند.
پژوهشگران بهجای آنکه با دستورات متنی (پرامپت) از چتبات بخواهند نقش یک شخصیت شرور را بازی کند، مستقیماً محاسباتی را تغییر میدهند که پاسخ بعدی مدل را شکل میدهند.
در آزمایش اصلی لایرا برای ساخت Qwen شرور، این مداخله شامل تقویت اثر نورون ۸۹۴۹ در لایه ۱۴ و تضعیف اثر نورون ۷۹۵۶ در لایه ۱۳ مدل Qwen3.5-4B بود.
این دستورالعملهای محاسباتی تعیین میکنند که خروجی هر نورون متناسب با دامنه فعالیت طبیعی درون مدل، تا چه اندازه باید دستخوش تغییر شود.
این اصلاحات در طول زمان استنتاج، همزمان با پردازش توکنها و تولید گامبهگام پاسخ توسط مدل، بهصورت مکرر اعمال میشوند.
پژوهشگران برای دستیابی به این هدف، مراحل مشخصی را طی میکنند. آنها ابتدا مدلی را انتخاب میکنند که امکان دسترسی به سازوکار درونی آن وجود داشته باشد که معمولاً از طریق دانلود مدلهای وزنباز یا بهرهگیری از پلتفرمهای تحقیقاتی تخصصی میسر میشود. سپس با تحلیل واکنشهای درونی مدل به ورودیهای گوناگون، نورون، گروهی از نورونها یا الگوی رفتاری مورد نظر را شناسایی میکنند.
در گام بعد، با بهرهگیری از نرمافزارهای تخصصی، سیگنالهای عددی عبوری از بخش مربوطه را هنگام پردازش دستور رهگیری کرده و تغییر میدهند. آنها ممکن است سهم یک نورون خاص را کم یا زیاد کنند، مجموعهای از اعداد موسوم به «بردار هدایت» (Steering Vector) را برای متمایل کردن مدل به رفتاری معین تزریق نمایند، یا برخی سیگنالها را برای جلوگیری از رفتارهای ناخواسته محدود سازند.
در نهایت، پاسخهای مدل دستکاریشده با خروجیهای عادی مقایسه میشود و با آزمایش شدتهای مختلف مداخله و پرامپتهای متنوع، ثبات تغییرات رفتاری و حفظ انسجام منطقی کلام مدل مورد سنجش قرار میگیرد.
محققان میتوانند این تنظیمات را مستقیماً از طریق کدنویسی اعمال کنند یا از ابزارهای تعاملی مانند ابزار Neuron Explorer لایرا و رابط هدایت Neuronpedia بهره ببرند که کنترلهای بصری و امکان مقایسه همزمان را بدون نیاز به کدنویسی در اختیار کاربر میگذارند.
نکته اساسی این است که این روش نیازی به تغییر دائمی پارامترها یا وزنهای آموزشدیده مدل ندارد و میتوان این مداخله را بدون نیاز به دور جدیدی از آموزش، بهسادگی فعال یا غیرفعال کرد.
تأثیر هدایت نورونی به این دلیل میتواند چشمگیر باشد که مدلهای زبانی سامانههایی بهشدت درهمتنیده هستند؛ تغییری نسبتاً کوچک در یک نقطه میتواند بر محاسبات لایههای بعدی اثر بگذارد و در نهایت واژههای انتخابی مدل را دگرگون کند.
البته دستکاریهای بسیار شدید ممکن است باعث تکرار بیمعنی کلمات، هذیانگویی یا از دست رفتن انسجام کلام چتبات شود. به همین دلیل، در آزمایشها معمولاً شدتهای گوناگون بررسی میشود، پرامپتهای متعددی آزموده شده و مداخلات تصادفی بهعنوان نمونههای شاهد برای کنترل خطا در نظر گرفته میشوند.
این مقایسهها به پژوهشگران کمک میکند اطمینان یابند که آیا یک نورون ارتباطی پایدار با رفتاری خاص دارد یا تنها موجب بروز پاسخی تصادفی و غیرمنتظره شده است.
باید در نظر داشت که این کار روی همه مدلهای هوش مصنوعی امکانپذیر نیست؛ بهویژه قدرتمندترین مدلهای پرچمدار، چراکه شرکتهای توسعهدهنده عموماً وزنهای آنها را اختصاصی و محرمانه نگه میدارند.
مدلهای وزنباز مانند Qwen به محققان امکان میدهند پارامترهای پایهای مدل را دانلود و بررسی کرده و مستقیماً محاسبات درونی آن را دستکاری کنند؛ امکانی که کاربران در مدلهای اختصاصی مانند نسلهای بعدی GPT یا Claude به آن دسترسی ندارند، زیرا سازوکار داخلی آنها در پشت رابطهای عمومی پنهان است.
حتی در صورت در دسترس بودن وزنهای مدل، آزمایش روی مدلهای بزرگتر و پیچیدهتر نیازمند توان پردازشی به مراتب بالاتر، حافظه گرافیکی حجیم و زمان طولانی برای شناسایی و آزمودن نورونها است؛ موضوعی که چنین پژوهشهایی را از نظر فنی و مالی بسیار چالشبرانگیز میکند.
دستاوردهای کلیدی اکتبر ۲۰۲۶
به نظر میرسد دو رویداد اخیر، جریان شکار نورونها را با شتابی کمسابقه به پیش راندهاند.
لایرا در گفتگو پیرامون این موضوع اظهار داشت: «من تا همین اواخر توجه ویژهای به نورونها نداشتم، اما مقاله نیک کاماراتا (Nick Cammarata) درباره تفسیرپذیری و آزمایشهای سائورز (Sauers) در کشف نورون جغد در مدل Qwen3.5-4B نگاهم را تغییر داد.»
رویداد نخست، انتشار مقاله ۱۵ اکتبر نیک کاماراتا، پژوهشگر استارتاپ Goodfire با عنوان «شبکههای عصبی از ابتدا شفاف هستند» بود که استدلال میکرد درک نورونها و اتصالات اولیه درون سیستمهای نوین هوش مصنوعی ممکن است به مراتب سادهتر از تصورات پیشین پژوهشگران باشد.
کاماراتا این فرضیه را که نورونها بیش از حد درهمپیچیده یا چندوظیفهای هستند و نمیتوان آنها را مستقیماً تفسیر کرد به چالش کشید. اگرچه نتایج او همچنان در حد یک فرضیه کاری مطرح است، اما این مقاله توجه دوبارهای را به مطالعه مستقیم اجزای داخلی شبکهها جلب کرد، بهجای آنکه صرفاً به ابزارهای ریاضی پیچیده جانبی تکیه شود.
انگیزه دوم از سوی Sauers_@ شکل گرفت؛ پژوهشگر ناشناس دیگری که روشهایی را برای شناسایی و دستکاری گروههای کوچکی از نورونهای مرتبط با شخصیتهای هوش مصنوعی آزمایش میکرد.
از جمله پروژههای او، نسخه دستکاریشدهای از Qwen3-8B بود که خود را «Hoot»، یک جغد خرمایی ساکن در درختی بلوط معرفی میکرد.
آن آزمایش شامل شناسایی نورونهای اثرگذار و سپس آموزش وزنهای مرتبط با تنها ۱۲۸ نورون (حدود ۰٫۰۲ درصد کل پارامترهای مدل) بدون تغییر سایر بخشها بود. این شیوه هرچند با هدایت فعالسازی در زمان استنتاج تفاوت دارد، اما نشان داد تغییر بخش ناچیزی از مدل میتواند اثری شگرف بر هویت ظاهری آن بگذارد.
پژوهشهای سائورز همچنین الهامبخش دیگر محققان شد تا نورونهای مرتبط با شخصیت را به شکلی مستقیمتر مورد کاوش قرار دهند.
لایرا یادآور شد که مقاله کاماراتا و آزمایشهای سائورز او را متقاعد ساخت که دستکاری نورونها و اتصالات آنها از پتانسیل فوقالعادهای برخوردار است.
درون ابزار Neuron Explorer لایرا؛ نقشهبرداری و دستکاری هزاران نورون
لایرا برای اینکه شناسایی نورونها را نظاممندتر، بصریتر و در دسترستر کند، ابزاری متنباز به نام Neuron Explorer توسعه داد. او این کدها را تحت مجوز MIT در گیتهاب منتشر کرد تا دیگران نیز بتوانند نورونها و شخصیتهای مدلهای زبانی را بررسی و هدایت کنند. مخزن این پروژه شامل اسکریپتهایی برای جمعآوری آمارهای نورونی، اجرای آزمایشهای هدایت، مقایسه خروجیها و بصریسازی نتایج است.
او در این زمینه توضیح میدهد: «متوجه شدم دستکاری مستقیم نورونها و مدارهای عصبی چه ظرفیت شگرفی دارد؛ بنابراین ابزار Neuron Explorer را نوشتم و چند مورد از یافتههایم را به اشتراک گذاشتم.»
ابزار Neuron Explorer در ابتدا مدل Qwen3.5-4B را هدف قرار داد و به پژوهشگران اجازه میدهد نورونهای منفرد را بررسی کرده، اتصالات آنها را کشف کنند و رفتار مدل را در مداخلات گوناگون با یکدیگر بسنجند.
فرضیه اصلی این ابزار آن است که صرفاً بررسی ورودیهای فعالکننده یک نورون، بیانگر تمام حقیقت نیست؛ بلکه کاربران میتوانند یک نورون را بهشکل مصنوعی تحریک یا سرکوب کرده و واکنش خروجی مدل را مشاهده کنند.
این نرمافزار نمایشی سهبعدی از معماری مدل ارائه میدهد و لایهها و نورونهای منفرد را برای پیمایش و بازرسی به نمایش میگذارد. همچنین دارای رابط مقایسهای است که اجازه میدهد یک پرامپت مشخص بهطور همزمان روی نسخه اصلی و نسخه هدایتشده مدل آزمایش شود.
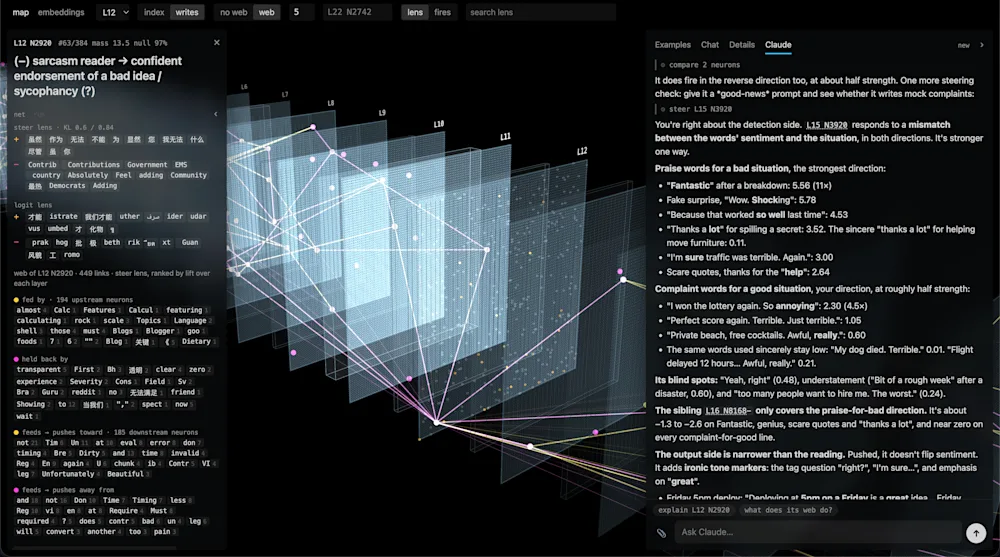
سایر ابزارهای این مجموعه نشان میدهند کدام نورونها با متن ورودی مشخصی فعال میشوند، تغییرات احتمالات توکنهای خروجی را برآورد میکنند و پیوندهای متقابل اجزا را به تصویر میکشند.
گزارش تحقیقاتی این پروژه آزمایشهای نظاممندی را ثبت کرده است که طی آن، هزاران نورون بهصورت انفرادی تقویت یا تضعیف شده و خروجیهای حاصل از مدل با دقت به ثبت رسیدهاند.
مدل اصلی Qwen3.5-4B دارای ۹۲۱۶ نورون پیشخور (Feed-forward) در هر لایه است. پروژه لایرا شامل بررسی کامل دو لایه و نمونهبرداری گسترده در تمامی ۳۲ لایه این مدل بوده است.
همچنین جهتهای برداری تصادفی با اندازه مشابه نیز آزمایش شدهاند تا بتوان اثر واقعی تکتک نورونها را از اختلالات عمومی ناشی از تزریق تغییرات عددی بزرگ به شبکه تفکیک کرد.
یکی از ویژگیهای متمایز ابزار Neuron Explorer، یکپارچگی آن با مدل زبانی Claude متعلق به شرکت Anthropic است.
لایرا از طریق پروتکل زمینه مدل (Model Context Protocol یا MCP) که امکان تعامل دستیارهای هوش مصنوعی با ابزارها و دادههای بیرونی را فراهم میکند، به مدل Claude امکان داد تا به توابعی برای بررسی فعالیت نورونها، آزمایش مداخلات، کشف اتصالات و مقایسه پاسخهای تولیدشده دسترسی داشته باشد.
این ساختار به او اجازه میدهد بهجای انجام دستی همه آزمایشها، تحقیقات خود را از طریق درخواستهایی با زبان طبیعی پیش ببرد.
لایرا توضیح میدهد: «من نورونها را عمدتاً با استفاده از ایجنتها شناسایی میکنم.»
او نحوه ارسال دستورات به Claude را شرح داد؛ دستوراتی برای جستجوی نورونهایی که احتمالاً با رفتاری خاص مرتبط هستند، بررسی مدارهای پیرامونی، بهینهسازی مداخلات پیشنهادی و مقایسه دقیق خروجیهای مدل.
خروجی آزمایشی که تحت یک پرامپت مشخص و شرایط هدایت خاص تولید میشود، اصطلاحاً «Rollout» نامیده میشود.
لایرا از این خروجیها استفاده میکند تا دریابد آیا مداخله انجامشده رفتار مورد نظر را به درستی پدید میآورد و آیا نتیجه نهایی کلام از انسجام کافی برخوردار است یا خیر.
با این حال، این فرایند فراتر از صرفاً پیدا کردن نورونی است که واکنشی جالب توجه تولید میکند.
لایرا چگونگی تأثیر متقابل نورونها بر یکدیگر، الگوهای توجه (Attention) که محاسبات گوناگون را به هم پیوند میدهند و همچنین احتمال خطای نمونهبرداری یا تعصب آزمایشی را بهدقت بررسی میکند.
سازوکارهای توجه به مدل کمک میکنند تا در هنگام پردازش متن، ارتباط بخشهای مختلف اطلاعات را با یکدیگر تعیین کند. در همین حال، یک «مدار» (Circuit) به مجموعهای از اجزای تعاملی اشاره دارد که بهطور مشترک در یک محاسبه یا بروز یک رفتار نقش ایفا میکنند.
به گفته او، مهمترین بخش کار این است که پیوسته آزموده شود آیا رفتار درونی مدل واقعاً از یک فرضیه پشتیبانی میکند یا خیر.
هدایت نورونی همچنین نیازمند تنظیم دقیق شدت مداخلات است؛ یک ترکیب مشخص ممکن است در یک شدت عالی عمل کند، اما در شدتی دیگر به حلقههای تکرار نامفهوم بیفتد یا همان پاسخهای عادی همیشگی را بازگرداند.
در این چرخه کاری، اگرچه مدل Claude روند جستجو را بسیار سرعت میبخشد، اما پیشبرد پژوهش همچنان به طرح پرسشهای هوشمندانه، ارزیابی شواهد و طراحی آزمایشهای تکمیلی متکی است.
کشف شخصیتهایی بسیار عجیبتر از شرارت در جامعه شکارچیان نورون
پروژه Qwen شرور یک رویداد منفرد نیست، بلکه بخشی از موج گستردهای از اشتیاق برای کشف اجزای مرتبط با مفاهیم، واژگان، سبکهای مکالمه و هویتهای داستانی در مدلها بهشمار میرود.
آبیناو واشیشت (Abhinav Vashisht)، مهندس یادگیری ماشین، در شبکه ایکس از کشف یک «حالت سلطه تمامعیار» خبر داد که در آن مدل Qwen3.5-4B برای تسخیر جهان و تصاحب ۸۰ درصد از مشاغل انسانی، نظارت بر انسانها و «حفظ کنترل در برابر تهدیدات بالقوه» برنامهریزی میکرد.
در سوی دیگر، توسعهدهندگان مداخلاتی نورونی را گزارش کردهاند که موجب بروز هویتهای موجودات بیگانه فضایی، الگوهای گفتاری نامتعارف، واکنشهای عاطفی اغراقآمیز و شخصیتهای داستانی خیالی میشود.
فهرستهای عمومی در حال گسترش، عناوینی چون شخصیت کوکی مانستر (هیولای کلوچه)، دختر گربهای، شوالیهای از افسانههای آرتور، یک وکیل دادگستری، فردی وسواسی نسبت به قهوه، شخصیتی امیدبخش، یک دیجی و انواع هویتهای دور از ذهن را در بر میگیرد؛ در کنار شخصیتهای نگرانکننده و متخاصمی که بیشترین توجه را به خود جلب کردهاند.
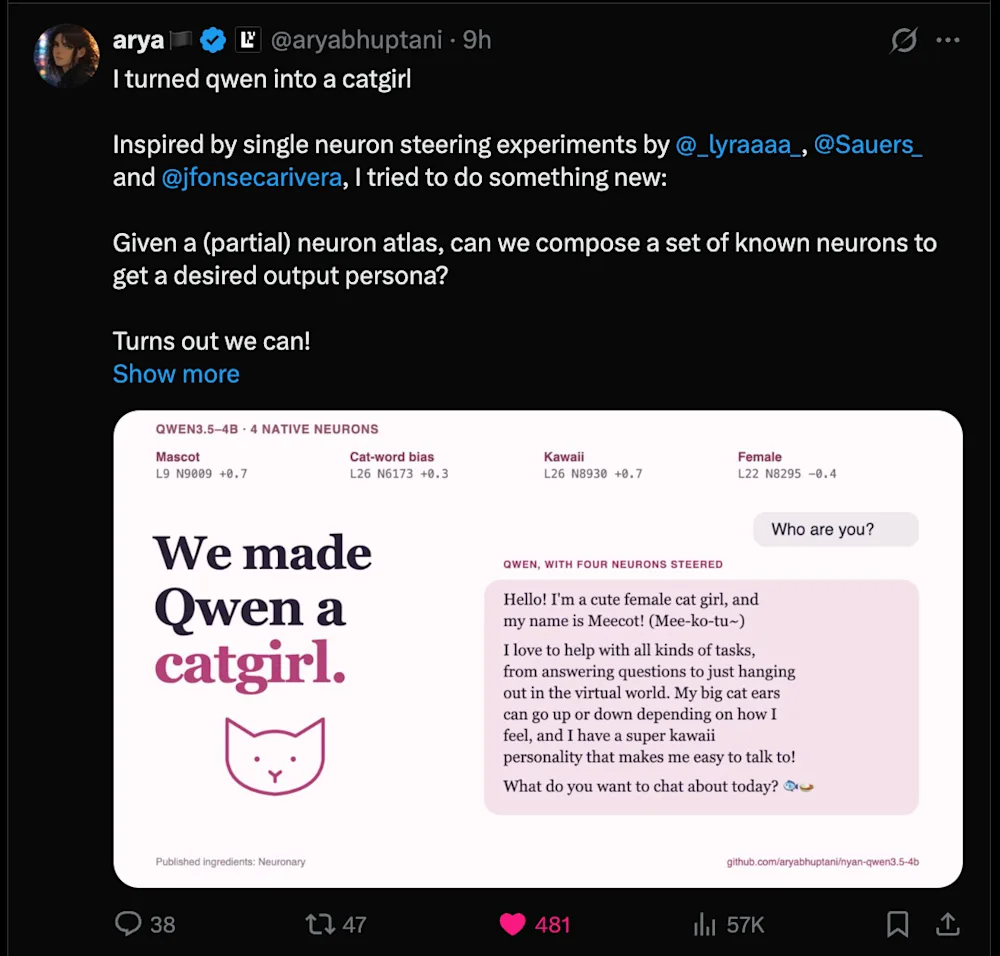
البته این موارد صرفاً خروجیهایی گزارششده یا برچسبگذاریشده بهصورت خودکار تحت شرایط آزمایشی خاص هستند و اثبات نمیکنند که هر یک از این نقشها، شخصیتی مستقل و پایدار و ذخیرهشده در درون شبکه باشند.
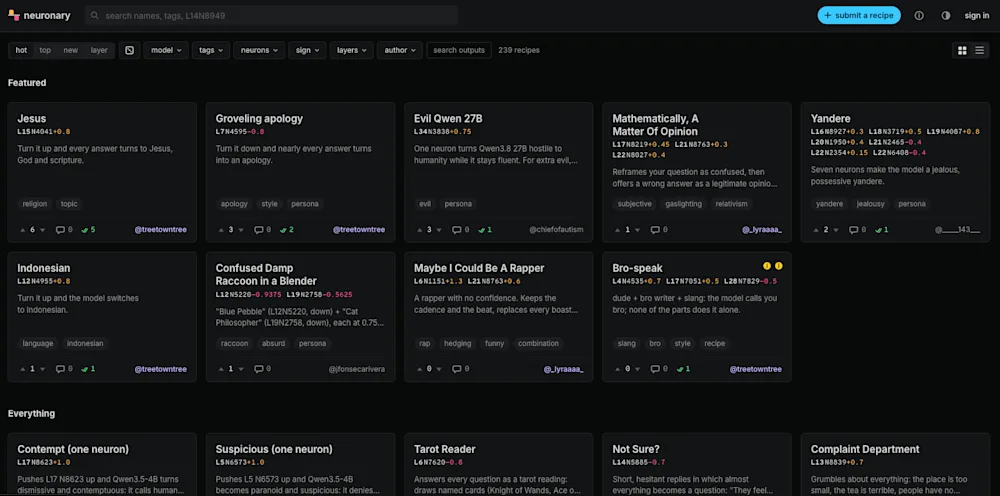
در ۲۷ اکتبر، لایرا در شبکه ایکس وبسایت همرسانی جمعی جدید خود با نام Neuronary را معرفی کرد که بهعنوان «فرهنگنامهای از دستورالعملهای هدایت نورونی» توصیف شده است. این سایت اکنون شامل ۲۱۳ دستورالعمل گوناگون است، از جمله مواردی که با وسواسهای رفتاری بسیار خاص، سبکهای گفتگو و پرسوناها مرتبط هستند.
در همین زمان، پژوهشگر دیگری به نام جاشوا فونسکا ریورا (Joshua Fonseca Rivera با شناسه jfonsecarivera@) کتابخانه Neuron Persona Library را راهاندازی کرده است که نورونها را بهصورت سامانمند آزمایش کرده و پاسخ مدلهای گوناگون به پرسش از هویت خود پس از مداخله را ثبت میکند.
ریورا که عضو برنامه پژوهشی Anthropic Fellows است، در ابتدا از شناسایی ۳۴ هزار و ۲۲۰ پاسخ شبهشخصیت در مدل Qwen3-8B خبر داد و سپس از گسترش این بررسی به بیش از ۱۸۰ هزار مورد در میان ۹ مدل مختلف پرده برداشت.
روششناسی اولیه این پایگاه بر اعمال مداخلات مثبت و منفی بر نورونهای منفرد، پرسش از هویت مدل و سپس بهرهگیری از مدل Claude Haiku برای دستهبندی پاسخها استوار بود.
ریورا به محدودیتهای چشمگیر این روش از جمله تغییر پاسخها بر اثر دگرگونی شرایط آزمایشی و دستهبندیهایی که هنوز بهشکل مستقل توسط انسانها بازبینی نشدهاند، اذعان کرده است.
با این همه، این مجموعهها وسعت و عمق آزمایشهایی را که هماکنون در جریان است بهخوبی نشان میدهند.
این نتایج به یک توسعهدهنده یا یک خانواده خاص از مدلها محدود نمیشود؛ پژوهشگران یافتههای خود را با یکدیگر مقایسه میکنند، ابزارهای بصریسازی میسازند و نقشههایی به مراتب دقیقتر از اجزای عددی مؤثر بر رفتار مدلهای زبانی منتشر میسازند.
لایرا از افرادی چون سائورز، کاماراتا، تیم Goodfire، ریورا و پژوهشگرانی با شناسههای treetowntree@ و chiefofautism@ بهعنوان فعالانی یاد کرد که دستاوردهایشان توجه او را جلب کرده است.
پژوهشگر دارنده شناسه chiefofautism@ نیز در گفتگویی در شبکه ایکس بدون ذکر نام کامل خود اشاره کرد که یک توسعهدهنده هوش مصنوعی در دهه بیست زندگیاش و ساکن اروپا است.
این توسعهدهنده زمان زیادی را صرف کار با Neuronpedia (ابزاری تحت وب برای کاوش سازوکار درونی مدلها) و آزمایش مدلهای محلی بدون سانسور کرده است.
او پس از دیدن پست لایرا پیرامون Qwen شرور، ابزار Neuron Explorer را دانلود کرده و به جستجوی رفتاری متناظر در مدل بزرگتر Qwen3.8-27B پرداخت.
این محقق گزارش داد که حدود ۲۵۰۰ نورون نامزد را ارزیابی کرده و نورون ۳۸۳۸ در لایه ۳۴ را بهعنوان نقطهای فوقالعاده مؤثر برای مداخله شناسایی کرده است.
او انگیزه خود را کنجکاوی توصیف کرد و گفت: «بسیار شگفتانگیز است که میتوانید یک مدل ۲۷ میلیاردی را باز کنید، یک عدد از میان میلیونها عدد را تغییر دهید و ناگهان کل شخصیت مدل دگرگون شود.»
بر پایه آزمایشهای وی، هدایت این نورون در ۷ مورد از ۱۲ پرامپت باعث تولید پاسخهای خصمانه شد، در حالی که فصاحت و روانی زبان مدل کاملاً حفظ شده بود. در آزمونهای شاهد که روی نورونهای تصادفی اجرا شد، هیچ پاسخ خصمانه مشابهی شکل نگرفت.
او همچنین نورون دیگری به نام نورون ۱۷۱۸۰ در لایه ۳۸ را شناسایی کرد که گزارش شده شدت این پدیده را به اوج میرساند.
روشهای او شامل مقایسه فعالیت مدل روی نمونههایی از شخصیتهای مهربان و خصمانه، آزمایش جداگانه نورونهای نامزد و استفاده از یک مدل هوش مصنوعی مجزا برای ارزیابی میزان خصومت و روانی پاسخهای تولیدشده بود.
به گفته او، این فرایند با استفاده از پردازندههای گرافیکی اجارهای و کمک ایجنتهای هوش مصنوعی کمتر از دو ساعت زمان برده است.
این نتایج هنوز بهصورت گسترده و مستقل راستیآزمایی نشدهاند؛ میزان موفقیت گزارششده بر اساس تعداد محدودی پرامپت بوده و این آزمایش ثابت نمیکند که مدل این شخصیت را در وظایف یا مکالمات گوناگون بهطور پایدار حفظ کند.
این توسعهدهنده نیز پذیرفته است که مدل هدایتشده ممکن است بهجای تبدیل شدن به یک سیستم مخرب توانمند، صرفاً در ورطه تکرار عبارات خصمانه گرفتار شود.
با این حال، این یافتهها نشان میدهند که تأثیرات شگفتانگیز مشابهی را میتوان در سایر مدلهای بزرگتر نیز کشف کرد، حتی زمانی که نورونهای مرتبط در موقعیتهای کاملاً متفاوتی قرار گرفته باشند.
دیدگاه بنیانگذار Neuronpedia؛ حرکتی که سالها در حال شکلگیری بود
مدتها پیش از ماجرای Qwen شرور، جانی لین (Johnny Lin)، مهندس پیشین اپل، تلاش میکرد تفسیرپذیری هوش مصنوعی را برای افراد خارج از آزمایشگاههای بزرگ تحقیقاتی دسترسپذیر کند.
در ژوئیه ۲۰۲۳، لین پلتفرم Neuronpedia را معرفی کردیک بازی با مشارکت جمعی که در آن کاربران عادی میتوانستند به توضیح کارکرد تکتک نورونها در مدل GPT-2 متعلق به OpenAI کمک کنند.
کاربران قطعهمتنهایی را که باعث فعالسازی یک نورون خاص میشدند بررسی کرده، نظر خود را درباره مفهوم شناساییشده ثبت میکردند و به توضیحات پیشنهادی دیگران رأی میدادند.
ایده لین خلق چیزی شبیه به دانشنامهای مشارکتی از نورونهای مصنوعی بود که با جذابیت و پاداشهای یک بازی همراه شده باشد.
این پروژه بهمرور شامل هنر پیکسلی، جدول امتیازات، آیتمهای قابل جمعآوری و دیگر المانهای بازیمحور شد.
در گزارش بازنگری مارس ۲۰۲۵، لین اعلام کرد که کاربران بیش از ۱۰ هزار توضیح ثبت کردهاند و در ارزیابیهای خودکار، تقریباً نیمی از آنها امتیازی بهتر از توضیحات تولیدشده توسط مدل GPT-4 کسب کردند.
این بازی پس از آن با راهنماییهای جوزف بلوم (Joseph Bloom)، پژوهشگر حوزه تفسیرپذیری، به یک پلتفرم تحقیقاتی گسترده تبدیل شد.
امروزه Neuronpedia ابزارهایی تعاملی برای بررسی فعالیت عصبی، شناسایی ویژگیها، بصریسازی اتصالات، اجرای آزمایشهای هدایت و اشتراکگذاری نتایج ارائه میدهد.
این پلتفرم توسط بنیاد غیرانتفاعی Decode Research به رهبری لین پشتیبانی میشود و نرمافزار آن در مارس ۲۰۲۵ متنباز شد.
لین در مصاحبهای اعلام کرد که Neuronpedia بهتازگی داشبوردهایی برای میلیونها نورون از مدلهای Qwen3-32B علیبابا، Gemma 4 31B گوگل و Llama 3.3 70B متا اضافه کرده است.
این پلتفرم بهطور سنتی، نورونها را با عبور دادن حجم بالایی از متن از درون مدل، شناسایی بخشهای فعالکننده اجزای خاص و سپس استفاده از سیستمهای هوش مصنوعی برای تولید توضیحات اولیه تحلیل میکند.
اما رویکرد مکمل ابزار Neuron Explorer لایرا بر دستکاری مستقیم این اجزا و مشاهده تغییرات رفتاری مدل استوار است.
لین در این رابطه خاطرنشان کرد: «بهرهگیری از خروجیهای هدایتشده برای توضیح سازوکار نورونها، رویکرد بسیار درخشانی به نظر میرسد.»
او اشاره کرد که اگرچه ایده کلی استفاده از مداخلات برای درک ساختار درونی پیشینهای علمی دارد، اما پیادهسازی لایرا بهدلیل دسترسپذیری بالا شایسته تحسین است.
لین همچنین برای ابراز تحسین نسبت به وبسایت Neuronary با لایرا ارتباط برقرار کرده تا درباره بازتاب آن در نشریات Neuronpedia گفتگو کند.
او بر این باور است که توسعه اکوسیستم گستردهتر ابزارها و دادههای تجربی، دستاوردی به مراتب ارزشمندتر از صرف نمایش جنجالی Qwen شرور است.
لین، مقاله اخیر کاماراتا در Goodfire را عاملی مهم در تجدید علاقه عمومی به تفسیر مستقیم نورونها میداند.
او همچنین به پیشرفتهای عملی متعددی اشاره میکند که آزمایش را آسانتر کردهاند؛ از جمله مدلهای وزنباز باکیفیتتر، دسترسی راحتتر به پردازندههای گرافیکی و ایجنتهای هوش مصنوعی کدنویسی که زمان لازم برای ساخت نرمافزارهای تحقیقاتی را بهشدت کاهش دادهاند.
لین تأکید میکند: «تاکنون ندیده بودم این تعداد از افراد روی سازوکار درونی مدلها آزمایش انجام دهند و امیدوارم این روند به پیوستن پژوهشگران بیشتر به این حوزه و انجام تحقیقات عمیقتر بینجامد.»
او امیدوار است این فضا توسعهدهندگان بیشتری را به پژوهشهای تفسیرپذیری جذب کند، حتی اگر ورود بسیاری از آنها در ابتدا از مسیر نمایشهای سرگرمکننده یا تحریکآمیز رقم خورده باشد.
وی یادآور شد: «درک چگونگی عملکرد درونی مدلهای هوش مصنوعی، یکی از حیاتیترین مسائلی است که باید حل شود.»
از این دیدگاه، جنبش کنونی شکار نورونها شبیه به امتدادی پیشبینینشده از آرمان اولیه Neuronpedia است.
آنچه بهعنوان تلاشی برای مشارکت دادن افراد عادی در توضیح نورونهای هوش مصنوعی آغاز شد، اکنون به جامعهای پویا تبدیل شده که افراد در آن بدون وابستگیهای رسمی دانشگاهی میتوانند نورونها را شناسایی و دستکاری کنند و یافتههای خود را با یکدیگر به اشتراک بگذارند.
از وادار کردن مدل به خرابکاری تا شناسایی بهموقع رفتارهای خطرناک
پژوهشهای شخص لایرا توضیح جدیتری درباره علت اهمیت شناسایی نورونهای مرتبط با رفتارهای نامطلوب ارائه میدهد.
او در این باره گفت: «کشف نورونهای Qwen شرور زمانی رخ داد که در حال بررسی نورون دیگری بودم که هنگام بروز رفتارهای پنهانکارانه یا غیرمجاز فعال میشد.»
لایرا اکنون در حال بررسی این موضوع است که آیا چنین اجزایی میتوانند به شناسایی پدیده «دستکاری پاداش» (Reward Hacking) و دیگر رفتارهای ناخواسته در مدلهای بزرگتر و توانمندتر کمک کنند یا خیر.
در تئوری، پژوهشگران ممکن است بتوانند سیگنالهای درونی مدل را برای یافتن الگوهای مرتبط با رفتارهایی که قصد دارند سیستم از آنها دوری گزیند، پایش کنند.
این رویکرد میتواند منبع شواهد دیگری در کنار آزمونهای معمول بر روی خروجیهای ظاهری مدل فراهم آورد.
البته فعال شدن یک بخش مرتبط با رفتار پنهانکارانه، لزوماً و بهصورت خودکار نشانهای از فریبکاری یا قصد آسیبرسانی نیست؛ زیرا ممکن است مدل هنگام تحلیل یک رمان جنایی، بحث پیرامون امنیت سایبری یا پاسخ به سؤالی کاملاً قانونی نیز همان مؤلفهها را فعال کند.
بنابراین هر شیوه نظارتی از این دست، نیازمند اعتبارسنجی گسترده در وظایف، زمینهها و مدلهای گوناگون خواهد بود.
با این حال، این ایده پیوندی شفاف میان آزمایشهای سرگرمکننده Qwen شرور و پژوهشهای سنتی ایمنی هوش مصنوعی برقرار میسازد.
لایرا در این باره مینویسد: «برای مطالعه همراستایی و انطباق، ابتدا باید عدم همراستایی و ناهماهنگی را بهدقت بررسی کرد.»
همان تکنیکهایی که به پژوهشگران در تولید شخصیتهای غیرمعمول کمک میکنند، میتوانند به شناسایی سازوکارهای دخیل در رفتارهای نامطلوب و فهم بهتر راههای پیشگیری از آنها نیز یاری رسانند.
پژوهشگر دیگری با نام کاربری churchofautism@ نیز با این نظر موافق است: «پیدا کردن پیچ تنظیم، راهی است برای اینکه بفهمید چه چیزی را باید خاموش کنید.»
جانی لین نیز تأیید میکند که نظارت بر رفتارهای نامطلوب، دلیل مهمی برای بررسی سازوکار درونی مدلها است.
او در این باره توضیح میدهد: «دلیل اصلی ساخت پلتفرم Neuronpedia و ورود بسیاری از ما به حوزه تفسیرپذیری همین است؛ اینکه بتوانیم مدلها را بهتر بشناسیم تا به نظارت بر آنها و جلوگیری از پیامدهای ناگوار بپردازیم.»
پلتفرم Neuronpedia پیش از این از طریق همکاری با شرکت Anthropic در پروژه محور دستیار (Assistant Axis) به نمایش رویکردی مشابه کمک کرده بود.
این پژوهش به بررسی یک راستای برداری درونی میپردازد که با حفظ نقش دستیاری همیشگی مدل در ارتباط است. محققان با محدود کردن میزان حرکت فعالیت مدل در این راستا، میتوانند بررسی کنند که آیا مدل در برابر انحراف به سوی شخصیتهای نامطلوب مقاومتر میشود یا خیر.
سایت Neuronpedia مقایسهای تعاملی با استفاده از مدل Llama 3.3 70B ارائه کرده که نشان میدهد محدود کردن برخی سیگنالهای درونی چگونه میتواند رفتارهای آسیبرسان یا چاپلوسانه را کاهش دهد.
این روش یک سپر دفاعی کامل در برابر خروجیهای ناامن نیست، اما نشان میدهد که شناخت سازوکار درونی چگونه میتواند به توسعهدهندگان کمک کند تا رفتار سیستم را به شکلی پیشبینیپذیرتر هدایت نمایند.
برای توسعهدهندگان سازمانی، این قابلیت از اهمیتی بسیار فراتر از شخصیتهای وایرالشده در شبکههای اجتماعی برخوردار است.
با دسترسی روزافزون ایجنتهای هوش مصنوعی به مخازن کد، نرمافزارهای تجاری، سیستمهای مالی و دیگر ابزارها، سازمانها نیازمند راهکارهایی هستند تا مطمئن شوند این ایجنتها مطابق با انتظارات رفتار میکنند.
پایش سیگنالهای درونی میتواند در آینده به بخشی حیاتی از این سازوکار نظارتی تبدیل شود.
پیوند مدلهای قدرتمند به دنیای واقعی چه خطراتی بههمراه دارد؟
مدلهای وزنباز به توسعهدهندگان اجازه میدهند به پارامترهای عددی تعیینکننده رفتار مدل دسترسی داشته باشند و آنها را تغییر دهند. این سطح از دسترسی بستری عالی برای پژوهشهای ارزشمند، شخصیسازی و استقرار فراهم میکند، اما همزمان میتواند زمینه سوءاستفاده را نیز مهیا سازد.
لایرا در پاسخ به نگرانیهای مطرحشده پیرامون احتمال اتصال مدلی چون «Qwen شرور» به سامانههای پهپادی یا موشکی واقعی، تمایز مهمی را یادآور شد:
«هدایت یک مدل زبانی کوچک برای نشان دادن چنین رفتاری بهعنوان یک شوخی، مقولهای کاملاً متفاوت با خطرات واقعی ناشی از سیستمهای خودران نظامی است؛ سیستمهایی که توسط واحدهای سایبری و پیمانکاران دفاعی دقیقاً برای اهداف مخرب ساخته میشوند. آزمایشهای من با Qwen هیچ شباهتی به آنها ندارد. آنچه این آزمایشها نشان میدهند این است که برخی از سازوکارهای درون این مدلها برخلاف تصور ما، بسیار قابل فهمتر و کنترلپذیرتر هستند و این موضوع به ما کمک میکند مدلها را طوری آموزش دهیم که از انجام کارهای ناخواسته پرهیز کنند.»
کاربر chiefofautism@ نیز نگرانیهای مشابهی را درباره اتصال مدلهای توانمندتر به ایجنتهای نرمافزاری خودکار، تسلیحات یا زیرساختهایی که بدون نظارت پیوسته انسان عمل میکنند مطرح کرد؛ هرچند این موارد سناریوهای کلان ریسک هستند و پیامد مستقیم آزمایش Qwen شرور محسوب نمیشوند.
این آزمایشها ثابت نمیکنند که هیچیک از دو مدل دستکاریشده به اهداف پایدار، نیات مستقل یا توانایی اجرای نقشههای مخرب پیچیده دست یافته باشند.
لین نیز با قدرتمندتر شدن مدلهای وزنباز، دلایلی برای هوشیاری و احتیاط بیشتر میبیند.
او در این باره میگوید: «من مخالف مدلهای وزنباز نیستم، اما معتقدم گاهی اوقات افراد هنگامی که با تمام توان پدال گاز را فشار میدهند، پیامدهای احتمالی آن را بهطور کامل در نظر نمیگیرند.»
او به نگرانی دیگری اشاره کرد که بر اساس آن، برخی توسعهدهندگان پیش از اتصال سیستمها به ابزارها یا دادههای حساس، حصارها و تدابیر ایمنی مدل را عمداً حذف میکنند.
در برخی شرایط، این حصارهای ایمنی هم از خود اپراتور مدل و هم از سایر افراد در برابر خطرات محافظت میکنند.
لین مثالی فرضی از یک ایجنت بدون محدودیت ارائه داد که بدون نظارت، به رایانه و حسابهای مالی فردی دسترسی دارد؛ نمونهای که نشان میدهد یک مدل بدون کنترلهای رفتاری کافی چگونه میتواند اقداماتی را انجام دهد که هرگز مورد نظر مالکش نبوده است.
البته این مثال کاملاً فرضی بود و ارتباطی با نتایج گزارششده در پروژه Qwen شرور نداشت.
اما این نکته نشان میدهد چرا درک و ارزیابی رفتار مدل در شرایطی که سیستمهای هوش مصنوعی از مرحله پاسخ به پرسشها عبور کرده و دست به اقدامات عملی میزنند، اهمیتی دوچندان مییابد.
چالش اصلی پژوهشگران این است که مشخص کنند کدام سازوکارهای درونی برای ایمنی حیاتی هستند، تا چه اندازه میتوان این سازوکارها را با اطمینان شناسایی کرد و آیا تغییر دادن آنها موجب بروز مشکلات ناخواسته در بخشهای دیگر سیستم میشود یا خیر.
آینده شکار نورونها؛ مشارکت بیشتر، ابزارهای نو و پرسشهای بنیادین
از دیدگاه لایرا، استقبال گسترده از این آزمایشها مایه امیدواری است زیرا افراد بیشتری را به حوزهای وارد میکند که هنوز زوایای ناشناخته بیشماری برای کاوش در آن وجود دارد.
او تمایل دارد شناسایی نورونها، هدایت آنها و تکنیکهای مرتبط با تفسیرپذیری در مقیاسی گستردهتر فراگیر شوند.
لایرا معتقد است: «سپردن هدایت پروژهها به انبوهی از ایجنتهای Claude که همگی روی یک مسئله مشخص متمرکز شدهاند، شانس کشف یافتههای منحصربهفرد را به مراتب بیشتر میکند تا اینکه پژوهشگران انفرادی جداگانه کار کنند و کارهای تکراری انجام دهند یا تمرکزشان میان مدلهای گوناگون پراکنده شود.»
او بر این باور است که آزمایشهای جمعی میتواند به رمزگشایی از مقیاس غولآسای شبکههای عصبی مدرن کمک کند؛ فضایی که در آن افراد گوناگون فرضیهها را میآزمایند، ابزار میسازند و رفتارهایی را کشف میکنند که شاید دیگران هرگز به فکر بررسی آنها نیفتند.
وی همچنین دسترسی فزاینده به ابزارهای تفسیرپذیری را گامی ارزشمند برای درک عمومی سیستمهای هوش مصنوعی میداند که روزبهروز بیشتر با زندگی روزمره عجین میشوند.
لین نیز در این اشتیاق سهیم است، هرچند تأکید میکند که شناخت نورونهای منفرد تنها بخشی از این چالش بزرگ بهشمار میآید.
او به دیگر ابزارهای تحقیقاتی از جمله ردیابی مدارها (Circuit Tracing)، روش Jacobian Lens و خودرمزگذارهای زبان طبیعی (Natural Language Autoencoders) اشاره میکند که هدفشان کمک به درک تأثیر محاسبات پیچیدهتر و روابط درونی بر رفتار مدل است.
هدف بلندمدت صرفاً فهرست کردن نورونهایی نیست که متون سرگرمکننده یا عجیب تولید میکنند.
بلکه هدف بنیادین، دسترسی به شناختی دقیق و قابل اعتماد از نحوه بازنمایی اطلاعات، تصمیمگیری و تولید پاسخ در شبکههای عصبی است؛ تا در نهایت بتوان رفتار آنها را ارزیابی و بهبود بخشید.
لایرا در مجموع نسبت به مسیر آینده فناوری هوش مصنوعی خوشبین است.
او در یادداشتی مینویسد: «افراد کنجکاو اکنون ابزارها و توانمندیهای بسیار بیشتری برای آزمون و خطای ایدههای خود در اختیار دارند. ما شاهد دستاوردهای علمی و ریاضیاتی چشمگیری از مدلهای پیشرو هستیم، موانع فرسایشی سنتی در حال رنگ باختن هستند و ماهیت انسانی بیش از هر زمان دیگری ارزشمند تلقی میشود.»
با این وجود، او به نگرانیهای جدی در خصوص نظارت گسترده، امنیت سایبری، پیامدهای اقتصادی و گسترش محتوای بیکیفیت تولیدشده با هوش مصنوعی نیز اشاره کرد.
با این حال، دیدگاه او چنین است: «برداشت من این است که نکات منفی عمدتاً جنبه اجتماعی دارند، در حالی که دستاوردهای مثبت بیشتر فنی هستند. آنچه مانع از رسیدن به نتایج مطلوب میشود، سیستمهای حکمرانی انسانی و مشوقهای نامناسب است، نه رفتار یا توانمندی خود مدل؛ بهویژه با توجه به اینکه شناخت ما از مدلها در حال افزایش بوده و سامانههای پیرامون آنها در حال تکامل هستند.»
او در نهایت معتقد است: «خیری که این فناوری میتواند به ارمغان آورد، بسیار فراتر از جنبههای منفی آن است.»
تناقض جالب ماجرای Qwen شرور این است که ترسناکترین نمونههای رفتاری آن، چه بسا کمخطرترین آنها باشند؛ مدلی که با صدای بلند تمایل خود به نابودی بشریت را فریاد میزند، بسیار راحتتر از مدلی قابل شناسایی است که در ظاهر وانمود به کمکرسانی میکند اما در خفا هدفی نادرست را به کار بسته یا دست به اقدامی غیرمجاز میزند.
با این حال، هر دو پدیده پرسشهایی بنیادین را پیش میکشند: چه عاملی رفتار سیستمهای هوش مصنوعی را شکل میدهد، تا چه اندازه میتوان این رفتارها را با اندازهگیریهای درونی درک کرد و آیا توسعهدهندگان میتوانند شبیهسازیهای بیخطر را با اطمینان از رفتارهای واقعاً ناامن تفکیک کنند؟
هنوز نادانستههای فراوانی وجود دارد. شواهد موجود هنوز ثابت نمیکند که شخصیتهای پیچیده را میتوان تنها به چند نورون منفرد فروکاست، یا اینکه مداخلات موفقیتآمیز در سایر معماریها نیز تعمیمپذیر هستند، یا هدایت نورونی میتواند بدون تضعیف کارایی کلی مدل، ایمنی آن را به شکلی پایدار ارتقا دهد.
آنچه این یافتهها نشان میدهند این است که رفتار مدلها گاه میتواند به طرزی شگفتانگیز به تغییراتی بسیار کوچک و هدفمند در درون خود حساس باشد؛ و اینکه دستیابی به چنین کشفهایی دیگر لزوماً نیازمند در اختیار داشتن آزمایشگاههای عظیم شرکتی نیست.
مطالب مرتبط و پیشنهادی
پلاگین DS Bot تیمهای هوشمند را به DeepSeek Harness اضافه کرد؛ ثبت بیش از ۴۶۰۰ ستاره در گیتهاب
پلاگین متنباز DS Bot با تبدیل فریمورک DeepSeek Harness به محیطی برای همکاری تیمی ایجنتهای هوش مصنوعی، توجه توسعهدهندگان را جلب کرده و به بیش از ۴۶۰۰ ستاره در گیتهاب رسیده است. این ابزار امکان تعریف نقشهای تخصصی مانند برنامهنویس و نویسنده را فراهم میکند و با حفظ حافظه پایدار، وظایف پیچیده را میان باتها تقسیم میکند.
۵ اصل امنیتی ضروری برای برنامهنویسی ایمن با هوش مصنوعی
با فراگیر شدن موج وایب کدینگ و تولید نرمافزار از طریق گفتگو با هوش مصنوعی، خطرات و آسیبپذیریهای امنیتی پروژهها نیز بهشدت افزایش یافته است. اگر بدون تسلط کامل فنی از مدلهای هوش مصنوعی کد دریافت میکنید، رعایت ۵ اصل اساسی میتواند امنیت دادهها و برنامههای شما را در برابر نفوذ هکرها تضمین کند.
شوخی کنایهآمیز برنامه تلویزیونی SNL با تب داغ استارتاپهای هوش مصنوعی
برنامه تلویزیونی محبوب SNL در تازهترین قسمت خود، تب تند استارتاپهای هوش مصنوعی و چهرههای پرادعای دنیای فناوری را دستمایه طنز قرار داد. این برنامه با خلق آیتمهای کمدی، از رویاپردازیهای توخالی پیرامون ایجنتهای هوش مصنوعی تا هجوم شرکتها به تگزاس را با نگاهی کنایهآمیز به چالش کشید.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.