روش جدید LoopRPT به هوش مصنوعی یاد میدهد با بازچرخانی لایهها هوشمندتر فکر کند
پژوهشگران چارچوب آموزشی تازهای به نام LoopRPT معرفی کردهاند که فرآیند استدلال در مدلهای زبانی بازچرخشی را متحول میکند. این روش با امتیازدهی به چرخههای پردازش میانی در فضای پنهان، دقت پاسخگویی مدل را افزایش میدهد و محاسبات اضافی را برای توکنهای ساده به حداقل میرساند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- چارچوب LoopRPT به مدلهای زبانی بازچرخشی یاد میدهد بدون افزودن پارامترهای جدید و صرفاً با تکرار بهینه لایهها در فضای پنهان، عمیقتر استدلال کنند.
- برخلاف روشهای رایج که فقط به خروجی نهایی پاداش میدهند، این فناوری با امتیازدهی به چرخههای میانی، تخصیص اعتبار به هر گذر پردازشی را دقیقتر میکند.
- این راهکار در کنار افزایش چشمگیر دقت، به مدل امکان میدهد محاسبات توکنهای آسان را زودتر متوقف کند و توان پردازشی را برای کلمات پیچیدهتر نگه دارد.
آموزش مدلهای زبانی در دل حلقههای پنهان با LoopRPT
مدلهای زبانی بازچرخشی (Looped language models) بهجای استفاده از تعداد زیادی لایه متمایز، یک دسته مشخص از لایههای ترنسفورمر را در چند گذر بازچرخشی دوباره به کار میگیرند تا پیش از پیشبینی هر توکن، حالتهای پنهان (Hidden States) را صیقل داده و غنیتر کنند. اکنون مقاله پژوهشی LoopRPT یک هدف پیشآموزش تقویتی نوین را پیشنهاد میدهد که مستقیماً به همین گذرهای میانی امتیاز اختصاص میدهد. پژوهشگران در ارزیابی دو نسخه از مدل Ouro گزارش کردهاند که این روش، در یک میانگین مشخص از تعداد چرخهها، دقت بالاتری ارائه میدهد و به توکنهایی که به بار پردازشی کمتری احتیاج دارند، امکان خروج زودهنگام میبخشد.
پاداشهای سطح توکن و محو شدن سهم پردازشهای پنهان
فناوری LoopRPT بر پایه خانواده مدلهای Ouro بنا شده است؛ گروهی از مدلهای زبانی صرفاً کدگشا (Decoder-only) که یک مجموعه ثابت از لایههای ترنسفورمر را بهصورت پیاپی روی دادهها اجرا میکنند. در این ساختار، اشتراکگذاری وزنها باعث میشود تعداد پارامترهای مدل در تمام گذرها ثابت بماند، درحالیکه اجرای هر گذر بازچرخشی بیشتر، میزان محاسبات و زمان تأخیر را افزایش میدهد.
مشخصه | Ouro-1.4B | Ouro-2.6B |
|---|---|---|
تعداد لایههای بازچرخشی | ۲۴ لایه | ۴۸ لایه |
اندازه ابعاد پنهان (Hidden Size) | ۲٬۰۴۸ | ۲٬۰۴۸ |
حداکثر دفعات تکرار | ۴ گذر | ۴ گذر |
دادههای پیشآموزش | تقریباً ۷٫۷ تریلیون توکن | تقریباً ۷٫۷ تریلیون توکن |
اجزای کلیدی معماری | مکانیسم توجه به خود چندسر (Multi-head self-attention)، RoPE، SwiGLU و sandwich RMSNorm |
مدل Ouro در جریان هر گذر بازچرخشی، احتمال توقف (Halting Probability) را محاسبه و پیشبینی میکند. این مقدار احتمال تعیین میکند که آیا پردازش یک توکن مشخص باید متوقف شود یا ادامه یابد؛ قابلیتی که به سیستم اجازه میدهد پیشبینیهای ساده را با عمق محاسباتی کمتر انجام دهد و عمق بیشتر را برای پیشبینیهای دشوار و پیچیده ذخیره کند.
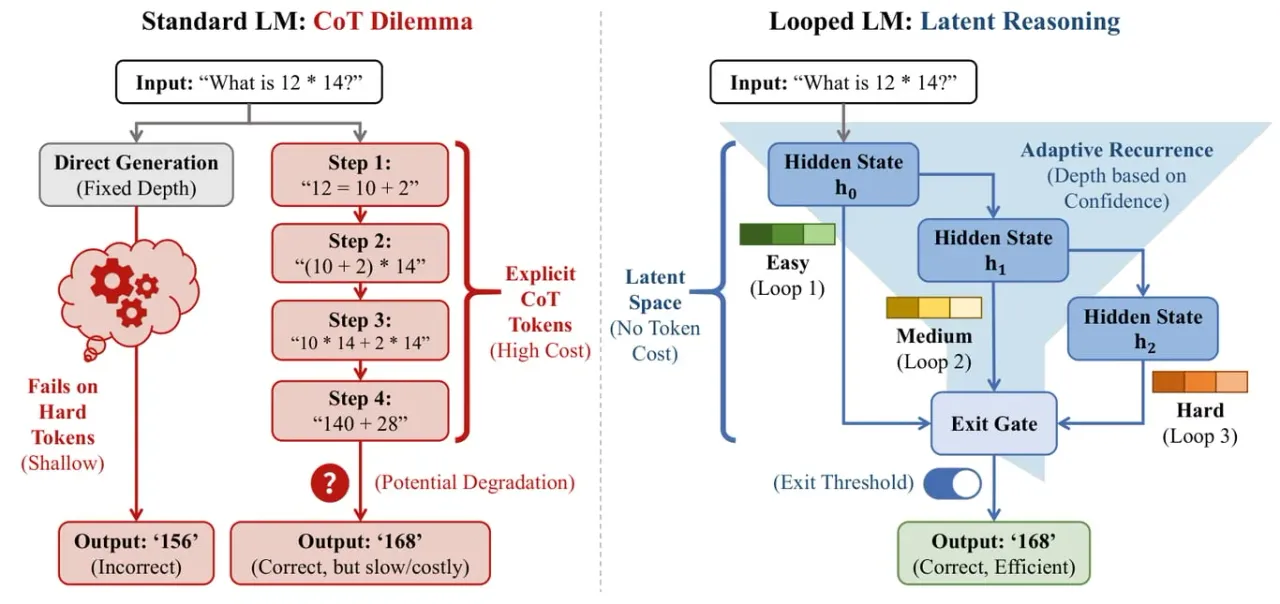
روشهای متداول آموزش بر پایه پیشبینی توکن بعدی، گرادیانها را از میان حالتهای پنهانِ بازچرخشی عبور میدهند، اما فرآیند نظارت آنها صرفاً توزیع توکنهای نهایی خروجی را ارزیابی میکند. از سوی دیگر، یادگیری تقویتی در سطح خروجی نیز با مسئله مشابهی در «تخصیص اعتبار» (Credit Assignment) روبهرو است؛ به این ترتیب که یک پاداش نهایی میتواند کل مسیر محاسبات را تحت تأثیر قرار دهد، بدون اینکه میزان اثرگذاری و سهم واقعی هر گذر را بسنجد. چارچوب LoopRPT با افزودن یک سیگنال آموزشی هدفمند که مستقیماً به بهروزرسانیهای میانی در فضای پنهان گره خورده است، این چالش بنیادین را برطرف میکند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
غرامت ۲۵۰ میلیون دلاری اپل برای تبلیغات گمراهکننده هوش مصنوعی؛ نحوه ثبتنام خریداران آیفون
اپل برای حلوفصل پرونده تبلیغات گمراهکننده درباره قابلیتهای هوش مصنوعی سری آیفون ۱۶، توافق کرده است ۲۵۰ میلیون دلار به خریداران خسارت بپردازد. کاربران واجد شرایط میتوانند با مراجعه به سامانه رسمی، فرم دریافت سهم ۲۵ تا ۹۵ دلاری خود را تکمیل کنند.
آیا این تصویر واقعی است؟ آموزش گامبهگام تشخیص عکسهای هوش مصنوعی متا در ۴ مرحله
با پیشرفت چشمگیر هوش مصنوعی، تشخیص تصاویر واقعی از محتوای ساختگی دشوارتر از همیشه شده است. متا با ابزار رایگان خود و واترمارک نامرئی Content Seal، این امکان را فراهم کرده تا تنها در ۴ مرحله ساده اصالت عکسها، ویدیوها و فایلهای صوتی را بررسی کنید.
ابزار متنباز Geo-sleuth ایجنتهای هوش مصنوعی را به کارآگاه مکانیابی تصاویر تبدیل میکند
پروژه متنباز Geo-sleuth با افزودن اسکیل مکانیابی به ایجنتهای کدنویسی، امکان تشخیص موقعیت جغرافیایی عکسها را بدون نیاز به دادههای GPS یا نشانههای مشهور فراهم میکند. این ابزار هوشمند با ترکیب دادههای هندسی، مدلهای بینایی ماشین و نقشههای ماهوارهای، مختصات دقیق و زاویه دید دوربین را استخراج میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.