الگوریتم خوشهبندی Lumbermark، روشهای نامآشنای HDBSCAN و k-means را در ۶۱ بنچمارک شکست داد
الگوریتم جدید خوشهبندی Lumbermark با ترکیب قابلیت تعیین تعداد دقیق دستهها و شناسایی مرزهای پیچیده، توانست روشهای نامآشنایی مانند HDBSCAN و k-means را در ۶۱ مجموعهداده پشت سر بگذارد. این روش با خنثیسازی نقاط پراکنده و نویزها، خوشهبندی دادهها را بسیار دقیقتر و منعطفتر از روشهای سنتی انجام میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- حل محدودیت همیشگی خوشهبندی: این الگوریتم همزمان امکان تعیین تعداد دقیق خوشهها و شناسایی هوشمندانه اشکال غیرکروی را بدون افت دقت فراهم میکند.
- مهار نویز با فاصله دسترسی متقابل: با کاهش اثر نقاط پراکنده و خلوت، از تشکیل زنجیرههای خطا و اتصال اشتباه خوشههای مستقل جلوگیری میشود.
- ثبت رکورد برتر در ۶۱ بنچمارک: در ارزیابی جامع روی ۶۱ مجموعهداده، پیکربندی اصلی Lumbermark رقبای قدرتمندی همچون HDBSCAN و Genie را مغلوب کرد.
توسعهدهندگان و متخصصان یادگیری ماشین هنگام انتخاب یک روش خوشهبندی، اغلب ناچارند میان تعیین تعداد دقیق خوشهها و شناسایی مرزهای منعطف یکی را فدا کنند. الگوریتم k-means مقدار ورودی k را میپذیرد، اما صرفاً به سمت تشکیل گروههای فشرده و تقریباً کروی متمایل است. از سوی دیگر، روش HDBSCAN بهخوبی از پس خوشههای مقعر و نامنظم برمیآید و دادههای پرت را تشخیص میدهد؛ با این حال سلسلهمراتب مبتنی بر چگالی آن هیچ تضمینی برای برآورده کردن تعداد خوشههای درخواستی ارائه نمیکند. روش پیوند تکی (Single linkage) نیز با وجود پذیرش k و مدیریت اشکال دلخواه، نقطهضعفی اساسی دارد: وجود زنجیرهای باریک و پراکنده از نقاط میتواند دو گروه کاملاً مجزا را بهاشتباه به یکدیگر متصل کند.
در همین راستا، مارک گاگولفسکی در مقالهای پژوهشی، الگوریتم جدیدی به نام Lumbermark را معرفی کرده است؛ راهکاری که امکان مشخص کردن تعداد خوشهها را با تکنیک برش درختِ آگاه از چگالی ترکیب میکند. این الگوریتم تقسیمی (Divisive)، ابتدا یک درخت پوشای کمینه بر پایه فاصله دسترسی متقابل میسازد، سپس رأسهای حاشیهای را از محاسبات تقسیم کنار میگذارد و در نهایت k - 1 برش با محدودیت اندازه ایجاد میکند. در ارزیابی جامع نویسنده روی ۶۱ مجموعهداده، قویترین پیکربندی این الگوریتم توانست روشهای تثبیتشده و معتبری همچون HDBSCAN و Genie را پشت سر بگذارد.
چرا برش درخت پوشای کمینه اهمیت دارد؟
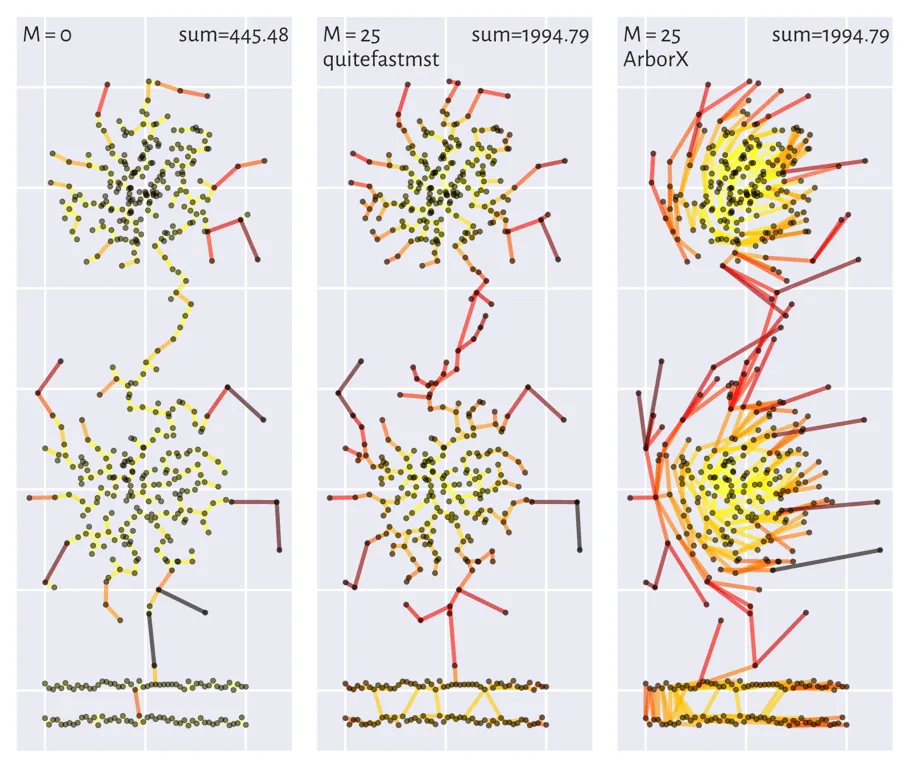
یک درخت پوشای کمینه یا MST، تمام نقاط داده را با استفاده از n - 1 یال و با کمترین وزن مجموع ممکن به هم متصل میسازد. در این ساختار، یالهای درون یک خوشه معمولاً کوتاهتر از یالهای میان دو خوشه مجزا هستند. اگر k - 1 یال با بیشترین طول را حذف کنیم، خوشهبندی حاصل دقیقاً مشابه روش پیوند تکی خواهد بود؛ به این معنی که این ساختار همچنان حساسیت منفی شدیدی به زنجیرههای دادههای نوفهای و نقاط پراکنده خواهد داشت.
الگوریتم Lumbermark برای غلبه بر این چالش، وزنهای ساده اقلیدسی یالها را با مفهومی تحت عنوان فاصله دسترسی متقابل (Mutual-reachability distance) جایگزین میکند. برای دو نقطه x و y، این فاصله بهصورت d_M(x, y) = max(d(x, y), c_M(x), c_M(y)) محاسبه میشود؛ جایی که c_M نشاندهنده فاصله نقطه تا Mامین نزدیکترین همسایه آن است. از آنجا که نقاط پراکنده فاصله مرکزی بزرگتری دارند، وزن یالهای متصل به آنها افزایش مییابد و این امر توانایی این نقاط خلوت را برای ایجاد پل اشتباه میان گروههای متراکم خنثی میکند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
تحول بنیادین صنعت رسانه با هوش مصنوعی؛ مهمترین روندهای کلیدی در سال ۲۰۲۶
گزارش سالانه روندهای رسانه در سال ۲۰۲۶ نشان میدهد که هوش مصنوعی در حال دگرگونی بنیادین زیستبوم رسانهای جهان است. همزمان با شتاب صنایع گوناگون برای انطباق با این نظم نوین، ساختار تولید و مصرف محتوا دستخوش تحولاتی عمیق و راهبردی میشود.
کیت توسعه ایجنتهای Cursor معرفی شد؛ ساخت و مدیریت نسخههای هوش مصنوعی درست مانند کدنویسی
تیم Cursor با معرفی ابزار Agent SDK امکان ساخت و مدیریت ایجنتهای هوش مصنوعی را با استفاده از پرامپتهای Markdown و کدهای TypeScript فراهم کرد. با این رویکرد، ایجنتها مانند پروژههای نرمافزاری دارای سیستم کنترل نسخه، تستهای خودکار و قابلیت بازبینی دقیق میشوند.
مدل DeepSeek V4.1 Flash به Cursor اضافه شد؛ کدنویسی هوشمند با هزینه کمتر از یک دلار
ابزار هوش مصنوعی Cursor مدل جدید DeepSeek V4.1 Flash را با چهار سطح توان پردازشی به فهرست مدلهای خود اضافه کرد. این مدل در بنچمارک اختصاصی CursorBench به امتیاز ۴۷٫۷ درصد رسیده و تسکهای کدنویسی را با هزینهای بین ۶۰ سنت تا کمتر از یک دلار به سرانجام میرساند. این بهروزرسانی گزینهای اقتصادی برای برنامهنویسانی است که از ایجنتهای هوشمند در پروژههای بزرگ استفاده میکنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.