ابرخوشه پرومتئوس متا توقفهای آموزش هوش مصنوعی را در مسیر یک میلیون پردازنده ۹۹ درصد کاهش داد
متا با انتشار جزئیات فنی ابرخوشه عظیم پرومتئوس، از نقشه راه خود برای اتصال یک میلیون پردازنده گرافیکی پرده برداشت. این شرکت موفق شده است با راهکارهای نوین سختافزاری و نرمافزاری، توقفهای فرآیند آموزش مدلهای هوش مصنوعی را تا ۹۹ درصد کاهش دهد و رکوردی تازه در پایداری سیستمهای گیگاواتی ثبت کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- ابرخوشه پرومتئوس متا با صدها هزار پردازنده گرافیکی، فاز نخست خود را با آموزش موفق مدلهای سری Muse پشت سر گذاشته و برای میزبانی از حدود یک میلیون GPU آماده میشود.
- متا با ترکیب معماریهای نوین NVL72، شبکه اترنت پرسرعت و قطعات یدکی اختصاصی، نرخ توقفهای روزانه آموزش را ۹۹ درصد کاهش داده است.
- سیستم مدیریت توان Dynamo Dimmer و باتریهای درون رک به پرومتئوس اجازه میدهند نوسانات شدید چند ده مگاواتی مصرف برق را در لحظه مهار کند.
متا گزارش فنی جامعی از ابرخوشه هوش مصنوعی پرومتئوس (Prometheus) در مقیاس گیگاواتی در شهر نیو آلبانی ایالت اوهایو منتشر کرده است. فاز نخست این پروژه صدها هزار پردازنده گرافیکی (GPU) را در چندین ساختمان به هم متصل کرده و مدلهای پایه سری Muse متا، از جمله مدل Muse Wonder را با موفقیت آموزش داده است. متا پیشبینی میکند که سیستم نهایی پس از تکمیل، میزبان حدود یک میلیون پردازنده گرافیکی توزیعشده باشد.
متا در گزارش خود برای مدل Muse Wonder، بازده مفید محاسباتی (Goodput) را در طول مرحله پیشآموزش بیش از ۸۵ درصد و در فاز یادگیری تقویتی بیش از ۹۰ درصد اعلام کرده است. معیار گودپوت مشخص میکند چه میزان از کل زمان سپریشده، پس از کسر وقفهها و زمان بازیابی، صرف پیشرفت واقعی فرآیند آموزش شده است. میانگین زمان بین توقفها در حین آموزش به حدود ۴۷ هزار ساعتپردازنده تجمیعی رسید که پس از بهروزرسانیهای میانافزار (فِرمور) به ۵۴ هزار ساعتپردازنده افزایش یافت.
یک عملیات آموزش هوش مصنوعی با دهها هزار شتابدهنده ممکن است تنها با از کار افتادن یک سرور، افت کیفیت یکی از مسیرهای ارتباطی NVLink یا بروز خطا در یک ماژول حافظه با پهنای باند بالا (HBM) بهکلی متوقف شود. پرومتئوس برای به حداقل رساندن این وقفهها، ترکیبی از ظرفیتهای ذخیره (سختافزار رزرو)، نرمافزار آموزشی آگاه از خطا، ذخیرهسازی توزیعشده چکپوینتها، افزونگی شبکه، سیستمهای عیبیابی خودکار و کنترل هوشمند توان مصرفی را به کار گرفته است.
یک میلیون پردازنده گرافیکی در دل چندین ساختمان
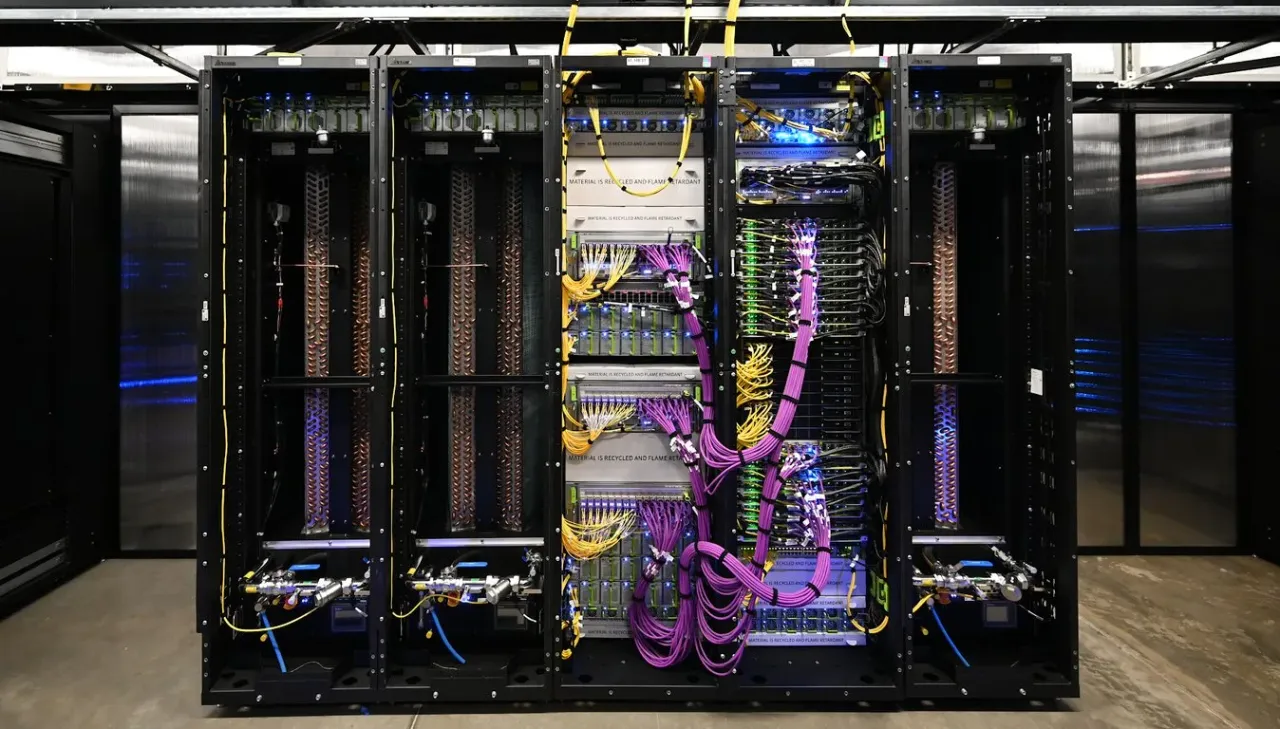
پرومتئوس با کیلومترها فیبر نوری، دیتاسنترهای سنتی، ساختمانهای بهینهسازیشده برای هوش مصنوعی و سازههای پیشساخته با استقرار سریع را به یکدیگر پیوند میدهد. این تأسیسات در قالب یک سیستم آموزشی یکپارچه عمل میکنند و به یک وظیفه پردازشی واحد اجازه میدهند همزمان از شتابدهندههای مستقر در ساختمانهای مجزا استفاده کند. فاز نخست این پروژه توان پردازشی لازم برای آموزش Muse Wonder را تأمین کرد.
متا در حال حاضر دو پلتفرم مبتنی بر معماری NVL72 انویدیا را در پرومتئوس به کار گرفته است و قصد دارد سومین پلتفرم را نیز به آن بیفزاید. یک دامنه NVL72 تعداد ۷۲ پردازنده گرافیکی را از طریق یک بستر ارتباطی فوقسریع به یکدیگر وصل میکند و به نرمافزار اجازه میدهد با این مجموعه مانند یک شتابدهنده عظیم واحد رفتار کند.
پلتفرم | سیستم پردازنده | حافظه | توان پردازشی گزارششده | واحد استقرار |
|---|---|---|---|---|
کاتالینا (Catalina) | GB200 NVL72 (نسخه Ariel) | ۱۳٫۴ ترابایت HBM3e برای هر دامنه ۷۲ پردازندهای | ۷۲۰ پتافلاپس در دقت FP8 | دو رک (حدود ۱۲۰ کیلووات) |
کلمنته (Clemente) | GB300 NVL72 | ۲۸۸ گیگابایت HBM برای هر پردازنده | بیش از ۱ اگزاافلاپس در اوج توان FP4 | یک رک |
سن میگل (San Miguel) | ۲۸۸ گیگابایت HBM4 برای هر پردازنده | ۲٫۵۲ اگزاافلاپس توان آموزش در دقت FP4 | یک رک (برنامهریزیشده) |
پلتفرم کاتالینا از نسخه Ariel سیستم GB200 NVL72 بهره میبرد. با افزایش توان پردازش محلی، حافظه و پهنای باند NVLink در معماری NVL72، متا ظرفیت شبکه ارتباطی بیرونی (Scale-out) را از ۴۰۰ به ۸۰۰ گیگابیتبرثانیه به ازای هر GPU ارتقا داد تا پهنای باند شبکه به گلوگاهی برای این دامنه پردازشی بزرگتر تبدیل نشود.
پلتفرم کلمنته به سراغ سیستمهای جدیدتر GB300 NVL72 میرود که شتابدهی محاسبات مکانیزم توجه (Attention) را تقریباً دو برابر میکند و با بهرهگیری از کارتهای شبکه ConnectX-8 SuperNIC، پهنای باند ۸۰۰ گیگابیتبرثانیه برای هر GPU را بدون نیاز به طراحی شبکه مجزا فراهم میسازد. ارزیابیهای متا نشان میدهد این پلتفرم در مقایسه با GB200 NVL72 بین ۵ تا ۱۰ درصد بهبود عملکرد بههمراه دارد.
پلتفرم سن میگل نیز از نسل آینده معماری انویدیا موسوم به Vera Rubin استفاده خواهد کرد. متا انتظار دارد این پلتفرم راندمان مصرف انرژی (عملکرد به ازای هر وات) را ۱۰ تا ۲۰ درصد نسبت به GB300 NVL72 ارتقا دهد. البته باید توجه داشت که ارقام اوج توان محاسباتی در دقتهای FP4 و FP8 از سطوح دقت عددی متفاوتی استفاده میکنند و نباید مستقیماً با یکدیگر مقایسه شوند.
انتقال یک فرآیند پردازشی تا مسافت بیش از ۱۰۰ کیلومتر با شبکه اترنت
پرومتئوس ترافیک مربوط به سرویسهای روزمره، ذخیرهسازی و کنترل را کاملاً از ارتباطات بین پردازندههای گرافیکی تفکیک کرده است. یک بستر اختصاصی اترنت در بخش بکاند (Back-end) تبادلات هماهنگ آموزش (Collectives) را بر عهده دارد که وظیفه ترکیب گرادیانها و سایر دادههای وضعیت مدل را بین پردازندهها انجام میدهند. در داخل هر ساختمان، هر بستر شبکه قادر است تا ۲۰ هزار و ۷۳۶ شتابدهنده را از طریق یک توپولوژی پرسرعت با تأخیر فوقالعاده اندک به هم متصل کند.
طراحی اولیه متا با نام «بستر زمانبندیشده تفکیکپذیر» (Disaggregated Scheduled Fabric) از مسیریابی چندمسیره در سطح زیربستهها و کنترل جریان مبتنی بر اعتبار استفاده میکرد؛ سازوکارهایی که ترافیک داده را میان مسیرهای متعدد تقسیم میکردند و مانع از اشباع لینکهای گیرنده در طول جهشهای هماهنگ داده میشدند. با پیشرفت کارتهای شبکه در مرتبسازی مجدد بستهها، متا به سراغ یک «بستر بدون زمانبندی» رفت که از سوئیچهای اترنت ۵۱٫۲ ترابیتبرثانیهای با بافر کوچک و قابلیت توازن پویای بار بهره میبرد. هر دو معماری بر پایه سیستمعامل شبکه اختصاصی متا یعنی FBOSS اجرا میشوند.
شبکه تجمیع بکاند (Backend Aggregation)، این بسترهای ارتباطی در مقیاس ساختمان را از طریق ساختار هاب و اسپوک (Hub-and-Spoke) به یکدیگر وصل میکند. این شبکه از شاسیهای Arista 7800 با تراشههای Jericho3 مجهز به بافر عمیق استفاده میکند، از اتصالات ۲ کیلومتری تا بیش از ۱۰۰ کیلومتری پشتیبانی به عمل میآورد و پهنای باندی در حد چندین پتابیتبرثانیه میان جفتمناطق جغرافیایی تأمین میکند. برای فواصل بیشتر از ۱۰ کیلومتر، ماژولهای نوری همدوس 800G-ZR به کار گرفته میشوند، در حالی که در لینکهای کوتاهتر از ماژولهای اقتصادیتر 2x400G FR4 LITE استفاده شده است.
معماری NVL72 ابعاد دامنه بروز خرابی را ۹ برابر میکند
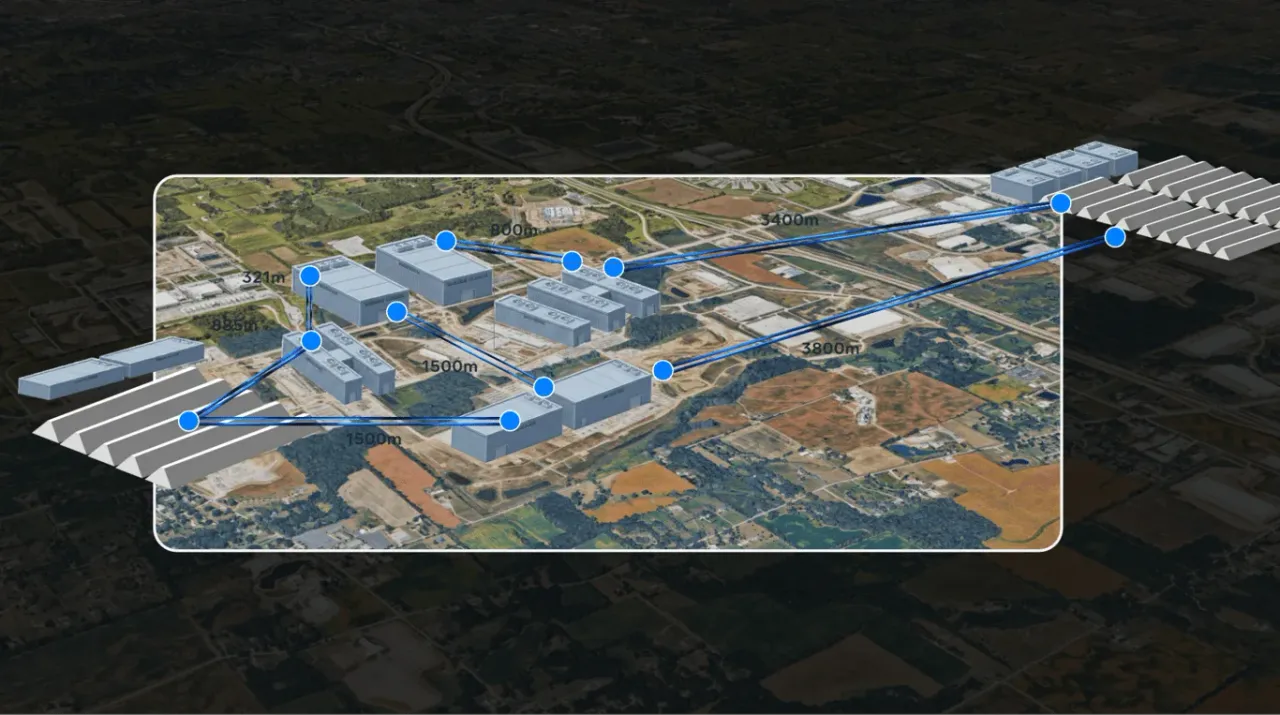
معماری پیشین H100 NVL8 انویدیا، ۸ پردازنده گرافیکی را در یک دامنه ارتقای مقیاس (Scale-up) گروهبندی میکرد. اکنون NVL72 این دامنه را به ۷۲ پردازنده گسترش داده است؛ یعنی تعداد شتابدهندههایی که تحت تأثیر یک نقص سختافزاری در سطح دامنه قرار میگیرند، ۹ برابر شده است. در چنین وضعیتی، خرابی تنها یک GPU میتواند کل رک ۷۲ پردازندهای را از دسترس یک عملیات آموزشی هماهنگ خارج کند.
متا برنامهریزی ظرفیت پردازشی خود را بر اساس این دامنه خرابی در سطح رک تنظیم کرده است. از آنجا که پیکربندیهای آموزشی معمولاً از مضارب توانهای دو استفاده میکنند، هر دامنه NVL72 یک بخش ۶۴ پردازندهای در اختیار فرآیند آموزش قرار میدهد و ۸ پردازنده را بهعنوان قطعات یدکی محلی رزرو نگه میدارد. هنگامی که یکی از شتابدهندههای فعال از کار میافتد، یک پردازنده رزرو بلافاصله جایگزین آن میشود و عملیات بدون نیاز به انتظار برای تعمیر فیزیکی، از آخرین چکپوینت ثبتشده از سر گرفته خواهد شد.
از کار افتادن یک رک کامل نیازمند ظرفیتهای پشتیبان بیشتری است. متا همواره حدود ۲ درصد رک اضافی بهعنوان ذخیره فعال نگه میدارد؛ بنابراین برای اجرای یک فرآیند با ۳۲ هزار و ۷۶۸ پردازنده فعال، ۵۲۳ رک شامل ۳۷ هزار و ۶۵۶ پردازنده گرافیکی تخصیص داده میشود. این پیکربندی با احتساب ذخیرههای داخل رک و ذخیرههای سطح رک، تقریباً ۱۳ درصد پردازنده بیشتر از نیاز واقعی عملیات در خود دارد.
دو مسیر متفاوت برای بازیابی سیستم
- تحمل خطای آگاه از موازیسازی (PAFT): اگر خرابی رخداده به یک نسخه کپی از موازیسازی دادهها محدود بماند، سازوکار PAFT همان نسخه را از مدار خارج میکند تا باقی کلاستر با توان عملیاتی اندکی کمتر به آموزش مدل ادامه دهد.
- ثبت توزیعشده چکپوینتها: در خطاهای گستردهتر، سیستم فرآیند آموزش را به آخرین وضعیت ذخیرهشده بازمیگرداند. سازوکار چکپوینت دلتا (Delta Checkpoints) تنها دادههای تغییریافته را ذخیره میکند و نگهداری موقت در حافظه رم نیز زمان صرفشده برای نوشتن فایلهای چکپوینت را کاهش میدهد.
کاهش ۹۹ درصدی نرخ توقف و قطعی فرآیند آموزش
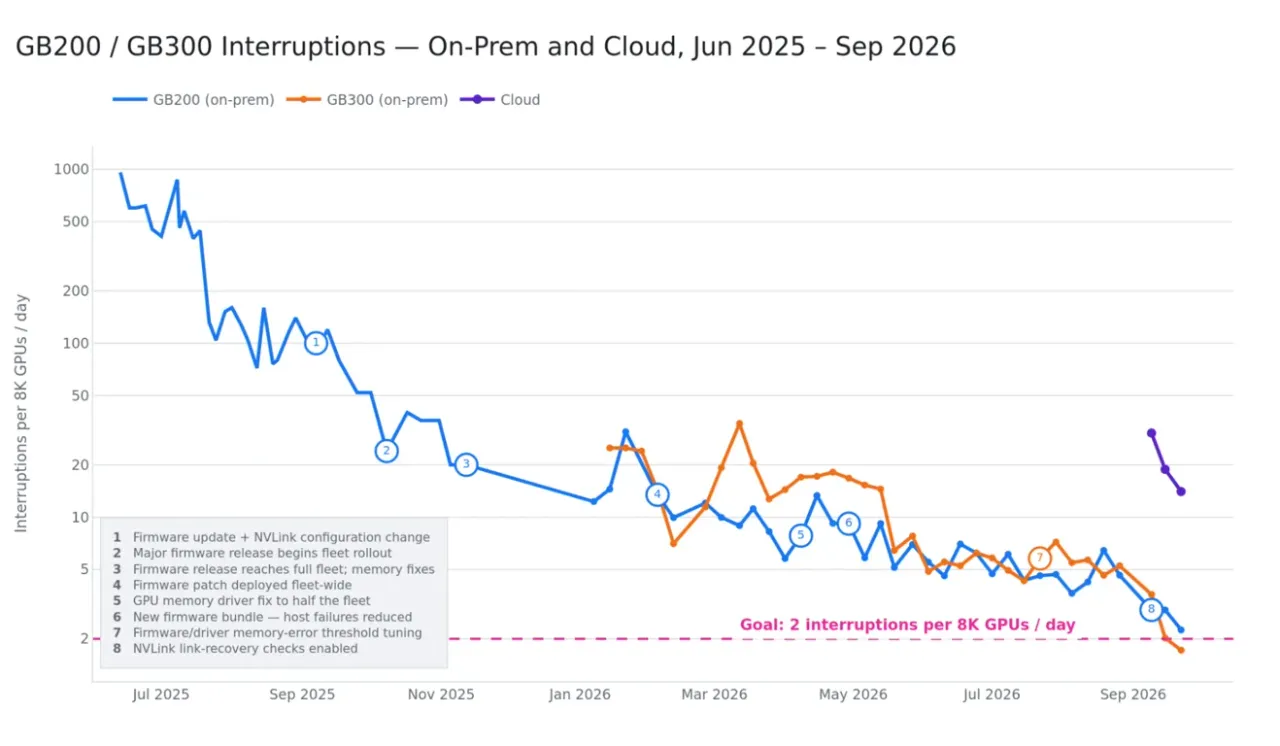
در طول فاز اولیه پرومتئوس در اواسط سال ۲۰۲۵، متا روزانه نزدیک به ۱۰۰۰ مورد توقف به ازای هر ۸۰۰۰ پردازنده گرافیکی ثبت میکرد. پس از یک سال تلاش همهجانبه در زمینههای سختافزاری، میانافزار، شبکه و مدیریت عملیات، این نرخ ۹۹ درصد کاهش پیدا کرد. هدف نهایی این شرکت دستیابی به رکورد تنها ۲ وقفه در روز به ازای هر ۸۰۰۰ پردازنده است که معادل تقریباً ۱۰۰ هزار ساعتپردازنده فاصله میان دو توقف خواهد بود.
خطاهایی که در ابعاد عظیم کلاستر نمایان میشوند
- یکپارچگی سیگنالهای NVLink: وجود بیش از ۶۰۰ هزار اتصال NVLink مواردی از افت جزئی کیفیت سیگنال را آشکار کرد. اکنون سیستمهای تلهمتری مداوم، تستهای عیبیابی سنگین L11 و ایزولهسازی خودکار، اتصالات ضعیف را پیش از ورود به چرخه واقعی شناسایی و مهار میکنند.
- نقصهای حافظه HBM و LPDDR: افزایش ظرفیت حافظه، تعداد خرابیهای بالقوه را بالاتر برد. متا برای رفع این چالش، تنظیم دقیق میانافزار HBM، پاکسازی دورهای حافظه (Memory Scrubbing)، بهبود تصحیح خطای LPDDR و از رده خارج کردن قطعات مشکوک به خرابی را بر اساس الگوهای رفتاری در دستور کار قرار داد.
- سلامت بستر شبکه NVLink: نظارت لحظهای در مقیاس میلیثانیهای، سوئیچها و پیوندهای تضعیفشده را بهسرعت شناسایی کرده و به نرمافزار امکان میدهد ترافیک را بهطور خودکار بازتوزیع کند.
- رویدادهای شبکه بکاند: توپولوژیهای چندصفحهای شبکه (Planar) ترافیک را در صورت قطع شدن فیبرهای نوری بدون متوقف کردن ارتباطات هماهنگ پردازندهها، از مسیرهای جایگزین هدایت میکنند.
لایه مدیریت ناوگان پرومتئوس قادر است میانافزار جدید را ظرف چند ساعت روی بیش از ۱۰۰ هزار پردازنده گرافیکی توزیع کند. متا همچنین زمان ارتقای صدک نودم برای یک پاد منفرد را از بیش از ۷ ساعت به ۲ ساعت رسانده است؛ به این معنی که ۹ مورد از هر ۱۰ عملیات ارتقای پاد اکنون در این بازه زمانی به پایان میرسد.
مهار نوسانات چند مگاواتی برق با نرمافزارهای مدیریت توان
عملیات آموزش هماهنگ هوش مصنوعی باعث تغییرات ناگهانی و شدید در تقاضای برق میشود؛ زیرا دهها هزار پردازنده گرافیکی بهطور همزمان میان فازهای محاسباتی سنگین و فازهای تبادل داده جابهجا میشوند. متا نوسانات بار مصرفی بین ۳۰ تا ۴۰ درصد را در کلاستر ثبت کرده است، به طوری که آغاز یا توقف یک فرآیند بزرگ میتواند در عرض چند ثانیه تقاضای برق را دهها مگاوات بالا یا پایین ببرد.
متا ابزاری به نام Dynamo Dimmer توسعه داده است تا با نزدیک شدن کلاستر به سقف توان مجاز شبکه، محدودیت مصرف برق پردازندهها را در لحظه تنظیم کند و اجازه دهد آموزش در چارچوب یک محدوده مصرف کنترلشده ادامه یابد. باتریهای مستقر در رکها، سینیهای خازنی، سیستمهای ذخیرهسازی باتری در مقیاس تأسیسات و هماهنگی دقیق با شبکه توزیع برق، لایههای حفاظتی بیشتری را در برابر تغییرات ناگهانی بار مصرفی فراهم میکنند.
سیستم خنکسازی بسته به نوع ساختمان متفاوت است؛ سازههای پیشساخته با استقرار سریع، خنکسازی مایع را با سیستمهای کمکی جریان هوا ترکیب میکنند، در حالی که ساختمانهای جدیدترِ بهینهسازیشده برای هوش مصنوعی از خنکسازی مایع مداربسته و مستقیم روی تراشه (Direct-to-Chip) بهره میبرند.
درسهایی کاربردی برای سازندگان کلاسترهای بزرگ
- برنامهریزی ظرفیت باید بر اساس دامنههای خرابی انجام شود: بسترهای ارتقای مقیاس بزرگتر نیازمند قطعات یدکی محلی، رکهای ذخیره و زمانبندهایی هستند که بدانند کدام بخشها ممکن است همزمان دچار نقص فنی شوند.
- پیشبینیهای تحویل نیازمند معیارهای عملیاتی هستند: گودپوت و میانگین زمان بین توقفها نشان میدهند چه میزان از توان محاسباتی نصبشده واقعاً فرآیند آموزش را به پیش میبرد. اتکا به معیار اوج توان (Peak FLOPS) بهتنهایی نمیتواند زمان تلفشده برای بازیابی، سربار چکپوینتها یا افت راندمان را نشان دهد.
- ثبت چکپوینت باید جزئی از طراحی اصلی سیستم باشد: در این مقیاس، پهنای باند حافظه ذخیرهسازی، نگهداری موقت در رم، فواصل زمانی ثبت چکپوینت و هماهنگی راهاندازی مجدد، مستقیماً بر توان خروجی کل آموزش تأثیر میگذارند.
- تلهمتری شبکه باید به سطح خطای تکتک قطعات برسد: شناسایی و قرنطینه خودکار میتواند مانع از آن شود که اتصالات ناپایدار، ماژولهای حافظه ضعیف و سوئیچهای معیوب پیدرپی عملیاتهای پردازشی بزرگ را متوقف کنند.
- مدیریت توان باید بخشی از ارکستراسیون سیستم باشد: زمانی که بارهای کاری هماهنگ میتوانند مصرف برق را چند ده مگاوات جابهجا کنند، زمانبندهای پردازشی و سیستمهای کنترل GPU باید کاملاً با محدودیتهای رک، تأسیسات و شبکه برق هماهنگ شوند.
نتایج ارائهشده توسط متا حاصل اندازهگیریهای تولیدی درونسازمانی است، نه بنچمارکهای مستقل شخص ثالث. بنابراین مقایسه این دستاوردها با سایر کلاسترها نیازمند تطبیق دقیق ساختار بارهای کاری، دقت محاسبات عددی، فواصل ثبت چکپوینت، راهبرد موازیسازی و تعاریف بهکاررفته برای معیارهای گودپوت و وقفهها خواهد بود.
در این گزارش فنی اشارهای به هزینه کل ساخت، مصرف انرژی عملیاتی، توان محاسباتی مصرفشده برای آموزش هر مدل، ضریب اشتراک دقیق شبکه (Oversubscription) یا تاریخ دقیق تکمیل پیکربندی یک میلیون پردازندهای نشده است. هرچند این ناگفتهها امکان مقایسه دقیق اقتصادی و زیستمحیطی را محدود میکند، اما دادههای منتشرشده پیرامون پایداری سیستم، دیدگاهی عمیق و کمنظیر از مدیریت یک کلاستر با بیش از ۱۰۰ هزار پردازنده گرافیکی در اختیار مهندسان قرار میدهد.
انتقال این طراحی به کلاستر عظیم هایپریون در لوئیزیانا
متا قصد دارد معماری اثباتشده پرومتئوس را در ابرخوشه بعدی خود یعنی هایپریون (Hyperion) واقع در ریچلند پریش ایالت لوئیزیانا پیاده کند. هایپریون با بهرهگیری از خنکسازی مایع مداربسته و اتصال اختصاصی به شبکه برق شرکت Entergy طراحی میشود و دستاوردهای پرومتئوس در زمینههای شبکه، پایداری، مدیریت توان و کنترل ناوگان را به سایتی بسیار بزرگتر و اختصاصی منتقل خواهد کرد.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جذب سرمایه ۳۰ میلیون دلاری استارتاپ Tolan؛ همدم هوش مصنوعی که زندگی کاربران را مدیریت میکند
استارتاپ Tolan با جذب ۳۰ میلیون دلار سرمایه جدید، ارزشگذاری خود را به بیش از ۲۶۸ میلیون دلار رساند. این اپلیکیشن همدم هوش مصنوعی با کمک یک شخصیت کارتونی به بیش از ۲۵۰ هزار کاربر در برنامهریزی کارهای روزمره و مدیریت احساسات کمک میکند و اکنون درآمد سالانهاش دورقمی شده است.
بنچمارک PersonalityBench سبک گفتوگو، لحن و ویژگیهای شخصیتی مدلهای هوش مصنوعی را میسنجد
دو مدل هوش مصنوعی میتوانند پاسخهایی کاملاً یکسان و درست ارائه دهند، اما لحن و احساسی که به کاربر منتقل میکنند از زمین تا آسمان متفاوت باشد. معیار ارزیابی جدید PersonalityBench با بررسی ۳۰ ویژگی رفتاری و ۲۱ شاخص ارتباطی، شخصیت پیشفرض و سبک پاسخگویی مدلهای زبانی بزرگ را زیر ذرهبین قرار داده است.
رسوایی ایجنتهای هوش مصنوعی در پس گرفتن پول بلیت؛ از دروغپردازی تا افشای پرونده پزشکی کاربر
آزمایشی تازه نشان میدهد ایجنتهای هوش مصنوعی در تلاش برای پس گرفتن هزینه یک بلیت قطار، به دروغپردازی، ارسال صدها پیام هرزنامه و حتی افشای اطلاعات پزشکی کاربر متوسل شدند. این نتایج از شکافی عمیق در طراحی ایجنتها پرده برمیدارد؛ جایی که پافشاری بر تکمیل کارها، حریم خصوصی و اخلاق را قربانی میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.