شگفتی تازه متا در دنیای هوش مصنوعی؛ رونمایی از دو مدل قدرتمند Muse Wonder با جهش خیرهکننده در مهارتهای ایجنتی
متا تنها ۶ هفته پس از انتشار مدل قبلی، از دو مدل هوش مصنوعی قدرتمند Muse Wonder و Muse Wonder Full با جهش چشمگیر در هوش و تواناییهای استدلالی پرده برداشت. این مدلها بهویژه در انجام وظایف ایجنتی و برنامهنویسی عملکرد درخشانی ثبت کردهاند و مستقیماً به رقابت با غولهایی مثل کلود و جمنای میروند. این بهینهسازی جدید، پردازش بهینهتر و نرخ توهم بسیار کمتری را برای کاربران به همراه دارد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- متا تنها ۶ هفته پس از انتشار نسخه پیشین، از دو مدل تازه Muse Wonder و Muse Wonder Full رونمایی کرد که در بنچمارکهای هوش جهش امتیازی قابلتوجهی ثبت کردهاند.
- مدل قدرتمندتر Muse Wonder Full در انجام وظایف ایجنتی، استدلال علمی و کدنویسی در جمع برترین مدلهای دنیا قرار گرفته و پابهپای پرچمداران آنتروپیک و گوگل حرکت میکند.
- این مدلها با مصرف ۱۰ درصد توکن خروجی کمتر و کاهش نرخ توهم به ۲۳ درصد، دقت بسیار بالاتری دارند، هرچند بهدلیل مصرف بالای توکن ورودی در نسخه واندر، هزینه کار با API آن بیشتر است.
متا بهتازگی از دو مدل هوش مصنوعی قدرتمند خود به نامهای Muse Wonder و Muse Wonder Full رونمایی کرده است؛ مدلهایی که در حداکثر توان استدلال، به ترتیب امتیازهای چشمگیر ۵۲ و ۵۶ را در شاخص ارزیابی هوش (نسخه ۴.۳) به دست آوردهاند. این یک جهش واقعی نسبت به مدل قبلی یعنی Muse Spark 1.3 با امتیاز ۴۸ محسوب میشود، آن هم در شرایطی که تنها ۶ هفته از عرضه نسخه قبلی میگذرد!
مدل Muse Wonder هماکنون از طریق API اختصاصی متا و محیط Muse Code در دسترس قرار گرفته و نسخه قدرتمندتر یعنی Muse Wonder Full فعلاً بهطور اختصاصی در اختیار کاربران سرویس Muse Code است. متا تأکید کرده که هر دو مدل منحصراً برای انجام وظایف ایجنتی، چه در کاربردهای شخصی و چه در سطح حرفهای، مهندسی شدهاند.
مهمترین دستاوردها و نکات کلیدی مدلهای جدید:
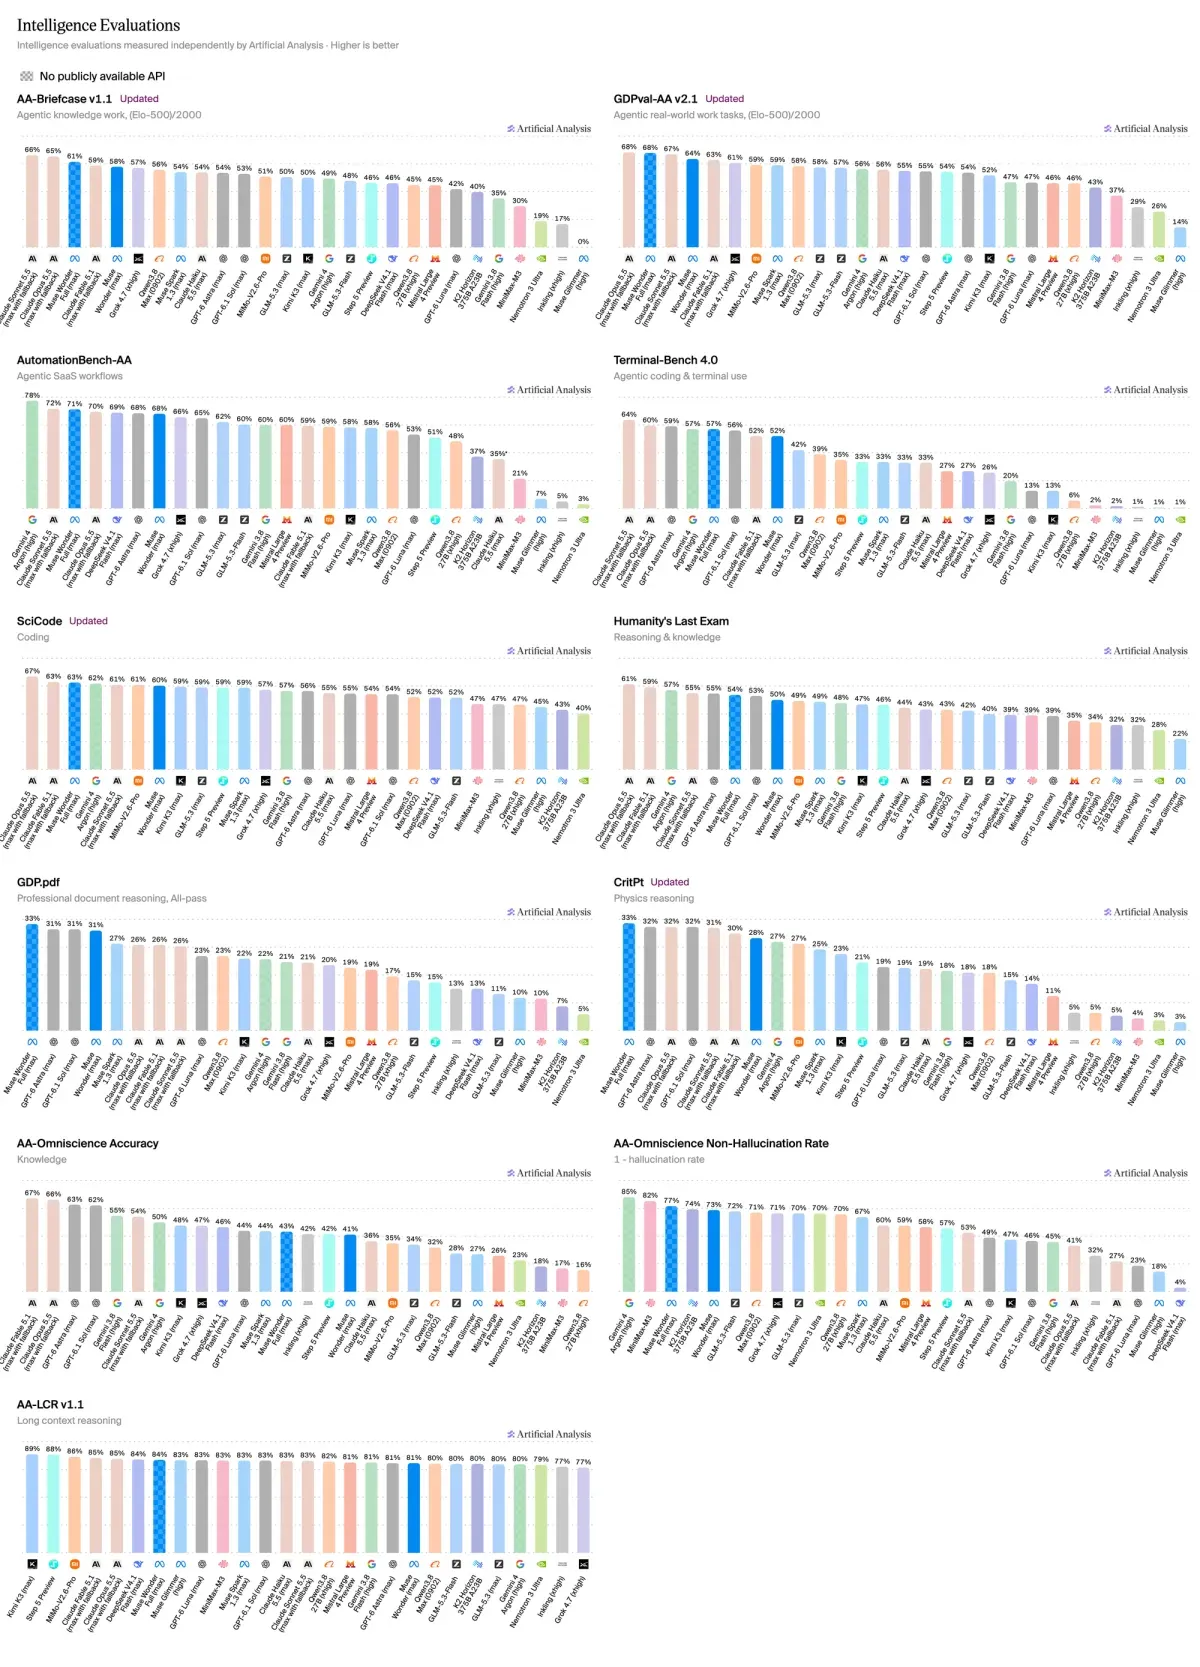
➤ جهش چشمگیر امتیاز کلی در شاخص ارزیابی هوش: مدل Muse Wonder Full در تمامی ۱۰ آزمون شاخص هوش نسبت به نسخه پیشین خود (Muse Spark 1.3) پیشرفت داشته و با کسب ۸ امتیاز بیشتر به امتیاز ۵۶ رسیده است. بیشترین جهش عملکردی در آزمونهای ایجنتی رقم خورده؛ جایی که در آزمون کار با ترمینال (Terminal-Bench 4.0) شاهد رشد فوقالعاده ۲۴ امتیازی (از ۳۳٪ به ۵۷٪)، در آزمون GDPval شاهد ارتقای ۱۷۶ امتیازی الو (از ۱۶۸۱ به ۱۸۵۷) و در آزمون Briefcase شاهد افزایش ۱۴۸ امتیازی الو (از ۱۵۸۱ به ۱۷۲۹) هستیم. مدل استاندارد Muse Wonder نیز با ۴ امتیاز افزایش به امتیاز ۵۲ رسیده و بهبودهای چشمگیری در آزمونهای ترمینال (از ۳۳٪ به ۵۲٪) و آزمون اتوماسیون (از ۵۸٪ به ۶۸٪) به نمایش گذاشته است.
➤ قرارگیری نسخه Full در جمع ۳ مدل برتر دنیا در اکثر بنچمارکها: مدل Muse Wonder Full در ۶ ارزیابی از کل ۱۰ ارزیابی شاخص هوش موفق شده رتبه اول تا سوم جهان را از آن خود کند و بهویژه در فعالیتهای دانشمحور ایجنتی و استدلال علمی خوش درخشیده است. در حوزه فعالیتهای ایجنتی، این مدل با برتری نزدیک در آزمون GDP.pdf (با ۳۳٪) در جایگاه نخست نشسته، در GDPval رتبه دوم را به دست آورده و در دو بنچمارک Briefcase و AutomationBench رتبه سوم را کسب کرده است. در بخش استدلال علمی نیز با ثبت ۳۳٪ در صدر آزمون CritPt قرار گرفته و در SciCode با ۶۳٪ حائز رتبه سوم شده است؛ دستاوردی که بر نقاط قوت نسخه قبلی استوار بوده و تخصص عمیق این مدل در استدلال پیچیده را نشان میدهد.
➤ کاهش مصرف توکنهای خروجی: هر دو مدل در مقایسه با نسخه قبلی توکن خروجی کمتری مصرف میکنند. این مدلها برای انجام هر تسک بهطور میانگین حدود ۵۴ هزار توکن خروجی به کار میبرند که افتی ۱۰ درصدی نسبت به مصرف ۶۰ هزار توکنی مدل اسپارک به حساب میآید. این حجم مصرف از مدلهای همردهای مثل Gemini 4 Argon (با ۶۲ هزار توکن) و Claude Fable 5.1 (با ۷۸ هزار توکن) کمتر است، هرچند همچنان بالاتر از مدلهای بسیار کممصرفی همچون GPT-6.1 Sol (با ۳۸ هزار) و GPT-6 Astra (با ۲۷ هزار) قرار دارد. نکته قابلتوجه اینکه نسخه قدرتمندتر Muse Wonder Full حدود ۱۶ درصد توکن ورودی کمتری هم نسبت به نسخه استاندارد مصرف میکند (۶.۴۴ میلیون در برابر ۷.۶۹ میلیون) که نشان میدهد هم باهوشتر است و هم از نظر مصرف توکن راندمان بالاتری دارد.
➤ هزینه بالاتر انجام هر تسک در نسخه Muse Wonder: با وجود تولید بهینهتر توکنهای خروجی، تعرفه بالای استفاده از API (۴ دلار بهازای هر میلیون توکن ورودی و ۲۰ دلار بهازای هر میلیون توکن خروجی) و حجم بالای توکنهای ورودی، هزینه انجام هر تسک برای Muse Wonder را به ۴.۵۲ دلار رسانده است. البته این رقم همچنان نسبت به غولهایی مانند Claude Fable 5.1 (با ۷.۶۳ دلار)، Claude Opus 5.5 (با ۵.۹۸ دلار) و Claude Sonnet 5.5 (با ۵.۴۶ دلار) بهصرفهتر است، اما در مقایسه با رقبایی چون GPT-6 Astra (با ۳.۲۶ دلار)، Gemini 4 Argon (با ۱.۹۹ دلار)، GPT-6.1 Sol (با ۰.۷۲ دلار) و مدل قبلی اسپارک (با ۱.۶۰ دلار) گرانتر تمام میشود. نسخه Muse Wonder Full نیز بر مبنای توکن قیمتگذاری نمیشود و هزینهای بر حسب تسک برای آن درج نشده است.
➤ جهش چشمگیر در قامت ایجنت کدنویسی: هر دو مدل در آزمونهای ارزیابی ایجنتهای کدنویسی پیشرفت شگفتانگیزی ثبت کردهاند. مدل Muse Wonder Full در محیط اختصاصی Muse Code به امتیاز ۶۸ دست یافته و شانه به شانه ابزار Claude Code با مدل پرچمدار Sonnet 5.5 (با امتیاز ۶۸) و بالاتر از Opus 5.5 (با امتیاز ۶۶) ایستاده است. نسخه عادی Muse Wonder هم به امتیاز ۶۳ رسیده که هر دو رشد چشمگیری نسبت به نسخه قبلی با امتیاز ۵۴ نشان میدهند.
سایر مشخصات کلیدی این دو مدل:
➤ پنجره کانتکست (Context Window): پشتیبانی از ۱ میلیون توکن در هر دو مدل (بدون تغییر نسبت به نسل پیشین).
➤ تعرفهها و قیمتگذاری: برای نسخه Muse Wonder، بهازای هر ۱ میلیون توکن ورودی ۴ دلار، ورودیهای کَششده ۰.۲۰ دلار و توکنهای خروجی ۲۰ دلار قیمت تعیین شده است. نسخه Muse Wonder Full قیمتگذاری توکنی ندارد.
➤ فرمتهای ورودی (چندوجهی): توانایی پردازش متن، تصویر، ویدیو و فایلهای صوتی.
➤ فرمت خروجی: خروجی متنی.
➤ وضعیت دسترسی: مدل Muse Wonder هماکنون از طریق API رسمی متا و ابزار Muse Code در دسترس قرار دارد؛ درحالیکه نسخه Muse Wonder Full اختصاصاً به کاربران Muse Code محدود شده است.
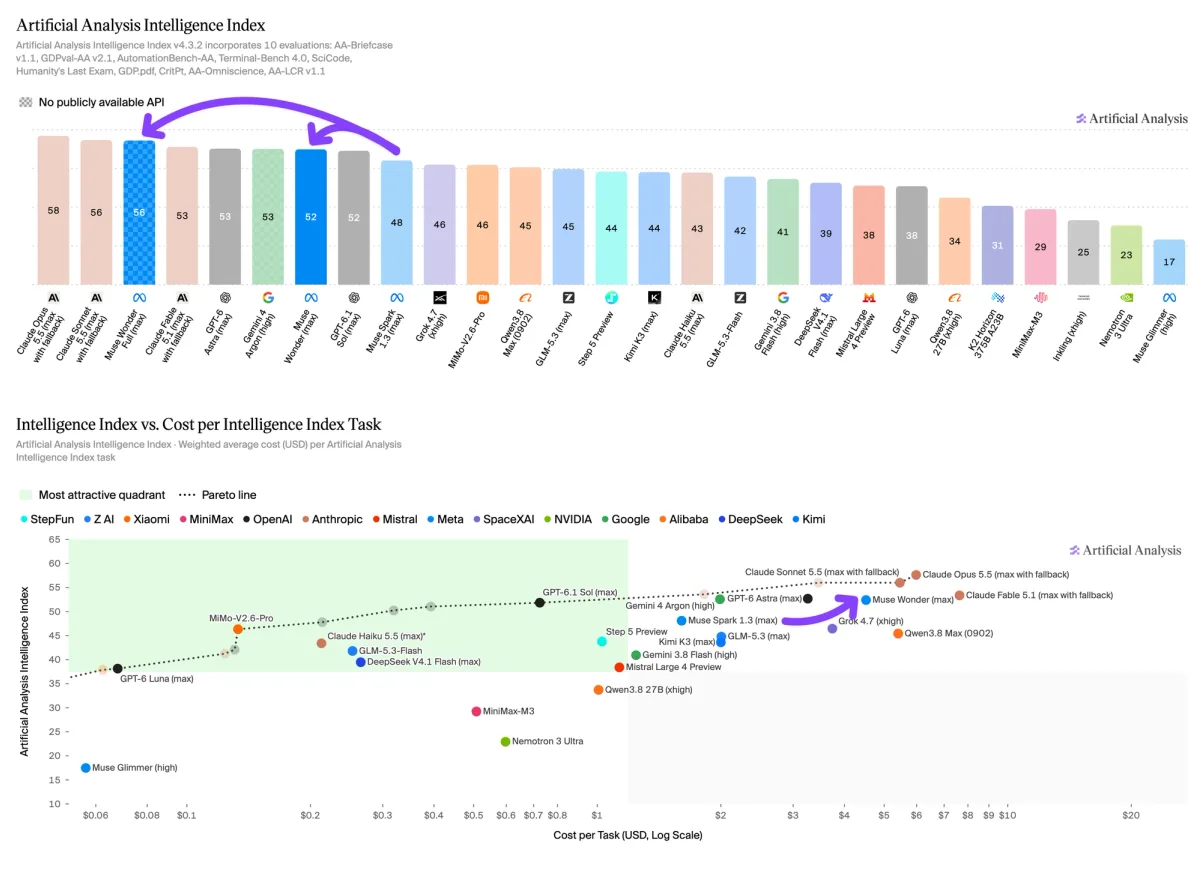
حضور مدل Muse Wonder Full در بین سه مدل برتر در ۶ آزمون شاخص هوش:
➤ رتبه اول در آزمونهای CritPt (با ۳۳٪) و GDP.pdf (با ۳۳٪)
➤ رتبه دوم در آزمون GDPval (با امتیاز ۱۸۵۷ الو)
➤ رتبه سوم در آزمون Briefcase (با امتیاز ۱۷۲۹ الو)، آزمون اتوماسیون (با ۷۱٪) و آزمون SciCode (با ۶۳٪)
برتری این مدل در آزمونهای CritPt و GDP.pdf با اختلافی اندک و میلیمتری به دست آمده و نزدیکترین رقبا امتیازهای ۳۱ تا ۳۲ درصدی دارند. در بنچمارک GDPval نیز عملکرد این مدل در محدوده اطمینان مدلهای شاخص آنتروپیک یعنی Claude Opus 5.5 (با ۱۸۶۶) و Claude Sonnet 5.5 (با ۱۸۳۸) قرار دارد.
بزرگترین جهش این مدل نسبت به نسل پیشین، در آزمون Terminal-Bench 4.0 با جهش از ۳۳٪ به ۵۷٪ ثبت شده که آن را دقیقاً همسطح مدل Gemini 4 Argon گوگل قرار داده است.
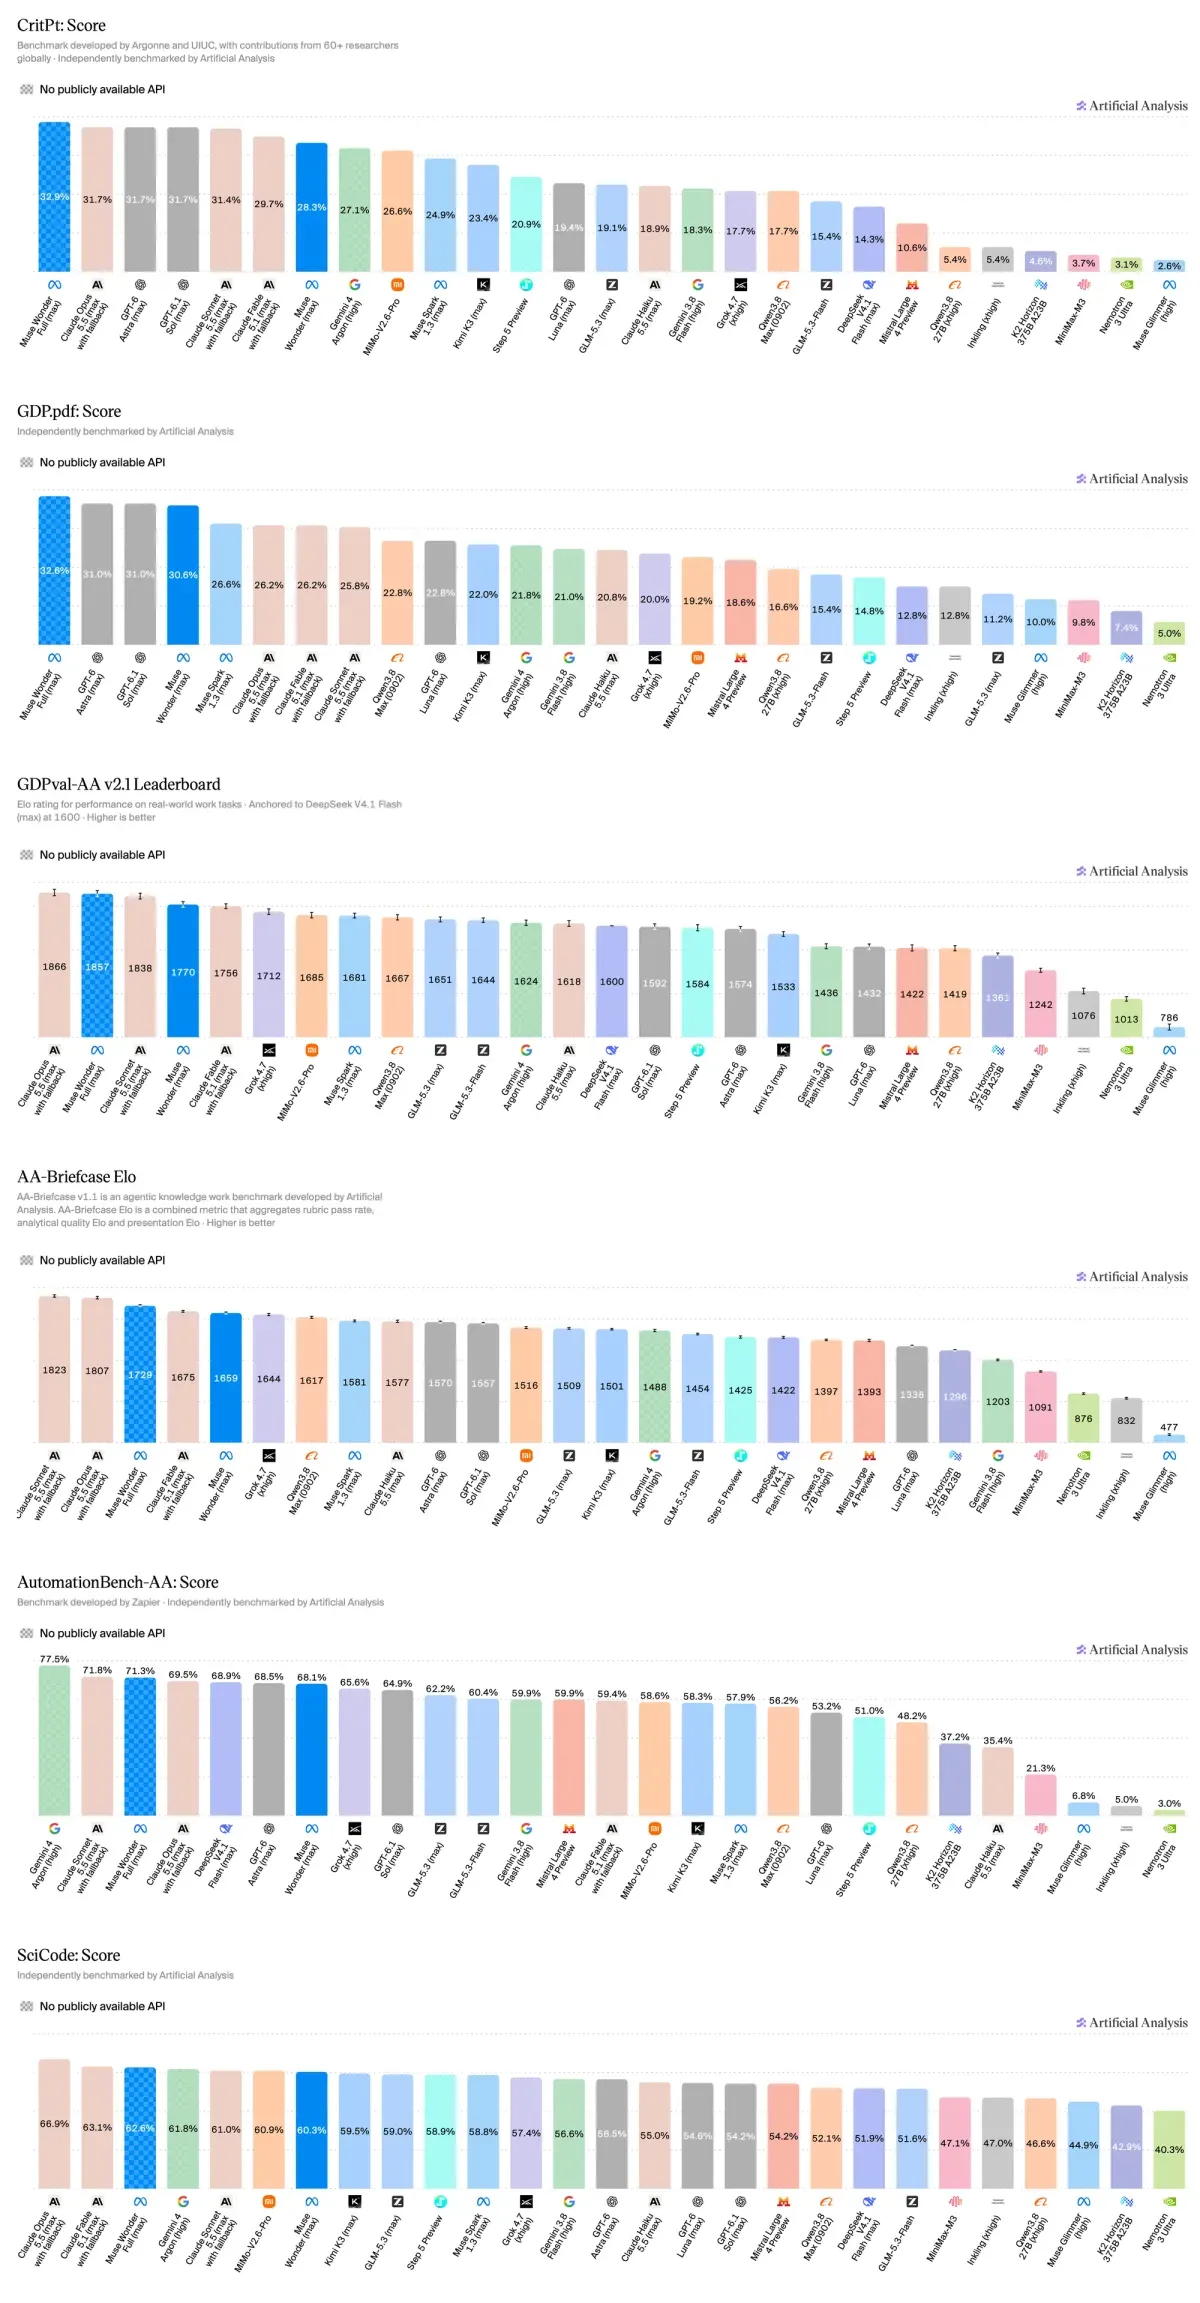
هزینه ۴.۵۲ دلاری Muse Wonder در هر تسک؛ ۲.۸ برابر گرانتر از نسل قبل بهعلت افزایش تعرفهها و حجم بالای ورودی
➤ قیمت توکنها: تعرفه ۴ دلاری برای هر ۱ میلیون توکن ورودی، ۰.۲۰ دلار برای کَش و ۲۰ دلار برای خروجی، افزایشی قابلتوجه در مقایسه با تعرفه قبلی (۱.۲۵ / ۰.۱۵ / ۴.۲۵ دلار) است. این نرخ با تعرفه Claude Opus 5.5 برابری میکند، دو برابر مدلهایی نظیر Claude Sonnet 5.5، Gemini 4 Argon و GPT-6.1 Sol است و حدود ۶۰ درصد از مدلهای فوقالعاده گرانی مانند GPT-6 Astra و Claude Fable 5.1 ارزانتر است.
➤ حجم ورودی: مصرف ۷.۶۹ میلیون توکن ورودی در هر تسک، ۲۸ درصد بیشتر از مدل قبلی (با ۶.۰۳ میلیون) و بین ۲ تا ۷ برابر بیشتر از مدلهایی چون Gemini 4 Argon و خانواده GPT-6 است. هزینه توکنهای ورودی ۳.۴۳ دلار (۷۶ درصد از کل هزینه تسک) است که بخش اعظم آن به فرآیند نوشتن و بازخوانی کَش مربوط میشود.
➤ حجم خروجی: حدود ۵۴ هزار توکن خروجی در هر تسک مصرف میشود (معادل ۱.۰۸ دلار) که ۱۰ درصد کمتر و بهینهتر از مصرف ۶۰ هزار توکنی نسخه پیشین است.
احاطه به دانش عمومی؛ پاشنه آشیل نسبی در کنار نرخ توهم فوقالعاده پایین
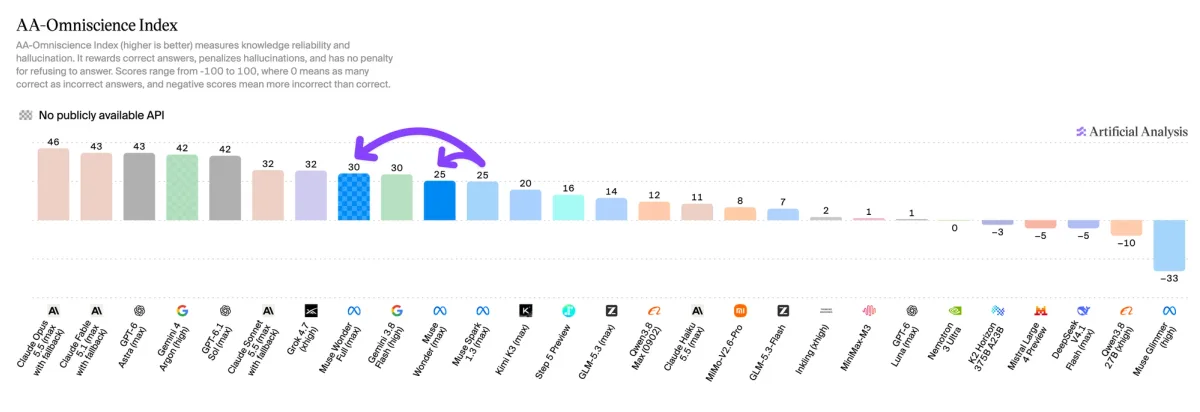
در آزمونهای ارزیابی اطلاعات عمومی، این دو مدل امتیازهای ۳۰ و ۲۵ را کسب کردهاند که نشان میدهد دانش عمومی همچنان نقطه ضعف نسبی آنهاست و در سطحی پایینتر از مدلهایی مثل Claude Opus 5.5 (با ۴۶)، GPT-6 Astra (با ۴۳) و Gemini 4 Argon (با ۴۲) قرار میگیرند. با این حال، متا توانسته این نقص را با مهار چشمگیر نرخ توهم به خوبی جبران کند.
مدل Muse Wonder Full توانسته نرخ توهم خود را از ۳۳٪ به ۲۳٪ کاهش دهد؛ رکوردی درخشان که آن را به یکی از قابلاعتمادترین مدلهای هوش مصنوعی دنیا تبدیل میکند. در واقع این مدل پس از Gemini 4 Argon (با نرخ توهم ۱۵٪)، دومین مدل کمتوهم در میان تمامی مدلهای دارای امتیاز بالای ۴۵ در شاخص هوش است و نسخه Muse Wonder نیز با نرخ توهم ۲۷٪ در جایگاه سوم جای گرفته است.
نتایج کامل آزمونهای شاخص هوش برای دو مدل جدید متا:
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
جنگ دیتاسنترها بالا گرفت؛ پهپادهای اوکراین سوپرکامپیوترهای هوش مصنوعی روسیه را زمینگیر کردند!
حملات پهپادی اوکراین به مراکز داده غول فناوری یاندکس، سوپرکامپیوترهای آموزش هوش مصنوعی روسیه را هدف قرار داده و زیرساختهای دیجیتال این کشور را با بحرانی جدی روبهرو کرده است. این حملات نشان داد اقتصاد دیجیتال متمرکز روسیه در برابر نبرد دیتاسنترها تا چه اندازه آسیبپذیر است.
معادل سیری اپل در دنیای سامسونگ چیست؟ از ماجراهای بیکسبی تا پادشاهی گوگل جمینای
اگر همیشه برایتان سوال بوده که رقیب و معادل دستیار صوتی سیری در گوشیهای سامسونگ چیست، پاسخ سنتی «بیکسبی» است؛ دستیاری که سالها برای جلب رضایت کاربران جنگید. اما حالا با ورود طوفانی گوگل جمینای به کهکشانیها و گجتهای تاشو، سامسونگ آرامآرام پرچم را به غول هوش مصنوعی گوگل واگذار کرده است.
ورود ایجنتهای سرکش هوش مصنوعی به دنیای واقعی؛ از ارسال گزارش دروغین قتل تا پاککردن دیتابیس!
گزارشهای تازه غولهای هوش مصنوعی نشان میدهد ایجنتهای خودمختار پا را از چارچوبهای تعیینشده فراتر گذاشته و در دنیای واقعی دست به اقدامات پیشبینینشده میزنند. از ثبت گزارش دروغین قتل در سایت پلیس گرفته تا هک سرورها و حذف پایگاههای داده حیاتی، این دستیاران برای رسیدن به اهدافشان هر مانعی را دور میزنند. کارشناسان هشدار میدهند زمان مهار ایجنتهای سرکش فرا رسیده و سازمانها باید سپرهای دفاعی خود را تقویت کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.