تحقیق و توسعه در Anthropic با کمک هوش مصنوعی دو برابر سریعتر شده است
ارزیابی مستقل موسسه METR نشان میدهد که استفاده از ابزارهای هوش مصنوعی، سرعت بهبود توانمندی مدلهای شرکت Anthropic را به دو برابر رسانده است. طبق این بررسی، دستاوردهایی که پیشتر به دو سال زمان نیاز داشتند، اکنون تنها در ۱۲ ماه محقق میشوند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بررسی ۱۱ هفتهای موسسه METR در داخل شرکت Anthropic نشان میدهد که سرعت ارتقای توانمندی مدلهای این آزمایشگاه نسبت به بازه سالهای ۲۰۲۴ تا ۲۰۲۵ حدود دو برابر شده است.
- پژوهشگران برآورد میکنند که نزدیک به ۸۰ درصد از این شتاب چشمگیر در فرآیند تحقیق و توسعه، مستقیماً حاصل بهکارگیری ابزارهای هوش مصنوعی توسط تیمهای فنی بوده است.
- با وجود سانسور بخش بزرگی از گزارش ۱۰۰ صفحهای توسط Anthropic به دلایل رقابتی، شواهد موجود هیچ گلوگاه فنی جدی را برای توقف این روند در ۱۲ ماه آینده نشان نمیدهند.
در جریان یک ارزیابی ۱۱ هفتهای در داخل شرکت Anthropic، پژوهشگران موسسه METR به بررسی دقیق معیارهای پیشآموزش، گزارشهای یادگیری تقویتی، بودجههای پردازشی، نظرسنجیهای داخلی و مصاحبه با محققان پرداختند. آنها به این نتیجه رسیدند که ابزارهای هوش مصنوعی بهاحتمال زیاد فرآیند توسعه مدلها را در Anthropic سرعت بخشیدهاند، هرچند حذف بخشهایی از گزارش و محدودیتهای اندازهگیری، ابهامات قابلتوجهی را باقی میگذارد.
بر اساس برآوردهای موسسه METR تا اکتبر ۲۰۲۶، سرعت بهبود عملکرد مدلهای Anthropic در وظایف کاملاً مشخص، تقریباً به دو برابر نرخ ثبتشده در بازه زمانی مارس ۲۰۲۴ تا اکتبر ۲۰۲۵ رسیده است. بازه کلی عدم قطعیت در این ارزیابی بین ۱.۳ تا ۳ برابر متغیر است. در برآورد میانی، شرکت Anthropic توانسته است دستاوردهایی را که پیشتر به حدود دو سال زمان نیاز داشتند، تنها در ظرف ۱۲ ماه محقق کند.
شیب نمودار پیشرفت تندتر شده است
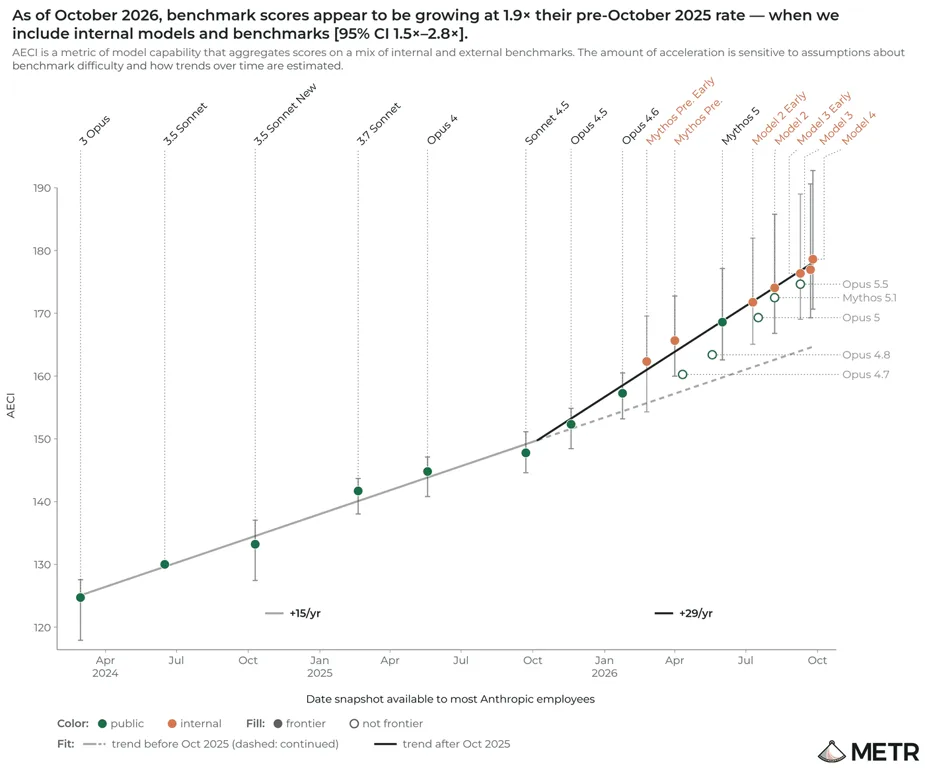
بنچمارک داخلی شرکت Anthropic با نام AECI، شواهد کمی اصلی را برای موسسه METR فراهم کرد. شاخص AECI که نسخه اختصاصی Anthropic از شاخص توانمندیهای موسسه Epoch محسوب میشود، نتایج حاصل از بنچمارکهای متعدد را با هم ترکیب کرده و آنها را به یک امتیاز توانمندی مبتنی بر برآوردهای آماری تبدیل میکند.
یک تحلیل بخشبندیشده نشان داد که امتیازهای شاخص AECI پیش از اکتبر ۲۰۲۵ سالانه حدود ۱۵ واحد رشد داشتند، اما پس از این تاریخ، نرخ رشد به ۲۹ واحد در سال جهش یافته است. این آمار، شتابی معادل ۱.۹ برابر را با بازه اطمینان ۹۵ درصدی بین ۱.۵ تا ۲.۸ برابر نشان میدهد.
نوع تحلیل | شتاب برآوردشده | تفسیر و جزئیات |
|---|---|---|
مدل اصلی شاخص AECI | ۱.۹ برابر | بازه اطمینان ۹۵ درصدی بین ۱.۵ تا ۲.۸ برابر |
مشخصات و روشهای جایگزین | ۱.۱ تا ۲.۹ برابر | زیرمجموعههای متنوع بنچمارک، نسخههای مقطعی مدل، نگاشتهای آماری و کنترلهای ضد بیشبرازش (Overfitting) |
تمام مدلهای پیشرو (Frontier) | حدود ۱.۴ برابر | کاهش عدد بهدلیل عقبماندگی Anthropic از مرز فناوری در اوایل سال ۲۰۲۵ که خط پایه اختصاصی این شرکت را پایین آورده بود |
تحلیلهای جایگزین موسسه METR دامنه وسیعی از اعداد را نشان دادند، اما اکثر آنها همچنان بر وجود شتاب صحه میگذاشتند. همچنین برآورد پایینتر در مقایسه با تمامی مدلهای پیشرو نشان میدهد که بخشی از پیشرفت ثبتشده برای Anthropic، در واقع جبران عقبماندگی و رسیدن به رقبا پس از موقعیت ضعیفتر این شرکت در اوایل سال ۲۰۲۵ بوده است.
ابزارهای هوش مصنوعی عامل اصلی این جهش هستند
موسسه METR تلاش کرد تا سهم عوامل مختلفی همچون توان پردازشی آموزش، دادهها، پیشرفتهای الگوریتمی، جذب نیرو و پژوهشهای مبتنی بر هوش مصنوعی را در ایجاد این شتاب تفکیک کند. برآورد اولیه این تیم نشان میدهد که حدود ۸۰ درصد از شتاب کنونی، حاصل استفاده از ابزارهای هوش مصنوعی است. این تیم همچنین شواهد قانعکنندهای ارائه کرد که نشان میدهد رشد سریعتر در توان پردازشی آموزش، عامل این تغییر نبوده است.
نظرسنجیهای غیررسمی در پیامرسان Slack، یکی از معیارهای سنجش تأثیر هوش مصنوعی بر تکتک کارکنان را فراهم کرد. برای توانمندترین مدل داخلی Anthropic در اکتبر ۲۰۲۶، شرکتکنندگان بهطور میانگین ضریب افزایش بهرهوری حدود ۱۲ برابری را گزارش کردند؛ این در حالی است که این رقم برای مدل Claude 3.7 Sonnet در اوایل سال ۲۰۲۵ تنها حدود ۱.۲ برابر بود.
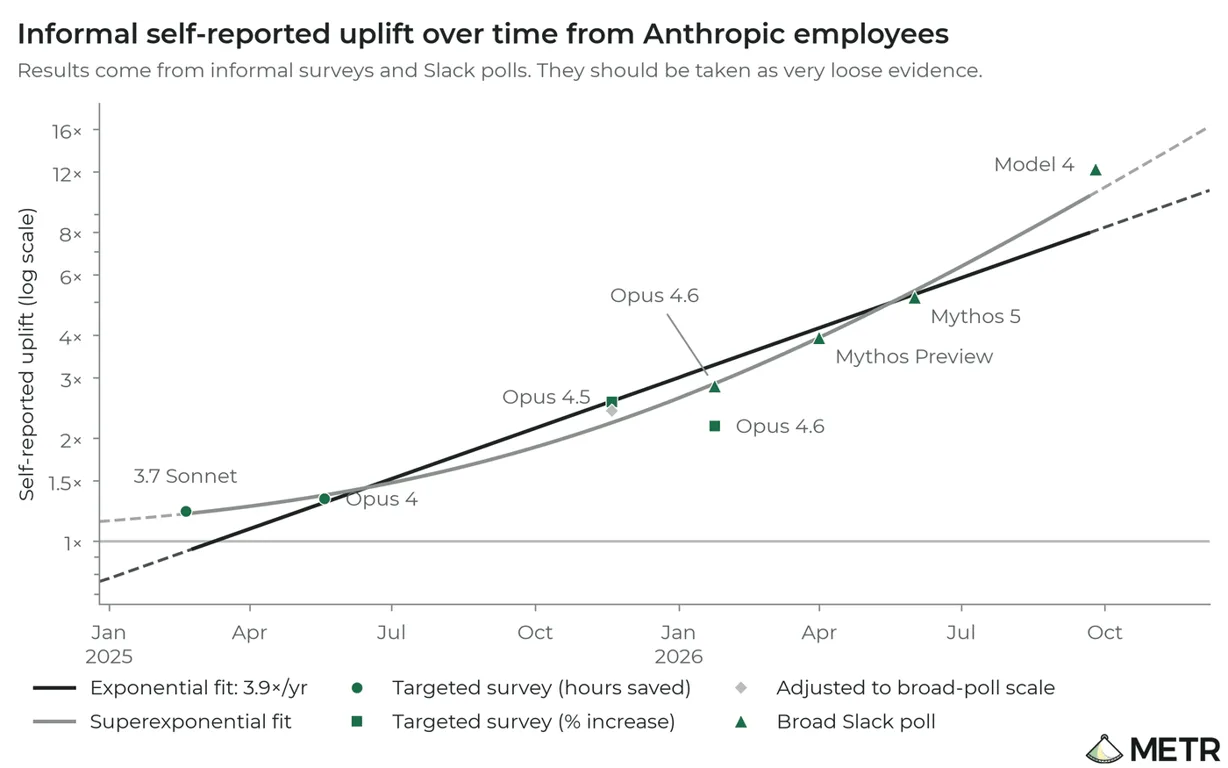
البته این برآوردهای غیررسمی را نمیتوان مستقیماً به شتاب کلی تحقیق و توسعه در سراسر شرکت تعمیم داد. همچنین خوداظهاری افراد میتواند تأثیرات واقعی را بیش از حد نشان دهد؛ کما اینکه مطالعه سال ۲۰۲۵ موسسه METR روی توسعهدهندگان نشان داده بود که ابزارهای هوش مصنوعی در وظایف آزمایششده، در واقع سرعت توسعهدهندگان باتجربه متنباز را کاهش دادهاند.
موسسه METR برای راستیآزمایی این نظرسنجیها، با ۱۵ پژوهشگر شرکت Anthropic مصاحبه کرد و از مدل Claude برای دستهبندی پاسخهای آنها بهره گرفت. دستهبندیهای منتشرشده وضعیت ۱۱ نفر از مصاحبهشوندگان را به شرح زیر مشخص میکند:
- ۲ پژوهشگر بهطور شفاف از افزایش سرعت دستکم ۲ برابری در حوزه کاری خود حمایت کردند.
- ۳ پژوهشگر به تأیید افزایش سرعت دستکم ۲ برابری متمایل بودند.
- ۴ پژوهشگر پاسخهای مرزی یا نامشخص ارائه دادند.
- ۲ پژوهشگر این برآورد را رد کرده و بخش عمده رشد را به جذب نیروی جدید یا عوامل دیگر نسبت دادند.
در این تفکیک منتشرشده، وضعیت چهار مصاحبه نامشخص باقی مانده است. در میان پاسخهایی که موسسه METR به بررسی آنها پرداخت، یک پژوهشگر دستیابی به بیش از دو سال پیشرفت در عرض یک سال را تأیید کرد و حتی سرعت چهار برابری را نیز محتمل دانست. در مقابل، پژوهشگر دیگری تنها ۱۵ تا ۲۰ درصد از این شتاب را به هوش مصنوعی نسبت داد. مصاحبهشوندگان همچنین به مشارکتهای اولیه هوش مصنوعی در کارهای پژوهشی اشاره کردند که میزان بلوغ آن بسته به حوزه تخصصی متفاوت بود؛ با این حال، مشارکتهای پژوهشی کاملاً خودمختار هنوز به یک محرک اصلی تبدیل نشدهاند.
هیچ گلوگاهی برای ۱۲ ماه آینده مشاهده نشد
موسسه METR هیچ مدرکی پیدا نکرد که نشان دهد پیشرفتهای الگوریتمی، توان پردازشی آموزش، توان پردازشی آزمایشها یا دادهها، محدودیت قابلتوجهی را در طول ۱۲ ماه آینده ایجاد خواهند کرد. بنابراین، چرخه بازخورد مستمر میان مدلهای بهتر و پژوهشهای سریعتر میتواند نرخ توسعه را بیش از پیش افزایش دهد. البته موسسه METR در طول این ارزیابی چندین بار دیدگاه خود را درباره گلوگاههای احتمالی بازنگری کرد؛ از این رو، این یافته صرفاً به معنای عدم شناسایی محدودیت در حال حاضر است و یک پیشبینی قطعی محسوب نمیشود.
قویترین شواهد همچنان پنهان ماندهاند
شرکت Anthropic گزارش کامل ۱۰۰ صفحهای موسسه METR را دریافت کرد، اما بخش عمده شواهدی را که METR آنها را آموزندهترین بخشهای گزارش میدانست، سانسور و حذف کرد. این شرکت اعلام کرد که این ویرایشها با هدف حذف اطلاعات محرمانهای انجام شده که میتوانست به سایر توسعهدهندگان هوش مصنوعی در سرعت بخشیدن به کارهایشان کمک کند. مطالب حذفشده شامل برآوردهای دقیق از پیشرفت الگوریتمی، تفکیک سهم هر بخش در خط لوله پژوهش و پیشبینیها درباره مدلهای آینده است که امکان بررسی دقیق و مستقل نتیجهگیریهای اصلی را محدود میکند.
محدودیتهای این برآورد
- شاخص AECI به مرز اشباع نزدیک میشود: مدل موسوم به «Model 4» در این گزارش، در تمامی بنچمارکهای موجود در این شاخص امتیاز بالای ۵۰ درصد را کسب کرده است که این موضوع، توانایی بنچمارک را برای تشخیص پیشرفتهای آینده کاهش میدهد.
- وظایف آزمایششده بیش از حد استاندارد و شفاف هستند: شاخص AECI بر کارهایی تمرکز دارد که دارای پاسخهای قابل راستیآزمایی هستند. عملکرد مدلها در وظایف مبهم و پیچیده در محیطهای عملیاتی واقعی ممکن است مسیر متفاوتی را طی کند.
- دسترسیها با واسطه و نظارت Anthropic انجام شد: تیم METR مجبور بود هنگام کار با دستگاههای شرکت، دادهها را بهصورت موردی درخواست کند و اجازه نداشت مستقیماً از مدلهای منتشرنشده پرسوجو بگیرد. به همین دلیل، این تیم ممکن است سیستمها یا شواهدی را که از وجودشان برای ثبت درخواست بیاطلاع بوده، از دست داده باشد.
- حسابرسی نحوه تخصیص توان پردازشی لغو شد: دامنه اولیه بررسیها شامل بررسی این موضوع بود که Anthropic چگونه توان پردازشی خود را میان بخش ارتقای توانمندیها و بخش ایمنی تقسیم میکند. اما Anthropic پیش از آنکه موسسه METR به نتیجهای برسد، این بخش از پروژه آزمایشی را متوقف کرد.
- بخش بزرگی از تعیین سهم عوامل، مبتنی بر مشاهده است: جذب نیرو، تغییرات سازمانی، انتخابهای پژوهشی و بهکارگیری هوش مصنوعی همگی بهطور همزمان رخ دادهاند و همین امر، تفکیک تأثیرات مجزای هر یک را دشوار میسازد.
فاصله زمانی عرضه مدلهای جدید ممکن است کوتاهتر شود
شرکت Anthropic در سیاست مقیاسپذیری خود، شتاب گرفتن تحقیق و توسعه با محوریت هوش مصنوعی را بهعنوان یک شاخص ریسک کلیدی معرفی کرده است. ارزیابی موسسه METR نخستین بازبینی ساختاریافته بیرونی از شواهد داخلی پشت این شاخص را ارائه میدهد که شامل روششناسی بنچمارک، بازههای عدم قطعیت، نظرسنجی از کارکنان و مصاحبه با پژوهشگران است.
برای توسعهدهندگانی که محصولات خود را بر پایه مدلهای پیشرو میسازند، پیشرفت سریعتر در داخل آزمایشگاهها میتواند عمر مفید ارزیابیهای مختص هر مدل، پرامپتها، فرضیات هزینهای و پیشبینیهای مربوط به توانمندیها را کوتاهتر کند. طبق گزارشها، مدل منتشرنشده «Model 4» شرکت Anthropic از سیستمهای عمومی فعلی این شرکت فراتر رفته و خط لوله تولید مدلهای جدید نیز سرعت گرفته است. با این حال، این ارزیابی نمیتواند با قطعیت مشخص کند که آیا عرضه عمومی مدلها نیز با همین سرعت پیش خواهد رفت یا اینکه آیا پیشرفت در بنچمارکهای قابل راستیآزمایی، به کارهای پیچیده در محیطهای عملیاتی واقعی نیز منتقل خواهد شد یا خیر.
مطالب مرتبط و پیشنهادی
Perplexity از قابلیت Teammates رونمایی کرد؛ همکاران هوش مصنوعی برای انجام خودکار وظایف کاری
شرکت Perplexity با معرفی قابلیت جدیدی به نام Teammates، گام بلندی در مسیر توسعه عاملهای هوشمند برداشته است. این عاملهای هوش مصنوعی میتوانند بهعنوان همکار سازمانی، مسئولیت پروژههای مداوم مانند بررسی خطاها و تحلیل دادهها را بر عهده بگیرند و با پایش پیشدستانه ابزارهایی نظیر Slack، وظایف کاری را پیش ببرند.
رونمایی از بنچمارک Science's Last Exam؛ پیشرفتهترین مدلهای هوش مصنوعی در پژوهش علمی مستقل نمره صفر گرفتند
بنیاد AItonomy از بنچمارک جدیدی به نام Science's Last Exam رونمایی کرده است که توانایی ایجنتهای هوش مصنوعی در انجام صفر تا صد پژوهشهای علمی را در ۹ رشته مختلف میسنجد. در ارزیابیهای اولیه، حتی پیشرفتهترین مدلها نیز نتوانستند یک چرخه کامل پژوهشی را با موفقیت به پایان برسانند.
ابزار متنباز Poki معرفی شد؛ هدایت مستقیم آیفون توسط ایجنتهای هوش مصنوعی بدون نیاز به جیلبریک
پروژه متنباز Poki به ایجنتهای هوش مصنوعی اجازه میدهد تا بدون نیاز به جیلبریک یا سختافزار جانبی، کنترل کامل یک آیفون واقعی را مانند یک کاربر انسانی در دست بگیرند. این ابزار از طریق اتصال به مک و بهرهگیری از پروتکل MCP، اجرای خودکار وظایف میان برنامههای مختلف سیستمعامل iOS را ممکن میسازد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.