خیز بلند مایکروسافت با تراشه Maia 300؛ آیا غولهای ابری حباب سودآوری انویدیا را میترکانند؟
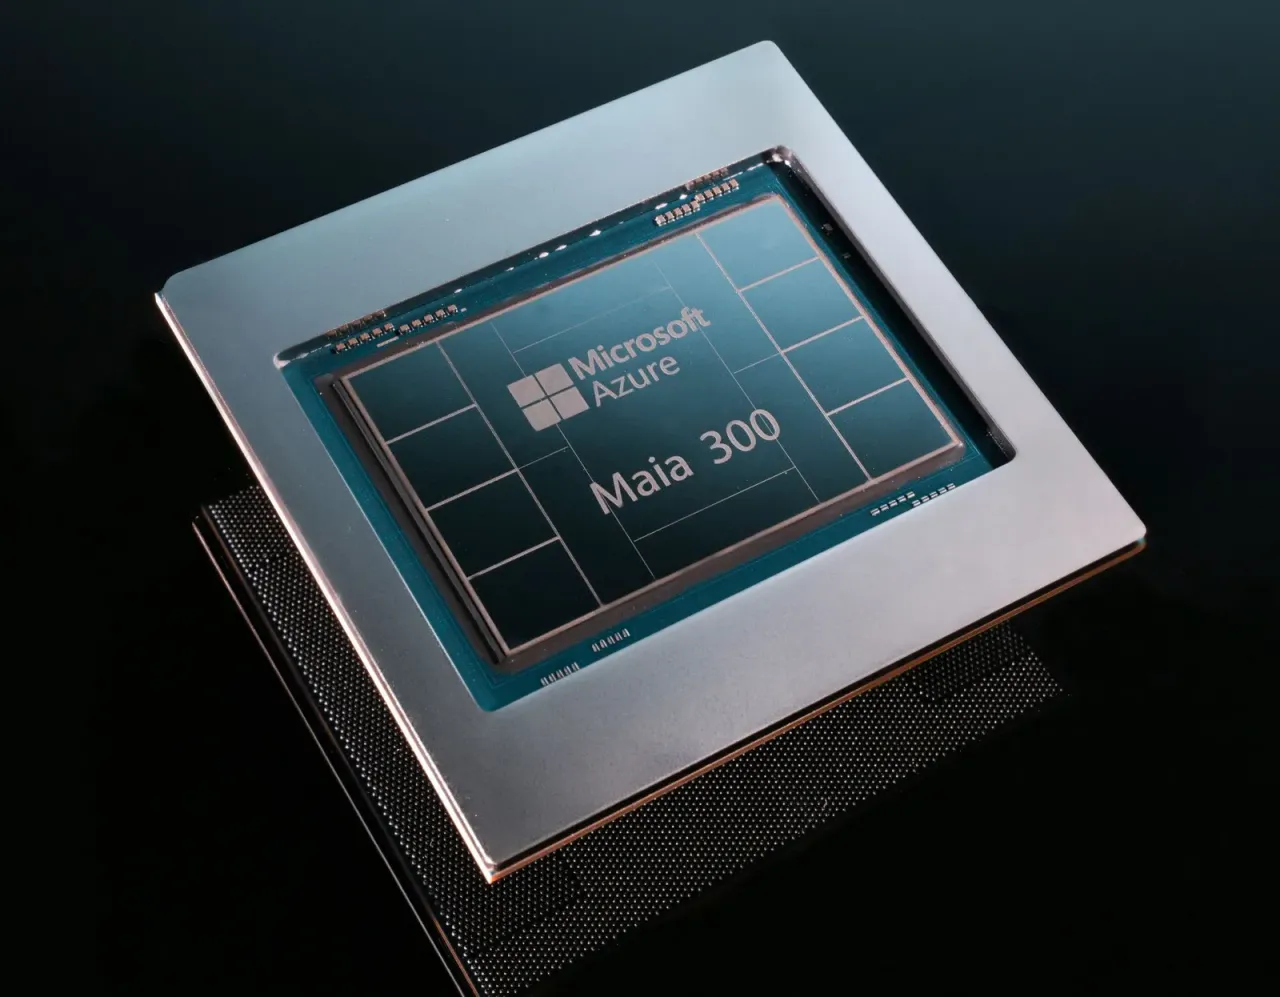
مایکروسافت از نسل جدید تراشه هوش مصنوعی خود به نام Maia 300 رونمایی کرد که با جهش ۲٫۵ برابری پهنای باند حافظه، به موتور اصلی پردازش آژور تبدیل خواهد شد. این اقدام ردموندیها در مسیر استقلال سختافزاری، حاشیه سود افسانهای انویدیا و آینده بازار تراشهها را با تحولی بزرگ روبهرو میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- مایکروسافت قصد دارد از سال ۲۰۲۷ تراشه اختصاصی Maia 300 را به پردازنده اصلی اجرای هوش مصنوعی در دیتاسنترهای چند گیگاواتی آژور تبدیل کند.
- معماری Maia 300 با ارتقای ۲٫۵ برابری پهنای باند حافظه (۱۸ ترابایت بر ثانیه)، تنگنای فاز تولید پاسخ در مدلهای استدلالی و ایجنتها را هدف قرار داده است.
- با خودکفایی غولهای ابری و ساخت تراشههای اختصاصی، حاشیه سود ۷۵ درصدی انویدیا در معرض خطر قرار گرفته، هرچند وابستگی زنجیره تأمین هنوز ادامه دارد.
- مایکروسافت به پیروی از گوگل و آمازون، تراشه اختصاصی Maia را در مقیاس چند گیگاوات به موتور اصلی اجرای هوش مصنوعی خود تبدیل میکند.
- تراشه آینده Maia 300 با اولویت دادن به تنگنای پهنای باند حافظه در فاز پاسخدهی، جهش توان پردازشی را روی ۳۶ درصد نگه داشته اما پهنای باند حافظه را نسبت به Maia 200 تا ۲٫۵ برابر افزایش داده است؛ تولید انبوه این پردازنده از سال ۲۰۲۷ آغاز میشود.
- بیش از نیمی از درآمد دیتاسنتری انویدیا با حاشیه سود ناخالص ۷۵ درصدی از سوی غولهای ابری تأمین میشود؛ بنابراین هر گام به سوی تراشههای اختصاصی، هم قدرت قیمتگذاری این شرکت و هم پایداری کل صنعت تراشه را تحت تأثیر قرار میدهد.
در سال ۲۰۲۴، مایکروسافت به کمیسیون اروپا اعلام کرده بود که گوگل تنها شرکتی است که در تمام لایههای هوش مصنوعی، از تراشهها گرفته تا فروشگاه اپلیکیشن موبایل، یکپارچگی عمودی دارد و «سایر شرکتها برای نوآوری و رقابت ناچارند به همکاریهای تجاری تکیه کنند».
اکنون ردموندیها برنامههای خود را فاش کردهاند تا بدون کوچکترین تردیدی، همان مسیر را در پیش بگیرند.
اسکات گاتری، معاون ارشد بخش ابری و هوش مصنوعی مایکروسافت، در پست رسمی وبلاگ مایکروسافت اعلام کرد که این شرکت از سال ۲۰۲۷ استقرار شتابدهندههای Azure Maia را تا مقیاس چند گیگاوات گسترش خواهد داد و Maia را به سیستم اصلی پردازش استنتاج (تولید پاسخ) برای تمام محصولات و خدمات مایکروسافت تبدیل میکند.
سلاح اصلی مایکروسافت برای این تحول، تراشه Maia 300 است؛ پردازندهای که رانی بورکار، مدیر سیستمها و زیرساختهای سختافزاری آژور، بههمراه سوراب دیگه، از مدیران ارشد برنامهریزی و معماری سیستمها، در یک بررسی عمیق معماری به تشریح جزئیات فنی آن پرداختهاند.
تغذیه پردازندهها بهجای بزرگتر کردن آنها؛ گام برداشتن در مسیر گوگل
این اقدام پیامی مستقیم و معنادار از سوی یکی از بزرگترین مشتریان انویدیا است که درست همزمان با اوجگیری نگرانیها درباره ترکیدن حباب هوش مصنوعی مخابره میشود. مؤسسه تحلیلی گارتنر در پیشبینی اخیر خود اعلام کرد که ارائهدهندگان هوش مصنوعی تنها در سال ۲۰۲۶ نزدیک به ۱ تریلیون دلار صرف توسعه زیرساختها خواهند کرد و درآمدهای حاصل از هوش مصنوعی حداقل تا سال ۲۰۳۲ به نقطهای نخواهد رسید که این هزینههای سنگین را بهشکل سودآور جبران کند.
اگر بزرگترین خریداران سختافزار هوش مصنوعی دیگر حاضر نباشند برای پرتکرارترین وظایف پردازشی خود حاشیههای سود سنگین انویدیا را بپردازند، گرانقیمتترین بخش این سرمایهگذاری زیرساختی آسیبپذیر خواهد شد. با این حال، هنوز نمیتوان با قاطعیت ادعا کرد که آیا Maia 300 همان محرک نهایی برای وقوع چنین تغییری خواهد بود یا خیر.
تراشه Maia 300 برخلاف طراحی تکدای (Single-die) در Maia 200، به سراغ پکیج چندچیپلتی رفته است که در آن، بخش محاسباتی بر پایه لیتوگرافی پیشرفته N2P شرکت TSMC تولید میشود و کنترلر حافظه بههمراه بخشهای ورودی/خروجی (I/O) روی دایهای مجزا قرار گرفتهاند. بر اساس بررسیهای تخصصی منتشرشده از مشخصات این تراشه، هشت پشته حافظه HBM4 در هر شتابدهنده ظرفیتی معادل ۲۸۸ گیگابایت با پهنای باند سرسامآور ۱۸ ترابایت بر ثانیه ارائه میدهند؛ در حالی که این رقم در نسل قبلی (Maia 200) تنها ۲۱۶ گیگابایت با سرعت ۷٫۱ ترابایت بر ثانیه بود.
مایکروسافت توان محاسباتی را فدا نکرده، بلکه تمرکز معماری خود را به شکلی هوشمندانه بر محور حافظه بازتنظیم کرده است. در مرحله تولید توکن (Decode) که فاز اصلی و زمانبر در زنجیرههای طولانی استدلال و حلقههای تصمیمگیری ایجنتها محسوب میشود، شتابدهندهها بیشتر زمان خود را صرف انتظار برای دریافت داده میکنند تا انجام محاسبات ریاضی.
تراشه Maia 300 تلاش میکند این شکاف را با نزدیک نگه داشتن دادهها به واحدهای محاسباتی برطرف کند؛ این کار از طریق چینش غیریکنواخت حافظه در میان چیپلتها، حافظه SRAM روی دای با مدیریت نرمافزاری، و استفاده از فرمتهای عددی فشردهتر مانند نسخه ارتقایافته MXFP4 و فرمتهای ذخیرهسازی کمتر از ۳ بیت بههمراه تبدیل سختافزاری میان آنها انجام میشود. معرفی Maia 300 بر واقعیتی مهر تأیید زد که اهالی صنعت از قبل به آن پی برده بودند: طراحی تراشههای اختصاصی دیگر یک پروژه جانبی برای غولهای ابری نیست.
گوگل، یعنی همان شرکتی که مایکروسافت دو سال پیش به آن اشاره کرده بود، اکنون درآمدزایی از فروش سیستمهای TPU به دیتاسنترهای مشتریان را آغاز کرده است. آنات اشکنازی، مدیر ارشد مالی آلفابت، در گزارش مالی سهماهه دوم به این موضوع اشاره کرد و سوندار پیچای، مدیرعامل گوگل، نیز تأکید داشت که این شرکت «شاهد تقاضای قدرتمندی از سوی مشتریان برای خرید سیستمهای مستقل TPU است».
گوگل تنها بازیگر این میدان نیست؛ شرکت آنتروپیک علاوه بر قرارداد قبلی برای دریافت حداکثر ۱ میلیون تراشه TPU، قراردادی برای تأمین ۳٫۵ گیگاوات ظرفیت TPU تا سال ۲۰۲۷ از طریق برودکام امضا کرده است و گزارشها نشان میدهد متا نیز از سال ۲۰۲۵ مذاکراتی را برای اجاره و خرید این تراشهها آغاز کرده بود. آمازون نیز رویکرد مشابهی را پیش گرفته است؛ اندی جسی، مدیرعامل آمازون، در اظهارات خود در آوریل ۲۰۲۶ اعلام کرد که کسبوکار تراشههای این شرکت شامل Trainium، Graviton و Nitro از مرز درآمد سالانه ۲۰ میلیارد دلار فراتر رفته و اکنون به «یکی از سه کسبوکار برتر تراشههای دیتاسنتر در جهان» تبدیل شده است. همزمان، اوپنایآی نیز از شتابدهنده اختصاصی خود به نام Jalapeño رونمایی کرده است.
حاشیه سود انویدیا؛ جام مقدس دنیای هوش مصنوعی؟
انگیزه غولهای فناوری از گزارشهای مالی خودِ انویدیا کاملاً مشخص است. این شرکت در سهماهه منتهی به ژوئیه ۲۰۲۶، درآمدی معادل ۹۶٫۲ میلیارد دلار ثبت کرد که ۸۹ میلیارد دلار آن مستقیماً از بخش دیتاسنتر و با حاشیه سود ناخالص خیرهکننده ۷۵ درصدی به دست آمده بود. کولت کرس، مدیر ارشد مالی انویدیا، در نشست گزارش مالی سهم غولهای ابری را ۴۹ میلیارد دلار اعلام کرد؛ این یعنی بیش از نیمی از درآمدهای دیتاسنتری انویدیا تنها از سوی گروه کوچکی از خریداران تأمین میشود که اتفاقاً بزرگترین آنها اکنون در حال طراحی شتابدهندههای اختصاصی خود هستند.
هر بار کاریِ استنتاج که به پردازندههای داخلی منتقل میشود، به این معنا است که خریدار بهجای پرداخت سود هنگفت انویدیا، هزینهای نزدیک به قیمت تمامشده ساخت تراشه را میپردازد. مایکروسافت در ژوئیه به سرمایهگذاران خود اعلام کرد که هزینه عملیاتی Maia 200 برای اجرای مدلهای اوپنایآی و مایکروسافت تا ۴۰ درصد ارزانتر از جدیدترین تراشههای انویدیا بوده است.
با این حال، مایکروسافت مشخص نکرد که منظورش از «سیستم پیشروی مبتنی بر پردازنده گرافیکی» دقیقاً کدام مدل از پردازندههای انویدیا بوده است؛ نکتهای بسیار حائز اهمیت، بهویژه با توجه به تمرکز شدید انویدیا بر ارتقای بهرهوری در تراشههای Vera Rubin، که اوپنایآی حتی از مقایسه مستقیم مدلهای خود با آن خودداری کرده بود.
این رونمایی تأثیر چشمگیری بر بازار سهام نگذاشت؛ در معاملات روز دوشنبه، ارزش سهام انویدیا ۱٫۲۹ درصد افت کرد و سهام مایکروسافت ۱٫۱۴ درصد افزایش یافت. عدم شفافیت مایکروسافت درباره جزئیات دقیق این بهبود بهرهوری میتواند یکی از دلایل این واکنش محتاطانه بازار باشد.
دلیل دیگر نیز به همان اندازه مهم است: بر اساس تحلیل کارشناسان مؤسسه اورکور آیاسآی (Evercore ISI)، انتظار میرود تراشه Maia تا سهماهه نخست سال ۲۰۲۷ تنها حدود ۱۰ درصد از کل هزینههای مایکروسافت برای خرید تراشههای هوش مصنوعی را به خود اختصاص دهد؛ در حالی که انویدیا درآمد سهماهه جاری خود را ۱۰۸ میلیارد دلار پیشبینی کرده است.
علاوه بر این، مقیاس تولید و پیادهسازی همچنان یک چالش ادامهدار است؛ با مصرف ۱۶۷ کیلووات به ازای هر رک، دستیابی به توان ۱ گیگاوات به حدود ۶۰۰۰ رک سرور Maia 300 یا نزدیک به ۵۷۵۰۰۰ شتابدهنده نیاز دارد؛ آن هم بدون احتساب مصرف برق سیستمهای خنککننده و زیرساخت دیتاسنتر.
از سوی دیگر، حرکت در مسیر گوگل به معنای توقف خرید از انویدیا نبوده است. آمازون علیرغم حضور در جمع «سه کسبوکار برتر تراشه»، همچنان قصد دارد تا اواسط سال ۲۰۲۸ بیش از ۳ میلیون پردازنده گرافیکی از انویدیا تحویل بگیرد.
آلفابت نیز که اکنون پردازندههای TPU خود را به دیگران عرضه میکند، در ماه ژوئیه پیشبینی مخارج سرمایهای (Capex) سال ۲۰۲۶ خود را به ۱۹۵ تا ۲۰۵ میلیارد دلار افزایش داد. این شرکت در کنار TPUها، پردازندههای Vera Rubin انویدیا را نیز در سبد خود دارد و مدیر ارشد مالی آن تأکید کرده که آلفابت «همچنان با محدودیتهای عرضه در بازار روبهرو است».
مایکروسافت نیز برای آموزش مدلها همچنان به تراشههای انویدیا و AMD متکی است و ساتیا نادلا، مدیرعامل مایکروسافت، در اوایل سال ۲۰۲۶ صراحتاً گفت: «اینکه توانایی یکپارچهسازی عمودی را داریم، به این معنا نیست که صرفاً و منحصراً بهشکل عمودی عمل خواهیم کرد».
پاسخ جنسن هوانگ، مدیرعامل انویدیا، به پرسشی درباره تراشههای سفارشی در نشست مالی ماه اوت، گویی مستقیماً درباره Maia نوشته شده بود: «در حالی که بسیاری از این تراشهها (XPU) صرفاً پردازندههایی مخصوص استنتاج برای یک فضای ابری یا یک سرویس خاص هستند، انویدیا یک پلتفرم کامل است». با این حال، شرطبندی متقابل مایکروسافت نگاه متفاوتی دارد: یک زیرساخت ابری بهتنهایی آنقدر بزرگ هست که توجیه اقتصادی داشته باشد.
چالش بنیادین فرضیه «ترکیدن حباب با تراشههای اختصاصی» این است که تراشههای سفارشی تنها دریافتکننده سود را تغییر میدهند، نه کل هزینههایی را که باید صرف شود. مؤسسه گارتنر هشدار میدهد که صنعت هوش مصنوعی در سالهای ۲۰۲۶ تا ۲۰۳۰ برای بازگشت منطقی سرمایهگذاریهای خود به حدود ۸٫۵ تریلیون دلار درآمد نیاز دارد، در حالی که پیشبینی میشود این فناوری حداکثر ۳٫۶ تریلیون دلار درآمد تولید کند. مایکروسافت نیز در واکنش به این وضعیت، سرمایهگذاریهای خود را کاهش نداده، بلکه در حال برنامهریزی برای افزودن گیگاواتها ظرفیت تازه است؛ اقدامی که با ارزانتر کردن هزینه تولید هر توکن، میتواند بهجای تعمیق شکاف مالی، به پر کردن آن کمک کند.
بخشی از صرفهجویی مالی مایکروسافت نیز در نهایت به بخشهای دیگر زنجیره تأمین سرازیر خواهد شد. برگ برنده Maia 300 اتکا به حافظههای پرتقاضای HBM4 است؛ همان حافظهای که انویدیا در تراشههای Rubin با ظرفیت مشابه ۲۸۸ گیگابایت در هر پکیج استفاده میکند. دایهای پردازشی این تراشه نیز توسط شرکت TSMC تولید میشوند که تأمینکننده قطعات برای تمام غولهای دنیای فناوری است.
تراشههای TPU گوگل بر اساس یک قرارداد بلندمدت با شرکت برودکام توسعه یافته و تولید میشوند؛ شرکتی که مدیرعامل آن، هاک تان، معتقد است «بسیاری از سرمایهگذاران هوش مصنوعی هنوز درک درستی از ماهیت سرمایهگذاری خود ندارند» و پیشبینی میکند کمبود تراشه تنها حوالی سالهای ۲۰۲۸ یا ۲۰۲۹ فروکش خواهد کرد. از طرف دیگر، انویدیا نیز دست روی دست نگذاشته است؛ این شرکت پیشتر ۲۰ میلیارد دلار برای دریافت مجوز فناوری دیکود مبتنی بر حافظه SRAM از شرکت Groq پرداخت کرده بود؛ نشانهای آشکار از اینکه انویدیا نیز خطر رقابت در بازار استنتاج را از مدتها قبل حس کرده است.
تا زمانی که نسخه نهایی این تراشه به مرحله تولید انبوه نرسد و مراجع مستقل خارج از مایکروسافت نتوانند عملکرد آن را ارزیابی کنند، Maia 300 صرفاً یک معماری روی کاغذ با توجیه فنی بسیار قوی است که کلیدیترین ارقام و ادعاهای مربوط به آن هنوز در انحصار ردموندیها قرار دارد. با تمام این تفاسیر، یک واقعیت غیرقابل انکار است: بزرگترین خطر برای سودآوری افسانهای انویدیا، نه رقبای سنتی، بلکه شاید وفادارترین و بزرگترین مشتریان این غول سختافزاری باشند.
مطالب مرتبط و پیشنهادی
اجرای مدلهای زبانی روی پلیاستیشن ۵؛ فریمورک llama.cpp به کنسول جیلبریکشده سونی آمد
توسعهدهندهای با پورت کردن فریمورک محبوب llama.cpp روی پلیاستیشن ۵ جیلبریکشده، امکان اجرای مدلهای هوش مصنوعی را روی پردازنده این کنسول فراهم کرد. در آزمایشهای اولیه، مدل سبک Qwen3.5 با موفقیت اجرا شده، اما محدودیت ۶ گیگابایتی حافظه در دسترس، چالش اصلی در اجرای مدلهای بزرگتر است.
گزارش جدید آنتروپیک از تحول محیط کار؛ کاهش چشمگیر استخدام نیروهای تازهکار و افزایش زمان جلسات
گزارش جدید آنتروپیک نشان میدهد ادغام عمیق هوش مصنوعی الگوهای کاری این شرکت را بهکلی دگرگون کرده است. سهم نیروهای تازهکار در تیمهای فنی با افتی محسوس روبهرو شده، درحالیکه کارمندان اکنون زمان بیشتری را در جلسات هماهنگی سپری میکنند.
بنچمارک ۱۳۲۹ ساعته Synth-DoPaCo معرفی شد؛ شبیهسازی مکالمات واقعی پزشک و بیمار برای هوش مصنوعی
پژوهشگران با توسعه مجموعهداده متنباز Synth-DoPaCo شامل بیش از ۱۳۰۰ ساعت مکالمه صوتی شبیهسازیشده میان پزشک و بیمار، چالش بزرگ کمبود دادههای طولانی در هوش مصنوعی پزشکی را برطرف کردند. این بنچمارک با بازسازی ۸۸۰۰ ویزیت بالینی کامل، بستری استاندارد برای ارزیابی دقیق مدلهای زبانی صوتی بدون نقض حریم خصوصی بیماران فراهم میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.