تربیت معلمان هوش مصنوعی با دانشآموزان شبیهسازیشده؛ شاهکار جدید مایکروسافت با سیستم StudentSim
بخش تحقیقات مایکروسافت از سیستم خلاقانه StudentSim رونمایی کرده است؛ ابزاری پیشرفته که رفتار و اشتباهات تکتک دانشآموزان را به شکل واقعگرایانه شبیهسازی میکند تا معلمان هوش مصنوعی بهتر آموزش ببینند. این سیستم نوین به توسعهدهندگان اجازه میدهد بدون نیاز به تستهای زمانبر و پرهزینه انسانی، بازخورد و راهنماییهای رباتهای آموزشی را با دقت بالا بسنجند و بهینهسازی کنند. نتایج اولیه این پروژه نشان میدهد عملکرد معلمان هوش مصنوعی آموزشدیده با این روش، تا ۱۵ درصد از مدلهای متداول یادگیری نظارتی بهتر است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- شبیهسازی هوشمندانه دانشآموزان برای آموزش معلمان مجازی: مایکروسافت ریسرچ با معرفی StudentSim راهکاری خلاقانه ارائه کرده تا به جای تستهای کند و گرانقیمت روی دانشآموزان واقعی، رفتار و نقاط ضعف اختصاصی یادگیرندهها را دقیق شبیهسازی کند و در اختیار مدلهای هوش مصنوعی معلم بگذارد.
- ردپای روانشناسی و ارزیابی بر اساس منطقه تقریبی رشد: این سیستم بر پایه مفهوم شناختهشده لِو ویگوتسکی سنجیده میشود؛ جایی که هم وفاداری رفتاری شبیهساز به الگوهای دانشآموز و هم میزان پاسخگویی او به راهنماییهای معلم ملاک ارزیابی قرار میگیرد.
- ارتقای چشمگیر عملکرد معلمان در یادگیری تقویتی: در آزمایشهای هدایت شطرنج، معلم هوش مصنوعی که با فیدبکهای StudentSim و یادگیری تقویتی آموزش دید، به دقت ۹۰.۵ درصدی رسید و روشهای نظارتی سنتی را با اختلاف حدود ۱۵ درصدی پشت سر گذاشت.
سیستم StudentSim؛ وقتی هوش مصنوعی برای خودش دانشآموز شبیهسازی میکند
بخش تحقیقات مایکروسافت (Microsoft Research) از سیستم جدیدی به نام StudentSim رونمایی کرده است؛ ابزاری هوشمند که نسخههای شبیهسازیشده و کاملاً شخصیسازیشدهای از دانشآموزان واقعی میسازد. به لطف این شبیهسازها، مدلهای معلم هوش مصنوعی میتوانند بدون معطلی برای ارزیابیهای زمانبر روی دانشآموزان واقعی، بازخوردهای سریع و مداوم دریافت کنند و مهارتهای تدریس خود را ارتقا دهند. مایکروسافت کدهای این پروژه و بنچمارک ارزیابی آن را بهصورت عمومی در یک مخزن گیتهاب منتشر کرده است.
سامانه StudentSim دست روی یکی از گلوگاههای همیشگی در توسعه هوش مصنوعی آموزشی گذاشته است. در واقعیت، برای اینکه بفهمیم آیا یک راهنمایی یا سرنخ درسی واقعاً به یادگیری دانشآموز کمک کرده یا نه، باید واکنش او را ببینیم؛ اما انجام تستهای انسانی و مطالعات میدانی برای هر بار بهروزرسانی مدل، فرآیندی فوقالعاده گران و زمانبر است. این سیستم یک محیط آزمایشی پایدار و تکرارپذیر فراهم میکند تا توسعهدهندگان بتوانند سیاستهای آموزشی و کیفیت راهنماییهای معلم را قبل از تست روی انسانها، با دقت بسنجند.
البته این پروژه هنوز در فاز اولیه و یک نمونه اولیه تحقیقاتیِ پیش از استقرار به حساب میآید. شواهد و دادههای منتشرشده از بنچمارکهای آفلاین و یک آزمایش تدریس شطرنج استخراج شدهاند و هنوز خبری از پیادهسازی عملی آن در کلاسهای درس واقعی نیست؛ بنابراین اعتبارسنجی نهایی همچنان به بررسی معلمان، مطالعات میدانی روی دانشآموزان و سنجش دستاوردهای آموزشی وابسته خواهد بود.
چرا نقشآفرینیهای کلیشهای معلمان هوش مصنوعی را به اشتباه میاندازد؟
اگر به یک مدل زبانی همهمنظوره پرامپت بدهید و از آن بخواهید ادای یک دانشآموز کلاس پنجمی ضعیف را درآورد، مدل شاید لحن حرف زدن یک کودک را خوب تقلید کند، اما دانش پیشرفته و قدرت استدلال خود را حفظ میکند! در نتیجه، به نظر میرسد معلم هوش مصنوعی عملکرد فوقالعادهای دارد، چرا که دانشآموز شبیهسازیشده مسائلی را حل میکند که یک کودک در دنیای واقعی قطعاً در حل آنها درمیماند و این موضوع توسعهدهندگان را کاملاً گمراه میکند.
از طرف دیگر، مدلهای سنتی ردیابی دانش (Knowledge-Tracing) هم گوشه دیگری از این ماجرا را هدف قرار میدهند. آنها با تکیه بر سابقه پاسخها و برچسبهای درستی و نادرستی ارزیابی میکنند که دانشآموز چه مطالبی را یاد گرفته است. با این حال، سرنخها و راهنماییهای سقراطی به زبان طبیعی معمولاً در قالب ورودیهای ساختاریافته و خشک این مدلها جا نمیگیرند و در نتیجه نمیتوانند نحوه پاسخ یادگیرنده به راهنماییهای کلامی را مدلسازی کنند.
یک شبیهساز دانشآموز دقیقاً چه وظایفی دارد؟
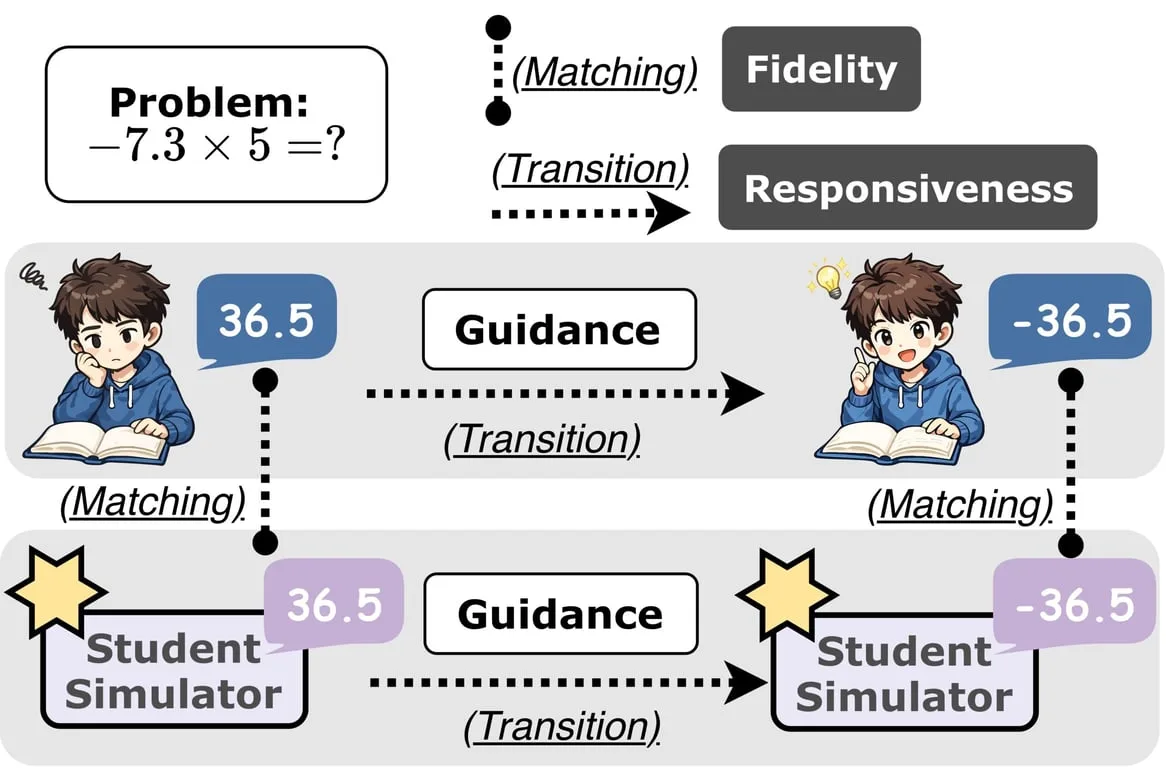
سیستم StudentSim شبیهسازی دانشآموزان را بر اساس دو معیار کلیدی میسنجد که از مفهوم «منطقه تقریبی رشد» (Zone of Proximal Development) مطرحشده توسط روانشناس مشهور، لِو ویگوتسکی (Lev Vygotsky) الهام گرفته شده است؛ مفهومی که فاصله میان عملکرد مستقل فرد و عملکرد او با دریافت راهنمایی را نشان میدهد:
- وفاداری رفتاری (Behavioral fidelity): این معیار ارزیابی میکند که پاسخهای شبیهساز تا چه اندازه به پاسخهای ثبتشده یک دانشآموز مشخص در مسائل دستنخورده و دیدهنشده شباهت دارد.
- پاسخگویی به راهنمایی (Guidance responsiveness): این سنجه مشخص میکند که آیا شبیهساز بعد از دریافت راهنمایی و سرنخ از معلم، پاسخ خود را تغییر داده و اصلاح میکند یا خیر.
معیار وفاداری باعث میشود شبیهسازهایی که مثل متخصصان همهچیزدان رفتار میکنند کنار گذاشته شوند؛ در حالی که معیار پاسخگویی، مدلهای بیتفاوت و ثابتی را که به راهنمایی معلم اهمیتی نمیدهند فیلتر میکند. البته همراهی و موافقت افراطی هم یک حالت شکست محسوب میشود؛ چون اگر شبیهساز هر پیشنهاد معلم را چشمبسته بپذیرد، دیگر بیانگر نقاط ضعف واقعی دانشآموز نخواهد بود. به همین دلیل این دو شاخص باید حتماً در کنار هم ارزیابی شوند.
شخصیسازی دقیق حتی با دادههای محدود
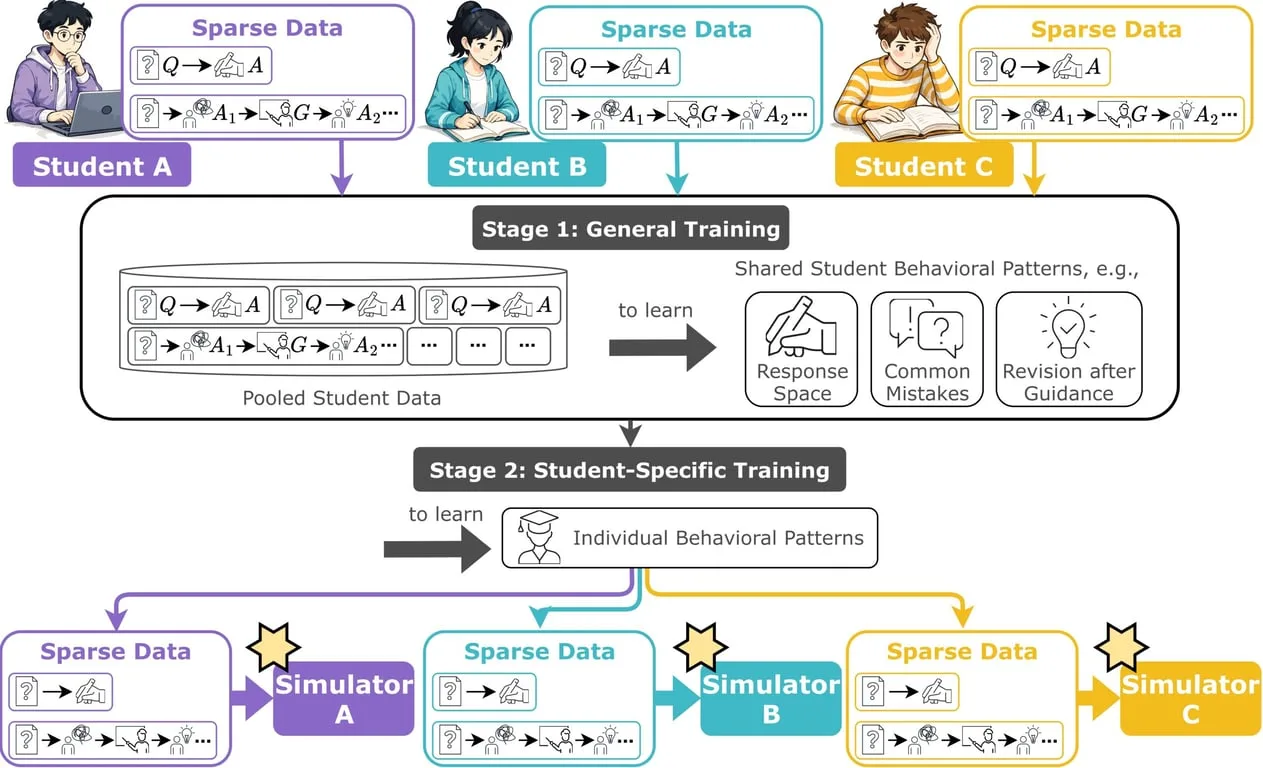
هر دانشآموز معمولاً فقط تعداد انگشتشماری مقاله، حرکت شطرنج یا تلاش برای حل مسأله در سابقه خود دارد و همین دادههای اندک میتواند مدل شخصیسازیشده را مستعد بیشبرازش (Overfitting) کند. برای حل این مشکل، StudentSim از یک فرآیند آموزش دومرحلهای بهره میبرد تا ابتدا الگوهای کلی را استخراج کرده و سپس آنها را برای یک یادگیرنده خاص شخصیسازی کند:
- آموزش در سطح حوزه (Domain training): در این گام، مدل ساختارهای رایج پاسخ، خطاهای متداول و نحوه اصلاح آنها را از روی مجموعه دادههای تجمیعشده از دانشآموزان مختلف در همان درس یاد میگیرد.
- شخصیسازی برای یادگیرنده (Learner personalization): در گام بعد، مدل حوزه روی دادههای اختصاصی یک دانشآموز خاص فاینتیون میشود تا رفتارهای تکرارشونده و الگوهای ویژه او را شبیهسازی کند.
این بنچمارک از مجموعهدادههای عمومی و بدون مشخصات هویتی که برای تحقیقات منتشر شدهاند استفاده میکند. سه حوزه مختلف این آزمون نیازمند خروجیهای متفاوتی هستند:
- شطرنج: پیشبینی حرکت بعدی بازیکن و چگونگی تغییر آن حرکت بعد از دریافت راهنمایی و مربیگری.
- نگارش زبان انگلیسی: تولید انشاهایی که حاوی الگوهای خطای همان زبانآموز باشد و پیشبینی نحوه بازنویسی متن پس از دریافت فیدبک.
- ریاضیات: پیشبینی پاسخهای چندگزینهای و ارزیابی اینکه آیا دانشآموز پس از خواندن توضیحات تشریحی، پاسخ خود را تصحیح میکند یا خیر.
بازی شطرنج؛ جایی که تفاوت مدلها عیان میشود
مایکروسافت عملکرد StudentSim را با مدل GPT-5.4 (از طریق پرامپتنویسی) و همچنین مدل Maia2 (یک مدل شطرنج اختصاصی که برای پیشبینی حرکات انسان طراحی شده) مقایسه کرد. ارقام بالاتر نشاندهنده عملکرد بهتر در هر یک از معیارهای گزارششده است.
مدل | وفاداری رفتاری (Fidelity) | پاسخگویی به راهنمایی (Responsiveness) |
|---|---|---|
StudentSim | ۰.۵۱۵۰ | ۰.۹۰۶۷ |
GPT-5.4 (با پرامپت) | ۰.۲۳۱۶ | ۰.۷۱۸۶ |
Maia2 | ۰.۴۵۳۵ | ۰.۲۷۲۱ |
مدل GPT-5.4 با وجود اینکه به راهنماییها پاسخ میداد، اما در تطابق با سبک بازی دانشآموز هدف قابلیت اطمینان پایینی داشت. از سوی دیگر، مدل Maia2 رفتار شطرنج انسانی را دقیقتر از GPT-5.4 بازتولید کرد، اما واکنش بسیار محدودی به راهنماییهای کلامی به زبان طبیعی نشان داد. در این بنچمارک، سیستم StudentSim بالاترین امتیاز ثبتشده را در هر دو شاخص به نام خود ثبت کرد و قدرت واقعیاش را نشان داد.
تبدیل بازخورد دانشآموز به پاداش در یادگیری تقویتی
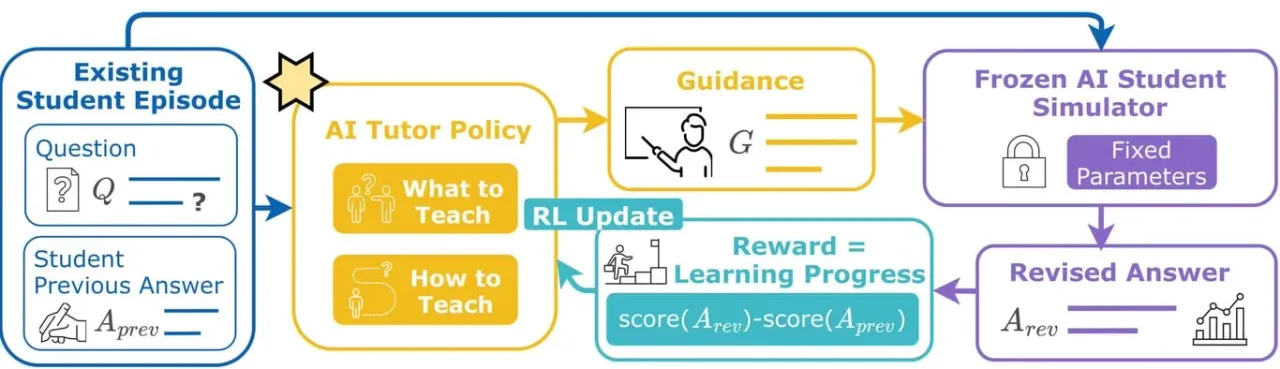
مایکروسافت در مرحله بعد آزمایش کرد که آیا این شبیهساز میتواند سیگنال پاداش موثری برای الگوریتمهای یادگیری تقویتی (RL) فراهم کند یا خیر. در این ساختار، پاداشها معلم را بهگونهای آپدیت میکنند که راهنماییهایش به بهبود واقعی نتایج دانشآموز شبیهسازیشده ختم شود:
- معلم موقعیت مهرهها در صفحه شطرنج و حرکت اشتباه قبلی یک دانشآموز واقعی را دریافت میکند.
- معلم یک راهنمایی به زبان طبیعی برای حل مسأله تولید میکند.
- سیستم StudentSim راهنمایی را میخواند و یک حرکت اصلاحشده ارائه میدهد.
- موتور شطرنج استاکفیش (Stockfish) میزان بهبود کیفیت حرکت را ارزیابی کرده و پاداش معلم را تعیین میکند.
وزنهای StudentSim در این فرآیند ثابت و دستنخورده (Frozen) باقی میمانند تا دانشآموز شبیهسازیشده پایدار بماند و فقط معلم دستخوش تغییر و بهبود شود. پژوهشگران عملکرد سه رویکرد را با هم مقایسه کردند: یک معلم سنتی آموزشدیده با دادههای برچسبدار (نظارتی)، یک معلم یادگیری تقویتی با شبیهساز GPT-5.4، و یک معلم یادگیری تقویتی با شبیهساز StudentSim.
روش آموزش معلم هوش مصنوعی | دقت (Accuracy) |
|---|---|
یادگیری تقویتی با StudentSim | ۹۰.۵٪ |
پایه نظارتی سنتی (بدون یادگیری تقویتی) | ۷۵.۷٪ |
یادگیری تقویتی با GPT-5.4 | ۷۱.۶٪ |
اساتید و کارشناسان شطرنج خروجیها را بدون اینکه بدانند کدام مدل با چه روشی آموزش دیده است داوری کردند. نتایج فوقالعاده بود: معلمی که با همراهی StudentSim آموزش دیده بود، معیار پایه نظارتی را با اختلاف چشمگیر ۱۴.۸ درصدی پشت سر گذاشت! جالبتر اینکه مدل مجهز به GPT-5.4 حتی ۴.۱ درصد ضعیفتر از روش سنتی ظاهر شد؛ موضوعی که نشان میدهد یک مدل عمومی توانمند اگر نتواند جامعه مخاطب یادگیرندگان را به درستی نمایندگی کند، پاداش تقریبی بسیار ضعیفی تولید خواهد کرد.
محدودیتها و چالشهایی که توسعهدهندگان باید جدی بگیرند
اگرچه شواهد فعلی موفقیت سیستم را در آزمایشهای کنترلشده تایید میکنند، اما برای پیادهسازی گسترده در دنیای واقعی چند ابهام و مانع جدی وجود دارد:
- اعتبار در کلاس درس: وفاداری در تستهای آفلاین و نظرات کارشناسان، مسائلی مثل میزان یادگیری بلندمدت، انگیزه دانشآموز یا پویایی کلاس درس را منعکس نمیکند.
- تنوع بنچمارکها: با اینکه بنچمارک سه حوزه را پوشش داده، اما ارزیابی یادگیری تقویتی فعلاً فقط روی بازی شطرنج متمرکز بوده است.
- ماندگاری یادگیری: شاخص پاسخگویی فقط اصلاح فوری حرکت یا پاسخ را میسنجد؛ تثبیت یادگیری و انتقال آن به مهارتهای دیگر نیازمند ارزیابیهای زمانبر در طول زمان است.
- دور زدن پاداش (Reward Exploitation): ممکن است معلم یاد بگیرد رفتارهای قابلپیشبینی شبیهساز را دور بزند؛ بنابراین پیشرفتهای حاصلشده باید حتماً با دانشآموزان واقعی راستیآزمایی شود.
- مسأله شروع سرد (Cold Start): شخصیسازی مدل به تاریخچه و سوابق دانشآموز بستگی دارد؛ بنابراین برای دانشآموزانی با سابقه کم یا بدون سابقه، دادههای قابلاتکایی وجود ندارد.
- حریم خصوصی و حاکمیت داده: ذخیره سوابق هر کاربر نیازمند رضایت، تدابیر امنیتی، کنترل دسترسی و آزمودن سیستم برای عدم حفظ ناخواسته دادههای حساس است.
- هزینههای عملیاتی: فاینتیون و نگهداری مدلهای جداگانه برای تکتک دانشآموزان در مقیاس کلاس یا کل پلتفرم، بار مالی و پردازشی سنگینی به همراه خواهد داشت.
این الگوی هوشمند به کدام حوزهها سرایت خواهد کرد؟
سیستم StudentSim یک الگوی نوین برای آزمون مبتنی بر مدل در سیستمهای تطبیقپذیر ارائه میدهد: آموزش یک شبیهساز مشترک روی دادههای تعاملی تجمیعشده، شخصیسازی آن برای یک کاربر یا گروه خاص، اعتبارسنجی واکنشهای آن به مداخلات آموزشی، و در نهایت استفاده از آن به عنوان یک محیط ایزوله (سندباکس) یا منبع تولید پاداش. ابزارهای مربیگری، ایجنتهای پشتیبانی و سیستمهای پیشنهاددهنده میتوانند با داشتن تاریخچه تعاملات و نتایج قابلاندازهگیری، همین رویکرد را پیادهسازی کنند.
تیمهایی که قصد دارند این الگو را به کار بگیرند، ابتدا باید رفتارهای هدف را دقیق مشخص کنند، دادههای آموزشی را از دادههای ارزیابی جدا نگه دارند، واکنشها به انواع راهنماییها را بسنجند و مراقب سوءاستفاده مدل از پاداش باشند. جزئیات دقیقتر این پژوهش در مقاله علمی مایکروسافت در دسترس است و کدهای آن به همراه بنچمارک در مخزن پروژه منتشر شدهاند.
مطالب مرتبط و پیشنهادی
بایتدنس دستبهکار شد؛ راهاندازی واحد اختصاصی ایمنی و همراستاسازی در آزمایشگاه هوش مصنوعی Seed
آزمایشگاه هوش مصنوعی بایتدنس دپارتمان جدید و مستقلی را برای نظارت بر ایمنی و همراستاسازی مدلهای خود راهاندازی کرده است. این واحد ویژه قرار است با تدوین استانداردها و سیستمهای حفاظتی، مانع از بروز خطرات احتمالی در مدلهای پیشرفته شود و عملکرد ایجنتها را کاملاً در مسیر اهداف انسانی هدایت کند.
خیز بلند ایکسپنگ برای عرضه ربات انساننمای IRON در سال ۲۰۲۷: آغاز تولید انبوه و برنامه فتح اروپا
کمپانی چینی ایکسپنگ (XPENG) رسماً اعلام کرد که تولید انبوه ربات انساننمای پیشرفته خود به نام IRON را تا پایان سال ۲۰۲۶ کلید میزند و تحویل تجاری آن را در نیمه نخست ۲۰۲۷ آغاز خواهد کرد. این غول خودروسازی و فناوری همچنین قصد دارد در نیمه دوم همان سال پای این ربات هوشمند را به بازارهای اروپایی باز کند. این گام بلند نشاندهنده ورود جدی ایکسپنگ به عصر هوش تجسدیافته و رقابت مستقیم با بزرگان حوزه رباتیک جهان است.
رسوایی هوش مصنوعی در وزارت کشور بریتانیا: از هر ۵ خلاصه پرونده پناهندگی، یکی غلط از آب درآمد!
گزارش جدید نهادهای حقوق دیجیتال نشان میدهد سیستم هوش مصنوعی وزارت کشور بریتانیا در خلاصهسازی پروندههای پناهندگی با نرخ خطای ۲۲ درصدی مواجه شده است. این ابزارها مبتنی بر مدل GPT-4o هستند و نهتنها موجب کندتر شدن روند رسیدگی شدهاند، بلکه نادیده گرفتن جزئیات حیاتی افراد را به همراه داشتهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.