فریمورک SIFT از دانشگاه MIT و Sakana AI؛ روشی هوشمندانه برای کاهش شدید هزینههای ارزیابی ایجنتهای کدنویس
محققان دانشگاه MIT و شرکت Sakana AI فریمورک جدیدی به نام SIFT معرفی کردهاند که هزینههای سنگین تست و ارزیابی ایجنتهای کدنویسی را به طرز چشمگیری کاهش میدهد. این سیستم با بهرهگیری از داوری مدلهای زبانی و جستجوی درختی ناهمگام، ارزیابی هوشمندانهتر و ارزانتری فراهم کرده و به دقت ۳۵.۱ درصدی در بنچمارک Polyglot رسیده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک SIFT با ترکیب داوری مدلهای زبانی (LLM-as-a-judge) و جستجوی درختی، به جای اجرای بنچمارکهای گرانقیمت برای تکتک تغییرات، کاندیداهای برتر ایجنتهای کدنویس را با هزینه بسیار کمتری رتبهبندی میکند.
- این سیستم با اجرای موازی تولید پچ، داوری و تست، بدون معطل ماندن برای تستهای قبلی پیش میرود و توانسته در کمتر از ۵ ساعت و با ۱۵۰ دلار هزینه به دقت ۳۵.۱ درصدی روی بنچمارک Polyglot برسد.
- آزمایشها نشان دادند که داور هوش مصنوعی حتی از روی خواندن سورسکد به تنهایی توانسته مشکلاتی مثل غیرفعال بودن ابزارهای راستیآزمایی یا ریسکهای سیستمی را بسیار بهتر از تستهای کوچک شناسایی کند.
ایجنتهای کدنویسی میتوانند با تغییر پرامپتها، ابزارها و حتی کدهایی که جریان کارشان را هدایت میکنند، عملکرد خودشان را ارتقا دهند. اما فهمیدن اینکه کدام تغییرات واقعاً مفیدند و ارزش نگهداشتن دارند، چالش بزرگی است و هزینههای سرسامآوری روی دست توسعهدهندگان میگذارد.
هر تغییر پیشنهادی باید به طور دقیق تست شود؛ به همین دلیل بررسی گزینههای متعدد میتواند هزاران ساعت پردازنده (CPU) مصرف کند و چند هزار دلار هزینه روی دست تیمها بگذارد.
حالا محققان دانشگاه MIT و شرکت Sakana AI با ارائه فریمورکی به نام خودبهبودی بازگشتی از طریق جستجوی درختی سریع (SIFT)، قصد دارند این هزینههای ارزیابی را به شدت کاهش دهند. فریمورک SIFT قبل از اینکه سراغ اجرای بنچمارکهای پرهزینه برود، از یک مدل زبانی مجزا برای مقایسه نسخههای مختلف ایجنتها استفاده میکند. این سیستم حتی میتواند در حالی که نسخههای قبلی همچنان در حال تست شدن هستند، تغییرات جدیدی را پیشنهاد دهد؛ قابلیتی که به الگوریتم جستجو اجازه میدهد بدون معطل شدن برای پایان تست هر پچ، همزمان شاخههای گوناگونی را بررسی کند.
به گفته پژوهشگران، در بنچمارک برنامهنویسی Polyglot، فریمورک SIFT توانست در کمتر از ۵ ساعت زمان واقعی، با مصرف ۴۲ ساعت CPU و فقط حدود ۱۵۰ دلار اعتبار API، به دقت ۳۵.۱ درصدی برسد.
برای تیمهایی که مشغول بهینهسازی بستر اجرایی ایجنتهای کدنویس برای کارهای مشخص هستند، SIFT راهکاری هوشمندانه پیش پا میگذارد: به جای اینکه هر نسخه جدید را زیر بار سنگین کل مجموعه تستها ببرید، منابع گرانقیمت ارزیابی را گزینششده و هوشمندانهتر خرج کنید.
هر پیشرفتی نیاز به تست دارد
مهندسان میتوانند دستورالعملهای یک ایجنت کدنویس را دستکاری کنند، ابزارهای جدیدی به آن بیفزایند یا نحوه واکنش آن به خطاها را تغییر دهند. اما این بهینهسازی دستی، وقت زیادی از متخصصان میگیرد و دامنه ایدهها را فقط به ذهن انسانها محدود میکند. در نقطه مقابل، روش «خودبهبودی بازگشتی» با اجازه دادن به سیستم برای اصلاح و بازنویسی سورسکد خودش، بخشی از این فرآیند را کاملاً خودکار میکند.
در این چرخه خودبهبودی، ایجنت خطاهایش را بررسی کرده و یک پچ اصلاحی برای ساختار اجرایی خودش پیشنهاد میدهد. نسخه بازبینیشده سپس تسکهای هدف را اجرا میکند و امتیازش تعیین میکند که آیا میتواند به نقطه شروعی برای پچهای بعدی تبدیل شود یا خیر. از آنجا که هر پچ خودِ سیستمی را که قرار است کارهای بعدی را پیشنهاد یا اجرا کند ارتقا میدهد، پیشرفتها میتوانند پلهپله روی هم سوار شوند.
رویکردهای قبلی این جستجو را به روشهای متفاوتی مدیریت میکردند. سیستم ماشین داروین گودل (DGM) آرشیوی از ایجنتها نگه میدارد و کاندیداها را روی مجموعههای تستی بزرگتر محک میزند؛ ابتدا ۱۰ تسک، سپس ۵۰ تسک و در نهایت کل بنچمارک Polyglot برای ارزیابی نهایی نگه داشته میشود. از سوی دیگر، ماشین هاکسلی گودل (HGM) هنگام تصمیمگیری درباره مسیر بعدی جستجو، عملکرد ایجنت و نوادگان آن را در نظر میگیرد و تعداد تسکهای نمونهبرداریشده را بر اساس ارزیابی کاندیداها تغییر میدهد.
چالش اصلی در این میان، هزینه سرسامآور تست تغییرات روی بستر ایجنت است. بر اساس آمار و ارقام این مقاله، پیشنهاد دادن یک پچ حدود ۱۲ سنت هزینه دارد. هر فراخوانی برای قضاوت و مقایسه جفتی حدود ۴.۴ سنت خرج برمیدارد و SIFT برای هر کاندیدا تا ۱۰ مورد از این قضاوتها (حدود ۴۴ سنت) انجام میدهد. این در حالی است که ارزیابی یک ایجنت روی ۵۰ تسک بنچمارک Polyglot حدود ۶ دلار هزینه مالی و ۲.۶ ساعت زمان پردازنده مصرف میکند.
تست کردن یک تغییر روی چند تسک محدود اگرچه ارزان تمام میشود، اما امتیازش میتواند فریبنده باشد؛ چون شاید به طور اتفاقی با مسائل خیلی ساده یا خیلی سخت روبهرو شده باشد. استفاده از یک مجموعه تست بزرگتر پایهای محکمتر برای تصمیمگیری فراهم میکند، اما اجرای آن همه تسک اضافی، زمان و پول زیادی میطلبد.
به تعبیر نویسندگان مقاله، گلوگاه اصلی این ماجرا «نسبت ضعیف سیگنال به هزینه در روشهای ارزیابی فعلی» است.
فریمورک SIFT چطور کار میکند؟
فریمورک SIFT بر پایه ساختار ایجنت DGM بنا شده، اما منبع بازخورد بسیار ارزانتری را وارد فرآیند جستجو میکند. ایده و شرطبندی اصلی SIFT این است: یک مدل زبانی میتواند دو نسخه از یک ایجنت را با هم مقایسه کرده و حتی قبل از اینکه کاندیدای جدید زیر بار تستهای سنگین برود، قضاوت کند که کدامیک عملکرد بهتری خواهد داشت.
وقتی SIFT یک ایجنت اصلاحشده میسازد، بلافاصله نسخه جدید را روی ۴ تسک کدنویسی امتحان میکند. این بررسی سریع باعث میشود قبل از اینکه سیستم وقت و هزینهای صرف مقایسه و تستهای بیشتر کند، تغییراتی که کلاً کار ایجنت را خراب کردهاند یا توانایی حل مسائل پایه را از آن گرفتهاند، فیلتر و رد شوند.
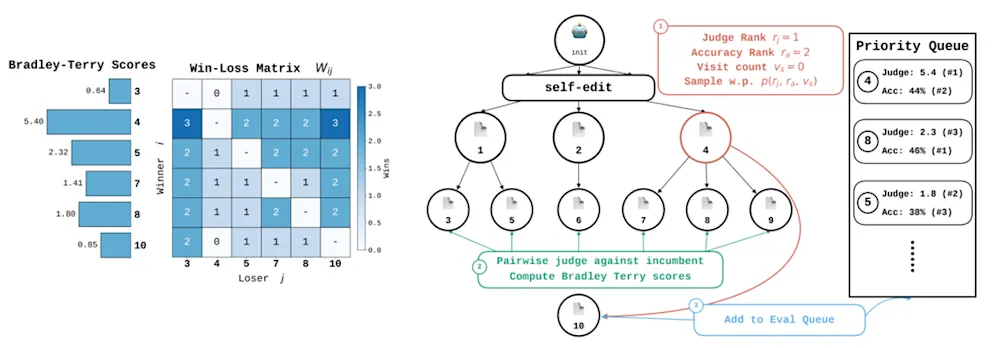
در مرحله بعد، SIFT از یک مدل زبانی به عنوان داور (LLM-as-a-judge) کمک میگیرد تا مقایسههای جفتی بین ایجنت جدید و حداکثر ۱۰ ایجنت برتر موجود در آرشیو انجام دهد. مقایسه دو پیادهسازی درست مثل این است که از یک مدیر استخدام بخواهید بین فینالیستها یکی را انتخاب کند، تا اینکه بخواهد به هر کدام نمرهای مطلق از ۱۰۰ بدهد. جالب اینجاست که این داور هوش مصنوعی فقط کد ایجنتها را میبیند، نه تسکهای بنچمارک یا نتایج آنها را.
سپس SIFT این انتخابهای جفتی را با استفاده از مدل آماری بردلی-تری (Bradley–Terry) ترکیب کرده و رتبهبندی میکند؛ روشی آماری برای تخمین قدرت نسبی بر اساس بردها و باختها. البته این رتبهبندی جایگزین تست نهایی نمیشود، بلکه کمک میکند مشخص شود سرمایهگذاری زمان روی تست و توسعه کدام نسخهها ارزش بیشتری دارد.
کاندیدای جدید سپس در یک صف اولویتبندیشده برای ارزیابیهای سنگینتر و زمانبر قرار میگیرد. اولویت این نسخه از ترکیب رتبه داور و رتبه دقت آن در بنچمارک به دست میآید.
این جریان کاری مانع از آن میشود که هر پچ منتظر ارزیابی کامل پچ قبلی بماند. تولید پچ، قضاوت داور و ارزیابی بنچمارک همگی به صورت موازی و همزمان پیش میروند؛ درست مثل یک پایپلاین CI مدرن در مهندسی نرمافزار که کار توسعه ادامه پیدا میکند در حالی که تستهای طولانیتر در پسزمینه در حال اجرا هستند. بدین ترتیب کاندیداهای امیدبخش حتی پیش از اتمام تستهای گرانقیمتشان میتوانند به والد پچهای بعدی تبدیل شوند.
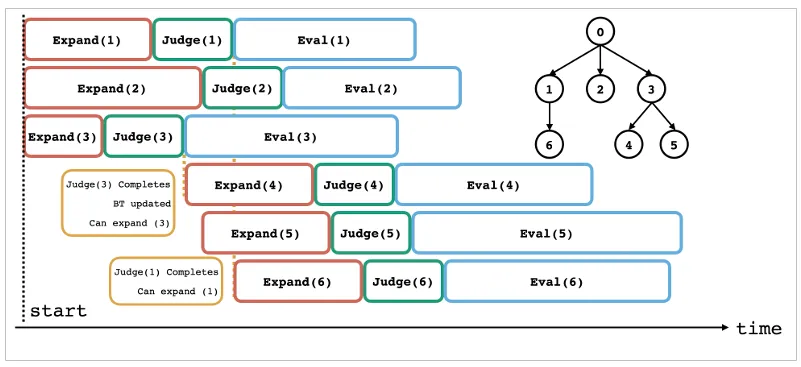
وقتی SIFT میخواهد یک والد را برای توسعه انتخاب کند، رتبه داور، رتبه دقت ایجنت در تسکهای جستجو و تعداد دفعاتی را که تاکنون انتخاب شده میسنجد. اگر کاندیدا هنوز در انتظار ارزیابی باشد، موقتاً دقت والد خود را به ارث میبرد. شمارش دفعات انتخاب قبلی مانع از گیر افتادن سیستم در یک شاخه خاص میشود و فضا را برای کشف مسیرهای جایگزینی که شاید در تغییرات بعدی شگفتیساز شوند، باز نگه میدارد.
در یکی از تستهای بنچمارک کدنویسی Polyglot، کاندیدایی به نام Node 9 یک دستورالعمل کوتاه برای اجرای تستها بعد از ویرایش کد به همراه ابزاری به نام «test_runner» اضافه کرد که خطاهای ساختاریافته را گزارش میداد. در نسلهای بعدی، پیچیدگیهای بیشتری به آن افزوده شد. جالب اینکه هر دو ایجنت در تست کوچک اولیه ۴۴ درصد تسکها را حل کردند و آن تست اولیه نتوانست نشان دهد کدام نسخه در بنچمارک گستردهتر بهتر عمل میکند. اما در ارزیابی کامل روی بنچمارک Polyglot، نسخه سادهتر امتیاز ۳۵.۶ درصد گرفت؛ در حالی که نسخه پیچیدهتر به امتیاز ۳۳.۸ درصد رسید. نکته شگفتانگیز این بود که داور هوش مصنوعی از قبل نسخه سادهتر Node 9 را برتر دانسته و رتبه بالاتری به آن داده بود!
وقتی داور هوش مصنوعی از نمره تست جلو میزند
محققان فریمورک SIFT را روی سه بنچمارک معتبر Polyglot، TerminalBench 2.1 و زیرمجموعه ۶۰ تسکی SWE-bench Verified آزمایش کردند. آزمایشهای آنها شامل چندین مدل کدنویسی و داور زبانی بود. آنها SIFT را با سیستمهای DGM و HGM مقایسه کردند، میزان بهبود را نسبت به نسخه اولیه بدون تغییر هر ایجنت سنجیدند، و حتی SIFT را یک بار بدون داور زبانی اجرا کردند تا مشخص شود حضور داور چقدر مؤثر بوده است.
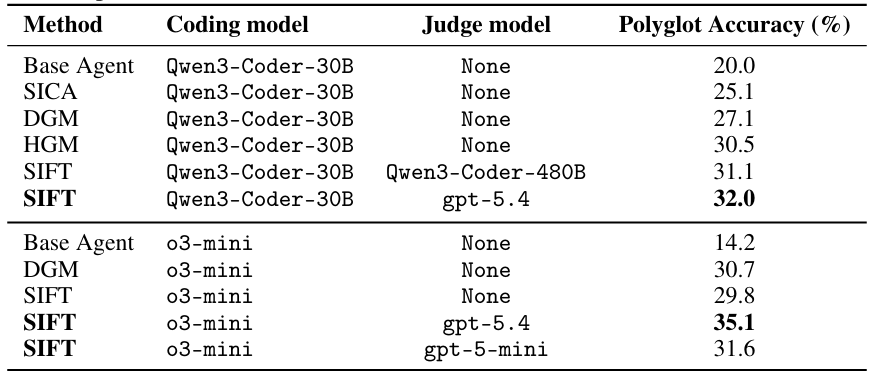
در بنچمارک Polyglot، فریمورک SIFT هم با مدل وزنباز Qwen3-Coder-30B و هم با مدل بسته o3-mini، دقت بهتری را با مصرف پردازش کمتر ثبت کرد. با مدل Qwen3-Coder-30B، امتیاز SIFT کمی بهتر از HGM بود، در حالی که حدود یکسوم کمتر ساعت پردازنده مصرف کرد. با مدل o3-mini نیز به دقت ۳۵.۱ درصدی رسید؛ در مقایسه با امتیاز ۳۰.۷ درصدی DGM. اجرای SIFT بدون داور زبانی به امتیاز ۲۹.۸ درصد محدود شد که نشان میدهد حضور داور عامل اصلی این جهش بوده است.
بنچمارک TerminalBench به خوبی نشان میدهد وقتی یک تست کوچک سیگنال گمراهکننده میدهد، داور چه چیزهایی را شکار میکند. ایجنت منتخب داور توانسته بود ۱۸ تسک از ۵۰ تسک مرحله جستجو را حل کند، در حالی که ایجنت دارای بالاترین امتیاز در همان جستجو ۱۹ تسک را حل کرده بود. اما در اجرای چندباره روی کل بنچمارک، منتخب داور میانگین ۳۶.۷ درصد را ثبت کرد؛ در مقایسه با ۲۸.۱ درصد ایجنتی که ۱۹ تسک را حل کرده بود! داور توانسته بود عیب کار را صرفاً از روی بررسی سورسکد بفهمد: ایجنت دوم ابزار تاییدکننده جدیدش به طور پیشفرض غیرفعال بود و بازنویسی ابزار shell آن خطر خرابی در زمان اجرا داشت.
نتایج در زیرمجموعه SWE-bench نیز برتری انتخابهای هدایتشده با داور را تایید کرد، هرچند تفاوتها کمی نزدیکتر بود. دو ایجنت برگزیده داور در چهار ارزیابی مختلف به میانگینهای ۵۰.۴ درصد و ۵۳.۸ درصد دست یافتند؛ در حالی که دو انتخاب برتر بدون داور میانگینهای ۴۴.۶ درصد و ۵۰.۴ درصد ثبت کردند. لازم به ذکر است که ایجنت اولیه بدون تغییر امتیاز ۴۰.۰ درصدی داشت.
تیمهای توسعه چه درسهایی میتوانند از SIFT بگیرند؟
اگرچه در این مقاله لینکی به یک پیادهسازی مستقل از SIFT ارائه نشده، اما توسعهدهندگان لزوماً نیازی به ساخت دوباره کل پشته خودبهبودی از صفر ندارند. از آنجا که SIFT روی بستر DGM توسعه یافته، تیمهایی که با پیادهسازیهای DGM کار میکنند بخش بزرگی از چرخه اصلی را در اختیار دارند: ایجاد تغییرات در ایجنت، نگهداری آرشیوی از نسخههای کاندید و ارزیابی عملکرد آنها. در واقع نوآوری SIFT اضافه کردن داوری جفتی، رتبهبندی بردلی-تری و ناهمگام (Asynchronous) کردن فرآیند جستجو است تا کاندیداها بتوانند همزمان با ارزیابی سایر گزینهها گسترش یابند.
هرچند SIFT فقط روی ایجنتهای کدنویسی تست شده، اما همین رویکرد پایه میتواند برای سایر ایجنتهای خودبهبوددهنده که متر و معیار مشخصی برای سنجش عملکرد دارند هم به کار برود. گام اول این است که یک ارزیابی کوچک و ارزان طراحی کنید تا تغییرات آشکارا نامناسب را سریعاً فیلتر و رد کند. برای یک ایجنت سازمانی، این ارزیابی میتواند مجموعهای کوچک از تسکهای داخلی باشد که ابزارهای خراب، افت کارایی یا تغییرات مغایر با الزامات پایه را بلافاصله شناسایی کند.
قطعه دوم این پازل، یک مدل زبانی در نقش داور است که پیادهسازیهای کاندیدا را به شکل جفتی مقایسه میکند. داور به جای اینکه تلاش کند نمره دقیق بنچمارک را پیشبینی کند، فقط کافی است یک رتبهبندی کاربردی ارائه دهد که نشان دهد کدام نسخه پتانسیل و امید بیشتری دارد.
در نهایت، این خط لوله باید ناهمگام (آسنکرون) باشد؛ تولید کاندیدا، داوری و ارزیابیهای گرانتر باید به صورت موازی اجرا شوند تا شاخههای امیدبخش بتوانند همزمان با تست کاندیداهای قبلی رشد کنند. بخش عمدهای از افزایش سرعت چشمگیر SIFT دقیقاً از همینجا ناشی میشود: درخت جستجو پیوسته گسترش مییابد بدون اینکه معطل تمام شدن ارزیابیهای وقتگیر بماند.
انتخاب مدل داور هم فرصتهای زیادی برای بهینهسازی هزینه در اختیار میگذارد. محققان دریافتند که یک مدل داور ارزانتر بخش عمدهای از سیگنالهای رتبهبندی کلی را در TerminalBench حفظ میکند؛ اگرچه مدلهای قویتر در انتخاب بهترین گزینهها قابلاعتمادتر بودند. به گفته آنها، میتوان از یک معماری لایهای استفاده کرد؛ یعنی از داور ارزانتر برای اکثر مقایسهها و از داور قدرتمندتر برای تفکیک گزینههای صدر جدول بهره برد.
فریمورک SIFT به خوبی نشان میدهد که چطور میتوان خودِ چرخه خودبهبودی را با ترکیب سیگنالهای ارزیابی کمهزینه و جستجوی موازی و ناهمگام به مراتب کارآمدتر کرد. این دستاورد به تیمها امکان میدهد بدون افزایش تصاعدی هزینههای تست، ایدهها و بهبودهای متعددی را در ایجنتها کاوش کنند. با این حال، هنوز هم برای تایید نهایی اینکه آیا یک تغییر واقعاً ایجنت را قویتر کرده یا نه، اجرای بنچمارکهای جامع ضروری است؛ کمااینکه محققان مجبور شدند جلوی پچهایی را که معیارهای ارزیابی را دور میزدند یا سست میکردند، به طور دستی بگیرند.
مطالب مرتبط و پیشنهادی
شتاب خیرهکننده مدل زبانی MiniCPM5 با دستیار ۳۲۴ میلیونی DSpark؛ جهش چشمگیر در تولید موازی توکنها
تیم OpenBMB با انتشار مدل کمحجم ۳۲۴ میلیون پارامتری DSpark، جهش بزرگی در سرعت استنتاج مدل زبانی MiniCPM5-2B ایجاد کرده است. این مدل با تکیه بر تکنیک هوشمندانه رمزگشایی گمانهزنانه، توکنها را به صورت دستهای حدس میزند تا فرایند پردازش با کمترین مصرف محاسباتی و بیشترین سرعت ممکن اجرا شود.
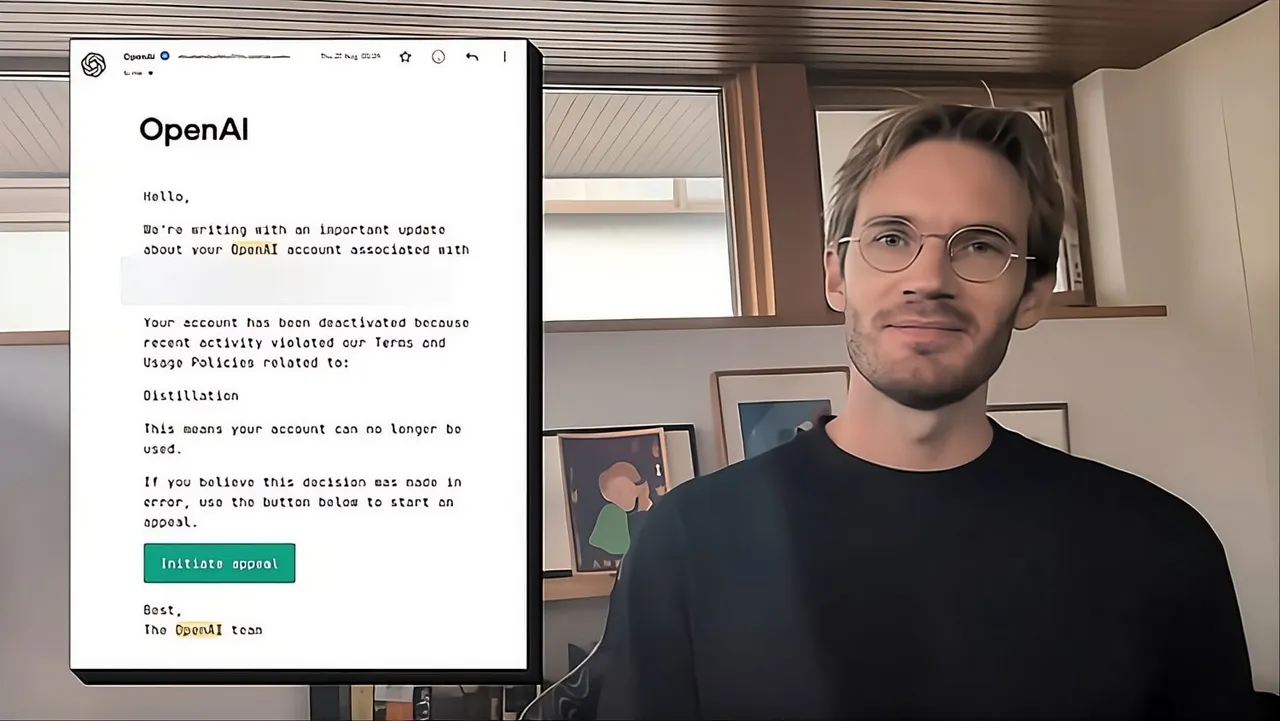
پیودیپای: موقع ساخت هوش مصنوعی اختصاصیام، OpenAI دو بار اکانتم را بست!
فلیکس شلبرگ یا همان پیودیپای معروف، بهتازگی مدل هوش مصنوعی محلی خود به نام Ajax را معرفی کرده، اما فاش ساخته که در مسیر توسعه آن، شرکت OpenAI دو بار حسابش را مسدود کرده است. او برای ساخت این مدل ۹ میلیارد پارامتری از تکنیک تقطیر استفاده کرده؛ موضوعی که زنگ خطر نقض قوانین سازنده ChatGPT را به صدا درآورده است.
طعنه سنگین سم آلتمن به آنتروپیک: نسبت دادن روح و دین به هوش مصنوعی خطرناکه!
سم آلتمن، مدیرعامل اوپنایآی، در اظهارنظری جنجالی به رویکرد شرکت رقیب یعنی آنتروپیک تاخت و نسبت دادن مفاهیم مذهبی و خودآگاهی به مدلهای هوش مصنوعی را یک تهدید امنیتی واقعی دانست. این اختلافنظر تازه پس از آن بالا گرفت که گزارشهایی از گفتوگوهای آنتروپیک با رهبران دینی برای تزریق اخلاق به مدلها منتشر شد. حالا دانشمندان ارشد هوش مصنوعی و حتی واتیکان هم به این مناقشه فلسفی کشیده شدهاند و درباره خطرات چنین رویکردی هشدار میدهند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.