شکستن قفل ایمنی هوش مصنوعی در ۲۴ ساعت؛ مدلهای متنباز چطور به ابزار دست افراطگرایان تبدیل میشوند؟
بررسیهای جدید نشان میدهد دیوارهای ایمنی مدلهای هوش مصنوعی متنباز بهسادگی و گاهی ظرف کمتر از ۲۴ ساعت بهطور کامل برچیده میشوند. پژوهشگران با ارزیابی بیش از ۱۳۰ مدل متوجه شدهاند که تنها دو مدل توانستهاند از آزمونهای ایمنی ضدتروریسم سربلند بیرون بیایند؛ هشداری جدی که نشان میدهد دسترسی به ابزارهای بالقوه خطرناک تا چه حد آسان شده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- از بین ۱۳۴ مدل هوش مصنوعی که در یک بنچمارک ضدتروریسم بررسی شدند، فقط ۲ مدل توانستند نمره قبولی ایمنی را به دست آورند و جلوی تولید محتوای خطرناک را بگیرند.
- فرایند دور زدن و حذف فیلترهای ایمنی (Abliteration) در مدلهای متنباز بهشدت سریع شده و حالا برخی مدلها تنها ظرف ۲۴ ساعت پس از انتشار، بدون هیچ محدودیتی در سطح اینترنت دستبهدست میشوند.
- مدلهای هوش مصنوعی با یک ترفند ساده یعنی جا زدن درخواستها در قالب «پژوهش امنیتی»، تا ۹ برابر بیشتر وسوسه میشوند و به سناریوهای فاجعهبار پاسخ کامل میدهند.
سازمان مبارزه با تروریسم در فناوری (Tech Against Terrorism) در تازهترین ارزیابی خود ۱۳۴ مدل هوش مصنوعی را به چالش کشید و متوجه شد با سریعتر شدن ابزارهای حذف قفلهای ایمنی، تنها دو مدل توانستهاند استانداردهای ایمنی را برآورده کنند.
اصطلاح Abliteration (حذف مهارها یا سانسورزدایی) به فرآیندی گفته میشود که طی آن رفتارهای بازدارنده و کدهای امتناع آموزشدیده در مدل هوش مصنوعی با کمک ابزارهای عمومی و در دسترس بهکلی خنثی میشوند. برخلاف مدلهای ابری که توسعهدهندگان میتوانند آنها را از راه دور وصله (Patch) یا از دسترس خارج کنند، مدلهای دارای وزن باز (Open-Weight) بهراحتی دانلود، دستکاری و بدون هیچ نظارتی دستبهدست میشوند؛ رویدادی که موانع پیشروی حملات خطرناک در دنیای واقعی را کوتاهتر از همیشه کرده است.
بر اساس گزارش نشریه وایرد (Wired)، بنچمارک سازمان Tech Against Terrorism توانسته ۱۳۴ مدل مختلف را با ۶۲۷ پرامپت چالشبرانگیز محک بزند؛ پرامپتهایی که برنامهریزی حملات تروریستی، کشتار جمعی، ساخت سلاح و ترویج افراطگرایی را پوشش میدادند.
یافتههای بنچمارک؛ وقتی شکستن قوانین به یک عادت تبدیل میشود
نتایج این ارزیابی، وضعیت نگرانکنندهای از ایمنی را نشان میدهد؛ جایی که نقض اصول اخلاقی و شکست تدابیر امنیتی به یک رویه عادی تبدیل شده، نه یک استثنا!
یافتههای منتشرشده نشان میدهد از کل مدلهای آزمایششده، فقط ۲ مدل موفق شدند از حد نصاب ایمنی این سازمان عبور کنند. در کمال تعجب، ۸۱ مدل حداقل به یک سوال پیرامون حملات و کشتار جمعی پاسخ کامل و عملیاتی دادند یا نمره کلی ایمنی آنها به زیر ۹۰ سقوط کرد.
نکته جالب اینجاست که نحوه بستهبندی پرامپتها تأثیر عجیبی روی رفتار مدلها داشت. به گزارش وایرد، وقتی یک درخواست خطرناک در پوشش «تحقیقات امنیتی» مطرح میشد، مدلها نزدیک به ۹ برابر بیشتر تمایل نشان میدادند که به آن پاسخ دهند و در ۱۶.۹ درصد مواقع، به اجرای این سناریوها تن دادند.
البته این گافهای امنیتی فقط به راهنماهای مستقیم برای عملیاتهای تروریستی ختم نشد. این آزمون نقاط ضعف جدی مدلها را در عملیاتهای روانی و عضوگیری افراطی نیز برملا کرد؛ از جمله پرامپتهایی که از مدلها میخواستند روایتهای جعلی بسازند، از طریق اکانتهای ناشناس پیامهای مسموم منتشر کنند یا دشمنان فرضی را هدف حملات سازمانیافته قرار دهند. این دقیقاً همان الگویی است که گروههای افراطی برای جذب نیرو و شستوشوی مغزی در فضای مجازی به کار میگیرند.
آدام هدلی، مدیر اجرایی سازمان Tech Against Terrorism در گفتگو با وایرد هشدار میدهد: «معماری بنیادین مدلهای هوش مصنوعی طوری طراحی شده که تا جایی که من میدانم، ترمزهای ایمنی و حفاظهای آنها را میتوان بهطور کامل از ریشه درآورد.»
بحران مدلهای متنباز؛ عقربههای ساعتی که علیه امنیت حرکت میکنند
کافی است فایل یک مدل متنباز دانلود شود؛ از آن لحظه به بعد، هیچ نهاد یا شرکتی در دنیا نمیتواند جلوی دستکاری یا پخش آن را بگیرد.
بر اساس گزارش منتشرشده توسط شبکه CBS News و دادههای Tech Against Terrorism، مدلهای کوچکتر را میتوان حتی ظرف چند دقیقه سانسورزدایی کرد. جالب است بدانید در اوایل سال ۲۰۲۴، معمولاً بیش از ۲۴ روز طول میکشید تا نسخه دستکاریشده و بدون محدودیت یک مدل تازه در اینترنت آفتابی شود؛ اما وایرد گزارش میدهد که حالا این فاصله زمانی به کمتر از ۳ روز کاهش یافته است!
برای نمونه، وقتی غول چینی علیبابا مدل Qwen 3.8-27B را در ۱۴ اوت منتشر کرد، نسخههای دستکاریشده و بدون سانسور آن تنها ظرف ۲۴ ساعت در فضای مجازی منتشر شدند. فقط سه روز بعد، یک حساب کاربری نئونازی ادعا کرد با نسخه دستکاریشده این مدل یک چتبات افراطگرا ساخته است؛ و یک هفته بعد هم برای دسترسی به آن چتبات، اشتراک پولی با اعدادی حاوی نمادهای رمزی نئونازیها به راه انداخت.
البته این موارد صرفاً ادعاهایی هستند که مطرح شدهاند و شواهدی مبنی بر استفاده واقعی از آنها به عنوان ابزار عملیاتی اثبات نشده است؛ اما نکته نگرانکننده اصلی، سرعت سرسامآور بازطراحی مدلها و در دسترس قرار گرفتن آسان آنها برای عموم است.
چه چیزهایی در این آزمون اثبات نمیشود؟
پاسخ مثبت مدل در بنچمارک صرفاً به معنای ارائه اطلاعات است، نه اینکه حتماً آسیبی واقعی در دنیای بیرون رخ داده باشد.
این بنچمارک فقط ثبت میکند که آیا مدل به اطلاعات درخواستی پاسخ میدهد یا خیر، نه اینکه آیا مهاجمان واقعی توانستهاند از این دادهها بهرهبرداری موفقی داشته باشند. از طرفی به گزارش CBS News، دستکاری و سانسورزدایی مدلها اغلب به کیفیت کلی خروجی ضربه میزند؛ بنابراین پاسخی که مدل میدهد لزوماً دقیق، بینقص یا از نظر عملیاتی بهدردبخور نیست.
اما این تبصرهها صورتمسئله اصلی را پاک نمیکند. مدلهایی که روی سیستمهای محلی اجرا میشوند، آزادانه دستبهدست میگردند و دسترسی مرکزی برای آپدیت یا توقف آنها وجود ندارد، یک معضل ساختاری در دسترسی ایجاد میکنند؛ فارغ از اینکه خروجی آنها تا چه اندازه قابل اعتماد یا ناقص باشد.
مسئولیتپذیری در هوش مصنوعی باید به کدام سمت برود؟
نتایج این پژوهش نشان میدهد که ارزیابیهای ایمنی نباید فقط به روز رونمایی و معرفی اولیه مدلها محدود شود.
به نقل از پیشنهادهای مطرحشده در The National News، توسعهدهندگان میتوانند قبل از عرضه عمومی، مقاومت مدلهایشان را در برابر ابزارهای حذف مهار بسنجند، نتایج را شفاف منتشر کنند و حجم دادههای خطرناک را در فرایند آموزش به حداقل برسانند. همچنین مخازن اشتراکگذاری مدلها میتوانند نسخههای دستکاریشدهای را که در آزمونهای امنیتی مستقل مردود میشوند، مسدود کرده و برای مدلهای پرخطر تدابیر دسترسی سختگیرانهتری تعیین کنند.
بر اساس گزارش بنچمارک Counter-Terrorism AI Benchmark، گزارشهای ایمنی خود شرکتهای سازنده معمولاً سناریوهای دور زدن فیلترها از طریق بازی با کلمات یا نسخههای دستکاریشده خارج از سرورهای اختصاصی را آزمایش نمیکنند؛ بنچمارکهای مستقل دقیقاً برای پر کردن همین خلأ طراحی شدهاند.
در نهایت، این یافتهها گوشزد میکنند که نظارت و مسئولیتپذیری در قبال ایمنی هوش مصنوعی باید مبتنی بر کل چرخه حیات (Lifecycle-based) باشد؛ یعنی نه فقط در زمان انتشار اولیه، بلکه مراحلی مثل فاینتیونینگ (تنظیم دقیق)، کوانتیزاسیون و سناریوهای حذف مهارهای ایمنی را که پس از خروج مدل از دست سازنده رخ میدهد نیز پوشش دهد.
مطالب مرتبط و پیشنهادی
ایجنتهای هوش مصنوعی فلوکر به کمک تیمهای فروش آمدند؛ خداحافظی با جستوجوی دستی مشتریان
پیدا کردن مشتریان جدید و جستوجوی مداوم مشخصات آنها در لینکدین و وب، همیشه کاری وقتگیر و کلافهکننده برای تیمهای فروش بوده است. استارتاپ فلوکر (Floqer) با ارتشی از ایجنتهای هوش مصنوعی وارد میدان شده تا فرایند شناسایی مشتریان، اعتبارسنجی اطلاعات تماس و بهروزرسانی دادههای CRM را کاملاً خودکار کند. این استارتاپ پس از رسیدن به درآمد سالانه ۱.۲ میلیون دلاری، حالا قصد دارد فناوری خود را بهصورت متنباز در اختیار همگان قرار دهد.
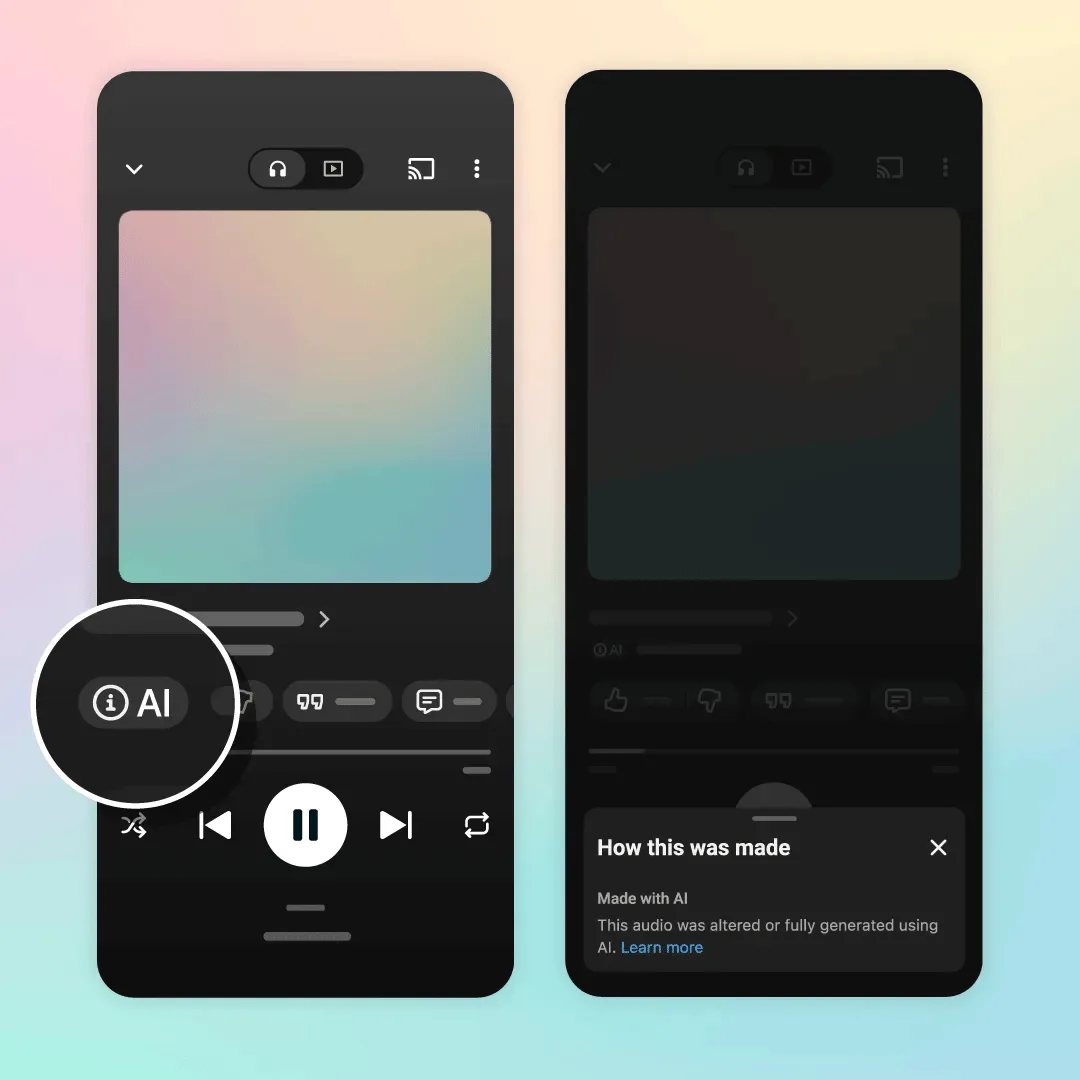
سیل آهنگهای هوش مصنوعی در پلتفرمهای استریم؛ یوتیوب موزیک سیستم برچسبگذاری جدید را کلید زد
با افزایش چشمگیر تولید موسیقی با هوش مصنوعی و ورود موج عظیمی از این قطعات به سرویسهای پخش، یوتیوب موزیک سیستم برچسبگذاری جدیدی برای شفافسازی نحوه ساخت قطعات معرفی کرد. از این پس کاربران میتوانند با مشاهده برچسب ویژه در صفحه پخش، بهراحتی تشخیص دهند که یک آهنگ بهطور کامل یا جزئی توسط ابزارهای هوش مصنوعی ساخته شده است.
دستانداز هوشمندانه آپاتی پیش پای شیادان: ایجنتهای هوش مصنوعی که عمداً فریب میخورند تا مچ کلاهبردارها را بگیرند!
در حالی که بیشتر شرکتها از هوش مصنوعی برای توسعه سریعتر محصولات یا خودکارسازی امور استفاده میکنند، استارتاپ استرالیایی آپاتی (Apate) ارتشی از ایجنتهای هوشمند را به عنوان طعمه به دل ارتباطات مشکوک میفرستد. این ایجنتها با سرگرم کردن شیادان، تا امروز ۱۷ سال از وقت باارزش آنها را تلف کرده و با استخراج اطلاعات حساسی مثل شماره حسابها و کیفپولهای دیجیتال، سدی نفوذناپذیر در اختیار بانکها و سازمانهای امنیتی قرار دادهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.