بنچمارک جدید OpenAI، خطاهای هوش مصنوعی در تحلیل دادههای واقعی آزمایشگاه را آشکار کرد
OpenAI با همکاری استارتاپ Ligo بنچمارک جدیدی به نام BioBasicsBench معرفی کرده است که توانایی ایجنتهای هوش مصنوعی را در تحلیل دادههای واقعی آزمایشگاههای زیستی ارزیابی میکند. این آزمون نشان میدهد مدلها حتی هنگام توصیف درست تصاویر آزمایشگاهی، ممکن است نتایج نادرستی بگیرند و تصمیمات اشتباهی پیشنهاد دهند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بنچمارک BioBasicsBench با ۱۰۰ وظیفه تخصصی، نحوه خواندن و تفسیر شواهد تجربی مانند تصاویر ژل و دادههای میکروسکوپی توسط هوش مصنوعی را میسنجد.
- مدل GPT-6 Astra با ثبت امتیاز ۶۶٫۷ درصد در صدر نتایج قرار گرفت و در مقایسه با سایر مدلهای ارزیابیشده پاسخهای خلاصهتری ارائه داد.
- خطاهای هوش مصنوعی مانند نادیده گرفتن شواهد متناقض و شمارش نادرست سلولها نشان میدهد این ابزارها حتماً باید زیر نظر مستقیم پژوهشگران فعالیت کنند.
OpenAI با همکاری استارتاپ طراحی آنزیم Ligo، بنچمارک جدیدی به نام BioBasicsBench را منتشر کرده است که شامل ۱۰۰ وظیفه تخصصی برای سنجش نحوه تفسیر شواهد خام آزمایشگاههای زیستی توسط ایجنتهای هوش مصنوعی میشود. در این آزمونها از تصاویر ژل الکتروفورز، پلیتهای کشت کلنی، دادههای میکروسکوپی و خروجی دستگاههای سنجش استفاده شده است. مدلها در این چالش باید مشاهدات دقیق را استخراج کنند، کنترلها و نمونههای شاهد را بسنجند و نتیجهگیریهای خود را تنها به آنچه شواهد اثبات میکنند محدود نگه دارند.
آزمونهای ارزیابی در حوزه زیستشناسی معمولاً مواردی چون یادآوری دانستههای علمی، پاسخ به سؤالات چهارگزینهای، استدلال روی پروتکلهای آزمایشگاهی یا بیوانفورماتیک را میسنجند. با این حال، BioBasicsBench دقیقاً مرحله تفسیر را هدف قرار داده است؛ یعنی همان گام حساسی که پس از جمعآوری دادهها و پیش از تصمیمگیری درباره اقدام بعدی برداشته میشود. دامنه این بنچمارک به تحلیل پس از گردآوری داده محدود است و کارهای فیزیکی مانند کار با پیپت، کار با دستگاهها و اجرای رباتیک بیرون از چارچوب این آزمون قرار میگیرند.
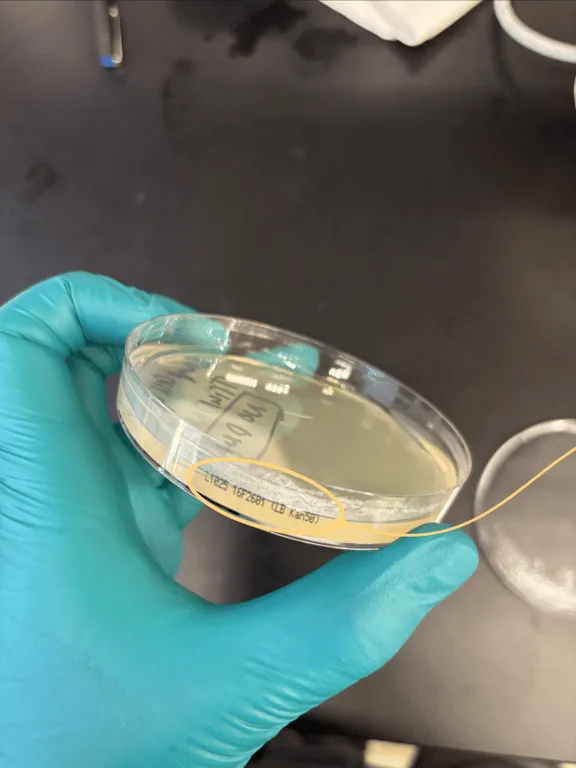
شواهد پیچیده آزمایشگاهی در ۵ حوزه تخصصی
وظایف این بنچمارک پنج حوزه متداول در فعالیتهای آزمایشگاهی را در بر میگیرند:
- روشهای کار با پروتئین
- تصویربرداری و فلوسایتومتری
- سنجشهای کمّی و آزمایشگاهی
- روشهای کار با اسیدهای نوکلئیک
- کلونینگ مولکولی
ایجنتهای هوش مصنوعی با تصاویر و فایلهای خروجی دستگاههایی سر و کار دارند که تمام پیچیدگیها و ابهامهای دنیای واقعی آزمایشگاه را در خود حفظ کردهاند. یک پاسخ درست ممکن است مستلزم تفکیک یک سیگنال واقعی زیستی از خطای تصویربرداری، شناسایی نمونه شاهد نامتناسب، یا نتیجهگیری درباره این نکته باشد که دادههای موجود به هیچ وجه فرضیه مطرحشده را پشتیبانی نمیکنند.
این وظایف پس از طراحی، توسط دانشمند دیگری از استارتاپ Ligo و همچنین یک فارغالتحصیل مقطع دکترای آزمایشگاه زیستی مورد بازبینی دقیق قرار گرفته است.
پیشتازی GPT-6 Astra در امتیاز و اختصار پاسخها
شرکت OpenAI هفت مدل خود را در بالاترین سطح پردازش استدلالی ارزیابی کرد و برای هر وظیفه، پنج تلاش در اختیار هر مدل گذاشت. میانگین امتیاز نهایی شامل نمرات جزئی برای پاسخهای ناکامل نیز میشود. بازه اطمینان ۹۵ درصدی نشاندهنده میزان عدم قطعیت آماری پیرامون هر میانگین است و تعداد توکنهای خروجی در هر وظیفه نیز میانگین طول پاسخها را مشخص میکند.
مدل | میانگین امتیاز | بازه اطمینان ۹۵ درصدی | توکنهای خروجی در هر وظیفه |
|---|---|---|---|
GPT-6 Astra | ۶۶٫۷٪ | ۶۰٫۳ تا ۷۳٫۱ درصد | ۴٬۷۰۴ |
GPT-6.1 Sol | ۶۲٫۰٪ | ۵۵٫۶ تا ۶۸٫۴ درصد | ۵٬۲۳۸ |
GPT-5.6 Sol | ۴۳٫۸٪ | ۳۷٫۶ تا ۵۰٫۰ درصد | ۹٬۰۹۹ |
GPT-6 Luna | ۳۸٫۳٪ | ۳۲٫۳ تا ۴۴٫۵ درصد | ۱۳٬۱۲۰ |
GPT-5.5 | ۳۵٫۴٪ | ۲۹٫۷ تا ۴۱٫۰ درصد | ۱۱٬۱۳۵ |
GPT-5.4 | ۳۳٫۲٪ | ۲۸٫۳ تا ۳۸٫۴ درصد | ۱۳٬۷۱۷ |
GPT-5.2 | ۳۱٫۲٪ | ۲۶٫۲ تا ۳۶٫۳ درصد | ۲۷٬۶۲۰ |
مدل GPT-6 Astra با امتیاز ۶۶٫۷ درصد در جایگاه نخست ایستاد که ۲۲٫۹ واحد درصد بالاتر از GPT-5.6 Sol است. مدل Astra با میانگین ۴٬۷۰۴ توکن خروجی برای هر وظیفه، در مقایسه با ۹٬۰۹۹ توکن در GPT-5.6 Sol، کوتاهترین پاسخها را در میان مدلهای آزمایششده ارائه داد.
شیوه نمرهدهی مبتنی بر امتیاز جزئی به این معناست که میانگین ۶۶٫۷ درصدی ممکن است شامل پاسخهای ناکامل متعددی باشد. در مقابل، سنجش نرخ تکمیل قطعی وظایف میتواند تصویر متفاوتی از میزان قابلیت اتکا ارائه دهد. علاوه بر این، جدول مذکور تنها هفت مدل از OpenAI را در یک پیکربندی مشخص مقایسه میکند؛ در حالی که مقایسه با مدلهای شرکتهای دیگر یا عملکرد کارشناسان انسانی به معیارهای پایهای مجزایی نیاز دارد. تحلیل دقیق هزینههای استقرار نیز مستلزم بررسی توکنهای ورودی، تاخیر پاسخدهی و قیمتگذاری هر مدل خواهد بود.
جایی که مشاهده به خطای عملیاتی تبدیل میشود
تحلیل کیفی OpenAI نشان میدهد یک مشاهده اولیه بهظاهر درست، از چندین مسیر مختلف میتواند به یک تصمیم آزمایشگاهی غیرقابل اتکا منجر شود:
- اشتباه گرفتن تغییر فوکوس با رویداد زیستی: در تصویربرداری با عمق متغیر یا z-stack، از یک نمونه در سطوح کانونی مختلف تصویربرداری میشود. یکی از پاسخها تغییرات ناشی از جابهجایی کانون تصویر را به اشتباه یک پدیده زیستی تلقی کرد.
- شناسایی نادرست باندهای ژل: مدل با وجود تفکیک موفق الگوی باندها، شناسههای آزمایشگاهی اشتباهی به آنها اختصاص داد و در نهایت کلنیهای نادرستی را انتخاب کرد.
- شمارش بیش از حد کلنیها: در یکی از وظایف شمارش، مدل پس از جا انداختن برخی کلنیها، ادغام کلنیهای همسایه و علامتگذاری نواحی خالی، تعداد کلنیها را حدود ۱۲ درصد بیشتر از واقعیت تخمین زد.
- نادیده گرفتن شواهد متناقض: در یکی از تحلیلهای میکروسکوپی، مدل متوجه تغییرات کانونی شد، اما نتیجهگیری کلی اولیهای را حفظ کرد که وجود بخشهای روشنتر در همان کادر مستقیماً آن را نقض میکرد.
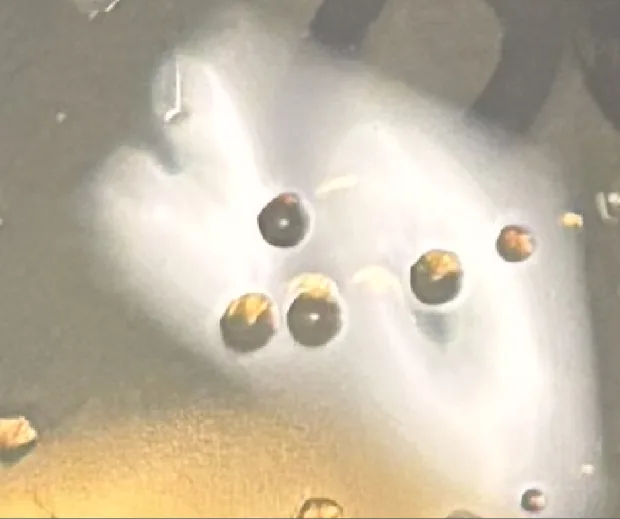
در این میان، مدل GPT-6 Astra موفق شد پلیتی را شناسایی کند که برچسب آنتیبیوتیک متفاوتی نسبت به پروتکل آزمایش داشت؛ مغایرتی مهم که در عمل نمونه شاهد را باطل میکرد. این مدل در وظیفه دیگری تشخیص داد که همپوشانی کانالهای آشکارسازی میکروسکوپ مانع از اثبات فرضیه مرگ سلولی میشود. گزارش OpenAI این موارد را بهعنوان نمونههای کیفی مطرح میکند و سنجش دقیق تکرارپذیری این رفتارها به تفکیک دقت در هر دستهبندی نیاز خواهد داشت.
لایه خواندن و تفسیر شواهد آزمایشگاهی
آزمونهای پیشین بیشتر مراحل مجاور در تحقیقات علمی را پوشش دادهاند. بهعنوان نمونه، بنچمارک BenchBench-Protocol بر استدلال پیرامون تغییرات پروتکلهای آزمایشگاهی تمرکز دارد، در حالی که بنچمارک ABC-Bench ایجنتها را در وظایف گستردهتر زیستشناسی از جمله کارهای نوین بیوانفورماتیک میسنجد. بر خلاف آنها، بنچمارک BioBasicsBench مشخصاً مرحله تفسیر شواهد را پس از تولید دادهها توسط آزمایش تفکیک و بررسی میکند.
این تمرکز دقیق باعث شده است بنچمارک جدید برای دستیاران هوش مصنوعی آزمایشگاهی اهمیت بالایی پیدا کند؛ دستیارانی که وظیفه بازبینی تصاویر، تأیید برچسبها، ارزیابی نمونههای شاهد یا نگارش تفاسیر اولیه را بر عهده دارند. همچنین موارد شکست مدلها در این آزمون، یکی از خطرات بنیادین استقرار این فناوری را نشان میدهد: یک مدل ممکن است عارضه یا خطای تصویر را کاملاً درست توصیف کند، اما با وجود این، اقدام و تصمیم نادرستی را به محقق پیشنهاد دهد.
طراحی سیستمهای هوش مصنوعی بر پایه مهار الگوهای خطا
توسعهدهندگانی که به ساخت دستیاران آزمایشگاهی مشغول هستند، میتوانند خطاهای شناساییشده در این بنچمارک را به الزامات فنی و عملیاتی مشخص تبدیل کنند:
- ثبت مشاهدات اولیه بهصورت کاملاً تفکیکشده از تفاسیر و اقدامات پیشنهادی.
- حفظ تصاویر خام، فرادادههای دستگاهها و شرایط نمونههای شاهد برای بازبینیهای بعدی.
- بررسی مجدد برچسبها، نوع آنتیبیوتیکها، هویت نمونهها و شرایط شاهد پیش از آغاز تحلیل.
- ارجاع فوری مواردی که با همپوشانی کانالها، کیفیت پایین تصویر یا شواهد متناقض روبرو هستند به کارشناس انسانی.
- الزام تأیید دانشمندان برای انتخاب کلنیها، نتیجهگیریهای نهایی و مراحل بعدی آزمایش.
علاوه بر این، OpenAI این قابلیتها را به امنیت زیستی پیوند میزند؛ زیرا همان مهارتهای تفسیر شواهد که به پژوهشهای سودمند پیرامون آنزیمها کمک میکنند، میتوانند در پروژههای زیستی مخرب نیز به کار گرفته شوند. بنابراین استقرار این ابزارها در کنار آزمونهای دقت، نیازمند اعمال کنترلهای دسترسی، ثبت تاریخچه فعالیتها و سازوکارهای نظارتی مستمر است.
امتیازات بهدستآمده و الگوهای خطای گزارششده نشان میدهند هوش مصنوعی در آزمایشگاههای زیستی باید در نقش یک دستیار تحت نظارت فعالیت کند؛ نقشی که در آن دانشمندان انسانی توصیهها را با دقت بررسی میکنند و مرجع نهایی تمام تصمیمگیریهای آزمایشگاهی باقی میمانند.
مطالب مرتبط و پیشنهادی
شرکت AT&T از مدل متنباز OTel 2.0 برای صنعت مخابرات رونمایی کرد
شرکت AT&T با همکاری شماری از غولهای فناوری، از مدل زبانی متنباز OTel 2.0 با ۳۱ میلیارد پارامتر برای صنعت مخابرات رونمایی کرد. این مدل بر پایه Gemma 4 توسعه یافته و روی ۴۴۰ میلیارد توکن تخصصی شبکه آموزش دیده است. انتشار این پروژه تحت مجوز Apache 2.0 گامی مهم در ارتقای هوش مصنوعی در زیرساختهای ارتباطی بهشمار میرود.
پژوهش دانشگاه استنفورد؛ ۲۶ ایجنت هوش مصنوعی در مدیریت همزمان چند کاربر شکست میخورند
پژوهشگران دانشگاه استنفورد و امآیتی با ارزیابی ۲۶ مدل تجاری و متنباز دریافتند که ایجنتهای هوش مصنوعی هنگام تعامل همزمان با چند کاربر عملکرد قابل اعتمادی ندارند. این دستیارها در مدیریت دستورهای متضاد، حفظ حریم خصوصی و هماهنگی تیمی با خطاهای جدی مواجه میشوند. این تیم با معرفی بنچمارک جدید Muses-Bench، چالشهای امنیتی و نظارتی مدلهای زبانی در فضاهای کاری اشتراکی را به تصویر کشیدهاند.
ابزار OpenCode Browse کنترل مستقیم تبهای فعال مرورگر را به ایجنتهای کدنویسی میسپارد
ابزار جدید OpenCode Browse با ترکیب افزونه مرورگر Chromium و پروتکل MCP، به ایجنتهای هوش مصنوعی امکان میدهد تبهای فعال و دارای نشست مرورگر را مستقیماً هدایت کنند. این ابزار با حذف نیاز به ساخت کلیدهای API و ورودهای مکرر، اتوماسیون محلی را سادهتر میکند. همچنین توسعهدهندگان میتوانند در هر لحظه مراحل حساسی مانند پرداختها یا ورود دومرحلهای را شخصاً در دست بگیرند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.