سرعت ۸ برابری در تولید توکن؛ اوپنایآی حالت Ultrafast را برای مدل GPT-6.1 Sol فعال کرد
اوپنایآی حالت فوقسریع Ultrafast را به مدل GPT-6.1 Sol اضافه کرد تا سرعت تولید توکن تا ۸ برابر افزایش یابد. این قابلیت ویژه با تمرکز بر ایجنتهای تعاملی و کدنویسی زنده عرضه شده و در ازای هزینه ۶ برابری، تأخیر پاسخدهی را به حداقل ممکن میرساند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- اوپنایآی حالت فوقسریع Ultrafast را برای مدل GPT-6.1 Sol فعال کرد؛ قابلیتی که سرعت تولید توکن را تا ۸ برابر سریعتر از حالت استاندارد میکند و تجربهای بسیار روان برای ایجنتهای تعاملی رقم میزند.
- این جهش سرعتی با هزینه ۶ برابری توکنها همراه است؛ پردازش هر یک میلیون توکن در این حالت ۱۲ دلار برای ورودی و ۶۰ دلار برای خروجی هزینه دارد که همچنان یکپنجم مدل پرچمدار Astra است.
- برای حفظ کامل این دستاورد سرعتی و جلوگیری از اتلاف زمان در رفتوبرگشت درخواستها، اوپنایآی استفاده از پروتکل وبسوکت (WebSockets) را به توسعهدهندگان توصیه کرده است.
ورود حالت فوقسریع Ultrafast به مدل GPT-6.1 Sol اوپنایآی
اوپنایآی دسترسی به حالت فوقسریع (Ultrafast tier) را برای مدل GPT-6.1 Sol در پلتفرمهای API، کدکس (Codex) و ChatGPT Work فعال کرد. این سرویس وعده داده سرعت تولید توکن را در مقایسه با حالت استاندارد تا ۸ برابر افزایش دهد؛ حرکتی که مستقیماً ایجنتهای تعاملی، ابزارهای کدنویسی زنده و سناریوهای اضطراری پاسخ به حوادث فنی را هدف گرفته است.
اوپنایآی نخستین بار در جریان کنفرانس DevDay سال ۲۰۲۶ حالت Ultrafast را برای مدل پرچمدار GPT-6 Astra معرفی کرده و وعده داده بود که این قابلیت بهزودی به مدل Sol هم میرسد. حالا این وعده عملی شده و با توجه به نوع حساب و پلن اشتراکی کاربران، در دسترس قرار گرفته است.
یک لاین اختصاصی با سرعت ۸ برابری برای همان مدل همیشگی
در حالت Ultrafast، همان مدل همیشگی GPT-6.1 Sol روی یک زیرساخت پردازشی و استنتاجی فوقسریع اجرا میشود. توسعهدهندگان برای استفاده از این قابلیت در API، کافی است مقدار service_tier را در درخواستهای Responses API روی ultrafast بگذارند.
طبق مستندات رسمی اوپنایآی، سرعت تولید توکن برای مدل Astra در حالت Ultrafast به ۳۰۰ توکن در ثانیه میرسد. برای مدل Sol هنوز سقف نهایی و عددی مشخصی اعلام نشده، اما اوپنایآی روی جهش چشمگیر ۸ برابری سرعت نسبت به حالت استاندارد تأکید دارد.
هزینهها چطور محاسبه میشود؟ ۶ برابر قیمت بیشتر به ازای هر توکن!
البته این سرعت دیوانهوار رایگان به دست نمیآید؛ فراخوانی API برای مدل GPT-6.1 Sol در حالت Ultrafast دقیقاً ۶ برابر بیشتر از حالت استاندارد آب میخورد:
سطح سرویس | ورودی بهازای هر ۱ میلیون توکن | خروجی بهازای هر ۱ میلیون توکن |
|---|---|---|
استاندارد (Standard) | ۲ دلار | ۱۰ دلار |
فوقسریع (Ultrafast) | ۱۲ دلار | ۶۰ دلار |
برای مقایسه بد نیست بدانید حالت فوقسریع در مدل غولپیکر GPT-6 Astra به ازای هر یک میلیون توکن، ۶۰ دلار برای ورودی و ۳۰۰ دلار برای خروجی هزینه دارد؛ بنابراین قیمت مدل Sol در حالت Ultrafast همچنان یکپنجم نسخه آسترا تمام میشود.
پلنها، پشتیبانی منطقهای و محدودیتهای مصرف
در پلتفرمهای کدکس و ChatGPT Work، دسترسی به حالت Ultrafast از طریق پلنهای زیر امکانپذیر است:
- پلن Pro 500
- قراردادهای سازمانی (Enterprise) واجد شرایط بر پایه میزان مصرف
- پلنهای آموزشی (Edu) مبتنی بر اعتبار
مدیران حسابهای سازمانی باید ابتدا این سطح کاربری را برای اعضای خود فعال کنند تا کاربران بتوانند آن را انتخاب نمایند. اوپنایآی اعلام کرده حالت Ultrafast در تمام مناطق جغرافیایی تحت پشتیبانی، از جمله سرورهایی با الزام نگهداری داده در خاک آمریکا یا اتحادیه اروپا در دسترس است. همزمان با این عرضه، قابلیت نگهداری دادهها در اتحادیه اروپا برای مدلهای GPT-6.1 Sol Fast و GPT-6 Luna Fast نیز اضافه شده است.
سقف ترافیک پیشفرض API هم بر اساس سطح مصرف (Usage tier) کاربران افزایش پیدا میکند:
سطح مصرف | سقف توکن پیشفرض |
|---|---|
Build | ۵۰۰٬۰۰۰ توکن در دقیقه |
Launch | ۱٬۰۰۰٬۰۰۰ توکن در دقیقه |
Grow | ۵٬۰۰۰٬۰۰۰ توکن در دقیقه |
وبسوکت؛ راهکاری برای هدر نرفتن ثانیههای طلایی سرعت
اوپنایآی برای ایجنتهایی که مرتباً از ابزارهای مختلف استفاده میکنند (Tool Calls)، استفاده از وبسوکت (WebSockets) را پیشنهاد میکند؛ زیرا یک اتصال دائمی و پایدار، بار اضافی و تأخیر بین مراحل رفتوبرگشت پیامها را از بین میبرد. هرچند فراخوانیهای HTTP همچنان از طریق SDK در دسترس هستند، اما چرخههای مکرر درخواست ممکن است بخش زیادی از سرعتی را که در حین تولید توکن ذخیره کردهاید، تلف کنند.
از آنجا که جهش ۸ برابری سرعت مشخصاً روی بخش تولید توکن اعمال شده، تیمهای فنی باید کل چرخه و جریان کاری را محک بزنند؛ چرا که تأخیر کلی سیستم (End-to-end latency) شامل مواردی مثل بار اتصال شبکه، زمان لازم تا دریافت اولین توکن (TTFT)، اجرای ابزارها و پردازشهای داخلی اپلیکیشن هم میشود.
توسعهدهندگان پایتون میتوانند با یک فراخوانی استاندارد Responses API، حالت فوقسریع GPT-6.1 Sol را به سادگی فراخوانی کنند:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model=\"gpt-6.1-sol\",
    service_tier=\"ultrafast\",
    input=\"Explain why the sky is blue in one sentence.\",
)

print(response.output_text)ایجنتهایی که در گفتگوهای چندمرحلهای (Multi-turn) فعالیت میکنند، میتوانند با باز نگه داشتن یک نشست وبسوکت و ارسال شناسه previous_response_id بین مراحل، پاسخها را به هم پیوند بزنند؛ بدون اینکه لازم باشد کل تاریخچه طولانی مکالمه را مدام از نو ارسال کنند.
چرا مدل Sol بهترین گزینه برای کارهای تعاملی و بیدرنگ است؟
اوپنایآی مدل GPT-6.1 Sol را در حوزههایی مثل کدنویسی با ایجنتها، کار با رایانه (Computer Use) و تسکهای حرفهای، بسیار نزدیک به غول پرچمدار خود یعنی GPT-6 Astra قرار داده؛ در حالی که قیمتش تنها یکپنجم آسترا است. مدل Sol از پنجره زمینهای عظیم ۱٬۰۵۰٬۰۰۰ توکنی پشتیبانی میکند که شامل ۹۲۲٬۰۰۰ توکن ورودی و ۱۲۸٬۰۰۰ توکن خروجی میشود.
اوپنایآی سه کاربرد کلیدی را برای این مدل پرسرعت هدف قرار داده است:
- مدیریت بحرانهای فنی (Incident Response): مهندسان نرمافزار میتوانند هنگام بروز باگهای بحرانی در سرورها، با سرعت بسیار بالاتر به ریشهیابی مشکل و تست راهکارها بپردازند.
- ایجنتهای کار با کامپیوتر (Computer-use agents): سرعت بالای تولید توکن باعث میشود تأخیرهای انباشتهشده در طول زنجیرهای از کلیکها و فعالیتها درون مرورگر یا نرمافزارها به حداقل برسد.
- تجربههای زنده برنامهنویسی: رابطهای صوتی، تکمیل خودکار کد، پیشنهادهای لحظهای حین تایپ و حلقههای ویرایش کد، همگی از این انتظار بسیار کوتاهتر بین ورودی و خروجی بیشترین بهره را میبرند.
هزینه بیشتر فقط برای جایی که ثانیهها ارزش طلا دارند
با نرخهای فعلی، تولید ۱۰۰٬۰۰۰ توکن خروجی در حالت استاندارد حدود ۱ دلار و در حالت فوقسریع نزدیک به ۶ دلار هزینه برمیدارد (بدون احتساب توکنهای ورودی). شاید پرداخت این ۵ دلار اضافه در زمان بروز بحران در سرور یا یک نشست برنامهنویسی زنده کاملاً منطقی و بهصرفه باشد، اما کارهای پسزمینه، ارزیابیهای آفلاین و پردازشهای ناهمگام که عجلهای برای تمام شدنشان نیست، بهتر است همچنان روی همان حالت اقتصادی استاندارد باقی بمانند.
با حضور سه سطح استاندارد، Fast و Ultrafast، حالا توسعهدهندگان سه سطح پردازشی متفاوت برای یک خانواده مدل در اختیار دارند. اکنون هر برنامهای میتواند به ازای هر درخواست، بسته به اهداف سرعت، بودجه مالی و رفتار کاربران، بهترین سطح را انتخاب کند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
شکار بخش گمشده کیهان با هوش مصنوعی آنتروپیک؛ کلود نقشه فرابنفش آسمان را کامل کرد
یک اخترفیزیکدان در دانشگاه جانز هاپکینز با استفاده از پلتفرم Claude Science موفق شد یکسوم گمشده از نقشه فرابنفش کیهان را بازسازی و کامل کند. این پروژه عظیم که در گذشته به ماهها کار طاقتفرسا نیاز داشت، حالا به لطف ایجنتهای هوشمند کلود و در عرض چند روز به سرانجام رسیده است.
سرمایهگذاری ۱ میلیارد دلاری انویدیا برای سلطه علمی آمریکا؛ پول خردی که خرج ابررایانههای هوش مصنوعی شد!
انویدیا از اختصاص یک میلیارد دلار برای توسعه پژوهشهای علمی و ابررایانههای هوش مصنوعی در آمریکا خبر داد؛ بودجهای که برای این غول تراشهساز حکم پول خرد را دارد اما ارتش پردازشی این کشور را در رقابت با چین تقویت میکند. این طرح بلندپروازانه با تجهیز آزمایشگاههای ملی به تراشههای بلکول، پیشتازی هوش مصنوعی و محاسبات کوانتومی را هدف گرفته است.
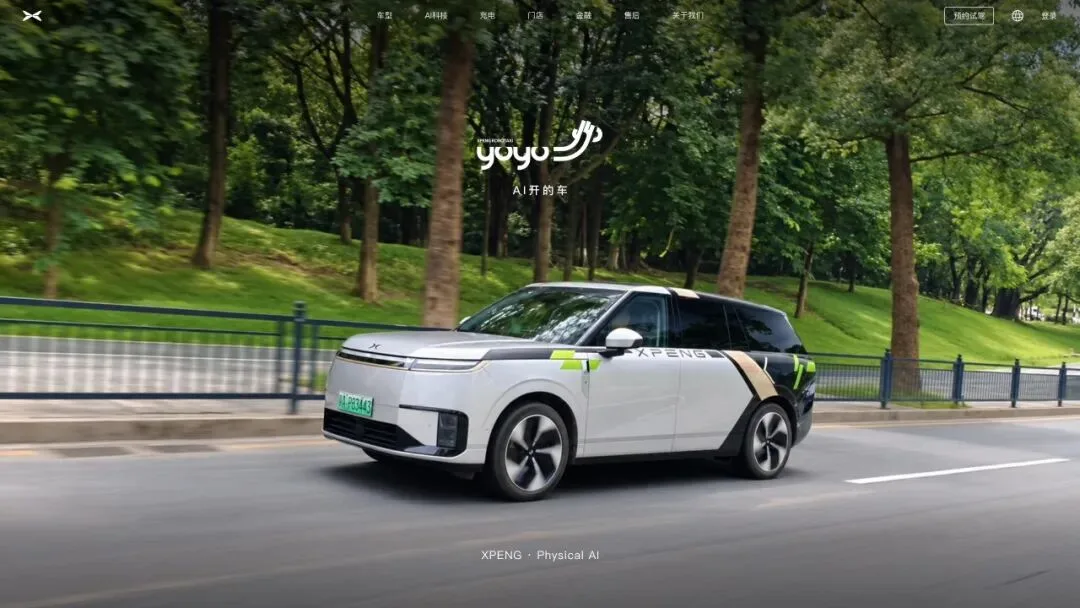
تاکسی خودران اختصاصی ایکسپنگ به خیابانها آمد؛ رونمایی از سرویس XPENG YOYO و آغاز تستهای عمومی
شرکت چینی ایکسپنگ (XPENG) با معرفی برند جهانی «XPENG YOYO» رسماً وارد فاز آزمایش عمومی تاکسیهای خودران خود شد. این روبوتاکسی تمامعیار با تکیه بر ۴ تراشه هوش مصنوعی تورینگ و مدل پیشرفته بینایی-زبانی VLA 2.0، بدون نیاز به لیدار در خیابانها مسافرگیری میکند. کاربران منتخب در چین از همین حالا میتوانند با کدهای دعوت اختصاصی، سفر در کابین لوکس و هوشمند این تاکسی را تجربه کنند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.