پرایم اینتلکت از Prime Inference رونمایی کرد؛ پردازش روزانه ۶۰۰ میلیارد توکن برای ایجنتهای هوشمند
استارتاپ پرایم اینتلکت با رونمایی از پلتفرم Prime Inference، زیرساخت پروداکشن پردازش روزانه صدها میلیارد توکن را در اختیار عموم قرار داد. این سرویس جدید با بهینهسازیهای عمیق سختافزاری و نرمافزاری روی تراشههای بلکول انویدیا، سرعت اجرای ایجنتهای کدنویسی و مدلهای متنباز بزرگی مثل GLM-5.3 را به اوج رسانده است.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پرایم اینتلکت پلتفرم Prime Inference رو معرفی کرد که روزانه نزدیک به ۶۰۰ میلیارد تا یک تریلیون توکن رو روی تراشههای پیشرفته انویدیا بلکول پردازش میکنه.
- این زیرساخت با تفکیک مراحل پردازش پرامپت و تولید توکن، فشردهسازی ۴ بیتی کش (NVFP4) و کاهش ترافیک NVLink، تأخیر اجرای مدل GLM-5.3 رو تا ۴۰ درصد کاهش داده.
- توسعهدهندهها میتونن با همون API آشنای سازگار با OpenAI، بدون دردسر از اندپوینتهای سرورلس یا ظرفیتهای رزروشده برای اجرای پایدار ایجنتهای هوشمند استفاده کنن.
استارتاپ پرایم اینتلکت (Prime Intellect) رسماً از پلتفرم جدید خود با نام Prime Inference رونمایی کرد؛ زیرساخت پردازشی قدرتمندی که ستون فقرات فرآیندهای یادگیری تقویتی (RL) و سرویسدهیهای اختصاصی به مشتریان این شرکت را تشکیل میدهد. این پلتفرم در حال حاضر روزانه نزدیک به یک تریلیون توکن را با تکیه بر منابع محاسباتی خود پردازش میکند. حالا پرایم اینتلکت همین زیرساخت مقیاسپذیر را در قالب اندپوینتهای سرورلس (Serverless) برای مدیریت ترافیکهای متغیر و ظرفیتهای رزروشده (Reserved Capacity) برای بارهای پردازشی مداوم روی مدلهای متنباز پیشرو، در دسترس همگان قرار داده است.
پرایم این استک نرمافزاری و سختافزاری را بهطور ویژه برای پشتیبانی از چرخههای سنگین یادگیری تقویتی، تولید دادههای مصنوعی (Synthetic Data)، ارزیابی مدلها و اجرای بیوقفه ایجنتهای کدنویسی طولانیمدت توسعه داده است. نخستین خروجی عمومی این سرویس، مدل قدرتمند GLM-5.3 است که هماکنون از طریق پلتفرم OpenRouter و همچنین API اختصاصی پرایم در دسترس قرار دارد. طبق آمارهای منتشرشده از سوی پرایم، این اندپوینت یکی از پرسرعتترین سرویسهای ارائهدهنده مدل GLM-5.3 در OpenRouter محسوب میشود و نرخ خطای فراخوانی ابزارها (Tool-call Error Rate) در آن تقریباً به صفر رسیده است.
یک API آشنا در کنار دو مدل دسترسی به ظرفیت پردازشی
این سرویس از یک رابط برنامهنویسی کاملاً سازگار با استاندارد OpenAI بهره میبرد؛ به این معنی که توسعهدهندگان میتوانند بدون نیاز به کوچکترین تغییری در کدهای خود و تنها با بهروزرسانی آدرس پایه (Base URL) به https://api.pinference.ai/api/v1 به این زیرساخت متصل شوند. علاوه بر این، پرایم یک رابط خط فرمان (CLI) اختصاصی را نیز برای تست و ارزیابی مستقیم فراهم کرده است:
prime inference chat 'z-ai/glm-5.3' "Write a haiku about KV caches."- مدل عمومی: سرویسدهی فوقالعاده کمتأخیر مدل GLM-5.3 با پشتیبانی قراردادهای تضمین سطح خدمات (SLA) در مقیاس صنعتی و تجاری
- سختافزار قدرتمند: بهکارگیری شتابدهندههای پیشرفته بلکول انویدیا (NVIDIA Blackwell) با برنامهریزی قطعی برای تجهیز به زیرساخت نسل بعدی ورا روبین (Vera Rubin)
- تابآوری و پایداری: سوئیچ خودکار (Failover) بیدرنگ بین دیتاسنترهای مختلف در صورت افت سلامت یا بروز اختلال در هر یک از سرورها
- ظرفیت منعطف: ارائه اندپوینتهای سرورلس برای پاسخگویی به نوسانات لحظهای ترافیک و ظرفیتهای اختصاصی رزروشده برای بارهای کاری سنگین و مداوم
- اکوسیستم نرمافزاری پیشرفته: بهرهگیری از فناوریهای NVIDIA Dynamo، vLLM، Mooncake و FlashInfer به همراه بازگرداندن بهینهسازیهای فنی انجامشده به پروژههای متنباز اصلی (Upstream)
پرایم همچنین قصد دارد بهزودی قابلیت استنتاج ناهمگام و دستهای (Batch & Asynchronous Inference) را برای پردازشهای آفلاین و کمهزینهتر به این پلتفرم اضافه کند. یکی دیگر از برنامههای جذاب این تیم، فراهم کردن امکان دیپلوی تککلیکی مدلهای فاینتیونشده از محیطهای آموزشی پرایم روی ظرفیتهای پردازشی رزروشده است.
چرا ایجنتهای هوش مصنوعی سرورهای استنتاج را به زانو درمیآورند؟
در یک سناریوی معمول هنگام اجرای ایجنتهای هوش مصنوعی با زمینههای طولانی (Long-Context)، در هر رفتوبرگشت حدود ۶ هزار توکن جدید به یک پرامپت ۱۴۰ هزار توکنی اضافه میشود؛ در حالی که بخش عمدهای از تاریخچه گفتگو دستنخورده باقی میماند و دوباره مورد استفاده قرار میگیرد. سرورهای استنتاج برای اینکه مجبور نشوند در هر مرحله کل این مکالمه غولپیکر را از ابتدا پردازش کنند، دادههای میانی لایههای توجه (Attention) را در حافظهای اختصاصی به نام «کیوی کش» (KV Cache) نگهداری میکنند.
اما چالش اصلی زمانی رخ میدهد که زیر بار پردازشی همزمان، سشنهای جاری با کشهای قبلی باید همان منابع پردازندههای گرافیکی (GPU) را با درخواستهای تازهای به اشتراک بگذارند که دارای پرامپتهای طولانی و بدون کش هستند. پردازش این پرامپتهای اولیه یا بهاصطلاح «سرد»، سرعت تولید توکن را برای سایر کاربران فعال به شدت کاهش میدهد؛ از سوی دیگر، جابهجایی حجم عظیمی از دادههای KV Cache بین کارتهای گرافیکی، بخش عمدهای از پهنای باند حافظه را میبلعد و سیستم را دچار کندی و معطلی میکند.
تفکیک پردازش پرامپت از فرآیند تولید توکن
پرایم برای حل این گلوگاه، مرحله پردازش اولیه پرامپت (Prefill) را به طور کامل از مرحله تولید توکنها (Decode) تفکیک کرده است. در این معماری، هر مرحله توسط دستههای مجزایی از GPUها مدیریت میشود. وظیفه مسیریابی هوشمند درخواستها بر عهده NVIDIA Dynamo گذاشته شده، اجرای مدل توسط فریمورک محبوب vLLM انجام میشود و در نهایت کتابخانه اختصاصی NIXL انویدیا دادههای ذخیرهشده در KV Cache را بلافاصله پس از پایان پردازش پرامپت به پردازندههای تولید توکن (دیکودرها) منتقل میکند.
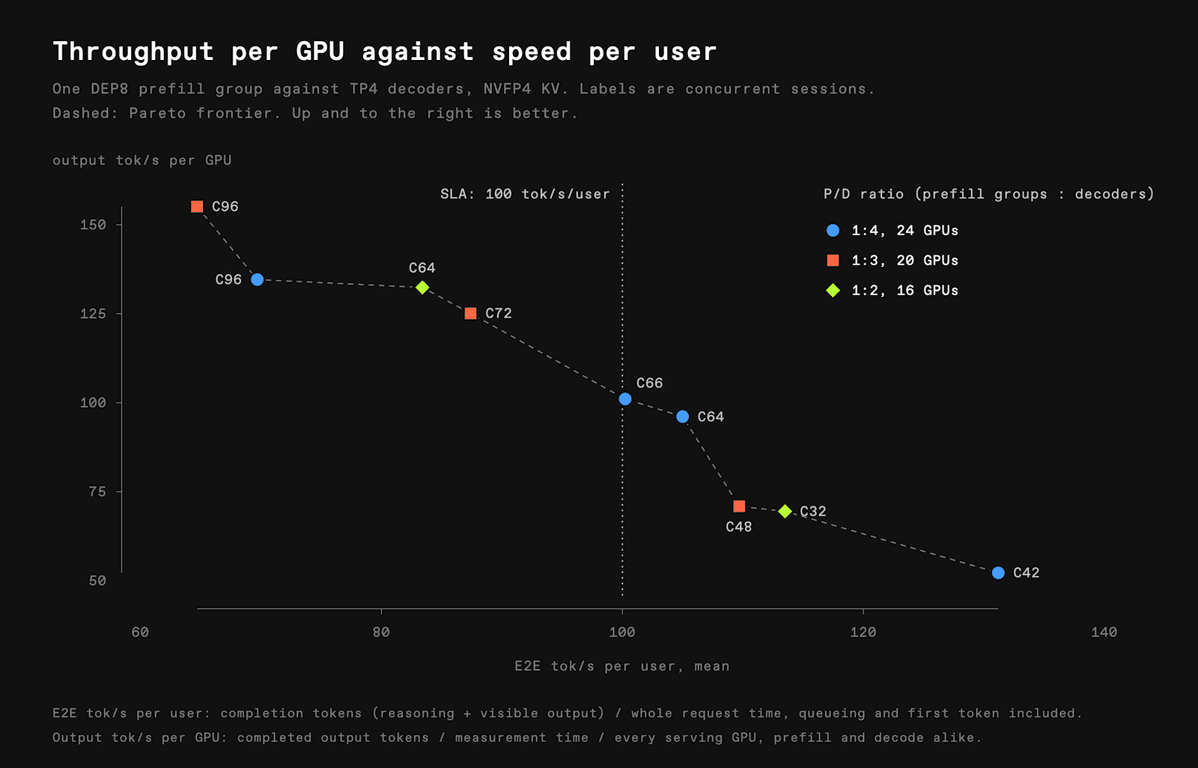
بررسیها و تستهای فنی پرایم نشان میدهد که این بازطراحی ساختاری، میزان تأخیر بین توکنها در صدک نودم (90th-percentile) را تا مرز ۴۰ درصد کاهش داده است. در سیستمهای پیشرفته GB200 NVL72 که مدل GLM-5.3 را میزبانی میکنند، ترکیب یک گروه پردازش پرامپت به ازای هر چهار گروه دیکودر توانسته از ۶۶ سشن همزمان با نرخ خیرهکننده ۱۰۱ توکن تولیدی در ثانیه برای هر کاربر فعال پشتیبانی کند.
کشهای ۴ بیتی راه را باز میکنند
استفاده از موازیسازی تنسور روی چهار پردازنده گرافیکی (موسوم به TP4) توانست کمترین میزان تأخیر را در مرحله تولید توکن به ثبت برساند؛ با این حال، هر یک از GPUها کماکان ناچار بودند یک نسخه کامل از کش نهان KV مربوط به هر درخواست را در حافظه خود نگه دارند؛ مسألهای که سقف تعداد توکنهای قابل ذخیرهسازی در رم را به شدت محدود میکرد.
مهندسان پرایم برای عبور از این بنبست، حافظه کش توجه نهان چندسر (MLA) مدل GLM-5.3 را با فرمت فشرده ۴ بیتی NVFP4 ذخیره کردند؛ فرمتی که به ازای هر گروه ۱۶ تایی از مقادیر، تنها یک مقیاس FP8 اختصاص میدهد. در نتیجه این ابتکار، حجم هر ردیف کش از ۵۷۶ بایت به ۳۵۲ بایت تقلیل یافت. با این ترفند و بدون نیاز به افزایش بودجه حافظه، ظرفیت بخش دیکودر حدود ۵۰ درصد جهش کرد و تعداد توکنهای قابل نگهداری در کش از ۱.۰۹ میلیون به ۱.۶۳ میلیون توکن رسید.
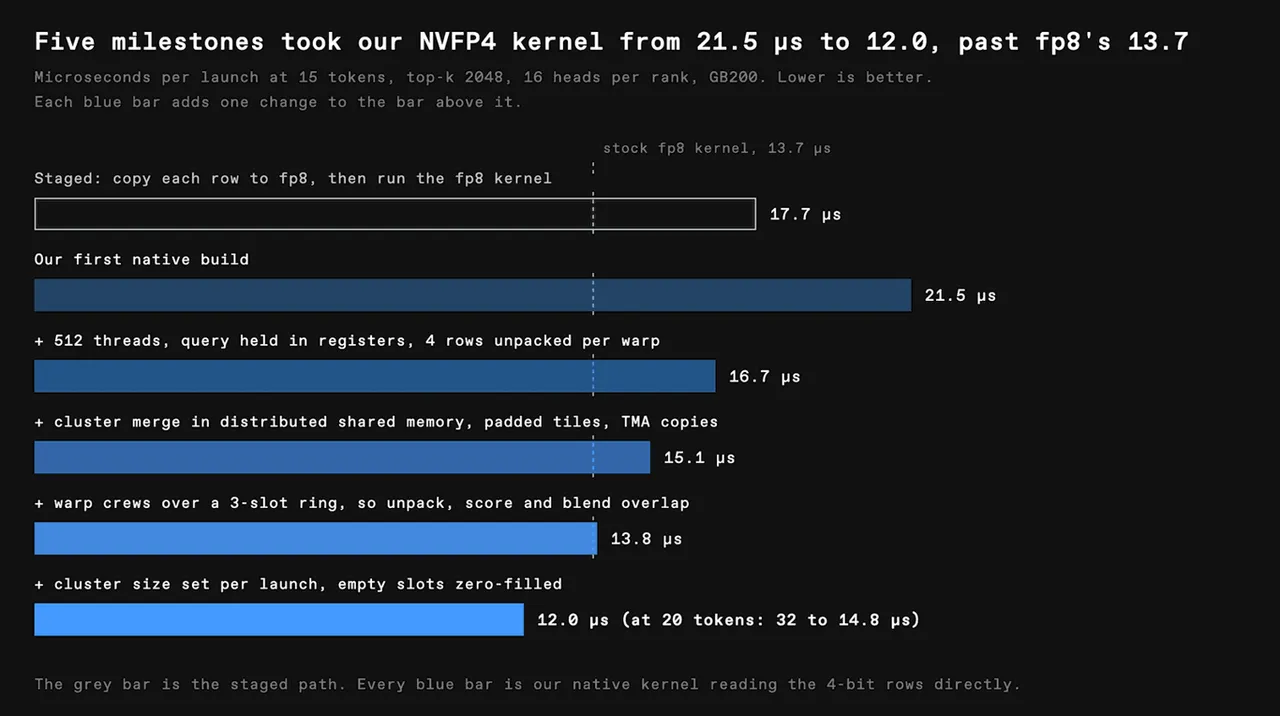
در روشهای ابتدایی، دادههای ۴ بیتی ابتدا روی بافرهای FP8 بازگشایی میشدند و سپس فرآیند توجه روی آنها اجرا میشد که همین رفتوبرگشت اضافه در حافظه GPU، تأخیر لایهها را بالا میبرد. پرایم برای رفع این نقیصه، یک کرنل محاسباتی بومی برای توجه تنک (Sparse-Attention Kernel) نوشت که منحصراً ردیفهای منتخب ایندکسر را لود کرده و مستقیماً روی خود چیپ آنلاک میکند. در این ساختار، NVFP4 به عنوان فرمت ذخیرهسازی حفظ شده، در حالی که محاسبات توجه با متغیرهای FP16 و تجمیع دادهها در دقت FP32 پیش میرود. این دستاورد فنی با سه تصمیم کلیدی در پیادهسازی حاصل شد:
- پیادهسازی پایپلاین سهمرحلهای که به یک دسته وارپ (Warp Group) اجازه میدهد ردیفها را از حالت فشرده خارج کند، همزمان با اینکه سایر گروهها به محاسبه امتیاز و تجمیع مراحل قبلی میپردازند
- تنظیم پویای اندازه کلاسترهای پردازندههای جریانی (SM) متناسب با اندازه بچ توکنها در لحظه
- پر کردن خانههای خالی در لیست ۲۰۴۸ موقعیتی با مقدار صفر؛ راهکاری که زمان آغاز اجرای توجه برای ۳۵ توکن را از حدود ۴۱ میکروثانیه به ۲۰.۶ میکروثانیه کاهش داد و عملاً نصف کرد
مسیر محاسبات توجه (Attention Path) | میزان تأخیر (Latency) |
|---|---|
فرمت بومی NVFP4 (Native) | حدود ۱۲ میکروثانیه |
فرمت مرحلهای NVFP4 (Staged) | ۱۷.۷ میکروثانیه |
فرمت FP8 | ۱۳.۷ میکروثانیه |
پرایم در حرکتی ارزشمند، کرنل بومی NVFP4 خود را به عنوان یک عملیات آزمایشی در اختیار پروژه محبوب FlashInfer قرار داده است تا کل جامعه متنباز بتوانند از آن بهرهمند شوند.
کاهش تکرار کپیها؛ آزادسازی تمام پتانسیل NVLink
آزمایشهای اولیه پرایم نشان داد که انتقال دادههای KV در بستر چندگرهای NVLink در مقایسه با استاندارد InfiniBand، حدود ۲۹۲ میلیثانیه زمان پاسخدهی به اولین توکن (TTFT) را به تعویق میاندازد. علت ماجرا اینجا بود که یک درخواست ساده با ۲۰۰ هزار توکن میتوانست ۳۲ هزار عملیات کپی ریز بین دستگاهها را روی هر کارت گرافیک فعال کند و با سیل عظیمی از برچسبهای انتقال، پهنای باند را فلج سازد.
جامعه توسعهدهندگان vLLM این پراکندگی داده را با معماری نوآورانه BLHNC حل کردند؛ چیدمانی بلوکمحور از حافظه KV که دادههای چندین لایه مختلف را به صورت پیوسته در هر بلوک ذخیره میکند. هرچند در این طرح اندازه هر بلوک به یکشانزدهم اندازه قبلی تقلیل یافته، اما تعداد توصیفگرهای انتقال از ۱۹,۵۵۹ به حدود ۱,۹۴۰ عدد کاهش پیدا کرده است. نتیجه این بهینهسازی، افت میانگین زمان انتقال از ۱۴۶ میلیثانیه به ۷۸ میلیثانیه (یعنی کاهشی در حدود ۴۷ درصد) بود.
حافظه کش بیشتر و صفهای کوتاهتر
روی پردازندههای گرافیکی فاز پرامپت، پرایم از ساختار DEP8 استفاده کرد که هشت دسته توجه موازی دادهای را با موازیسازی تخصصی ترکیب میکند. این در حالی بود که در ساختار جایگزین TEP8، دادههای KV هر درخواست روی تمامی هشت پردازنده کپی میشد. راهکار DEP8 به کارتهای مختلف این امکان را داد که درخواستهای متفاوتی را کش کنند؛ نوآوری بزرگی که بدون نیاز به سختافزار اضافه، ظرفیت قابل استفاده پیشوند کش (Prefix-Cache) را حدود ۵ برابر افزایش داد.
زمانبند پردازشی پرایم معمولاً حتی پیش از آنکه درخواست وارد صف پردازش دستهای شود، دادههای کششده KV را آماده در اختیار داشت. این تیم با کاهش سقف پردازش پرامپت از ۸,۰۰۰ به ۴,۰۰۰ توکن به ازای هر GPU توانست این معطلی را هم کمتر کند؛ اقدامی که میانه زمان انتظار در صف را از ۵۵۰ میلیثانیه به ۱۱۰ میلیثانیه رساند و زمان تولید نخستین توکن را تقریباً ۲۰ درصد سریعتر کرد.
گاردریلهای ساختاری برای فراخوانی بینقص ابزارها
سیستم Dynamo در شرایط عادی ممکن بود درخواستهایی را که به ابزارهای تعریفنشده ارجاع داده میشدند، بدون هیچ هشداری نادیده بگیرد و وضعیت پایان عادی را به ایجنت برگرداند؛ خطایی بیصدا که ایجنت هوش مصنوعی را بدون هیچ پیام خطا یا دستور اجرایی معلق رها میکرد. چنین نقصهایی به ویژه برای ایجنتهای کدنویسی و پژوهشی آسیبزننده است؛ چرا که تکتک مراحل تصمیمگیری آنها به فراخوانی معتبر و دقیق ابزارهای ساختاریافته وابسته است.
پرایم برای رفع این معضل، یک ابزار سازنده تگهای ساختاری را به Dynamo اضافه کرد تا موتور xgrammar فریمورک vLLM بتواند ساختار دقیق و قوانین فراخوانی ابزارها را در حین تولید تضمین کند. این گرامر ساختاری، توکنهایی را که موجب شکست قالب استاندارد میشوند، پیش از انتشار توسط مدل مسدود میسازد. علاوه بر این، این تیم باگهای پارسر را که باعث خراب شدن کاراکترهای < در کدهای تولیدی و فایلها میشدند نیز به طور کامل برطرف کرد.
حلقه بازخورد مدلهای باز و آینده پردازش هوش مصنوعی
هدف کلان و راهبردی پرایم، پیوند زدن زیرساخت سرویسدهی پروداکشن با فرآیندهای یادگیری و آموزش مدلها است؛ به این صورت که دادهها و عملکردهای ثبتشده از ایجنتهای در حال اجرا، مستقیماً به عنوان دادههای آموزشی جدید برای چرخههای بعدی یادگیری تقویتی به کار گرفته شوند. تحقق این چرخه پیشرفته نیازمند لایه استنتاجی فوقالعاده پایداری است که بتواند متنهای بسیار طولانی را با اطمینان کامل پردازش کند و خروجیهای ساختاریافته مورد نیاز ایجنتها را کاملاً سالم تحویل دهد.
این دستاوردهای مهندسی بهخوبی اثبات میکنند که در کنار قدرت پردازشی صرف GPUها، عواملی نظیر چیدمان حافظه، فشردهسازی کش، زمانبندی هوشمند، ظرافت انتقال داده و دیکودینگ مقید، نقشی بنیادین در کارایی نهایی ایجنتها ایفا میکنند. اکنون جامعه توسعهدهندگان مدلهای متنباز میتوانند از طریق اندپوینت عمومی GLM-5.3 یا تهیه سرویسهای رزروشده، از این بهینهسازیهای فنی بهرهمند شوند. البته باید به خاطر داشت که ارقام و رکوردهای منتشرشده توسط خود توسعهدهنده و بر اساس مدلی خاص ثبت شدهاند و کارایی واقعی در عمل به طول زمینه، بار همزمانی کاربران، نرخ استفاده مجدد از پرامپتها و معماری نهایی مدلها وابسته خواهد بود.
مطالب مرتبط و پیشنهادی
شتاب خیرهکننده مدل زبانی MiniCPM5 با دستیار ۳۲۴ میلیونی DSpark؛ جهش چشمگیر در تولید موازی توکنها
تیم OpenBMB با انتشار مدل کمحجم ۳۲۴ میلیون پارامتری DSpark، جهش بزرگی در سرعت استنتاج مدل زبانی MiniCPM5-2B ایجاد کرده است. این مدل با تکیه بر تکنیک هوشمندانه رمزگشایی گمانهزنانه، توکنها را به صورت دستهای حدس میزند تا فرایند پردازش با کمترین مصرف محاسباتی و بیشترین سرعت ممکن اجرا شود.
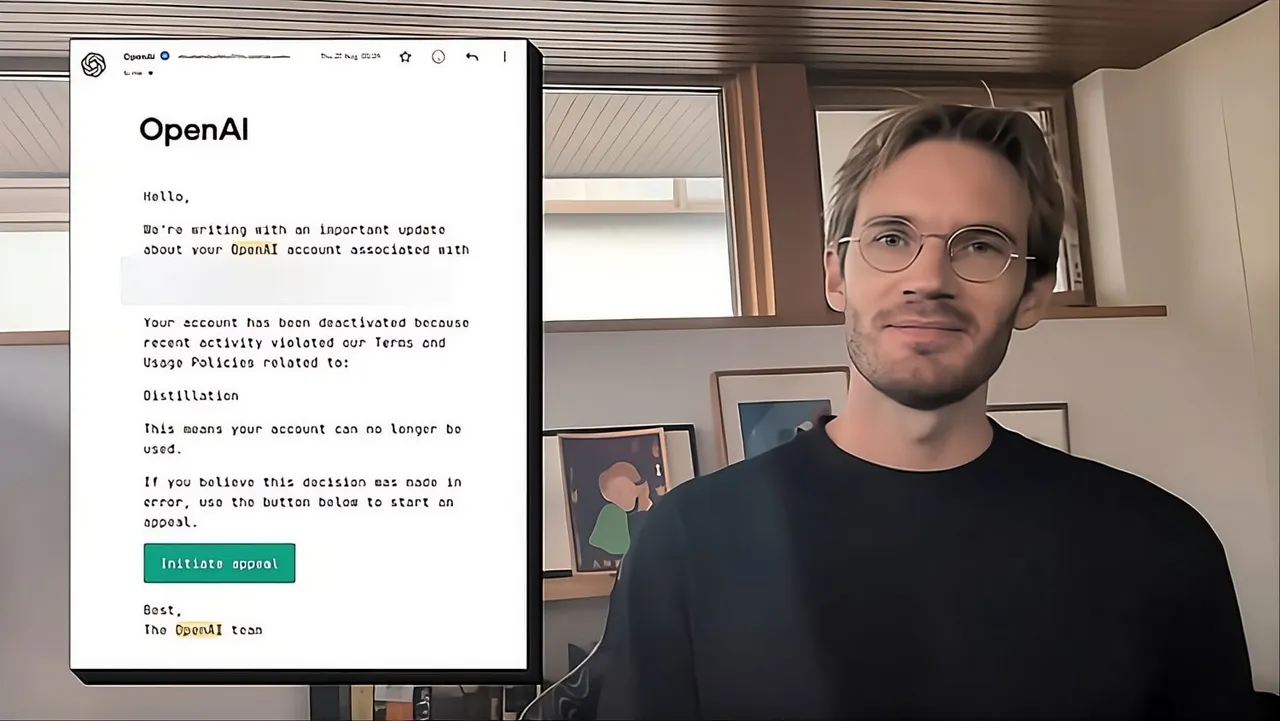
پیودیپای: موقع ساخت هوش مصنوعی اختصاصیام، OpenAI دو بار اکانتم را بست!
فلیکس شلبرگ یا همان پیودیپای معروف، بهتازگی مدل هوش مصنوعی محلی خود به نام Ajax را معرفی کرده، اما فاش ساخته که در مسیر توسعه آن، شرکت OpenAI دو بار حسابش را مسدود کرده است. او برای ساخت این مدل ۹ میلیارد پارامتری از تکنیک تقطیر استفاده کرده؛ موضوعی که زنگ خطر نقض قوانین سازنده ChatGPT را به صدا درآورده است.
طعنه سنگین سم آلتمن به آنتروپیک: نسبت دادن روح و دین به هوش مصنوعی خطرناکه!
سم آلتمن، مدیرعامل اوپنایآی، در اظهارنظری جنجالی به رویکرد شرکت رقیب یعنی آنتروپیک تاخت و نسبت دادن مفاهیم مذهبی و خودآگاهی به مدلهای هوش مصنوعی را یک تهدید امنیتی واقعی دانست. این اختلافنظر تازه پس از آن بالا گرفت که گزارشهایی از گفتوگوهای آنتروپیک با رهبران دینی برای تزریق اخلاق به مدلها منتشر شد. حالا دانشمندان ارشد هوش مصنوعی و حتی واتیکان هم به این مناقشه فلسفی کشیده شدهاند و درباره خطرات چنین رویکردی هشدار میدهند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.