کاهش چشمگیر حجم مدل ۹ میلیارد پارامتری به ۲.۴۲ گیگابایت با مدل جدید Prism ML
آزمایشگاه Prism ML از مدل زبانی و بصری Ternary-Bonsai-2-9B رونمایی کرد که با فشردهسازی پیشرفته، حجم یک مدل ۹ میلیارد پارامتری را از ۱۷.۹ گیگابایت به ۲.۴۲ گیگابایت کاهش میدهد و اجرای محلی آن را روی لپتاپها ممکن میسازد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- شرکت Prism ML با عرضه مدل Ternary-Bonsai-2-9B موفق شده است حجم مدل پایه Qwen3.5-9B را از ۱۷.۹ گیگابایت به ۲.۴۲ گیگابایت کاهش دهد.
- این مدل با ذخیره وزنها در قالب سه مقدار عددی، حجم فایل را حدود ۷.۴ برابر کوچکتر کرده و امکان اجرای محلی روی پردازندههای معمولی و تراشههای اپل را فراهم میکند.
- اجرای کوچکترین نسخههای این مدل نیازمند استفاده از نسخه سفارشی ابزار llama.cpp است و بهرهگیری از کل پنجره متنی ۲۶۲ هزار توکنی آن حافظه بیشتری مصرف میکند.
آزمایشگاه Prism ML مدل Ternary-Bonsai-2-9B را منتشر کرده است که یک مدل زبانی و بصری (VLM) کوانتیزهشده بر پایه Qwen3.5-9B بهشمار میرود. نسخه پیشفرض GGUF این مدل، هسته زبانی تقریباً ۸.۹۵ میلیارد پارامتری را از حدود ۱۷.۹ گیگابایت در دقت FP16 به ۲.۴۲ گیگابایت فشرده میکند، در حالی که اجزای پردازش تصویر آن بهصورت جداگانه عرضه میشوند. مخزن این مدل در پلتفرم Hugging Face بیش از ۸۹۶ هزار دانلود و ۳,۷۰۰ لایک را ثبت کرده است، هرچند آمارهای کل در این پلتفرم میتواند شامل دانلودهای تکراری و خودکار نیز باشد.
کاهش حجم فایلهای وزن مدل، طیف سختافزارهای قابل استفاده برای استنتاج محلی (Local Inference) را گسترش میدهد و اجرای آن را روی کارتهای گرافیک لپتاپ، تراشههای اختصاصی اپل و سیستمهای متکی بر پردازنده مرکزی (CPU) ممکن میسازد. با این حال، چند محدودیت در استقرار آن نقش دارند: کوچکترین فرمتهای این مدل نیازمند نسخه انشعابی (Fork) ابزار llama.cpp متعلق به Prism ML هستند، حافظه مصرفی در زمان اجرا از حجم فایل GGUF فراتر میرود و استفاده از تمام ظرفیت پنجره زمینه ۲۶۲,۱۴۴ توکنی، مصرف حافظه و تأخیر پاسخدهی را به میزان قابل توجهی افزایش میدهد.
چگونه ۹ میلیارد پارامتر در ۲.۴۲ گیگابایت جای میگیرد؟
این مدل زبانی ماتریسهای اصلی وزن خود را با مقادیر سهوضعیتی (Ternary) شامل {-1, 0, +1} بههمراه یک مقیاس مشترک FP16 برای هر گروه ذخیره میکند. این الگو بخشهای تعبیهسازی (Embeddings)، نگاشتهای توجه (Attention Projections)، نگاشتهای MLP و بخش خروجی مدل زبانی را پوشش میدهد. هستههای پردازشی سفارشی در حین استنتاج، این ساختار فشرده را مستقیماً میخوانند و از ایجاد یک کپی کامل با دقت FP16 از وزنها جلوگیری میکنند.
همچنین یک چرخش بلوکی هادامارد (Hadamard rotation) در وزنهای ذخیرهشده ادغام شده است و محیط اجرا، تبدیل متناظر را روی فعالسازیها (Activations) اعمال میکند. این چرخش مقادیر پرت و بزرگ را در ابعاد مختلف توزیع میکند و خطای کوانتیزاسیون ناشی از نگاشت وزنها به سه مقدار عددی را کاهش میدهد.
روش فشردهسازی | حجم فایل | ساختار چیدمان | پشتیبانی در زمان اجرا |
|---|---|---|---|
PTQ1_0 | ۲.۰۰ گیگابایت | تریتهای فشرده؛ کوچکترین فایل | نسخه سفارشی Prism ML |
PQ2_0 | ۲.۴۲ گیگابایت | جایگاههای دو بیتی؛ نسخه پیشفرض و سریعترین در بازگشایی | نسخه سفارشی Prism ML |
Q2_0 | ۲.۵۶ گیگابایت | ساختار سازگار با نسخه اصلی | نسخه سفارشی Prism ML و نسخه اصلی llama.cpp |
فایل پیشفرض PQ2_0 حدود ۷.۴ برابر کوچکتر از مدل زبانی ۱۷.۹ گیگابایتی با دقت FP16 است. البته این نسبت صرفاً مربوط به وزنهای زبانی روی دیسک است و بسته اختیاری پردازش تصویر، وضعیت پنجره متنی، بافرهای محاسباتی و سربار زمان اجرا را شامل نمیشود.
پنجره متنی ۲۶۲ هزار توکنی با محدودیتهای عملی
مطالب مرتبط و پیشنهادی
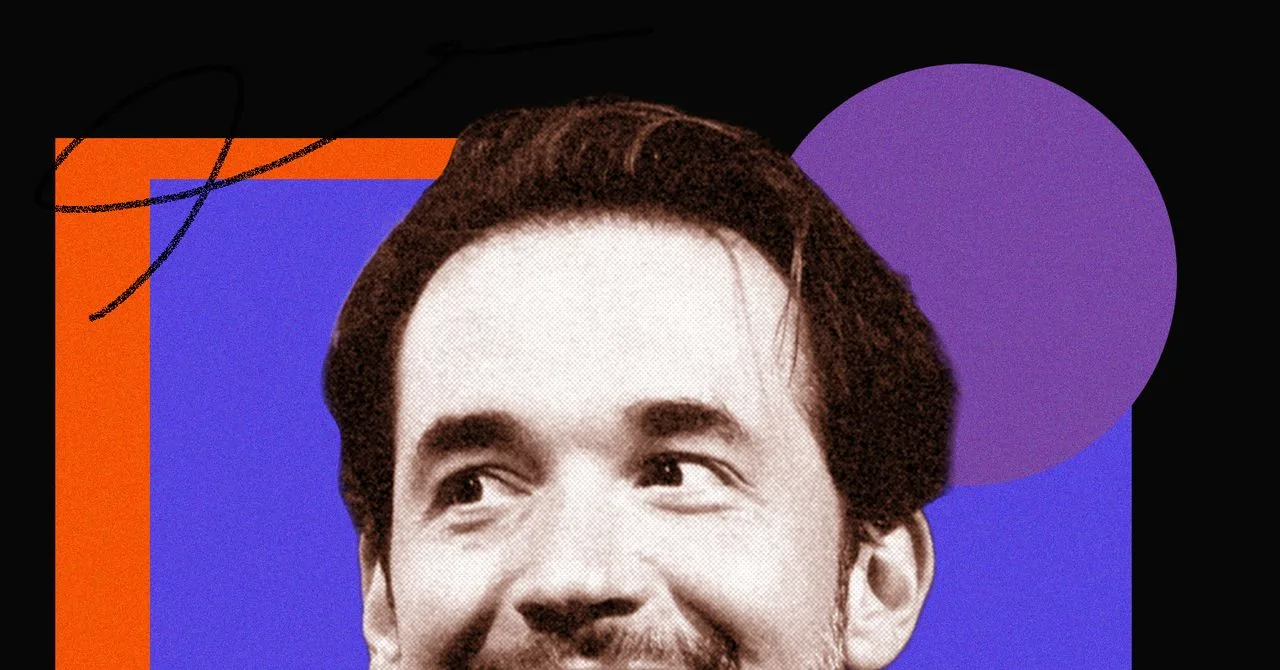
هشدار همبنیانگذار ردیت درباره تسخیر وب توسط هوش مصنوعی؛ دوران شبکههای اجتماعی سنتی به سر آمده است
الکسیس اوهانیان، همبنیانگذار ردیت، معتقد است نفوذ گسترده رباتها و محتواهای بیکیفیت هوش مصنوعی، اینترنت را از دست انسانها خارج کرده است. او پیشبینی میکند آینده وب برای ایجنتهای هوشمند ساخته میشود و گروههای گفتوگوی خصوصی جایگزین شبکههای اجتماعی فعلی خواهند شد.
رونمایی شرکت webAI از سیستم Meridian Air CivoE؛ ترکیب مدل پایه ۱۲ میلیارد پارامتری با متخصصان وظیفهمحور
شرکت webAI از سیستم هوش مصنوعی Meridian Air CivoE رونمایی کرد که یک مدل پایه ۱۲ میلیارد پارامتری ثابت را با ماژولهای متخصص برای وظایف مختلف ترکیب میکند. طبق گزارشهای این شرکت، این معماری توانسته است امتیاز بنچمارکها را از ۵۹٫۸ به ۸۵٫۵ ارتقا دهد و در پردازشهای تخصصی به عملکرد مدلهای پیشرو نزدیک شود.
پلتفرم dub از دستیار هوش مصنوعی Arlo برای ارزیابی سبدهای مالی رونمایی کرد
پلتفرم آمریکایی dub از دستیار هوش مصنوعی جدیدی به نام Arlo در اپلیکیشن خود رونمایی کرد که امکان تحلیل داراییها و ارزیابی ریسک سبدهای سرمایهگذاری را با زبان طبیعی برای کاربران فراهم میکند. این ابزار از طریق بازوی مشاورهای رسمی شرکت تحلیلها و پیشنهادهای مالی ارائه میدهد، اما بههیچوجه معاملات خودکار انجام نمیدهد و پولی جابهجا نمیکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.