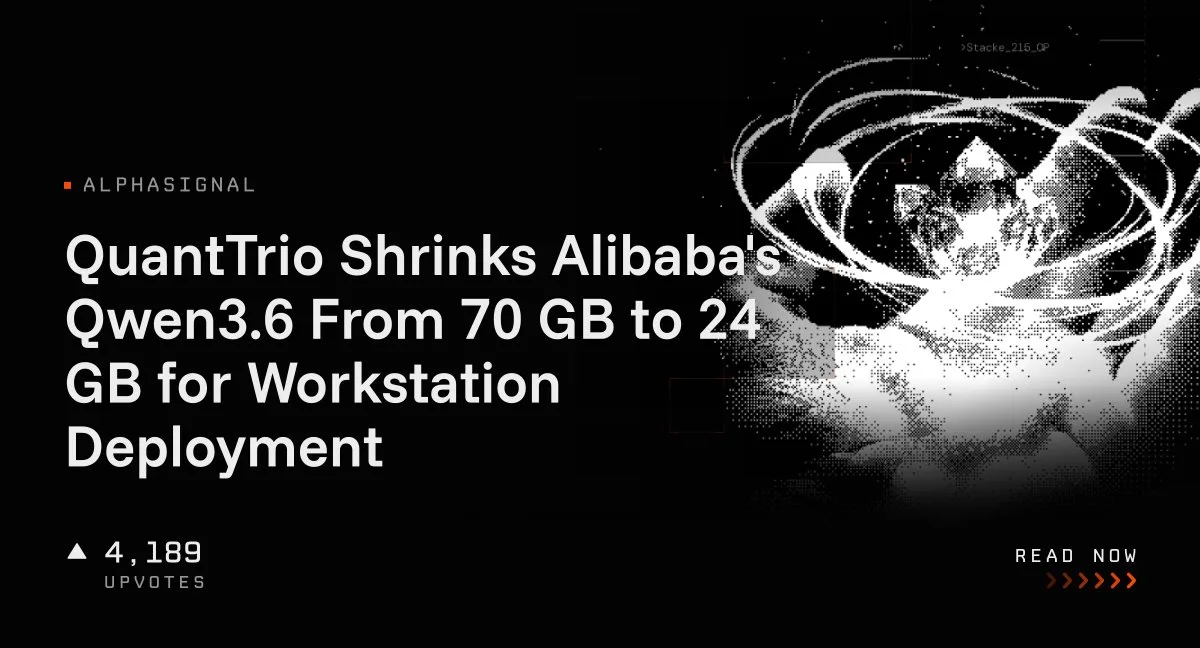
کاهش چشمگیر حجم مدل Qwen3.6 علیبابا از ۷۰ به ۲۴ گیگابایت؛ اجرای محلی روی ورکاستیشنها!
تیم QuantTrio نسخه ۴ بیتی و فشردهشده مدل قدرتمند Qwen3.6-35B-A3B علیبابا را منتشر کرد که حجم فایلهای وزنی آن را از حدود ۷۰ گیگابایت به ۲۴ گیگابایت میرساند. این بهینهسازی با تکنیک AWQ باعث شده اجرای این مدل چندکارشناسی (MoE) روی ورکاستیشنها و سیستمهای مجهز به کارتهای گرافیک در دسترستر، بسیار سادهتر و عملی شود. البته برای راهاندازی کامل این سرویس، علاوه بر وزنهای ۲۴ گیگابایتی، همچنان به حافظه ویدئویی (VRAM) اضافه برای پردازش و کش نیاز خواهید داشت.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم QuantTrio با استفاده از تکنیک فشردهسازی ۴ بیتی AWQ، حجم فایلهای وزنی مدل Qwen3.6 علیبابا را از ۷۰ گیگابایت به حدود ۲۴ گیگابایت رسانده تا اجرایش روی ورکاستیشنها حسابی راحتتر شود.
- این نسخه فشرده در پلتفرم هاگینگ فیس با استقبال فوقالعادهای روبهرو شده و تا الان بیش از ۷۸۸ هزار بار دانلود شده که نشاندهنده عطش بالای کاربران برای اجرای مدلهای سنگین با حافظه کمتر است.
- حواستان باشد که حجم ۲۴ گیگابایتی فقط مربوط به ذخیرهسازی وزنهای مدل است؛ برای اجرای زنده به حافظه گرافیکی (VRAM) بیشتری برای کش KV و بافرهای موقت نیاز خواهید داشت و یک کارت ۲۴ گیگابایتی به تنهایی کافی نیست.
عرضه نسخه ۴ بیتی AWQ برای مدل Qwen3.6-35B-A3B توسط QuantTrio
تیم QuantTrio یک مخزن AWQ را برای مدل Qwen3.6-35B-A3B منتشر کرده است؛ مدلی با وزنهای باز بر پایه معماری مخلوطی از کارشناسان (Mixture-of-Experts) از شرکت علیبابا. این نسخه ۴ بیتی، حجم فایلهای وزنی مدل را از حدود ۷۰ گیگابایت در فرمت BF16 به حدود ۲۴ گیگابایت کاهش میدهد. همین بهینهسازی باعث شده تا اجرای این مدل روی ورکاستیشنهای مجهز به چند پردازنده گرافیکی، یک جفت کارت ۴۸ گیگابایتی یا سرورهای معمولی، کاملاً عملی و شدنی شود.
این مخزن تا به حال بیش از ۷۸۸ هزار بار در هاگینگ فیس (Hugging Face) دانلود شده است. البته این رقم، تعداد درخواستهای دانلود فایل را میشمارد و لزوماً به معنی تعداد کاربران یکتا یا سیستمهای راهاندازیشده نیست؛ با این حال، نشاندهنده استقبال اولیه فوقالعاده کاربران از نسخهای است که حافظه بسیار کمتری نسبت به فایلهای وزنی اصلی میطلبد.
در شناسنامه مدل پایه، این اثر به عنوان اولین نسخه با وزنهای باز در خانواده Qwen3.6 معرفی شده است. این مدل در مجموع ۳۵ میلیارد پارامتر دارد، اما برای پردازش هر توکن تنها حدود ۳ میلیارد پارامتر را فعال میکند. علیبابا این مدل را تحت مجوز متنباز Apache 2.0 در دسترس عموم قرار داده است.
کاهش هزینههای راهاندازی با وزنهای ۴ بیتی
تکنیک AWQ که مخفف عبارت Activation-aware Weight Quantization (کوانتایزیشن وزنها بر اساس فعالسازی) است، وزن لایههای خطی پشتیبانیشده را با دقت ۴ بیتی ذخیره میکند، در حالی که در بخشهایی که زمان اجرا به دقت بالاتری نیاز دارد، دقت بیشتری را حفظ مینماید. این ترفند مصرف حافظه و پهنای باند را به شدت کاهش میدهد، هرچند ممکن است در مقایسه با نسخه باکیفیتتر BF16 افت کیفیت اندکی به همراه داشته باشد.
تیم QuantTrio این بیلد را با استفاده از فرآیند فشردهسازی بدون داده (Data-free Quantization) آماده کرده است؛ به این معنی که برای تعیین مقیاسهای کوانتایزیشن، هیچ مجموعه داده کالیبراسیونی را به مدل تزریق نکرده است. با این رویکرد، نیاز به دادههای کالیبراسیون از فرآیند ساخت حذف شده است، هرچند که استفاده از یک مجموعه کالیبراسیون دقیق و دستچینشده گاهی میتواند دقت خروجی را بالاتر ببرد.
مشخصه | پیکربندی اعلامشده |
|---|---|
فایلهای وزنی مدل | تقریباً ۲۴ گیگابایت |
رانتایم سرویسدهی | vllm>=0.19.0 |
نسخه ترنسفورمرز | transformers>=5.5.4 |
محیط محاسباتی CUDA | نسخه ۱۲.۸ یا ۱۳.۰ |
سقف کانتکست پیشنهادی | ۳۲٬۷۶۸ توکن |
مجوز انتشار (لایسنس) | Apache 2.0 |
باید به این نکته مهم توجه داشت که رقم ۲۴ گیگابایت صرفاً به وزنهای ذخیرهشده مدل اختصاص دارد. یک سرور فعال برای رسیدگی به درخواستها، به حافظه اضافهای برای کش KV، اکتیویشنها، نمودارهای محاسباتی CUDA، بافرهای موقت و پاسخگویی به درخواستهای همزمان نیاز دارد. بنابراین نباید تصور کرد که صرفاً چون حجم فایلها حدود ۲۴ گیگابایت است، یک کارت گرافیک ۲۴ گیگابایتی برای میزبانی کامل این سرویس کافی خواهد بود.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
عطش غولهای هوش مصنوعی برای برق؛ انرژی زمینگرمایی چطور سوگلی جدید سیاستمداران و شرکتهای فناوری شد؟
عطش دیتاسنترهای هوش مصنوعی برای تأمین برق پایدار و شبانهروزی، جان تازهای به صنعت انرژی زمینگرمایی دمیده است. این منبع پاک اکنون به نقطه توافقی کمسابقه میان دموکراتها و جمهوریخواهان در واشنگتن تبدیل شده و غولهای فناوری حاضرند برای دسترسی به آن مبالغ سنگینی پرداخت کنند.
چالش بزرگ شرکتها با هوش مصنوعی؛ ابزارها آمادهاند، اما نیروی متخصص کجاست؟
سازمانها برای عقب نماندن از رقابت با شتاب به سمت ابزارهای هوش مصنوعی هجوم آوردهاند، اما بزرگترین مانع آنها نه کمبود نرمافزار، بلکه بحران نیروی انسانی ماهر است. با همهگیر شدن مدلهای زبانی، خروجیهای هوش مصنوعی رو به یکنواختی رفتهاند و تنها با تفکر انتقادی، قضاوت انسانی و مهارتهای تخصصی میتوان از این فناوری یک مزیت رقابتی ساخت.
اپل: سیری نیازی به شکست ChatGPT ندارد؛ استراتژی متفاوت کوپرتینو در میدان هوش مصنوعی
در حالی که غولهای فناوری میلیاردها دلار صرف ساخت باهوشترین چتباتهای دنیا میکنند، اپل مسیر کاملاً متفاوتی را در پیش گرفته است. مدیرعامل این شرکت معتقد است سیری اصلاً نیازی به شکست دادن ChatGPT در مسابقه هوش ندارد، بلکه برگ برنده اصلی در اطلاعات شخصی نهفته روی آیفون شماست.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.