اجرای مدل ۱۷۷ میلیاردی Qwen روی مک ۶۴ گیگابایتی؛ ترفند شگفتانگیز Atomic Chat با اساسدی
تیم Atomic Chat با ابداع روشی خلاقانه و استفاده از حافظه پرسرعت SSD، موفق شد مدل عظیم ۱۷۷ میلیارد پارامتری Qwen3.8-Flash-Next را روی مک ۶۴ گیگابایتی با سرعت خیرهکننده ۳۶ توکن بر ثانیه اجرا کند. این دستاورد با انتقال جدول انگرم مدل به حافظه اساسدی و اختصاص رم یکپارچه به هسته محاسباتی ممکن شده و پیشنمایشی جذاب از معماری آینده Qwen4 به شمار میآید.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم Atomic Chat با انتشار کوانتایزهای GGUF مدل ۱۷۷ میلیاردی Qwen3.8-Flash-Next، اجرای روان آن را روی مک با تنها ۶۴ گیگابایت رم ممکن کرد.
- با انتقال جدول ۳۹ گیگابایتی انگرم (n-gram) به حافظه SSD و اختصاص رم یکپارچه به هسته محاسباتی، سرعت مدل به ۳۶ توکن بر ثانیه میرسد.
- برای جلوگیری از کرش حافظه گرافیکی در سیستمعامل مک، این جدول در یک پارت مجزا (Shard 2) قرار گرفته تا فشار به فریمورک Metal وارد نشود.
چطور مدل ۱۷۷ میلیاردی Qwen با فایل ۸۵ گیگابایتی روی مک ۶۴ گیگابایتی اجرا میشود؟
تیم Atomic Chat نسخههای کوانتایز شده GGUF از مدل قدرتمند Qwen3.8-Flash-Next را منتشر کرده است؛ نسخهای که با بهرهگیری از یک جدول جستجوی متکی بر اساسدی (SSD-backed lookup table)، فشار روی حافظه رم را به شکل چشمگیری کاهش میدهد. بر اساس گزارشهای این مخزن، نسخه کوانتایز شده ۸۵ گیگابایتی روی مک مجهز به تراشه M5 Max و تنها ۶۴ گیگابایت حافظه یکپارچه (Unified Memory)، به سرعت فوقالعاده ۳۶ توکن بر ثانیه دست یافته است؛ آن هم در حالی که تمام بخشهای بینایی ماشین مدل نیز بدون مشکل بارگذاری شدهاند.
مدل پایه با داشتن ۱۷۷ میلیارد پارامتر، طبق شناسنامه رسمیاش در واقع پیشنمایشی از معماری هیجانانگیز Qwen4 به حساب میآید. راز این دستاورد بزرگ در چیدمان نامتعارف پارامترهای آن نهفته است؛ یک جدول انگرم (n-gram) با حجم ۳۹ گیگابایت که برای تولید هر توکن تنها به چند کیلوبایت خواندن داده نیاز دارد. همین ترفند باعث شده تا بتوان این جدول را بهصورت Memory-map روی حافظه SSD نگه داشت و فضای ارزشمند حافظه یکپارچه را تمام و کمال به تانسورهای سنگین محاسباتی اختصاص داد.
چگونه یک فایل ۸۵ گیگابایتی در ۶۴ گیگابایت رم جا شد؟
این غول ۱۷۷ میلیاردی شامل یک جدول امبدینگ انگرم با ۵۱ میلیارد پارامتر است. برای تولید هر توکن، مدل توالی سه توکن اخیر را هش کرده و ۱۶ سطر که هرکدام شامل ۱۶۰ مقدار هستند را بیرون میکشد. این فرآیند جستجو در هر مرحله رفت محاسباتی (Forward pass)، تنها حدود ۲.۷ کیلوبایت داده منطقی را درگیر میکند که رقمی فوقالعاده ناچیز است.
با سرعت تولید ۳۶ توکن در ثانیه، این مقادیر درخواستی پهنای باند بسیار ناچیزی مصرف میکنند. از آنجا که صفحات حافظه ذخیرهسازی از بار مفید دادههای منطقی بزرگتر هستند، Atomic Chat ترافیک واقعی خواندن تصادفی از حافظه را حدود ۳ مگابایت بر ثانیه تخمین میزند. گزارشها نشان میدهد زمان دسترسی به حافظه NVMe SSD کمتر از ۱۰۰ میکروثانیه است، در حالی که بودجه زمانی تولید هر توکن به حدود ۲۸ میلیثانیه میرسد؛ یعنی این فرآیند هیچ افت سرعتی در اجرای مدل ایجاد نمیکند.
موفقیت این معماری مدیون یک فرمول هوشمندانه است: نسبت خواندن از این جدول برای هر توکن تقریباً یک پارامتر به ازای هر ۱۳ میلیون پارامتر است! از طرف دیگر، لایههای فعال معماری ترکیبی از متخصصان (MoE) حدود ۶ میلیارد پارامتر را فراخوانی کرده و گیگابایتها داده جابهجا میکنند که مشخصاً به رم پرسرعت و پهنای باند بسیار بالا نیاز دارد. بنابراین، اجرای متکی بر SSD تنها برای بانک جستجوی پراکنده به کار رفته و هسته اصلی و فعال مدل در همان حافظه یکپارچه پرسرعت مک مستقر مانده است.
البته تراشههای اپل سیلیکون یک محدودیت حیاتی در ساختار بخشبندی پارتها (Shard layout) به همراه دارند. ماجرا از این قرار است که وقتی یک پارت GGUF حاوی تانسورهای پردازنده گرافیکی باشد، کتابخانه llama.cpp کل محدوده حافظهنگاشت آن پارت را در اختیار فریمورک Metal قرار میدهد. ترکیب کردن جدول انگرم با وزنهای گرافیکی میتواند کل جدول را در حافظه قفل کند و در اولین تلاش برای پردازش توکن، خطای معروف kIOGPUCommandBufferCallbackErrorOutOfMemory رخ دهد. برای پیشگیری از این مشکل، تیم Atomic Chat این جدول را در پارت دوم (Shard 2) کاملاً ایزوله کرده است؛ به همین دلیل به کاربران توصیه میشود حتماً چیدمان پیشفرض پارتها را دستنخورده حفظ کنند.
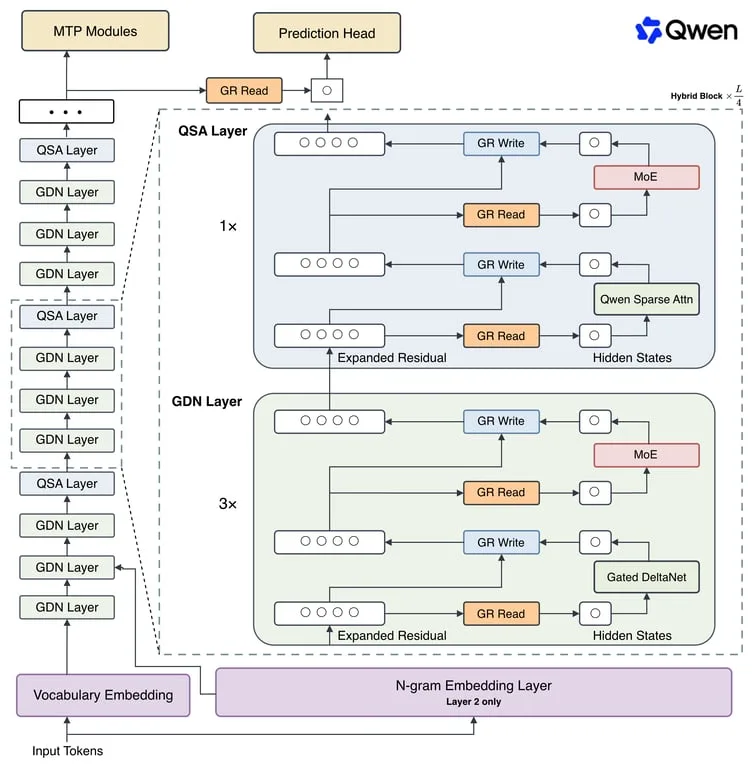
نگاهی به جزئیات معماری پیشنمایش Qwen4
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
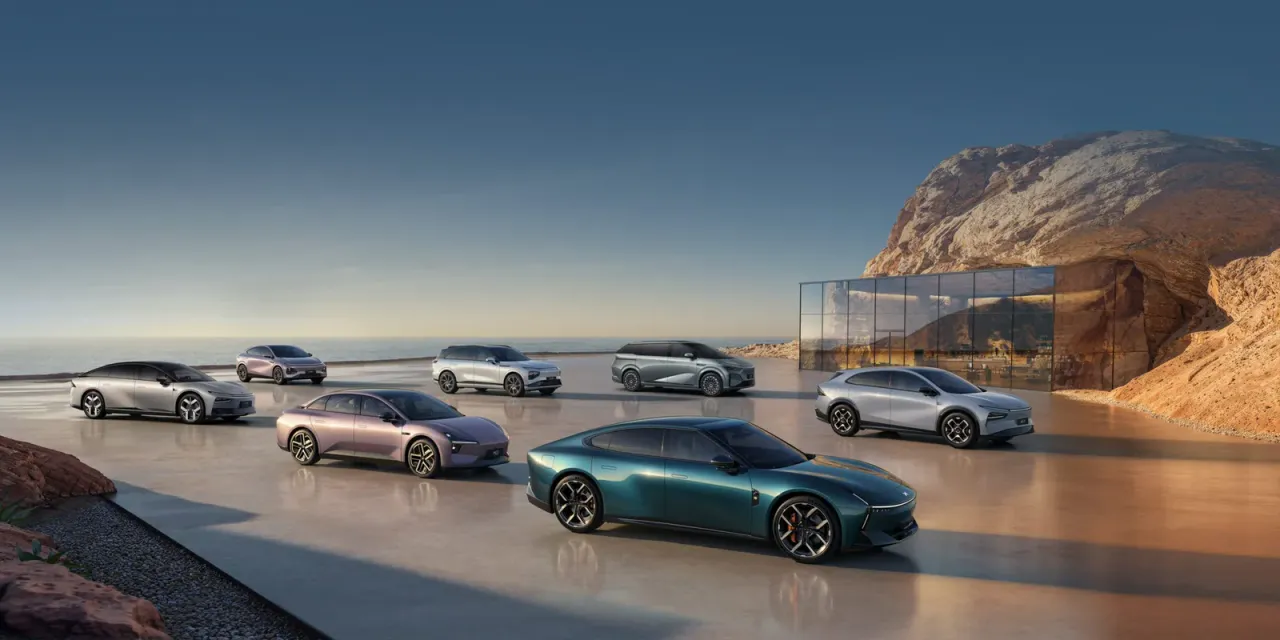
سیستم رانندگی خودران اکسپنگ سال ۲۰۲۷ به اروپا میآید؛ هوش مصنوعی چینی در جادههای قاره سبز
شرکت چینی اکسپنگ قصد دارد سیستم کمکراننده پیشرفته و خودران خود به نام NGP را در سال ۲۰۲۷ روانه خیابانهای اروپا کند و هماکنون مشغول رایزنی با رگولاتورهای محلی است. مهندسان این خودروساز با بهرهگیری از هوش مصنوعی توانستهاند این سیستم پیچیده را تنها ظرف دو هفته برای رانندگی در کشورهای جدید اروپایی بومیسازی کنند. اکسپنگ برنامه دارد پکیج کامل این فناوری را برای ناوبری خودکار در جادهها و شهرهای قاره سبز در دسترس رانندگان قرار دهد.
دستیار هوش مصنوعی LingGuang یک ایجنت شخصی میشود: ماجراجویی جدید گروه آنت با حافظه بلندمدت و پروتکل MCP
گروه آنت در حال آزمایش نسخه ارتقایافتهای از دستیار هوش مصنوعی LingGuang است که آن را از یک چتبات معمولی به یک ایجنت شخصی خودکار تبدیل میکند. این بهروزرسانی بزرگ با افزودن حافظه بلندمدت و توانایی انجام پیشدستانه وظایف، به ایجنت امکان میدهد تا مدیریت کارهای روزمره کاربران و تعامل با ابزارهای مختلف را به دست بگیرد. انتظار میرود این نسخه جدید با پشتیبانی از پروتکل MCP و اسکیلهای متنوع، در ماه اکتبر به صورت عمومی منتشر شود.
جذب سرمایه نجومی ۲.۳ میلیارد یوانی توسط Infinigence AI؛ رکوردشکنی چین در زیرساختهای هوش مصنوعی
استارتاپ چینی Infinigence AI در دور سرمایهگذاری سری C موفق به جذب ۲.۳ میلیارد یوان شد تا رکورد تازهای در توسعه زیرساختهای بومی هوش مصنوعی ثبت کند. مجموع منابع مالی این استارتاپ برآمده از دانشگاه چینهوا با این تامین مالی به ۴.۳ میلیارد یوان رسیده است. این شرکت روی یکپارچهسازی نرمافزاری پردازش تراشههای مختلف برای آموزش و اجرای مدلهای هوش مصنوعی تمرکز دارد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.