مدل شگفتانگیز RIDM از استارتاپ Reka: استخراج کلیدهای مخفی و حرکت دوربین از دل هر ویدیو!
استارتاپ رکا (Reka) با انتشار مدل معکوس و منبعباز RIDM، یکی از بزرگترین چالشهای توسعه مدلهای جهان را حل کرده است. این مدل هوشمند با تحلیل هر ویدیوی اولشخص میتواند کلیدهای حرکتی کیبورد و زاویه چرخش دوربین را با دقت بالا شناسایی کرده و ویدیوهای وب را به دادههای تعاملی تبدیل کند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- استارتاپ Reka از مدل جمعوجور و منبعباز RIDM رونمایی کرد؛ ابزاری که با تماشای هر ویدیوی اولشخص، کلیدهای فشردهشده کیبورد (مثل WASD) و زاویه چرخش سر و دوربین را حدس میزند.
- این مدل با تکیه بر جریان نوری (Optical Flow) و نادیده گرفتن بافت و رنگها، در ویدیوهای دنیای واقعی به دقت خیرهکننده ۸۵.۹ درصدی رسیده و مدلهای سنتی مبتنی بر پیکسل را کاملاً شکست داده است.
- با استفاده از این فناوری، میتوان میلیونها ویدیوی یوتیوب و دوربینهای گوپرو را بدون نیاز به لاگ دستی، به دادههای طلایی برای آموزش مدلهای جهان و هوش مصنوعی رباتها تبدیل کرد.
رونمایی رکا از RIDM؛ حدس زدن دکمههای کنترل از روی ویدیو!
مدلهای جهان تعاملی (Interactive World Models) برای یادگیری دقیق نیاز دارند ویدیوها را با همان دکمهها و فرمانهای کنترلی اولیهای که باعث تغییر صحنه شدهاند تطبیق دهند؛ اما مشکل اینجاست که در ویدیوهای معمولی اینترنت بهندرت لاگ یا تاریخچهای از دکمهها پیدا میشود. حالا استارتاپ رکا با معرفی مدل پویایی معکوس رکا (بهاختصار RIDM) و انتشار وزنهای آن تحت مجوز آپاچی ۲.۰، دستبهکار بزرگی زده است. توسعهدهندگان حالا میتوانند با این مدل جمعوجور، روی گیمپلیهای موجود، ویدیوهای یوتیوب و حتی تصاویر دوربینهای اکشن، برچسبهای کنترلی شبیهسازیشده ایجاد کنند.
وقتی یک کلیپ کوتاه اولشخص را به RIDM میدهید، این مدل احتمال فشرده شدن دکمههای گسستهای مثل W، A، S، D و حتی کلید Shift (برای دویدن یا تغییر سرعت حرکت) را محاسبه میکند. علاوه بر این، زاویه پیوسته چرخش به چپ و راست (Yaw) و بالا و پایین شدن دوربین (Pitch) را هم تخمین میزند. جالب است بدانید رکا مجموعه داده آموزشی RIDM را تماماً از روی گیمپلی بازیها ساخته و سپس انتقال موفق آن به ویدیوهای دنیای واقعی را بررسی کرده است؛ خروجی این مدل دقیقاً برای ناوبری اولشخص و کنترل زاویه دید دوربین بهینهسازی شده است.
کمبود لاگهای کنترلی؛ بزرگترین مانع ساخت مدلهای جهان
یک مدل جهان یاد میگیرد پیشبینی کند که محیط پس از انجام یک حرکت مشخص چه تغییری میکند؛ این قابلیت به سیستم آموزشی اجازه میدهد آیندههای احتمالی را برای کارهایی مثل تا کردن لباس یا فشردن حوله شبیهسازی کند. شبیهسازی دقیق و واقعی اینگونه تعاملات فیزیکی در محیطهای شبیهساز دستی فوقالعاده دشوار است. برای آموزش یک مدل تعاملی، تکتک تغییرات بصری باید با همان حرکتی که باعث شکلگیریشان شده جفت شوند؛ در حالی که اغلب ویدیوهای ضبطشده فقط تصاویر خام هستند و با برچسبگذاری دستی هم نمیتوان دکمهها و فرامین ورودی پنهان را بازسازی کرد.
اینجاست که مدل پویایی معکوس (Inverse Dynamics Model) وارد عمل میشود و بر اساس تغییرات بصری دیدهشده در ویدیو، محتملترین اکشن یا حرکت را حدس میزند. اجرای این مدل روی ویدیوهای برچسبنخورده، زنجیرهای از شبهاکشنهای تولیدی میسازد که میتوان آنها را در کنار فریمهای اصلی قرار داد و مستقیماً به سیستمهای آموزشی مدلهای جهان تزریق کرد.
جریان نوری؛ پلی هوشمند میان بازیهای ویدیویی و دنیای واقعی
تیم رکا دو معماری جمعوجور مختلف را تست کرده است: مدل اول که مبتنی بر پیکسل (Pixel) است، فریمهای خام ویدیویی را وارد بدنه کانولوشنی IMPALA میکند (همان مدلی که در پروژه VPT شرکت OpenAI برای ماینکرفت استفاده شده بود). در مقابل، مدل جریان (Flow) با استفاده از یک شبکه از پیش آموزشدیده و فریزشده RAFT-small، جفتفریمها را به جریان نوری (Optical Flow) تبدیل میکند و سپس یک ترنسفورمر قابلآموزش، بردار حرکات را پردازش میکند.
مدل | روش بازنمایی | تعداد پارامترها | وزنهای منتشرشده |
|---|---|---|---|
پیکسل (Pixel) | فریمهای خام از طریق IMPALA | ۹.۸ میلیون (همگی آموزشپذیر) | حدود ۳۹ مگابایت |
جریان (Flow) | جریان نوری با RAFT-small | ۲.۸ میلیون (۱.۸ میلیون آموزشپذیر) | حدود ۷.۲ مگابایت |
جریان نوری (Optical Flow) مسیر جابهجایی نقاط تصویر میان دو فریم متوالی را ثبت میکند و بخش عمده رنگها و بافتهای ظاهری را کنار میگذارد. به همین دلیل، حرکت دوربین در یک راهروی بازی ویدیویی و یک خیابان واقعی میتواند میدان جریان کاملاً مشابهی بسازد، حتی اگر در سطح پیکسلی هیچ شباهتی به هم نداشته باشند. حذف نشانههای ظاهری پیش از مرحله پیشبینی باعث میشود مدل روی گرافیک بازیها دچار بیشبرازش (Overfitting) نشود و در دنیای واقعی هم عالی جواب دهد.
ویدیوهای دنیای واقعی تفاوت مدلها را آشکار میکنند
نتایج طبقهبندی منتشرشده توسط رکا نشان میدهد که هر مدل چقدر در تشخیص حرکت به جلو، چرخش به چپ یا چرخش به راست موفق عمل میکند. علاوه بر این، یک آزمایش دوکلاسه جداگانه نیز دقت تشخیص جهت چرخش را سنجیده است.
مجموعه داده | وظیفه | مدل جریان (Flow) | مدل پیکسل (Pixel) |
|---|---|---|---|
ویدیوهای واقعی (۷۸ کلیپ) | حرکت به جلو، گردش به چپ یا گردش به راست | ۸۵.۹٪ | ۳۰.۸٪ |
ویدیوهای واقعی (۴۷ چرخش) | گردش به چپ یا راست | ۹۱.۵٪ | ۵۱.۱٪ |
دوربینهای گوپرو (۷۲ کلیپ) | حرکت به جلو، گردش به چپ یا گردش به راست | ۷۵.۰٪ | ۵۸.۳٪ |
ویدیوهای گیمینگ | حرکت به جلو، گردش به چپ یا گردش به راست | ۸۴.۵٪ | ۷۷.۵٪ |
در مجموع مقایسههای انجامشده میان شش پیکربندی مختلف، مدل جریان در پنج حالت با اقتدار پیروز میدان شد. بیشترین اختلاف ثبتشده مربوط به مجموعه ویدیوهای واقعی ۷۸ کلیپی است که مدل جریان ۵۵.۱ درصد از رقیب پیکسلی خود جلوتر ایستاد. تنها برتری مدل پیکسلی مربوط به تشخیص جهت چرخش در دوربینهای گوپرو بود که در آن توانست فقط یک کلیپ بیشتر را درست دستهبندی کند.
آموزش متعادل با فریمهای ویدیویی دقیق
تیم رکا گیمپلی بازیها را با وضوح ۷۲۰×۱۲۸۰ پیکسل و با نرخ ۴۸ فریم بر ثانیه ضبط کرد و برای تکتک فریمها، ۱۱ کلید کنترلی کیبورد، حرکات ماوس و زاویه دقیق دوربین را مستقیماً از موتور بازی استخراج کرد. از آنجا که در ویدیوهای خام، حرکت به جلو اکثریت مطلق فریمها را تشکیل میداد، پژوهشگران دادهها را در پنج دسته حرکتی جداگانه و متعادل نمونهبرداری کردند:
- حرکت به جلو (Forward): حدود ۱۰۵,۰۰۰ کلیپ با نگهداشتن کلید
Wو کمترین میزان جابهجایی دوربین. - چرخش دوربین (Turn): حدود ۱۰۵,۰۰۰ کلیپ بدون فشردن کلیدهای جهتنما و با چرخش زاویه دید حداقل ۱۰ درجه.
- حرکت به طرفین یا دندهعقب (Lateral or reverse): حدود ۵۳,۰۰۰ کلیپ با استفاده از کلیدهای
A،DیاS. - تغییر زاویه به بالا و پایین (Tilt): حدود ۱,۵۰۰ کلیپ که کمیابترین نوع حرکت ضبطشده بود.
- حرکت به پهلو همراه با چرخش (Lateral plus turn): حدود ۵۰,۰۰۰ کلیپ که در مرحله نهایی اضافه شد تا حرکت استریفینگ (حرکت به پهلو) را از چرخش ساده دوربین متمایز کند.
سیگنالهای ضعیف حرکتی؛ پاشنه آشیل مدل RIDM
خطاهای گزارششده در مدل RIDM معمولاً در ویدیوهایی رخ میدهد که جریان نوری در آنها وجود ندارد، حذف شده یا بیش از حد مبهم است:
- سیگنال ضعیف: فریمهای کاملاً ثابت یا فضاهای بسیار تاریک ممکن است باعث پیشبینی اشتباه چرخش شوند.
- حرکتهای متناقض: برداشتن گام به طرفین همزمان با چرخش دوربین در جهت عکس، میتواند مدل را در تشخیص جابهجایی خطی و چرخش گیج کند.
- تغییرات بزرگنمایی (Scale changes): زوم کردن به داخل یا خارج میتواند برای مدل شبیه حرکت به جلو یا عقب به نظر برسد.
- لرزشگیر دوربین (Stabilization): لرزشگیرهای خودکار در دوربینهای ورزشی و اکشن ممکن است پیش از رسیدن ویدیو به RIDM، چرخشها را خنثی یا حذف کرده باشند.
از آنجا که این موارد میدان حرکت را مخدوش یا دستکاری میکنند، خطوط لوله تولید باید احتمالات کلیدها را حفظ کرده و بخشهای مشکوک یا دارای ضریب اطمینان پایین را قبل از ورود به چرخه آموزش بازبینی کنند.
عرضه منبعباز با یک نکته مهم حقوقی درباره RAFT
وزنهای منتشرشده در هاگینگفیس (Hugging Face) در قالب استاندارد safetensors همراه با فایلهای config.json و اسکریپت اجرای inference.py در دسترس قرار گرفتهاند. حجم نسخه مبتنی بر جریان حدود ۷.۲ مگابایت و حجم نسخه پیکسلی نزدیک به ۳۹ مگابایت است.
رکا مدلهای RIDM را تحت مجوز آپاچی ۲.۰ منتشر کرده است. با این حال، نسخه جریان به وزنهای از پیشآموزشدیده RAFT-small در کتابخانه Torchvision وابسته است؛ وابستگیای که به دلیل شرایط استفاده از مجموعه دادههای آموزشیاش ممکن است محدودیتهایی برای استفاده تجاری ایجاد کند. بنابراین پروژههای تجاری باید این ضوابط حقوقی را بررسی کنند، هرچند مدل پیکسلی کاملاً مستقل بوده و هیچ وابستگیای به RAFT ندارد.
تبدیل ویدیوها به برچسبهای کنترلی؛ راهنمای گامبهگام توسعهدهندگان
توسعهدهندگان میتوانند با حفظ همگامی زمانی کلیپها و در نظر گرفتن هر خروجی به عنوان یک برچسب شبیهسازیشده (شبهبرچسب)، از RIDM در خط لوله دادههای خود بهره ببرند:
- تقسیم ویدیوهای اولشخص به پنجرههای زمانی متناسب با تنظیمات مدل انتخابی.
- اجرای مدل و استخراج احتمال کلیدهای گسسته به همراه مقادیر پیوسته چرخش و زاویه دید (Yaw و Pitch).
- الصاق هر خروجی تحلیلی به پنجره زمانی متناظر در ویدیو.
- فیلتر کردن یا بررسی دستی کلیپهای تاریک، بیحرکت، تثبیتشده با لرزشگیر، دارای زوم شدید یا حرکات متناقض.
- تزریق جفتدادههای تأییدشده ویدیو و اکشن به خط لوله آموزش مدلهای بعدی.
سیستمهای آموزشی مدلهای جهان و مدلهای ویدیویی کنترلپذیر میتوانند این برچسبهای همگامشده را به عنوان دادههای شرطیسازی استفاده کنند؛ همچنین پایپلاینهای سیاستگذاری ناوبری هم میتوانند از آنها برای پیشآموزش یا دستهبندی دادهها بهره ببرند. البته سیستمهای رباتیک تجسمیافته (Embodied AI) همچنان نیازمند نگاشت جداگانهای هستند تا فرمانهای اولشخص RIDM را به فضای محرکها و مفاصل ربات مقصد ترجمه کنند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
دوپامین مصنوعی و مغزهای هکشده؛ هوش مصنوعی مولد چطور سیمکشی تمرکز ما را به هم میریزد؟
رگبار نوتیفیکیشنها و سیستمهای هوش مصنوعی مولد با تولید مداوم «دوپامین مصنوعی»، ساختار شیمیایی و مدارهای تمرکز مغز انسان را دستخوش تغییر اساسی کردهاند. این سقوط دامنه توجه صرفاً یک مسئله شخصی نیست، بلکه با از بین بردن فرصتهای استراحت مغزی، امنیت شناختی و تفکر عمیق جامعه را در معرض تهدیدی جدی قرار داده است.
شتاب خیرهکننده مدل زبانی MiniCPM5 با دستیار ۳۲۴ میلیونی DSpark؛ جهش چشمگیر در تولید موازی توکنها
تیم OpenBMB با انتشار مدل کمحجم ۳۲۴ میلیون پارامتری DSpark، جهش بزرگی در سرعت استنتاج مدل زبانی MiniCPM5-2B ایجاد کرده است. این مدل با تکیه بر تکنیک هوشمندانه رمزگشایی گمانهزنانه، توکنها را به صورت دستهای حدس میزند تا فرایند پردازش با کمترین مصرف محاسباتی و بیشترین سرعت ممکن اجرا شود.
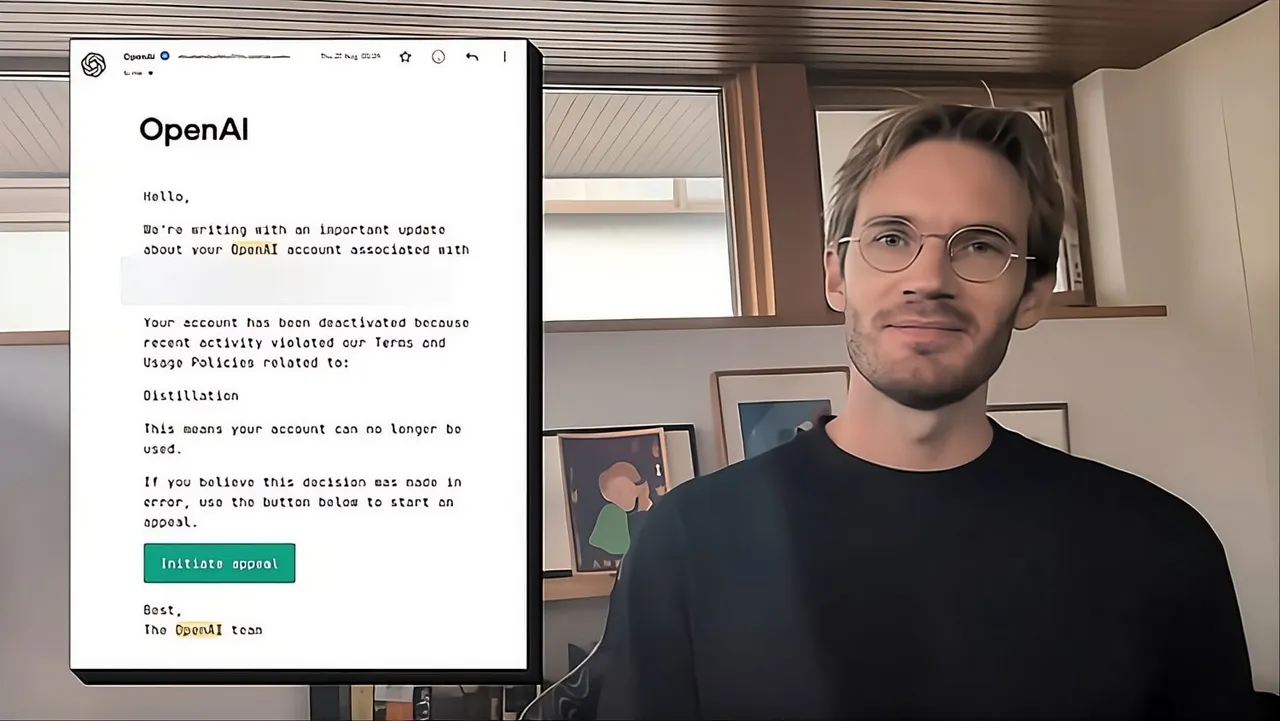
پیودیپای: موقع ساخت هوش مصنوعی اختصاصیام، OpenAI دو بار اکانتم را بست!
فلیکس شلبرگ یا همان پیودیپای معروف، بهتازگی مدل هوش مصنوعی محلی خود به نام Ajax را معرفی کرده، اما فاش ساخته که در مسیر توسعه آن، شرکت OpenAI دو بار حسابش را مسدود کرده است. او برای ساخت این مدل ۹ میلیارد پارامتری از تکنیک تقطیر استفاده کرده؛ موضوعی که زنگ خطر نقض قوانین سازنده ChatGPT را به صدا درآورده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.