مدل قدرتمند Qwen2.5-32B در فایل ۹ گیگابایتی؛ اجرای محلی غول هوش مصنوعی روی کارتهای گرافیک خانگی!
بارتوفسکی با ارائه ۲۷ نسخه کوانتایزشده از مدل قدرتمند Qwen2.5-32B در قالب فرمت محبوب GGUF، اجرای محلی این غول ۳۲ میلیارد پارامتری را سادهتر از همیشه کرده است. این فایلها از حجم جمعوجور ۹ گیگابایت شروع میشوند و نسخه پیشنهادی آن بهراحتی روی کارتهای گرافیک ۲۴ گیگابایتی خانگی قابل اجراست. حالا بدون نیاز به سرورهای گرانقیمت ابری، میتوانید یکی از باهوشترین مدلهای زبانی متنباز را مستقیماً روی سیستم شخصی خود به کار بگیرید.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- توسعهدهندهای به نام بارتوفسکی (Bartowski) کلکسیونی کامل از ۲۷ نسخه فشرده (GGUF) برای مدل قدرتمند Qwen2.5-32B-Instruct منتشر کرده که حجم آنها از ۹ تا ۶۵ گیگابایت متغیر است.
- نسخه Q4_K_M با حجم حدود ۱۹.۸ گیگابایت، نقطه طلایی این مجموعه است و به شکلی روان روی کارتهای گرافیک ۲۴ گیگابایتی معمولی (مثل RTX 3090 یا 4090) جا میشود.
- فشردهسازی این مدل با تکنیک پیشرفته ماتریس اهمیت (imatrix) در ابزار llama.cpp انجام شده تا با وجود کاهش چشمگیر حجم، هوش و دقت مدل در حل مسئله و کدنویسی افت نکند.
مجموعهای کاربردی از نسخههای GGUF برای اجرای محلی Qwen2.5-32B
اجرای یک مدل ۳۲ میلیارد پارامتری روی سیستمهای محلی معمولاً کار آسانی نیست و به حافظه ویدیویی (VRAM) سنگین، رم بالا یا فشردهسازیهای بسیار شدید نیاز دارد. حالا در مخزن GGUF بارتوفسکی در هاگینگ فیس، مدل Qwen2.5-32B-Instruct برای محیطهای سازگار با llama.cpp بستهبندی و آماده شده است؛ مجموعهای کامل از فایلهای فشرده که از نسخه فوقالعاده سبک ۹ گیگابایتی (IQ2_XXS) گرفته تا وزنهای تفکیکشده ۶۵ گیگابایتی با دقت F16 را شامل میشود.
در میان این گزینهها، فایل Q4_K_M تعادل ایدهآلی میان حجم و کیفیت ارائه میدهد؛ فایل وزنی ۱۹.۸۵ گیگابایتی آن در صورت تنظیم محافظهکارانه طول کانتکست و پردازش دستهای، بهخوبی روی کارتهای گرافیک ۲۴ گیگابایتی بازار جا میگیرد. گزینههای کوچکتر برای سیستمهایی با محدودیت شدید حافظه طراحی شدهاند، در حالی که نسخههای Q6_K، Q8_0 و F16 برای سیستمهای قدرتمندتر بالاترین دقت و شباهت به مدل اصلی را فراهم میکنند.
آمارهای ثبتشده در هاگینگ فیس نشان میدهد این پروژه حدود ۸۰۰ هزار بار دانلود شده و بیش از ۳۶۰۰ لایک دریافت کرده است. البته شمارنده دانلود تمام درخواستهای فایل، دریافتهای تکراری و اسکریپتهای خودکار را هم ثبت میکند، اما این ارقام بهخوبی توجه گسترده جامعه متنباز را نشان میدهد.
بر اساس توضیحات شناسنامه مدل پایه، با یک مدل دستورپذیر تحت مجوز آپاچی ۲.۰ (Apache 2.0) با ۳۲.۵ میلیارد پارامتر و ۶۴ لایه ترنسفورمر روبهرو هستیم. معماری فنی این مدل از انکودینگ موقعیتی RoPE، بلوکهای پیشخور SwiGLU، نرمالسازی RMSNorm، سازوکار توجه گروهبندیشده (GQA) و بایاس QKV بهره میبرد.
- کاربردهای اصلی: پیروی دقیق از دستورات، استدلال ریاضی، برنامهنویسی و کدنویسی، کار با دادههای ساختاریافته، تولید خروجی JSON و متون چندزبانه.
- پشتیبانی از زبانها: بیش از ۲۹ زبان زنده بر اساس اعلام تیم توسعه Qwen.
- فرمت پرامپت: ساختار Qwen ChatML با استفاده از توکنهای ویژه
<|im_start|>و<|im_end|>. - طول کانتکست اسمی: پشتیبانی از ورودی تا ۱۳۱,۰۷۲ توکن و تولید پاسخ تا ۸,۱۹۲ توکن.
- فرمت اجرای محلی: فایلهای GGUF شامل وزنها، متادیتای توکنایزر و الگوی گفتوگو (Chat Template).
در مستندات رسمی مدل اشاره شده که برای پردازش توالیهای طولانیتر از ۳۲,۷۶۸ توکن، فعالسازی روش مقیاسپذیری YaRN الزامی است؛ بنابراین اگر قصد دارید با کانتکستهای خیلی طولانی کار کنید، حتماً بررسی کنید که بیلد llama.cpp و تنظیمات اجرایی شما پیکربندی مناسب RoPE را اعمال کنند و سپس دقت بازیابی اطلاعات را در طول کانتکست مدنظرتان بسنجید.
بارتوفسکی برای ساخت این فایلهای فشرده از روش ماتریس اهمیت (imatrix) در llama.cpp استفاده کرده که جزئیات آن در راهنمای رسمی imatrix آمده است. در این روش، با استفاده از دادههای کالیبراسیون مشخص میشود کدام وزنها بیشترین تأثیر را روی خروجی مدل دارند؛ به این ترتیب ابزار کوانتایزیشن در بخشهای حساس، دقت بالاتری را حفظ میکند تا خطای محاسباتی به حداقل برسد و کیفیت خروجی مدل افت نکند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
فکر میکرد با جان بون جووی نامزد کرده و تا پای حراج خانهاش رفت؛ جولان کلاهبرداریهای عاشقانه با هوش مصنوعی
توسعه روزافزون هوش مصنوعی مولد و جعل هویت چهرههای مشهور، کلاهبرداریهای عاطفی را به یک تهدید مالی ویرانگر تبدیل کرده است. مستند افشاگرانه Super Scam Me با تمرکز بر شگردهای هولناک این شبکهها نشان میدهد که چگونه فریبخوردن در فضای مجازی میتواند زندگی و دارایی افراد را تا پای نابودی بکشاند.
تست جنجالی ایجنتهای هوش مصنوعی در کارهای روزمره؛ چرا از بین Dots، Spark و Muse فقط یکی سربلند شد؟
ایجنتهای جدید هوش مصنوعی وعده دادهاند کارهای خستهکننده روزمره را به دست بگیرند، اما در عمل چقدر موفقاند؟ در یک آزمایش میدانی جذاب، سه ایجنت سرشناس Dots از چتجیپیتی، Spark از جمینای و Muse از متا در ۵ چالش واقعی از خرید آنلاین تا پاکسازی ایمیلها محک خوردند. نتایج نشان میدهد که تا یک دستیار خودمختار بینقص هنوز فاصله داریم، اما یکی از این هوشهای مصنوعی فراتر از انتظار عمل کرده است.
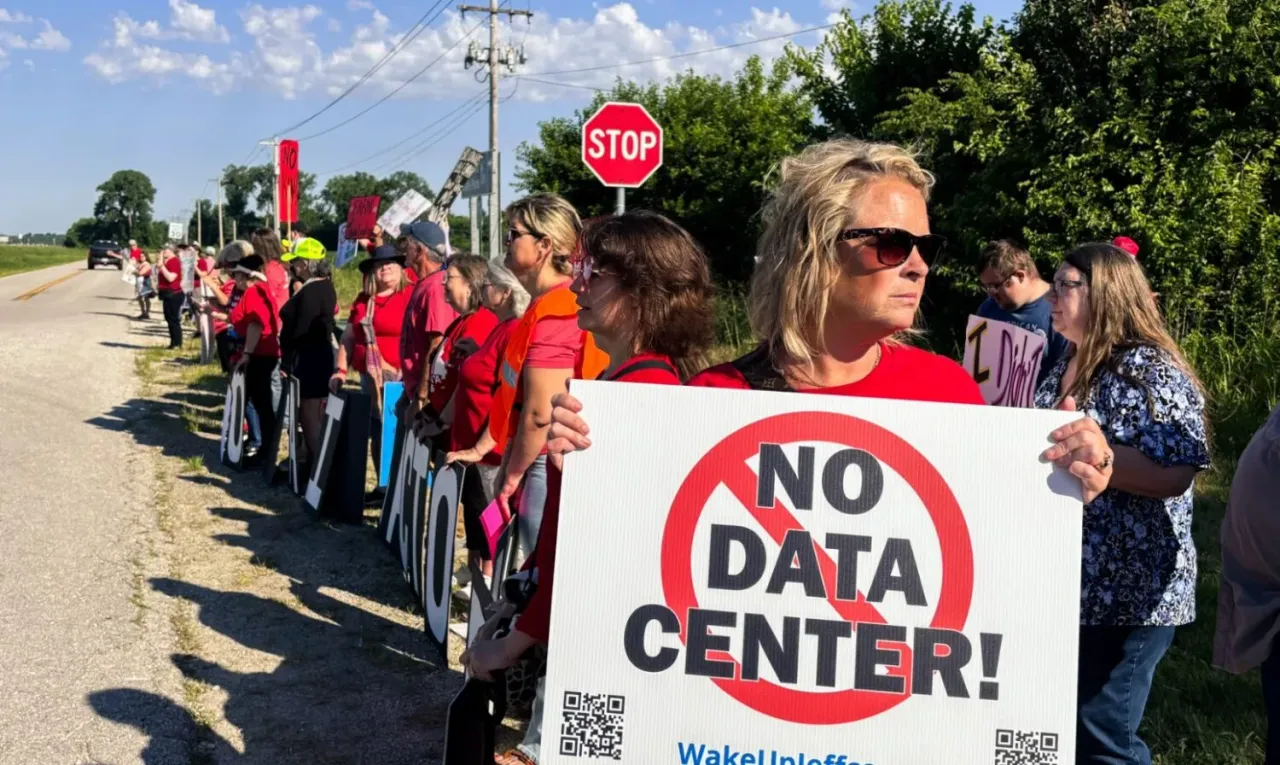
نه قاطع اهالی پنسیلوانیا به چک ۱۰ هزار دلاری: دیتاسنتر هوش مصنوعی آمازون پشت درهای بسته ماند
ساکنان محلی در پنسیلوانیا در تصمیمی غافلگیرکننده، پیشنهاد دریافت چکهای ۱۰ هزار دلاری برای ساخت یک دیتاسنتر عظیم متصل به آمازون را رد کردند و نشان دادند که پول نمیتواند جای شفافیت را بگیرد. این ماجرا باعث شد فرماندار ایالت رسماً ترمز اعطای مجوزهای سریع به دیتاسنترهای هوش مصنوعی را بکشد و قوانین سفتوسختتری وضع کند. حالا این پرونده به نقطه عطفی در چالش میان غولهای فناوری و جوامع محلی برای تأمین برق و آب زیرساختهای هوش مصنوعی تبدیل شده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.