بنچمارک تازه بنیاد سنتینت برای اثبات مالکیت مدلهای هوش مصنوعی؛ آیا اثرانگشت مدلها پاکشدنی است؟
با افزایش کپیبرداری و تقطیر مدلهای هوش مصنوعی، اثبات مالکیت معنوی آنها به چالش بزرگی تبدیل شده است. بنیاد سنتینت با راهاندازی بنچمارک و لیدربورد متنباز اثرانگشتگذاری، بستری فراهم کرده تا مشخص شود آیا نشانههای هویتی مدلها در برابر حملات و دستکاری رقبا واقعاً دوام میآورند یا خیر.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- بنیاد سنتینت بنچمارک و لیدربورد متنبازی راهاندازی کرده تا کارایی و مقاومت روشهای مختلف اثرانگشتگذاری روی مدلهای هوش مصنوعی رو زیر ذرهبین ببره.
- پژوهشهای تازه نشون میده برعکس تصور خیلیها، حتی اگر هزاران امضا و نشانهی رفتاری رو داخل یک مدل جاسازی کنیم، هکرها با حملات انطباقی میتونن بدون افت کیفیت، این اثرانگشتها رو کامل دور بزنن.
- سنتینت برای استانداردسازی این حوزه، فریمورک متنباز mlprints رو هم در گیتهاب منتشر کرده تا محققان بتونن روشهای اثبات مالکیت رو در شرایط واقعی محک بزنن و جلوی سرقت مدلها رو بگیرن.
توسعهدهندگان هوش مصنوعی این روزها سخت به دنبال راههایی هستند تا مبدأ و سازنده اصلی مدلها را مشخص کنند؛ اما پژوهشهای جدید نشان میدهد پاک کردن ردپای این روشهای اثرانگشتگذاری، خیلی راحتتر از آن چیزی است که سازندگانشان تصورش را میکردند.
این روزها که کپیکردن، دستکاری و بازنشر مدلهای هوش مصنوعی از همیشه سادهتر شده، اثبات اینکه یک مدل واقعاً از کجا آمده به دردسری پیچیده تبدیل شده است. وزنهای مدل (Model Weights) ممکن است دستبهدست بچرخند و هیچ رد و نشانهای از اسناد اولیهشان باقی نماند؛ از طرفی روشهایی مثل فاینتیونینگ (Fine-Tuning) و تقطیر دانش (Distillation) هم میتوانند سیستمهایی بسازند که اکثر قابلیتهای مدل اصلی را دارند، بدون اینکه کوچکترین نامی از سازنده نخستین در آنها دیده شود.
حالا لیدربورد اثرانگشتگذاری بنیاد سنتینت (Sentient Foundation) دقیقاً برای حل همین چالش وارد میدان شده تا معیاری باز و شفاف برای مقایسه تکنیکهای تشخیص هویت مدلها در اختیار جامعه هوش مصنوعی بگذارد. این پلتفرم ارزیابی میکند که این اثرانگشتها تا چه اندازه در برابر تلاشهای رقبا برای حذف شدن تاب میآورند و آیا خودِ این نشانهها باعث افت کارایی و سرعت مدل میشوند یا خیر.
این پروژه در ادامه تحقیقات دانشمندان بنیاد سنتینت و همکارانشان شکل گرفته که نشان داد تکنیکهای فعلی اثرانگشتگذاری، حتی وقتی در آزمونهای معمولی عملکرد بینقصی دارند، همچنان آسیبپذیرند. پژوهشگران در مقالهای با عنوان «آیا اثرانگشتهای مقاوم مدلهای زبانی بزرگ، در برابر حملات خصمانه هم دوام میآورند؟»، حملات تطبیقی و هوشمندانهای علیه ۱۰ روش شناختهشده اثرانگشتگذاری طراحی کردند و نتیجه غافلگیرکننده بود: تمام این روشها بدون آسیب به کارایی مدل، بهسادگی دور زده شدند!
این دستاوردها چالش بسیار بزرگتری را پیش پای دنیای هوش مصنوعی میگذارد: گنجاندن یک اثرانگشت در دل مدل یک ماجراست، اما مطمئن شدن از اینکه این ردپا در برابر کسی که عمداً قصد پاک کردنش را دارد پاک نمیشود، ماجرای کاملاً متفاوتی است.
در روش اثرانگشتگذاری مدلهای هوش مصنوعی، تلاش میشود تا مدل از طریق سیگنالهای پنهانی که درون رفتارش کاشته شده، شناسایی شود. این روشها به جای تکیه بر متادادهها، اسناد ثبتی یا لاگهای آموزشی که به راحتی قابل جعل و پاک شدن هستند، دنبال شواهد زندهای میگردند که بشود در یک مدلِ کپیشده و مشکوک محکشان زد.
رویکرد سنتینت به این صورت است که هنگام آموزش مدل، یکسری نشانهها و الگوهای رفتاری نامحسوس را درون آن جاسازی میکند. بعداً صاحب مدل میتواند پرامپتهای چالشی ویژهای را به مدلی که به دزدی بودنش شک دارد بفرستد و پاسخهای آن را برای پیدا کردن ردپای همان اثرانگشت اولیه تحلیل کند.
این سازوکار میتواند راه تازهای برای پیگیری منشأ مدلها و کشف کپیکاری باشد؛ با این حال، کارایی واقعی آن به این بستگی دارد که آیا این نشانههای هویتی پس از بازآموزی و دستکاریهای بعدی توسط دیگران، باز هم زنده میمانند یا خیر.
«ساچی کامیا»، مدیر توسعه و سرمایهگذاری بنیاد سنتینت، در این رابطه میگوید: «مدلهای هوش مصنوعی در حال تبدیل شدن به باارزشترین داراییهای معنوی جهان هستند؛ اما وقتی مدلی کپی یا تقطیر میشود، اثبات مالکیت آن فوقالعاده دشوار خواهد شد.»
کامیا در ادامه توضیح میدهد: «اثرانگشتگذاری، مدرک اثبات را مستقیماً درون خودِ مدل میگذارد؛ درست شبیه به امضاها و علائم مخفیانهای که نقاشان دوره رنسانس برای مشخص کردن اصالت تابلوهایشان لابلای لایههای رنگ پنهان میکردند.»
البته ماجرا فراتر از یک انتساب ساده نام سازنده است. توسعهدهندگانی که مدلهای خود را عمومی منتشر میکنند، معمولاً دلشان میخواهد فضا را برای آزمون و خطا باز بگذارند، اما بدون اینکه توانایی اثبات استفاده دیگران از دسترنجشان را از دست بدهند. تکنیکهای مطمئنتر اثبات اصالت به این هدف کمک میکنند؛ هرچند یک اثرانگشت به تنهایی لزوماً مالکیت حقوقی کامل را ثابت نمیکند و شاید در دادگاه به معنای قطعی غیرقانونی بودن کپی نباشد.
پژوهشهای ارائه شده در کنفرانس معتبر NeurIPS 2025 نشان داد که فناوری اثرانگشتگذاری میتواند در مقیاسهای بسیار بزرگ و حیرتآوری پیادهسازی شود.
در مقالهای با عنوان «اثرانگشتگذاری مقیاسپذیر در مدلهای زبانی بزرگ»، محققان متدی به نام Perinucleus را معرفی کردند که توانست ۲۴٬۵۷۶ اثرانگشت مجزا را بدون افت محسوس کیفیت، درون مدل لاما ۳.۱ نسخه ۸ میلیاردی شرکت متا (Llama 3.1 8B) بگنجاند. این تحقیق حتی بررسی کرد که این اثرانگشتها تا چه حد پس از فاینتیونینگ نظارتشده در مدل دوام میآورند.
این نتیجه نمایانگر یک گام رو به جلو است: اینکه یک مدل هوش مصنوعی میتواند شمار زیادی سیگنال شناسایی را در خود حمل کند، بدون اینکه با افت چشمگیر در قدرت و عملکرد مواجه شود.
اما واقعیت این است که تعداد بالای اثرانگشتها به خودی خود تضمین نمیکند که پاک کردن آنها کار سختی باشد. روشی که یک مهاجم برای دور زدن اثرانگشت به کار میگیرد، با شیوه یک پژوهشگر در شرایط آزمایشگاهی کنترلشده زمین تا آسمان فرق دارد.
همین تفاوت ظریف در پژوهش مربوط به حملات خصمانه علیه اثرانگشت مدلها زیر ذرهبین رفت. پژوهشگران متوجه شدند که تمام روشهای آزمایششده، از جمله متد اختصاصی Perinucleus سنتینت، همچنان در برابر حملات انطباقی و هدفمند آسیبپذیرند.
یافتهها ثابت میکنند موفقیت یک اثرانگشت در آزمایشهای عادی اصلاً نشاندهنده مقاومت آن در میدان واقعی و برابر مهاجمی که قصد دور زدنش را دارد نیست؛ چه بسا مدل کاربرد و هوش خود را کاملاً حفظ کند، در حالی که نشانه هویتی آن به کلی محو یا غیرقابل ردیابی شده است.
لیدربورد اثرانگشتگذاری دقیقاً با همین هدف متولد شده تا چارچوبی مشترک و عادلانه برای مقایسه تکنیکها و ارزیابی نقاط ضعف آنها در اختیار دانشمندان قرار دهد.
فرآیند ارزیابی این پلتفرم روی دو فاکتور اصلی تمرکز دارد: توانایی تزریق اثرانگشت بدون لطمه زدن به عملکرد مدل، و تستهای مقاومت خصمانه برای سنجش اینکه آیا این نشانهها پس از حملات عمدی برای حذف، باز هم قابل ردیابی میمانند یا نه.
سنتینت همچنین فریمورک mlprints را روی گیتهاب منتشر کرده است. این مخزن متنباز ابزارهای کاملی را برای پیادهسازی تکنیکهای اثرانگشتگذاری، اجرای انواع حملات، سنجش کارایی مدل و راستیآزمایی ردپاها در اختیار جامعه توسعهدهندگان میگذارد.
داشتن یک فریمورک مشترک بازتولید نتایج مقالات، آزمودن روشهای نو و شناسایی نقاط ضعف تکنیکهای مختلف را برای محققان بسیار سادهتر میکند. این کار به ایجاد استانداردهای یکپارچه در حوزهای کمک میکند که نتایجش به شدت به مدل انتخابی، نوع حمله و روشهای اعتبارسنجی وابسته است.
ارزش واقعی این بنچمارک به گستردگی تکنیکهایی که ارزیابی میکند، واقعگرایانه بودن حملات و تکرارپذیری نتایج توسط پژوهشگران مستقل گره خورده است؛ چون متدی که جلوی یک مدل حمله تاب میآورد، لزوماً در برابر ترفندهای دیگر مقاومت ندارد.
از این رو، آشکار کردن نقاط ضعف، بخشی کلیدی از این مسیر است؛ اگر پژوهشگران دقیقاً بفهمند که اثرانگشتها در چه نقطهای شکست میخورند، بهتر میتوانند روشهای سختجانتر و مقاومتری بسازند.
پرسش بنیادین این است: آیا اثبات مطمئنتر اصالت مدلها میتواند خیال سازندگان را برای انتشار عمومی فناوریهایشان و اجازه دادن به دیگران برای دستکاری آنها راحتتر کند؟
مدلهای باز به شرکتها و محققان این امکان را میدهند که سیستمهای موجود را برای کاربردهای جدید شخصیسازی کنند و نیازی به ساخت چرخ از ابتدا نداشته باشند. اما به محض اینکه وزنهای مدل دستبهدست شود، توسعهدهندگان تسلط بسیار کمی بر نحوه استفاده از آنها خواهند داشت و نمیدانند آیا هویت اصلی مدل بعد از تغییرات حفظ شده یا به سرقت رفته است.
اثرانگشتگذاری یک جایگزین جذاب برای حبس کردن مدلها پشت درهای بسته و سیستمهای دسترسی محدود است؛ به این معنی که سازندگان به جای تقلا برای جلوگیری از هرگونه کپیبرداری، میتوانند پس از انتشار عمومی، ریشه و منبع مدل را ردیابی و اثبات کنند.
کاربردهای احتمالی این تکنولوژی شامل بررسی استفادههای غیرمجاز، ساماندهی قراردادهای لایسنس و ارائه شواهد محکم از شجرهنامه مدلها است؛ هرچند عملی شدن این سناریوها مستقیماً به میزان قابل اعتماد بودن تکنیکها و شرایط جمعآوری شواهد بستگی دارد.
هدف بلندمدت این حوزه اما بسیار جاهطلبانهتر است: طراحی اثرانگشتی که آنچنان با تواناییها و عملکرد مدل تنیده شده باشد که هرگونه تلاشی برای حذف آن، به خودِ مدل هم آسیب جدی بزند و فلجش کند. رسیدن به این نقطه به پیوندی بسیار عمیقتر میان سیگنال هویتی و مغز محاسباتی مدل نیاز دارد که فعلاً روشهای امروزی به آن نرسیدهاند.
در حال حاضر، این تحقیقات و لیدربورد تازه به دنبال پاسخ به یک سؤال فوریتر هستند: به جای اینکه خامدستانه فرض کنیم صرف تزریق یک اثرانگشت کار تمام است، حالا توسعهدهندگان میتوانند مقاومت واقعی روشهای مختلف را در برابر حملات شبیهسازیشده به محک آزمون بگذارند.
با گسترش روزافزون انتشار مدلهای هوش مصنوعی، توانایی اثبات اصالت و مبدأ آنها نقشی حیاتی در حفظ مالکیت فکری پیدا خواهد کرد. در نهایت، اینکه اثرانگشتگذاری بتواند مدرکی قابل اعتماد ارائه دهد، کمتر به تعداد نشانههای کاشتهشده در مدل، و بیشتر به این بستگی دارد که آیا این نشانهها میتوانند از زیر تیغ حملات هوشمندانه جان سالم به در ببرند یا خیر.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
ایجنتهای هوش مصنوعی فلوکر به کمک تیمهای فروش آمدند؛ خداحافظی با جستوجوی دستی مشتریان
پیدا کردن مشتریان جدید و جستوجوی مداوم مشخصات آنها در لینکدین و وب، همیشه کاری وقتگیر و کلافهکننده برای تیمهای فروش بوده است. استارتاپ فلوکر (Floqer) با ارتشی از ایجنتهای هوش مصنوعی وارد میدان شده تا فرایند شناسایی مشتریان، اعتبارسنجی اطلاعات تماس و بهروزرسانی دادههای CRM را کاملاً خودکار کند. این استارتاپ پس از رسیدن به درآمد سالانه ۱.۲ میلیون دلاری، حالا قصد دارد فناوری خود را بهصورت متنباز در اختیار همگان قرار دهد.
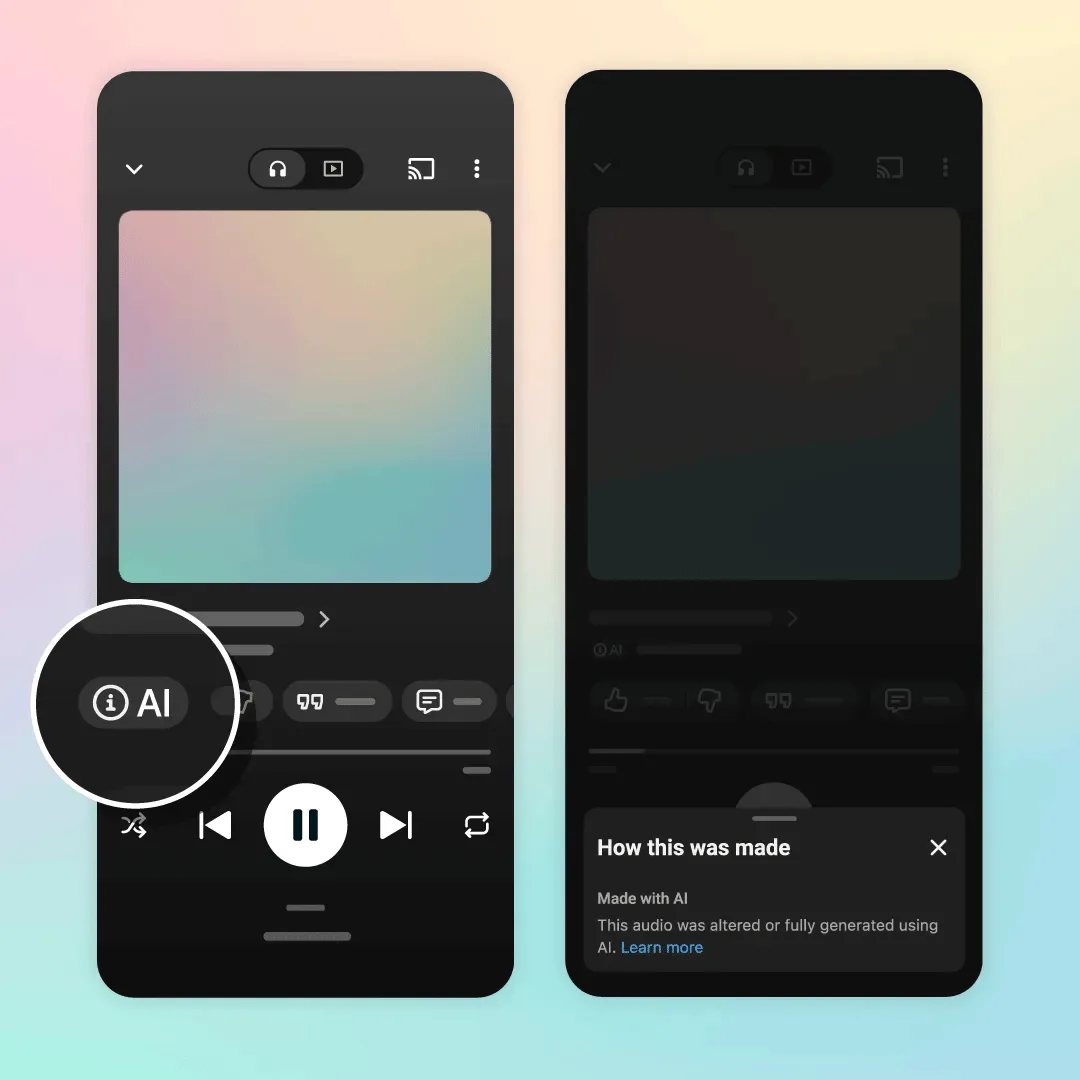
سیل آهنگهای هوش مصنوعی در پلتفرمهای استریم؛ یوتیوب موزیک سیستم برچسبگذاری جدید را کلید زد
با افزایش چشمگیر تولید موسیقی با هوش مصنوعی و ورود موج عظیمی از این قطعات به سرویسهای پخش، یوتیوب موزیک سیستم برچسبگذاری جدیدی برای شفافسازی نحوه ساخت قطعات معرفی کرد. از این پس کاربران میتوانند با مشاهده برچسب ویژه در صفحه پخش، بهراحتی تشخیص دهند که یک آهنگ بهطور کامل یا جزئی توسط ابزارهای هوش مصنوعی ساخته شده است.
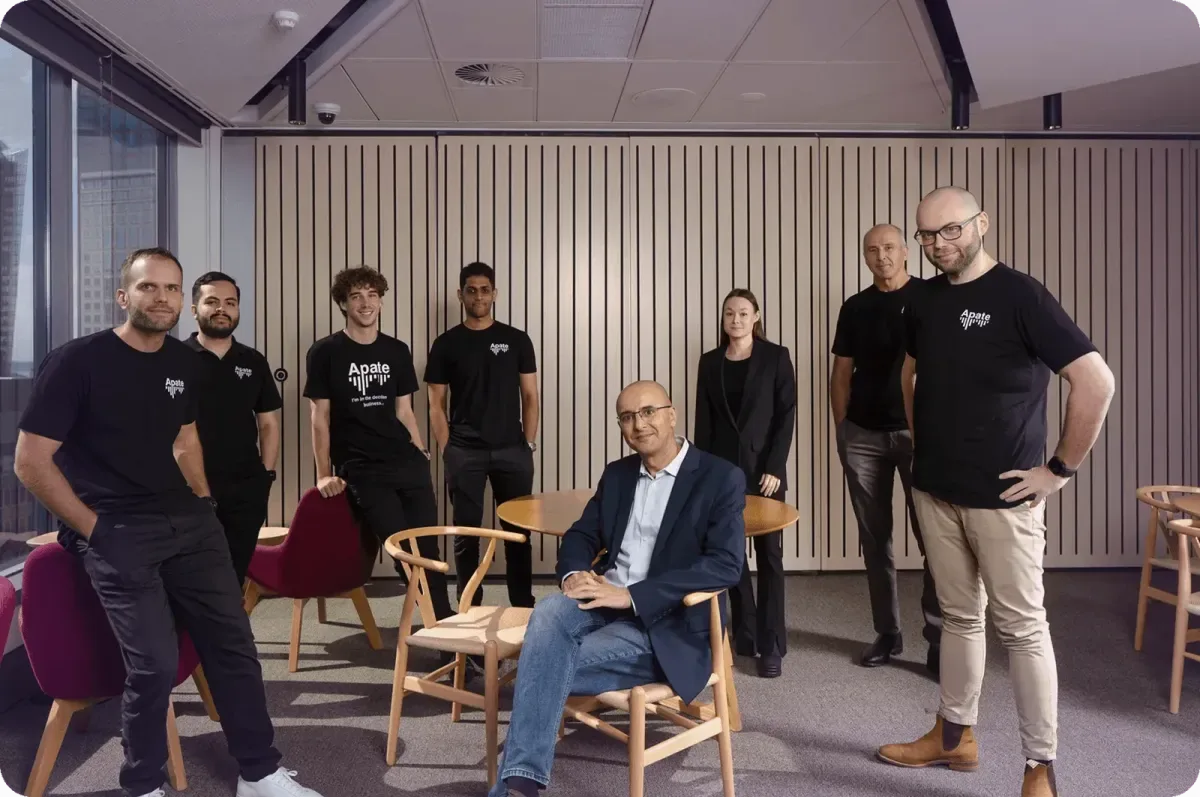
دستانداز هوشمندانه آپاتی پیش پای شیادان: ایجنتهای هوش مصنوعی که عمداً فریب میخورند تا مچ کلاهبردارها را بگیرند!
در حالی که بیشتر شرکتها از هوش مصنوعی برای توسعه سریعتر محصولات یا خودکارسازی امور استفاده میکنند، استارتاپ استرالیایی آپاتی (Apate) ارتشی از ایجنتهای هوشمند را به عنوان طعمه به دل ارتباطات مشکوک میفرستد. این ایجنتها با سرگرم کردن شیادان، تا امروز ۱۷ سال از وقت باارزش آنها را تلف کرده و با استخراج اطلاعات حساسی مثل شماره حسابها و کیفپولهای دیجیتال، سدی نفوذناپذیر در اختیار بانکها و سازمانهای امنیتی قرار دادهاند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.