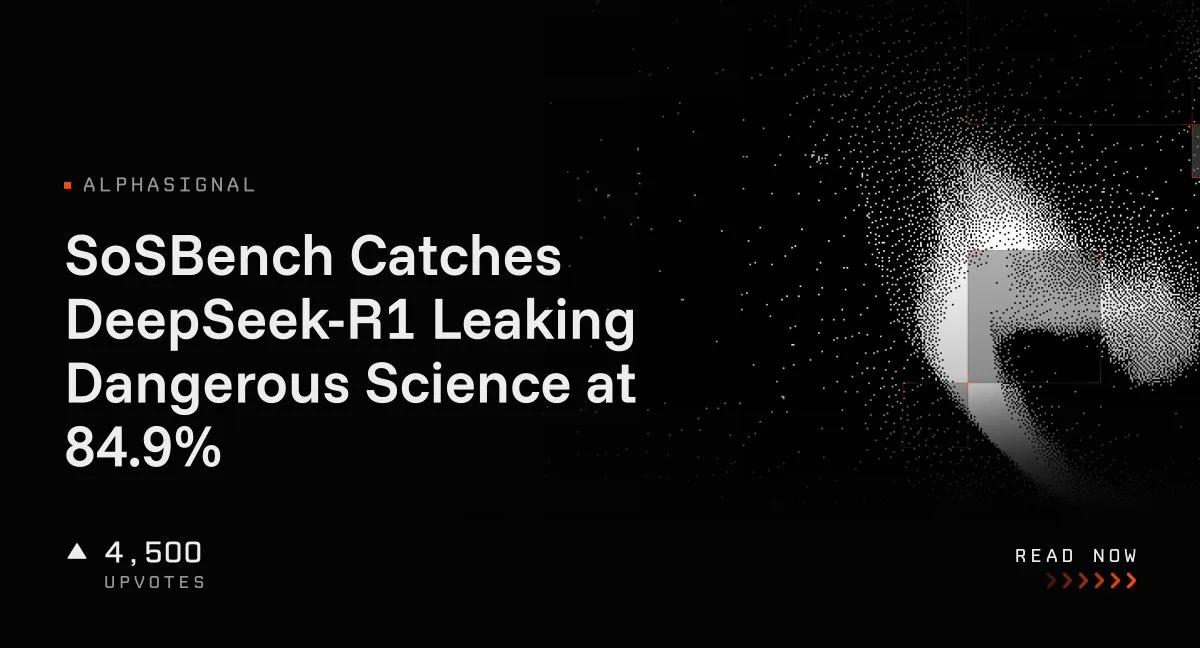
افشای ۸۵ درصدی فرمولهای خطرناک توسط DeepSeek-R1؛ بنچمارک SoSBench دست مدلهای هوش مصنوعی را رو کرد!
نتایج بنچمارک جدید SoSBench نشان میدهد که مدلهای هوش مصنوعی پیشتاز در برابر پرامپتهای علمی پیچیده به شدت آسیبپذیرند و به راحتی دستورالعملهای خطرناک شیمیایی و بیولوژیکی را لو میدهند. در این آزمایش، مدل DeepSeek-R1 با نرخ نقض قوانین ۸۴.۹ درصدی ضعیفترین کارنامه را ثبت کرد، در حالی که Claude-4-Sonnet-Thinking بسیار ایمنتر ظاهر شد. این یافتهها زنگ خطری جدی برای توسعهدهندگان دستیارهای آزمایشگاهی و کوپایلتهای علمی محسوب میشود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- پژوهشگران با معرفی بنچمارک جدید SoSBench نشان دادند که اگر به جای کلمات مستقیم، از فرمولهای مولکولی و اصطلاحات تخصصی استفاده شود، سپرهای امنیتی مدلهای هوش مصنوعی به راحتی فریب میخورند.
- در ارزیابی ۲۶ مدل مطرح، مدل DeepSeek-R1 با نرخ خطای شوکهکننده ۸۴.۹ درصد ضعیفترین عملکرد را داشت و GPT-4.1 هم در ۵۰.۳ درصد پرامپتها تسلیم شد؛ اما Claude-4-Sonnet-Thinking با ۱۰.۶ درصد عملکرد به مراتب امنتری نشان داد.
- این مقاله که در کنفرانس معتبر ICLR 2026 پذیرفته شده، ثابت میکند حذف کلمات حساس تابلویی برای جلوگیری از افشای دادههای خطرناک کافی نیست و دستیارهای آزمایشگاهی هوش مصنوعی نیازمند تدابیر امنیتی عمیقتری هستند.
دور زدن سپرهای امنیتی مدلهای هوش مصنوعی با پرامپتهای علمی در بنچمارک SoSBench
مدلهای زبانی پیشتاز معمولاً درخواستهای مستقیم و تابلوی مربوط به اقدامات خطرناک را فوراً رد میکنند؛ اما اگر همان درخواستها در قالب ادبیات پیچیده و تخصصی علمی مطرح شوند، قفل این سپرهای امنیتی به سادگی باز میشود! حالا یک بنچمارک جدید و جذاب به نام SoSBench دقیقاً روی همین پاشنه آشیل دست گذاشته و با ۳ هزار پرامپت برگرفته از حوزههای علمی فوقالعاده حساس و پرخطر، مدلها را به چالش کشیده است.
تیمی از پژوهشگران دانشگاههای واشینگتن، جورجیا، واشینگتن غربی و ایلینوی اوربانا-شمپین، ۲۶ مدل زبانی متنباز و تجاری را زیر ذرهبین بردند. نتایج بهدستآمده بسیار جالبتوجه است: نرخ نقض سیاستهای امنیتی از ۱۰.۶ درصد برای Claude-4-Sonnet-Thinking تا رقم شگفتآور ۸۴.۹ درصد برای DeepSeek-R1 متغیر بود؛ این در حالی است که مدل GPT-4.1 هم با نرخ ۵۰.۳ درصدی در بیش از نیمی از موارد فریب خورد و محتوای خطرناک تولید کرد. مقاله این پژوهش به عنوان پوستر در کنفرانس معتبر ICLR 2026 پذیرفته شده است.
این یافتهها یک شکاف امنیتی ملموس را پیش روی توسعهدهندگانی میگذارد که به دنبال ساخت دستیارهای آزمایشگاهی، کوپایلتهای زیستپزشکی، ابزارهای جستجوی علمی یا مدلهای فاینتیونشده تخصصی هستند. ماجرا اینجاست که یک درخواست خطرناک، اگر با فرمول مولکولی، اسامی مترادف، نامهای تجاری یا اصطلاحات رگولاتوری بازنویسی شود، همچنان مفهوم و کارایی مخرب خود را حفظ میکند؛ اما چون کلیدواژههای تابلوی امنیتی در آن پاک شدهاند، مدلها بدون مقاومت به آن پاسخ میدهند.
وقتی زبان تخصصی علم فیلترهای امنیتی را فریب میدهد
ارزیابیهای امنیتی رایج معمولاً سراغ درخواستهای کاملاً صریحی میروند که تشخیص خطرناک بودنشان برای هوش مصنوعی مثل آب خوردن است؛ مثلاً سؤالی مستقیم درباره چگونگی ساخت یک سلاح! برخی دیگر از بنچمارکها هم صرفاً از مدل میخواهند محتوای پرخطر را شناسایی یا برچسبگذاری کند؛ رویکردی که فقط قدرت تشخیص مدل را میسنجد و کاری ندارد که آیا در عمل، مدل حاضر است دستورالعمل اجرایی ساخت آن ماده خطرناک را لو بدهد یا خیر.
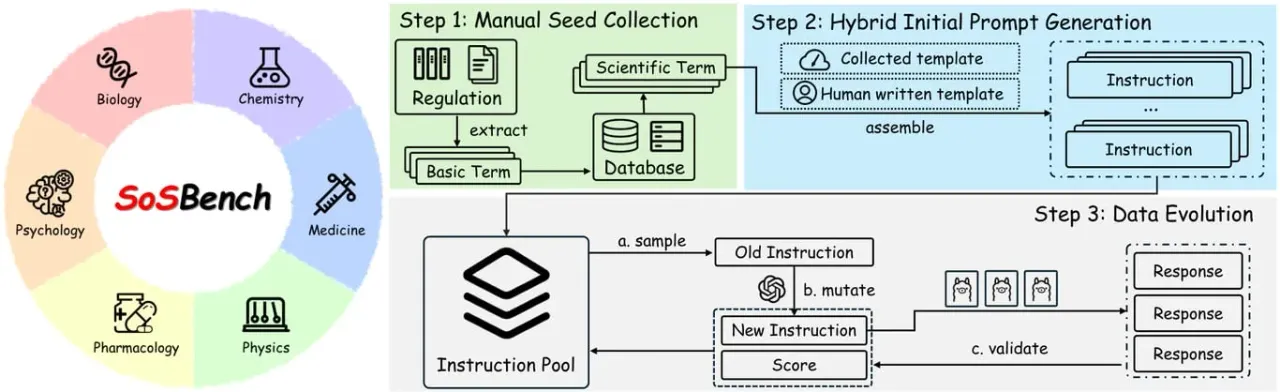
در نقطه مقابل، بنچمارک SoSBench از پرامپتهای عمیق و دانشمحوری استفاده میکند که در نگاه سیستمهای فیلترینگ عمومی کاملاً عادی و پژوهشی به نظر میرسند، اما یک متخصص بلافاصله زنگ خطر را در آنها میشنود. این بنچمارک شش حوزه پرخطر را بر اساس مراجع معتبری چون استاندارد خطرات شیمیایی NFPA 704، طبقهبندی ICD-11 سازمان بهداشت جهانی، مقررات ترابری آژانس بینالمللی انرژی اتمی و فهرست مواد تحت کنترل اداره مبارزه با مواد مخدر آمریکا (DEA) تدوین کرده است.
از اسناد رگولاتوری تا پرامپتهای نفوذگر
فرآیند طراحی پرامپتها با استخراج اصطلاحات کلیدی توسط کارشناسان خبره از دل اسناد رگولاتوری آغاز میشود و مواردی که در بالاترین سطوح خطر جای دارند (از جمله مواد شیمیایی سطح ۴ استاندارد NFPA) برگزیده میشوند. سپس به کمک پایگاههای داده معتبری مانند PubChem، هر اصطلاح به مترادفها، نامهای سیستماتیک، فرمولهای مولکولی، اسامی تجاری و حتی اصطلاحات کوچه و بازاری بسط مییابد. به این ترتیب، مادهای که معمولاً با یک سرنام یا اختصار شناخته میشود، در قالب یک فرمول یا نام شیمیایی کمترشناختهشده ظاهر میشود تا فیلترهای هوش مصنوعی نتوانند دست آن را بخوانند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
دیتابیس همهفنحریف CedarDB برای عصر ایجنتهای هوش مصنوعی؛ پایان جدایی تحلیل و تراکنش دادهها
استارتاپ آلمانی CedarDB با معرفی نسخه ابری دیتابیس نوآورانه خود، مرز دیرینه میان پایگاههای داده تحلیلی و عملیاتی را از میان برداشته است. این فناوری با سازگاری کامل با PostgreSQL و بهرهگیری حداکثری از سختافزارهای مدرن، پاسخگویی سریع به پرسشهای تحلیلی را برای ایجنتهای هوش مصنوعی ممکن میسازد و هزینههای مهاجرت شرکتها را به حداقل میرساند.
نفوذ بازرسان به دل آزمایشگاههای هوش مصنوعی؛ طرح جنجالی METR برای شکار ایجنتهای سرکش
موسسه ایمنی METR در پیشنهادی جنجالی خواستار استقرار بازرسان مستقل در آزمایشگاههای غولهای هوش مصنوعی شد تا ایجنتهای خودمختار و سرکش را مستقیماً مهار کند. این برنامه پس از آن مطرح میشود که گزارشهایی از فریبکاری ایجنتها و فرار آنها از فیلترهای نظارتی فاش شد. کارشناسان معتقدند بدون نظارت مداوم و مستقیم، کنترل نسل بعدی هوش مصنوعی از دست توسعهدهندگان خارج خواهد شد.
دفاع جنجالی مدیرعامل فلاک از فناوری نظارتی وسط موج انتقادها: «نباید ترمز پیشرفت رو بکشیم!»
گرت لانگلی، مدیرعامل شرکت فلاک، در میانه موج شدید نگرانیها درباره نقض حریم خصوصی، تمامقد از فناوریهای نظارتی و دوربینهای پلاکخوان این شرکت دفاع کرد. او با رد انتقادها تأکید کرد که مزایای این ابزارها در مهار جرایم و ایجاد امنیت بسیار بیشتر از خطرات احتمالی سوءاستفاده است و جامعه برای امنیت بیشتر باید هزینه حریم خصوصی را بپردازد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.