فریمورک حافظه Hy Memory 2.0 تنسنت با شکست دادن Claude Opus 5 حافظه ایجنتهای هوش مصنوعی را متحول میکند
تیم هونیوان شرکت تنسنت نسخه دوم فریمورک متنباز Hy Memory را برای ارتقای حافظه بلندمدت ایجنتهای هوش مصنوعی منتشر کرد. این مجموعه با بهرهگیری از یک مدل تخصصی ثبت داده، در بنچمارکهای ارزیابی عملکردی فراتر از مدل قدرتمند Claude Opus 5 به نمایش گذاشته است و مدیریت سوابق در ابزارهای برنامهنویسی را یکپارچه میکند.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک متنباز Hy Memory 2.0 تنسنت با تفکیک چرخه ثبت حافظه از مدل اصلی، چالش ذخیرهسازی، بهروزرسانی و رفع تعارض دادهها در ایجنتها را حل میکند.
- مدل تخصصی Hy-Memory-30B-A3B با فعالسازی ۳ میلیارد پارامتر در هر توکن، در بنچمارکهای استاندارد امتیاز ۵۵٫۴۹ را ثبت کرده و Claude Opus 5 را پشت سر گذاشته است.
- ابزار دسکتاپ MemHub سوابق و کدهای ثبتشده در دستیارهایی مثل Cursor و Claude Code را در یک پایگاه داده محلی گردآوری کرده و امکان جابهجایی سوابق بین ابزارها را فراهم میسازد.
تیم هونیوان شرکت تنسنت فریمورک Hy Memory 2.0 را منتشر کرد؛ مجموعهای جامع برای مدیریت حافظه ایجنتهای هوش مصنوعی که وظیفه حفظ اطلاعات و کانتکست کاربردی را در طول جلسات کاری مختلف، کار با ابزارها و کار روی پایگاههای کد بر عهده دارد. این بسته جدید شامل یک فریمورک متنباز پایتون، یک برنامه دسکتاپ و خط فرمان (CLI) برای ردیابی عملکرد ایجنتهای کدنویسی و یک مدل زبانی تخصصی برای نوشتن و تطبیق دادههای حافظه بلندمدت است.
این پشته نرمافزاری یکی از چالشهای همیشگی در مهندسی ایجنتها را هدف قرار میدهد: تشخیص اینکه کدام جزئیات ارزش ذخیرهسازی دارند، دادهها با چه ساختاری باید نگهداری شوند و چه زمانی شواهد و اطلاعات جدید باید یک حافظه موجود را بهروزرسانی یا جایگزین کنند. بر اساس گزارش تنسنت، مدل تخصصی این مجموعه در نقش نویسنده حافظه توانسته است در چهار چارچوب ارزیابی مختلف به میانگین امتیاز کلان ۵۵٫۴۹ دست یابد، در حالی که این رقم برای مدل قدرتمند Claude Opus 5 برابر با ۵۴٫۶۲ است.
یک پکیج کامل، سه مأموریت مجزا
این نسخه فرآیند مدیریت حافظه را به بخشهای مجزایی تفکیک میکند تا تیمهای توسعه بتوانند آنها را بهصورت یکپارچه یا کاملاً مستقل به کار بگیرند.
بخش | نقش | جزئیات کلیدی |
|---|---|---|
فریمورک حافظه و کیت توسعه نرمافزار پایتون (SDK) | چرخههای پردازش تخصصی را برای گفتوگو، کارهای اداری و بهرهوری، و کدنویسی ارائه میدهد. | |
برنامه دسکتاپ و ابزار تحت خط فرمان (CLI) محلی | تاریخچهها و ردیابیهای مجازشده توسط کاربر را از ابزارهایی مانند Claude Code، Cursor، Codex، OpenCode و Qwen Code جمعآوری میکند. | |
مدل اختصاصی ثبت حافظه بلندمدت | مسیر نوشتن دادهها را برای فریمورکهای Hy-Memory، Mem0 و MemOS با حدود ۳ میلیارد پارامتر فعال به ازای هر توکن اجرا میکند. |
ابزار MemHub دادههای دریافتی را در یک دایرکتوری محلی مدیریتشده ذخیره کرده و آنها را از طریق یک محیط اجرایی واحد در دسترس قرار میدهد. این معماری محلیمحور (Local-first)، یک لایه حافظه مشترک را میان دستیارهای کدنویسی تحت پشتیبانی در اختیار برنامهنویسان میگذارد؛ هرچند مدیریت مجوزهای دسترسی برنامهها و امنیت ذخیرهسازی محلی همچنان از ملاحظات مهم در زمان استقرار به شمار میآید.
چرا باید مدل ثبت حافظه را آموزش اختصاصی داد؟
بسیاری از پشتههای نرمافزاری ایجنتها برای استخراج فکتها، حذف دادههای تکراری و رفع تناقضات پیش از ذخیره بردارها در دیتابیس برداری، از یک مدل زبانی عمومی استفاده میکنند. در چنین حالتی، کیفیت نهایی حافظه کاملاً به پرامپتها، رفتار ذاتی مدل و API انتخابی وابسته میشود.
مدل Hy-Memory-30B-A3B دقیقاً برای این مسیر نوشتن و ثبت داده آموزش دیده است. این مدل مشخص میکند چه اطلاعاتی باید ذخیره شوند، با چه دقتی بیان گردند و شواهد بعدی چگونه باید بانک حافظه پایدار را اصلاح کنند. این مدل میتواند بدون نیاز به تغییر در سیستم بازیابی اطلاعات، جایگزین مدلهای عمومی ثبت حافظه در فریمورکهایی مانند Mem0، MemOS یا Hy-Memory شود.
ارزیابی در شرایط برابر؛ سنجش اختصاصی مدل ثبت حافظه
تنسنت میانگین کلان نتایج زیر را در چهار چارچوب ارزیابی گزارش کرده است:
مدل ثبت حافظه | امتیاز |
|---|---|
Hy-Memory-30B-A3B | ۵۵٫۴۹ |
Claude Opus 5 | ۵۴٫۶۲ |
DeepSeek V4.1 Flash | ۵۳٫۶۴ |
مدل پایه Qwen3-30B-A3B | ۴۴٫۳۷ |
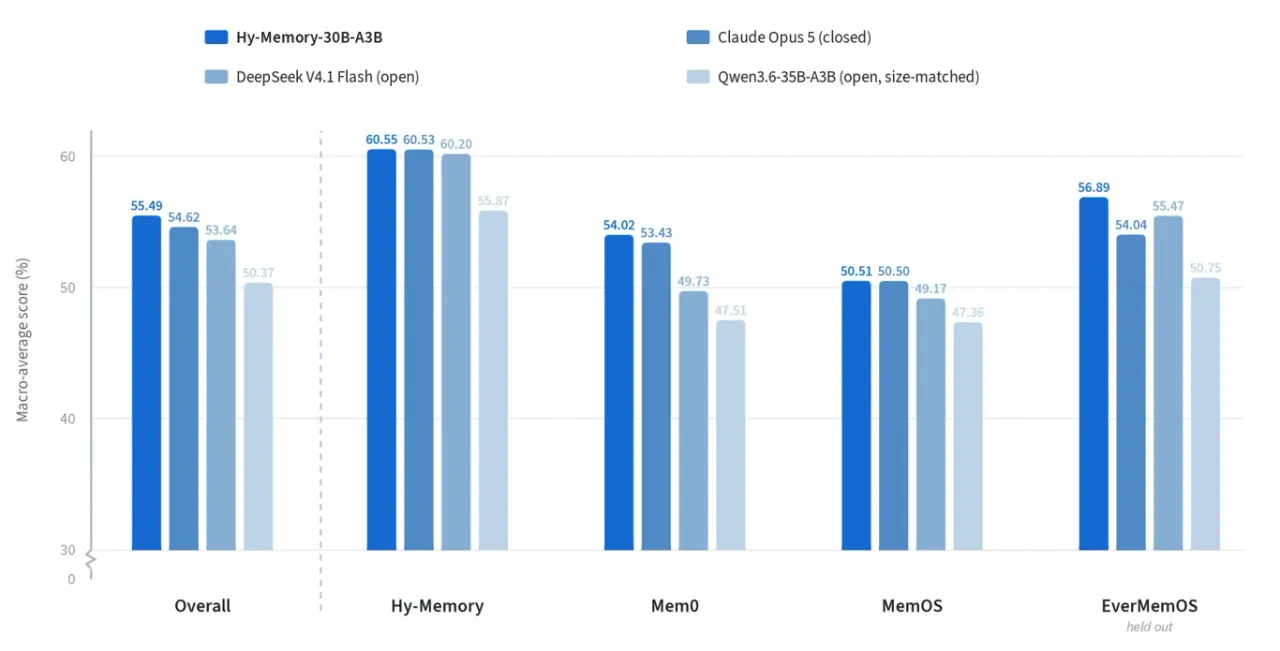
در این فرآیند ارزیابی، تنها متغیر تغییریافته همان مدل ثبت حافظه است؛ نسخههای بنچمارک، پرامپتها، تنظیمات بازیابی اطلاعات، مدلهای پاسخدهنده، مدلهای داور و نمونههای آزمایشی کاملاً ثابت ماندهاند. هر مدل ثبت حافظه کار خود را با یک بانک خالی شروع میکند و وضعیت حافظه اختصاصی خود را میسازد.
میانگین کلان بهدستآمده شش معیار مختلف را پوشش میدهد: LoCoMo Judge، LongMemEval، PersonaMem-v2، Travel SPS، Shopping PS و Code Memory Bench. این پروتکل، تأثیر فرآیند نوشتن حافظه را در یک سیستم ثابت میسنجد و هدف آن مقایسه کل ساختار ایجنتها با تنظیمات متفاوت بازیابی، تولید یا ابزارها نیست.
فرآیند آموزش بر مسیر نوشتن متمرکز است
این مدل از دو مرحله آموزشی بهره میبرد که در همان پیکربندیهای ارزیابی مشابه محیط استقرار اجرا میشوند:
- تقطیر درونپالیسی حافظه (Memory On-Policy Distillation): یک مدل معلم منجمد (Frozen Teacher) نظارت فشردهای را روی زنجیرههای وضعیت حافظه تولیدشده توسط مدل دانشآموز اعمال میکند.
- یادگیری تقویتی حافظه با تخصیص سهم (Attributed Memory Reinforcement Learning): سیستم آموزشی بانکهای حافظه کاملشده را ارزیابی کرده، به هر بخش مجزا (Chunk) امتیاز و اعتبار اختصاص میدهد و بانک منتخب را به پنجره زمینه (کانتکست) بعدی منتقل میکند.
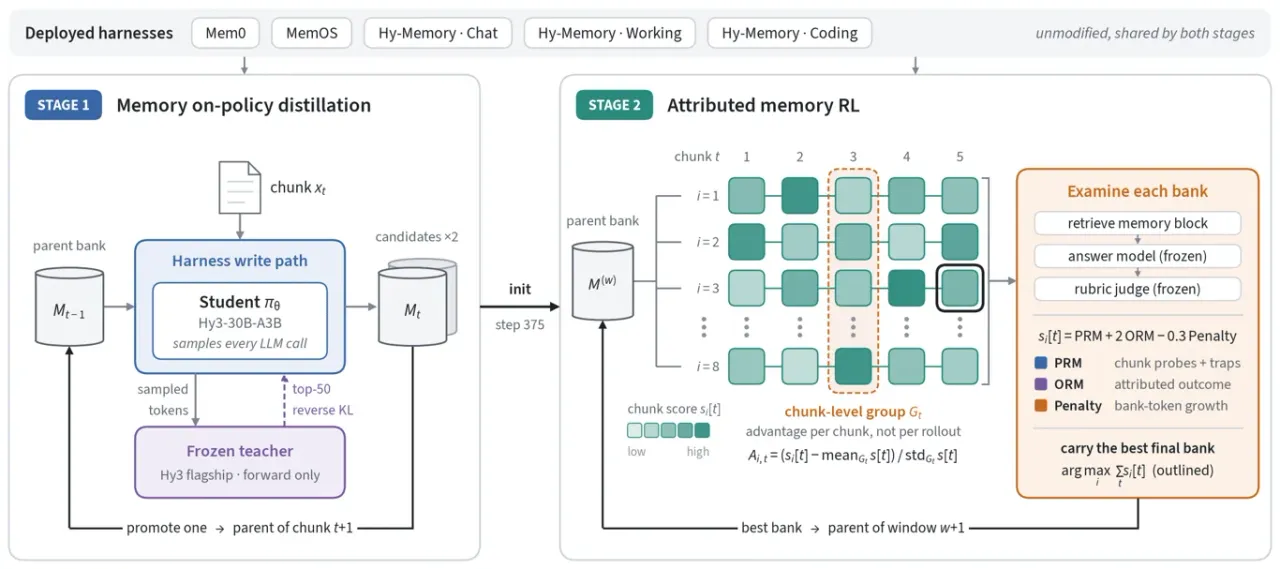
در طول فرآیند یادگیری تقویتی، هر اجرای آزمایشی (Rollout) یک توالی از بانکهای حافظه تولید میکند که پس از پردازش هر چانک شکل میگیرند. امتیازها در میان اجراهای مختلف در همان موقعیت چانک نرمالسازی میشوند؛ امری که باعث میشود با پیشرفت توالی، بهترین اجرای آزمایشی تغییر کند. در نهایت، سیستم بانکی را که بالاترین مجموع امتیازهای چانکها را داشته باشد انتخاب کرده و از آن بهعنوان وضعیت مرجع (Parent State) برای پنجره بعدی استفاده میکند.
این ساختار تخصیص اعتبار، ویرایشهایی در حافظه را تشویق میکند که به بهبود بازیابی و پاسخدهی در مراحل بعدی منجر شوند. تنسنت بنچمارک EverMemOS را خارج از فرآیند آموزش نگه داشت و در ارزیابی نهایی امتیاز پیشتاز ۵۶٫۸۹ را روی آن ثبت کرد؛ شواهدی که نشان میدهد الگوی آموختهشده برای ثبت حافظه، فراتر از بنچمارکهای زمان آموزش نیز تعمیمپذیر است.
حافظه اختصاصی برای هر نوع بار کاری
فریمورک Hy-Memory سه چرخه پردازش مجزا تعریف کرده است؛ چراکه تاریخچه گفتوگوها، جلسات کاری و تغییرات سورسکد، هر کدام شکل متفاوتی از کانتکست ماندگار را تولید میکنند.
چرخه پردازش (پایپلاین) | ساختار حافظه | کاربرد هدف |
|---|---|---|
گفتوگو (Chat) | هشت لایه سلسلهمراتبی از L0 تا L7 | اطلاعات پایه، متن خام مکالمه، فکتهای بنیادی، خلاصهها، طرحوارهها (Schemas) و اهداف آتی را ذخیره میکند. اهداف منقضیشده به فکتهای عادی تبدیل میشوند. |
کاری و اداری (Working) | یک فکت به ازای هر جلسه بههمراه تجربیات قابل استفاده مجدد | جلسات کاری و بهرهوری را ثبت کرده و تجربیاتی را که از یک آستانه ارزشی مشخص عبور کنند، نگه میدارد. این دو لایه به یکدیگر پیوند متقابل دارند. |
کدنویسی (Coding) | حافظه کاری بههمراه زنجیره نسخهبندیشده تغییرات کد (Diff Chain) | تغییرات و بازبینیهای دقیقی را ثبت میکند که استخراج فکت مبتنی بر خلاصه ممکن است آنها را نادیده بگیرد. |
زنجیره تغییرات کد (Diff Chain)، فکتهای بازیابیشده را با تاریخچه سورسکد غنیتر میکند. در این روش، جستجوی برداری ابتدا فکتهای مرتبط را انتخاب کرده و سپس این زنجیره تمام ویرایشهای انجامشده روی کد مورد نظر را به آن ضمیمه میکند. سیستم Hy-Memory این بازبینیها را مستقیماً از Git diffهای محلی یا عملیات جایگزینی قطعی ثبتشده در لاگ ابزارها استخراج میکند.
هر رشته کدنویسی نشاندهنده یک بلوک از یک تابع در یک فایل و روی یک شاخه (Branch) مشخص است. این رشتهها بر اساس کاربر و فضای کاری جداسازی میشوند؛ رویکردی که مانع از ورود تغییرات ریپازیتوریها یا حسابهای کاربری نامرتبط به یک زنجیره واحد میشود.
از نصب تا اولین جستجو
این کیت توسعه نرمافزار تحت مجوز متنباز Apache-2.0 توسعه یافته و با نام hy-memory==2.0.1 روی مخزن PyPI منتشر شده است. برای اجرای آن به یک اندپوینت مدل زبانی سازگار با OpenAI و یک اندپوینت امبدینگ نیاز دارید و امکان اتصال اختیاری به پایگاههای داده Qdrant، FAISS، Neo4j و MySQL بههمراه یک مدل بازرتبهبندی محلی چندزبانه (Local Multilingual Reranker) نیز فراهم است.
pip install "hy-memory==2.0.1"توسعهدهندگان میتوانند بسته به هزینه و سطح پیچیدگی مورد نیاز برنامه خود، یکی از سه حالت عملیاتی زیر را انتخاب کنند:
حالت | عملکرد |
|---|---|
lite | محتوای خام را برای بازیابی برداری بدون نیاز به فراخوانی مدل زبانی ذخیره میکند. |
pro | قابلیت استخراج با مدل زبانی و تطبیق حافظه را برای بارهای کاری استاندارد اضافه میکند. |
ultra | استنتاج طرحوارههای سطح بالاتر و پاکسازی چنددامنهای را از طریق تابع evolve() در اختیار سیستم میگذارد. |
کلاینت این فریمورک متدهای مستقیمی را برای افزودن محتوا و جستجو در حافظههای ذخیرهشده کاربران ارائه میدهد:
from hy_memory import HyMemoryClient

client = HyMemoryClient(mode="pro")
client.add(
    "I love sci-fi movies, especially Interstellar",
    user_id="user_1",
)

results = client.search(
    "What movies does the user like?",
    user_ids=["user_1"],
    limit=10,
)

for mem in results["memories"]["normal"]:
    print(f"[{mem['score']:.2f}] {mem['content']}")
مدل Hy-Memory-30B-A3B را میتوان از طریق فریمورکهای vLLM یا SGLang در قالب یک API سازگار با استانداردهای OpenAI اجرا کرد. در درخواستها، زمانی که کار صرفاً به استخراج مستقیم فکتها بدون نیاز به زنجیره استدلال طولانی نیاز دارد، میتوان پارامتر reasoning_effort: no_think را تنظیم کرد.
مهاجرت آسان بدون نیاز به بازنویسی کدها
تیمهایی که در حال حاضر از کتابخانههایی مانند Mem0 یا MemOS استفاده میکنند، میتوانند بدون دستکاری معماری فعلی ذخیرهسازی و بازیابی اطلاعات خود، صرفاً مدل ثبت حافظه را جایگزین کنند. در سوی دیگر، تیمهایی که کل این SDK را پیادهسازی کنند، به سیاستهای حافظه تفکیکشده برای مکالمه، فعالیتهای کاری و کدنویسی در کنار حالتهای استقرار مشخص برای مدیریت بهینه مصرف مدل دسترسی خواهند داشت.
ابزار MemHub با ذخیره سوابق مجاز در یک پایگاه داده محلی مشترک، این معماری را به دستیارهای مختلف کدنویسی تعمیم میدهد. این رویکرد مسیری شفاف برای انتقالپذیری حافظه میان ابزارهای مختلف پیش پای توسعهدهندگان میگذارد؛ با این حال، نتایج بنچمارکها زاویه دقیقتری را نشان میدهند: در محیطهای ارزیابی کنترلشده تنسنت، یک مدل ثبت حافظه تخصصی عملکرد بهتری در مقایسه با مدلهای عمومی همهمنظوره در تشکیل بانکهای داده ارائه داده است.
مطالب مرتبط و پیشنهادی
چگونه قبوض برق و پسانداز بازنشستگی شما، بدون اطلاعتان خرج رونق هوش مصنوعی میشود؟
صندوق بینالمللی پول نسبت بهشکلگیری یک چرخه خطرناک تأمین مالی در صنعت هوش مصنوعی هشدار داد که در صورت شکست، بار سنگین آن بر دوش شهروندان عادی خواهد افتاد. اکنون هزینههای سرسامآور ساخت مراکز داده از طریق افزایش قبوض برق، یارانههای شهری و سرمایهگذاری صندوقهای بازنشستگی تأمین میشود، در حالی که این شرطبندی بزرگ ممکن است هرگز به سودآوری مورد انتظار نرسد.
تایوان برای حمایت از زنجیره تأمین انویدیا، در خاک آمریکا شهرکهای صنعتی میسازد
دولت تایوان قصد دارد با جذب میلیاردها دلار سرمایه، چندین شهرک صنعتی در خاک آمریکا برای شرکتهای همکار و زنجیره تأمین انویدیا تأسیس کند. نخستین مجتمع در ایالت تگزاس با هزینهای بالغ بر ۴ میلیارد دلار احداث خواهد شد تا به استقرار آسانتر شرکتهای کوچکتر سختافزاری کمک کند.
تب هوش مصنوعی آمریکا در فیلیپین؛ احداث قطب ۴۰ میلیارد دلاری تراشه به بهای آوارگی بومیان
آمریکا و فیلیپین در حال پیشبرد طرح احداث قطب بزرگ تراشه و هوش مصنوعی Pax Silica با وعده سرمایهگذاری ۴۰ میلیارد دلاری هستند. بااینحال، ابهامات جدی پیرامون مصرف نجومی آب و برق و خطر آوارگی بومیان آئتا، اعتراضهای گستردهای را علیه این پروژه کلید زده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.