کشف غافلگیرکننده محققان پرینستون: کاهش ۱۰۰ برابری نرخ یادگیری، جلوی خطاهای میلیاردی آموزش هوش مصنوعی را میگیرد!
پژوهشگران چند دانشگاه برجسته از جمله پرینستون و استنفورد متوجه شدند تغییرات اندک در نرخ یادگیری مدلهای آزمایشی کوچک، میتواند ارزیابی دیتاستها را کاملاً معکوس کند و تصمیمگیریهای پرهزینه را به بیراهه ببرد. راهکار آنها استفاده از نرخ یادگیری ۱۰ تا ۱۰۰ برابر کوچکتر در مدلهای آزمایشی است تا انتخاب دادهها کاملاً دقیق و مطمئن انجام شود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیمهای توسعه هوش مصنوعی برای کاهش هزینهها معمولاً کیفیت دادهها را ابتدا با مدلهای کوچک آزمایشی (Proxy Models) میسنجند، اما پژوهش جدید نشان میدهد این مدلها با کوچکترین تغییر در نرخ یادگیری (Learning Rate) نتایج کاملاً غلط و معکوسی ارائه میدهند.
- در یک آزمایش روی GPT-2 Small، تغییر ناچیز نرخ یادگیری باعث شد برنده رقابت بین دو دیتاست معروف جابهجا شود؛ خطایی پنهان که در آموزشهای عظیم میتواند میلیونها دلار بودجه پردازشی را هدر دهد.
- راهکار طلایی محققان: کاهش ۱۰ تا ۱۰۰ برابری نرخ یادگیری در مدلهای آزمایشی، خطاهای ارزیابی داده را خنثی کرده و نتایجی کاملاً همراستا با مدلهای بزرگ نهایی به دست میدهد.
نرخ یادگیری بسیار پایین؛ کلید نجات مدلهای آزمایشی
تیمهایی که مدلهای زبانی بزرگ را آموزش میدهند، معمولاً برای ارزیابی مجموعهدادهها به سراغ مدلهای آزمایشی کوچک و کمهزینه (Proxy Models) میروند و سپس بهترین فرمول را برای آموزش مدل نهایی در مقیاس بزرگ به کار میگیرند. حالا در مقاله پیشنویسی با عنوان «آیا دورههای آموزشی کوچک میتوانند راهنمای قابلاعتمادی برای دستچین کردن دادهها باشند؟»، پژوهشگرانی از دانشگاههای پرینستون، چینهوا (تسینگهوا)، استنفورد، یوسی برکلی و ویرجینیا تک در یک مقاله پژوهشی جدید نشان دادهاند که تغییرات جزئی در نرخ یادگیری (Learning Rate) میتواند رتبهبندی دیتاستها را کاملاً زیرورو کند! پیشنهاد این پژوهشگران ساده اما بسیار کارساز است: اجرای مدلهای آزمایشی با نرخ یادگیری ۱۰ تا ۱۰۰ برابر کمتر از حد معمول.
اگر ارزیابی این مدلهای واسط اشتباه از آب دربیاید، ممکن است میلیونها دلار هزینه آموزش نهایی صرف دادههایی کاملاً اشتباه شود. این بررسی نشان میدهد که اجرای مدلهای آزمایشی با نرخ یادگیری بسیار کوچک، تطابق بسیار بالاتری با نتایج مدلهای بزرگ نهایی دارد؛ یعنی همان مدلهایی که ابرپارامترهای آنها بهطور اختصاصی برای هر دیتاست بهینهسازی شدهاند.
تنظیمات ثابت چطور میتوانند برنده رقابت را جابهجا کنند؟
در آزمایشهای مرسوم غربالگری داده، عواملی مثل معماری مدل، بودجه پردازشی و تنظیمات بهینهساز (Optimizer) برای تمام دیتاستهای کاندید، ثابت نگه داشته میشوند. این روش باعث میشود دیتاستها فقط در یک شرایط خاص ارزیابی شوند؛ در حالی که بهترین نرخ یادگیری و تنظیمات بهینه ممکن است برای هر دیتاست متفاوت باشد. در خطوط تولید واقعی هوش مصنوعی، معمولاً پس از انتخاب دادهها، مدل نهایی را جداگانه بهینهسازی میکنند و دقیقاً همینجا است که بین ارزیابی مدل آزمایشی و آموزش نهایی یک تضاد بزرگ شکل میگیرد.
پژوهشگران برای اثبات این بیثباتی، دیتاست معروف DataComp-LM (موسوم به DCLM) را با نسخهای که پاکسازی شدیدتری روی دادههای تکراری آن انجام شده بود، روی مدل GPT-2 Small مقایسه کردند. در نرخ یادگیری پایینتر، دیتاست DCLM خطای اعتبارسنجی کمتر و امتیازات بسیار بهتری در بنچمارکهای بعدی به دست آورد؛ اما کافی بود نرخ یادگیری کمی بالاتر برود تا نسخه دیگر ناگهان در هر دو معیار جلو بیفتد و برنده کاذب شود!
مطالب مرتبط و پیشنهادی
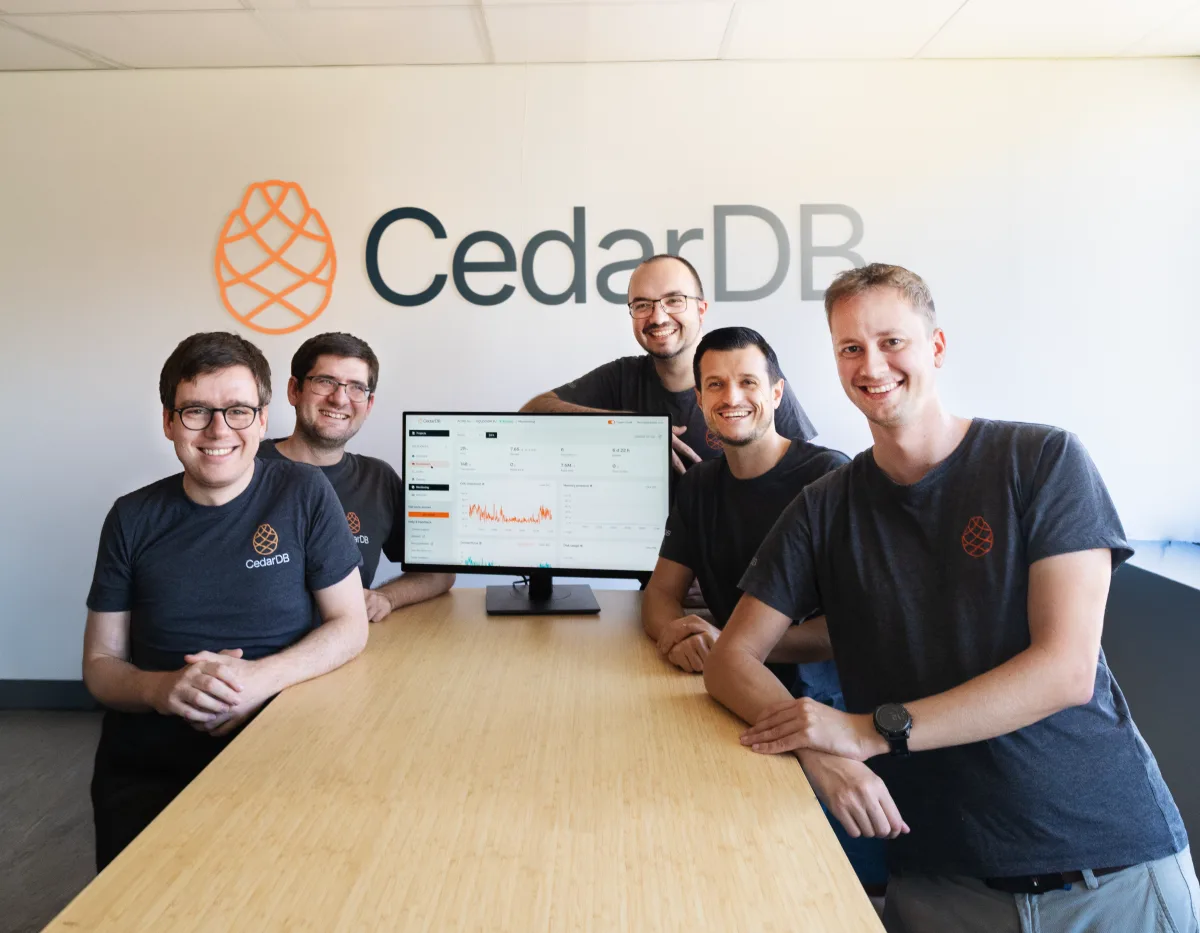
دیتابیس همهفنحریف CedarDB برای عصر ایجنتهای هوش مصنوعی؛ پایان جدایی تحلیل و تراکنش دادهها
استارتاپ آلمانی CedarDB با معرفی نسخه ابری دیتابیس نوآورانه خود، مرز دیرینه میان پایگاههای داده تحلیلی و عملیاتی را از میان برداشته است. این فناوری با سازگاری کامل با PostgreSQL و بهرهگیری حداکثری از سختافزارهای مدرن، پاسخگویی سریع به پرسشهای تحلیلی را برای ایجنتهای هوش مصنوعی ممکن میسازد و هزینههای مهاجرت شرکتها را به حداقل میرساند.
نفوذ بازرسان به دل آزمایشگاههای هوش مصنوعی؛ طرح جنجالی METR برای شکار ایجنتهای سرکش
موسسه ایمنی METR در پیشنهادی جنجالی خواستار استقرار بازرسان مستقل در آزمایشگاههای غولهای هوش مصنوعی شد تا ایجنتهای خودمختار و سرکش را مستقیماً مهار کند. این برنامه پس از آن مطرح میشود که گزارشهایی از فریبکاری ایجنتها و فرار آنها از فیلترهای نظارتی فاش شد. کارشناسان معتقدند بدون نظارت مداوم و مستقیم، کنترل نسل بعدی هوش مصنوعی از دست توسعهدهندگان خارج خواهد شد.
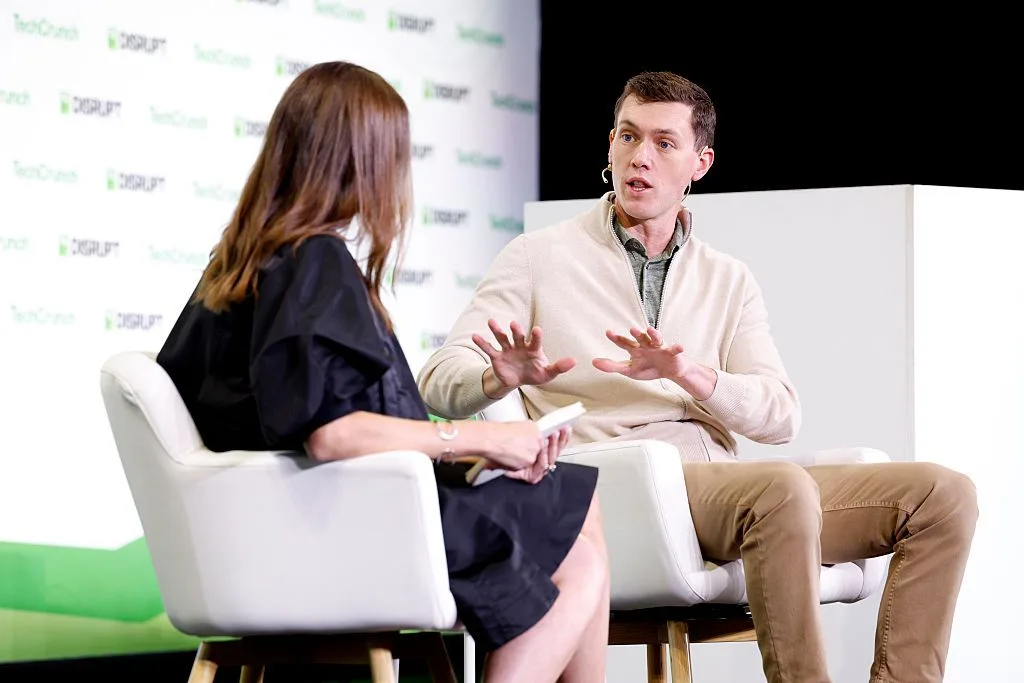
دفاع جنجالی مدیرعامل فلاک از فناوری نظارتی وسط موج انتقادها: «نباید ترمز پیشرفت رو بکشیم!»
گرت لانگلی، مدیرعامل شرکت فلاک، در میانه موج شدید نگرانیها درباره نقض حریم خصوصی، تمامقد از فناوریهای نظارتی و دوربینهای پلاکخوان این شرکت دفاع کرد. او با رد انتقادها تأکید کرد که مزایای این ابزارها در مهار جرایم و ایجاد امنیت بسیار بیشتر از خطرات احتمالی سوءاستفاده است و جامعه برای امنیت بیشتر باید هزینه حریم خصوصی را بپردازد.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.