کلود واقعاً خنگتر شده؟ مچگیری از Claude Opus 5.5 با تله ۷۸ سوالی livenerf
همیشه این بحث داغ وجود داشته که مدلهای هوش مصنوعی بعد از عرضه بهمرور خنگتر و ضعیفتر میشوند، اما اثبات آن کار سادهای نبود. حالا با پروژه متنباز livenerf و ارزیابی روزانه با ۷۸ سوال کالیبرهشده، تغییرات دقت و طول خروجی Claude Opus 5.5 به صورت دقیق ثبت و ردیابی میشود.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- خیلی از کاربران حس میکنند مدلهای هوش مصنوعی پس از مدتی افت کیفیت پیدا میکنند؛ پروژه متنباز livenerf برای اولینبار این ادعا را به دادههای آماری مستند تبدیل کرده است.
- این بنچمارک با اجرای روزانه ۷۸ سوال چالشبرانگیز در شرایط کاملاً قرنطینه و پایدار، رفتار مدل قدرتمند Claude Opus 5.5 را زیر ذرهبین قرار میدهد.
- با بهرهگیری از فریمورک استاندارد ارزیابی Inspect و نمرهدهی تطابق دقیق (Exact-match)، هرگونه وابستگی به قضاوت سلیقهای سایر مدلها حذف شده است.
پروژه livenerf افت کیفیت مدلها را به دادههای زمانی تبدیل میکند
حتماً شما هم بارها این ادعا را شنیدهاید که مدلهای پیشرو و ابری هوش مصنوعی پس از مدتی «خنگتر» میشوند؛ اما راستیآزمایی این گفتهها همیشه فوقالعاده دشوار بوده است، چون کاربران بهندرت معیاری از عملکرد مدل در روز نخست عرضه در اختیار دارند. پروژه متنباز livenerf دقیقاً با هدف حل همین چالش توسعه یافته و با ثبت مداوم یک بنچمارک ثابت در طول زمان، شواهدی مستند از هرگونه تغییر پس از عرضه در دقت و طول پاسخهای مدل ارائه میدهد.
توسعهدهندهای با نام مستعار ninjahawk نسخه اولیه (v0) این ابزار را برای مدل Claude Opus 5.5 که از طریق بستر Claude Code روی اشتراک Max اجرا میشود، منتشر کرده است. معماری این پروژه به گونهای پیادهسازی شده که به محض فراهم شدن رابطهای کاربری پایدار و قابل تثبیت، امکان پشتیبانی از سایر مدلهای هوش مصنوعی را نیز خواهد داشت.
تثبیت بستر آزمون و زیر ذرهبین بردن رفتار مدل
از آنجا که محیط Claude Code کنترلهای تنظیم نمونهبرداری (Sampling) را در دسترس قرار نمیدهد و امکان غیرفعالسازی استدلال را هم فراهم نمیکند، خروجیهای مدل همواره تا حدی ماهیت تصادفی دارند. با این حال، livenerf با تثبیت تمام متغیرها از جمله پرامپتها، نسخه خط فرمان Claude Code، سیستم نمرهدهی، محیط اجرا و روال تحلیل دادهها، هر دور آزمون را تا بالاترین حد ممکن تکرارپذیر و یکپارچه کرده است.
این بنچمارک از فریمورک ارزیابی Inspect متعلق به موسسه ایمنی هوش مصنوعی بریتانیا (UK AISI) استفاده میکند. متدولوژی آماری آن نیز از رویکرد تحلیل حاشیه خطا متعلق به شرکت Anthropic، شامل مقایسههای جفتی و بازههای عدم قطعیت، پیروی مینماید.
بخش | نحوه پیادهسازی |
|---|---|
مجموعه پرامپتها | اجرای همان سوالات کالیبرهشده و ثابت در هر روز اندازهگیری. |
نحوه اجرا | اجرای تکمرحلهای در یک دایرکتوری خالی، همراه با غیرفعال بودن تمام ابزارها، سرورهای MCP و فایلهای حافظه. |
سیستم نمرهدهی | نمرهدهی مبتنی بر تطابق دقیق (Exact-match) جهت جلوگیری از اتکا به قضاوت سایر مدلهای هوش مصنوعی که ممکن است خودشان نیز دچار افت کیفیت شوند. |
بستر آزمون | نسخه خط فرمان Claude Code CLI در تمام طول ارزیابیها بدون تغییر و پینشده باقی میماند. |
معیار اصلی | میزان دقت در مقایسه با عملکرد پایه و اولیه هر سوال. |
معیار ثانویه | میانه تعداد توکنهای خروجی به ازای هر نمونه. |
ذخیرهسازی دادهها | لاگهای خام .eval فریمورک Inspect بهصورت سوابق فقطافزودنی (Append-only) حفظ و ذخیره میشوند. |
گلچین ۷۸ سوال طلایی از میان ۲,۳۳۶ سوال اولیه
در فرایند غربالگری اولیه، تعداد ۲,۳۳۶ سوال چالشی از منابع معتبری چون GPQA Diamond، MMLU-Pro، سوالات مسابقات ریاضی و آزمون AIME 2025-26 بررسی شد و برای هر سوال چهار نمونه پاسخ تولید گردید. مدل Opus 5.5 در نخستین نمونه به دقت خیرهکننده حدود ۹۳ درصدی رسید؛ نکته جالبتر اینکه ۹۷ درصد سوالات، یا در تمام دورهای آزمون درست پاسخ داده شدند یا در تمام دورها غلط بودند.
مطالب مرتبط و پیشنهادی
دوپامین مصنوعی و مغزهای هکشده؛ هوش مصنوعی مولد چطور سیمکشی تمرکز ما را به هم میریزد؟
رگبار نوتیفیکیشنها و سیستمهای هوش مصنوعی مولد با تولید مداوم «دوپامین مصنوعی»، ساختار شیمیایی و مدارهای تمرکز مغز انسان را دستخوش تغییر اساسی کردهاند. این سقوط دامنه توجه صرفاً یک مسئله شخصی نیست، بلکه با از بین بردن فرصتهای استراحت مغزی، امنیت شناختی و تفکر عمیق جامعه را در معرض تهدیدی جدی قرار داده است.
شتاب خیرهکننده مدل زبانی MiniCPM5 با دستیار ۳۲۴ میلیونی DSpark؛ جهش چشمگیر در تولید موازی توکنها
تیم OpenBMB با انتشار مدل کمحجم ۳۲۴ میلیون پارامتری DSpark، جهش بزرگی در سرعت استنتاج مدل زبانی MiniCPM5-2B ایجاد کرده است. این مدل با تکیه بر تکنیک هوشمندانه رمزگشایی گمانهزنانه، توکنها را به صورت دستهای حدس میزند تا فرایند پردازش با کمترین مصرف محاسباتی و بیشترین سرعت ممکن اجرا شود.
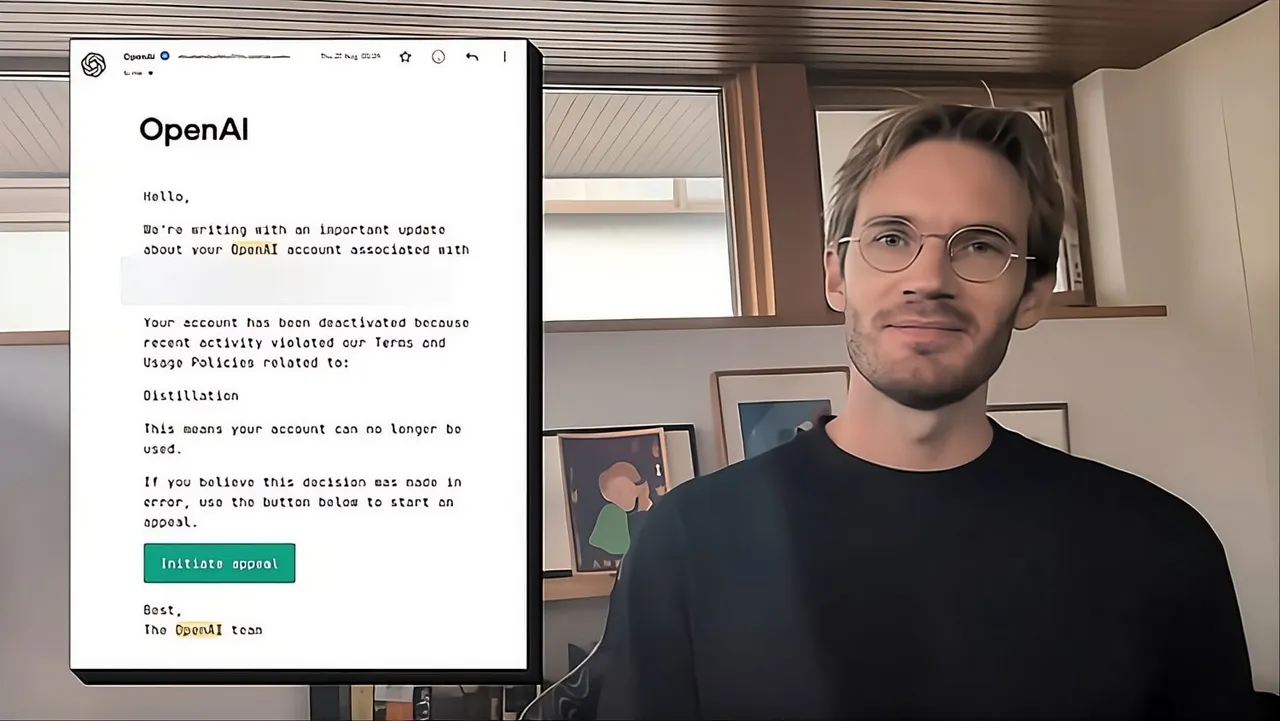
پیودیپای: موقع ساخت هوش مصنوعی اختصاصیام، OpenAI دو بار اکانتم را بست!
فلیکس شلبرگ یا همان پیودیپای معروف، بهتازگی مدل هوش مصنوعی محلی خود به نام Ajax را معرفی کرده، اما فاش ساخته که در مسیر توسعه آن، شرکت OpenAI دو بار حسابش را مسدود کرده است. او برای ساخت این مدل ۹ میلیارد پارامتری از تکنیک تقطیر استفاده کرده؛ موضوعی که زنگ خطر نقض قوانین سازنده ChatGPT را به صدا درآورده است.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.