شاهکار جدید Unsloth: تبدیل مدل جمعوجور ۰.۸ میلیاردی به موتور تصمیمگیری فوقسریع با دقت ۷۸ درصدی!
تیم Unsloth قابلیت جدیدی برای فاینتیون مدلهای زبانی معرفی کرده که به جای تولید متنهای طولانی، مستقیماً تصمیمات ساختاریافته و احتمالات دقیق را خروجی میدهد. با این نوآوری، حتی یک مدل کوچک ۰.۸ میلیارد پارامتری مثل Qwen3.5 میتواند بدون خطاهای رایج JSON، با دقت خیرهکننده ۷۸ درصد و مصرف تنها ۴ گیگابایت حافظه گرافیکی، وظایف طبقهبندی و تصمیمگیری سازمانی را به سرعت انجام دهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- تیم محبوب Unsloth قابلیتی به ابزارهای خود اضافه کرده که مدلهای زبانی را برای تصمیمگیری سریع و خروجیهای ساختاریافته (مثل بله/خیر، امتیازدهی و برچسبگذاری) بدون معطلیِ تولید متن معمولی، فاینتیون میکند.
- در آزمایشهای انجامشده، مدل بندانگشتی Qwen3.5 با تنها ۰.۸ میلیارد پارامتر توانست به دقت خیرهکننده ۷۸ درصدی برسد و در بنچمارکهای مختلف جهش عظیمی ثبت کند؛ آن هم تنها با مصرف ۴ گیگابایت VRAM در ۴۲ دقیقه!
- این روش با دور زدن فرآیند خستهکننده تولید توکنبهتوکن، مشکلاتی مثل شکستن ساختار JSON و تاخیر خروجی را کاملاً حل کرده و گزینهای فوقالعاده بهصرفه برای جایگزینی APIهای گرانقیمت در پردازش تیکتها و فرمهاست.
آموزش مدلهای زبانی کوچک برای تصمیمگیری ساختاریافته در Unsloth
تیم Unsloth قابلیت جدیدی برای فاینتیون مدلهای تصمیمگیری (Decision Models) به اپلیکیشن دسکتاپ و ابزارهای متنباز خود اضافه کرده است؛ جزئیات کامل این روش در راهنمای مدل تصمیمگیری این مجموعه تشریح شده است. توسعهدهندگان حالا میتوانند به سادگی یک مدل زبانی از پیشآموزشدیده را طوری آموزش دهند که برچسبها را انتخاب کند، به سوالات بله یا خیر پاسخ دهد یا در یک مقیاس مشخص امتیاز بدهد؛ آن هم در حالی که برای تکتک گزینهها احتمال دقیق ریاضی محاسبه میشود. در این روش استنتاج، دادههای ساختاریافته مستقیماً و بدون نیاز به تولید گامبهگام متن (تولید خودبازگشتی) تحویل داده میشوند؛ اتفاقی که تأخیر پاسخدهی را به شدت کاهش داده و کابوس همیشگی خطاهای خروجی و خراب شدن فرمت JSON را برای همیشه از بین میبرد.
پرواز دقت مدل ۰.۸ میلیاردی به بالای ۷۰ درصد!
بر اساس نتایج بنچمارکهای منتشرشده، این نوع فاینتیون جهش چشمگیری در دقت مدل کوچک Qwen3.5-0.8B روی سه دیتاست مختلف دستهبندی ایجاد کرده است:
مجموعه داده | قبل از آموزش | بعد از آموزش | میزان بهبود |
|---|---|---|---|
typed-decisions | ۳۶٪ | ۷۳٪ | ۳۷ واحد درصد |
BANKING77 | ۷٪ | ۷۴٪ | ۶۷ واحد درصد |
CLINC150 | ۱۹٪ | ۷۶٪ | ۵۷ واحد درصد |
در یک ارزیابی جداگانه روی ۳۰۰۰ ردیف داده تست دستنخورده، این مدل به دقت تحسینبرانگیز ۷۸ درصدی رسید؛ جالبتر این که کل فرایند آموزش این مدل ۰.۸ میلیاردی تنها به ۴ گیگابایت حافظه گرافیکی (VRAM) نیاز داشت. البته این نتایج حاصل ترکیب دادهها و تنظیمات اختصاصی گزارششده توسط تیم سازنده است. برای استفاده در محیطهای عملیاتی و واقعی، مهندسان باید دقت هر کلاس، هزینههای ناشی از خطای مثبت کاذب، میزان کالیبراسیون، تأخیر و عملکرد مدل روی دادههای واقعی محیط کاری خود را نیز به دقت ارزیابی کنند.
یک پردازش واحد، چندین پاسخ ساختاریافته
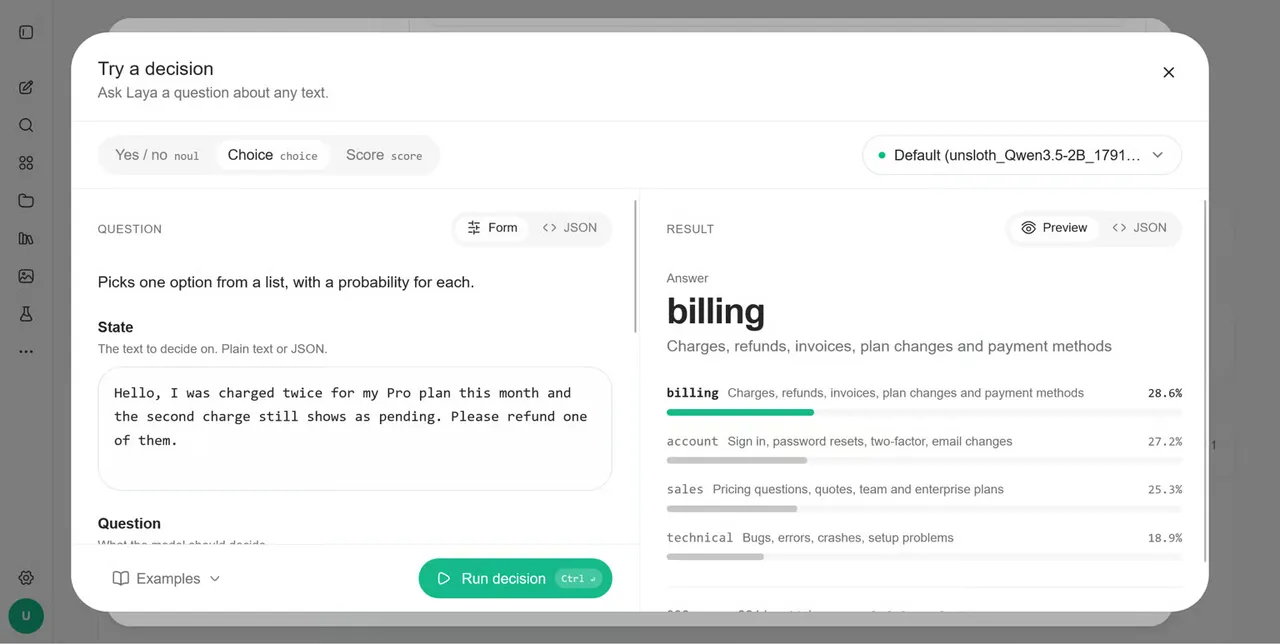
هنگام اجرای مدل در فاز استنتاج، کاربر متن ورودی را همراه با یک یا چند پرسش مشخص و گزینههای مجاز به مدل تحویل میدهد. بدنه اصلی مدل زبانی کل این پرامپت را تنها در یک مرحله کدگذاری و پردازش میکند. سپس یک سر طبقهبندی (Classification Head) سبک و جمعوجور بر پایه معماری Clef از شرکت Cloudflare، گزینههای مختلف را بر اساس لایههای میانی مدل امتیازدهی کرده و توزیع احتمال دقیق هر پرسش را برمیگرداند.
در مدلهای عادی، تولید توکنبهتوکن و خودبازگشتی بسیار زمانبر است و معمولاً به یک پارسر اضافه برای بررسی سلامت خروجی نیاز دارد. اما مسیر تصمیمگیری Unsloth این چرخه وقتگیر را کاملاً دور میزند؛ به این ترتیب هم تأخیر ناشی از ساخت توکنها ناپدید میشود و هم دیگر خبری از خطاهای ساختاری در خروجی نیست. با این حال توجه داشته باشید که بدنه اصلی مدل همچنان کل متن پرامپت را میخواند؛ بنابراین هر چقدر سوالات و گزینههای بیشتری اضافه کنید، طول توالی و حجم محاسبات بالاتر خواهد رفت.
برای نمونه، متن یک تیکت پشتیبانی مشتریان میتواند تنها با یک بار عبور از شبکه، همزمان چندین تصمیم مهم را رقم بزند: هدایت تیکت به تیم مربوطه، تشخیص قصد کاربر و مشخص شدن این که آیا مشتری درخواست بازگشت وجه دارد یا خیر. هر فیلد به طور کاملاً مجزا مقدار برگزیده و درصد احتمال خاص خودش را دریافت میکند.
فرمول جادویی پشت این جهش بزرگ چیست؟
آزمایش منتشرشده از یک سر طبقهبندی Clef و آداپتورهای LoRA با رنک ۶۴ (Rank-64) برای یک دور آموزش (Epoch) استفاده کرده است. تکنیک LoRA ماتریسهای کوچک و کمرتبه را آموزش میدهد و بخش اعظم وزنهای مدل پایه را دستنخورده باقی میگذارد که باعث صرفهجویی چشمگیر در حافظه مورد نیاز برای آموزش میشود. تنظیمات پیشفرض و اولیه از وزنهای پایه ۴ بیتی، آداپتورهای رنک ۱۶ و نرخ یادگیری 2e-4 بهره میبرد؛ با این حال توسعهدهندگانی که میخواهند این بنچمارک را عیناً بازتولید کنند، باید حتماً از کانفیگ رنک ۶۴ استفاده کنند تا به همین نتایج درخشان برسند.
مجموعه دادههای آموزشی این آزمایش شامل ترکیب دیتای typed-decisions با ۱۲ منبع معتبر دستهبندی و استنتاج زبان طبیعی بوده است: AG News، ARC، BANKING77، BoolQ، CLINC150، CommonsenseQA، MMLU، MNLI، نمونههای تزریق پرامپت (Prompt-injection)، SNLI، SST-5 و WANLI. همچنین دیتاست ارزیابی ۳۰۰۰ ردیفی از ترکیب سه مجموعه typed-decisions، BANKING77 و CLINC150 گلچین شده که طبق اعلام سازندگان، کاملاً پالایش شده تا هیچ داده مشترکی با بخش آموزش نداشته باشد.
با ۴ گیگابایت VRAM چه کارهایی میتوان انجام داد؟
بر اساس گزارش تیم توسعه، میزان دقت نهایی، اوج مصرف حافظه گرافیکی و مدتزمان آموزش در مدلهای مختلف به شرح زیر است:
مدل | دقت در تست | میزان VRAM | زمان آموزش |
|---|---|---|---|
Qwen3.5-0.8B | ۷۸٪ | ۴ گیگابایت | ۴۲ دقیقه |
Qwen3.5-2B | ۸۱٪ | ۸ گیگابایت | ۴۰ دقیقه |
Llama 3.2 3B | ۷۹٪ | ۴.۱ گیگابایت | ۳۰ دقیقه |
Gemma 4 E4B | ۷۷٪ | ۱۴.۴ گیگابایت | ۴۹ دقیقه |
Laya (فاینتیون مجدد) | ۷۷٪ | ۲.۵ گیگابایت | ۱۰ دقیقه |
نتیجه مدل Laya حاصل فاینتیون بیشتر روی یک مدل تصمیمگیری از پیشآموزشدیده است. علاوه بر این، یک اجرای سریع روی مدل Qwen3.5-4B با تنظیم max_steps=60 توانسته ظرف تنها ۱۰ دقیقه روی یک پردازنده گرافیکی Nvidia L4 به دقت ۷۶ درصدی دست پیدا کند. البته مدتزمان واقعی و مصرف حافظه بسته به سختافزار، طول ورودی، اندازه بچ (Batch Size)، دقت محاسباتی و ساختار دیتاست شما متغیر خواهد بود.
از آمادهسازی دیتاست تا پیشبینی و اجرا
خبر خوب این است که در نسخه دسکتاپ Unsloth میتوانید کل این فرایند را حتی بدون نوشتن یک خط کد پایتون اجرا کنید؛ همزمان کتابخانه متنباز آن کلاسهای FastDecisionModel و DecisionTrainer را برای ادغام مستقیم با پایپلاینهای موجود در اختیارتان میگذارد.
- یک مدل پایه مانند
unsloth/Qwen3.5-4Bرا انتخاب کنید. - حالت Train as را روی گزینه Decision model قرار دهید.
- مجموعه داده برچسبگذاریشده خود را انتخاب کرده و آموزش را کلید بزنید.
هر نمونه داده آموزشی باید شامل متن مبدأ و پاسخ مورد انتظار برای هر سوال باشد. برچسبها دقیقاً باید با ساختار سوالات، گزینههای مجاز یا مقادیر عددی مدنظر همخوانی داشته باشند. برای دسترسی به این ابزار، میتوانید به مخزن گیتهاب (GitHub) پروژه Unsloth مراجعه کنید که این ماژول را در کنار سایر ابزارهای کاربردی خود عرضه کرده است.
در محیط پایتون، متد predict یک متن آزاد و دیکشنری از سوالات ساختاریافته را به عنوان ورودی دریافت میکند:
answers = FastDecisionModel.predict(
    model,
    tokenizer,
    \"Hi, I was charged twice for invoice #4411. Please refund today.\",
    {
        \"team\": {
            \"type\": \"choice\",
            \"criteria\": {
                \"billing\": \"invoices, payments, refunds\",
                \"technical\": \"bugs, outages, errors\",
                \"sales\": \"pricing, new plans\",
            },
        },
        \"refund\": {
            \"type\": \"bool\",
            \"instructions\": \"Does the customer ask for a refund?\",
        },
    },
)

print(answers[\"team\"][\"probabilities\"])
سنجش میزان اطمینان مدل با معیار ECE
هر پیشبینی که توسط مدل انجام میشود، علاوه بر گزینه انتخابی، شامل توزیع آماری احتمالات نیز هست. متد calibrate این احتمالات را با درستی واقعی مدل روی دادههای تست مقایسه کرده و شاخصهایی مانند دقت، مقدار خطا (Loss) و خطای کالیبراسیون مورد انتظار (ECE) را گزارش میدهد. این معیار پیشبینیها را بر اساس ضریب اطمینان دستهبندی میکند و اختلاف میان میانگین اطمینان و دقت واقعی را میسنجد؛ طبیعتاً هر چه مقدار ECE پایینتر باشد، مدل قابلاعتمادتر است.
کالیبراسیون دقیق به یک دیتاست مجزا و نماینده نیاز دارد؛ چرا که با تغییر الگوهای ترافیک، لحن ورودیها، فراوانی کلاسها یا رفتار کاربران، احتمالات کالیبرهشده قبلی ممکن است دقت خود را از دست بدهند. به همین دلیل سیستمهای فعال در محیط واقعی باید مرتباً هم دقت و هم کالیبراسیون را زیر نظر بگیرند و در صورت مشاهده تغییرات رفتاری، مدل را مجدداً کالیبره یا آموزش دهند.
چه کارهایی بهترین گزینه برای مدلهای تصمیمگیری هستند؟
بهترین گزینهها برای پیادهسازی
- مسیریابی هوشمند تیکتها و تشخیص قصد کاربر
- غربالگری و اولویتبندی تعدیل محتوا
- شناسایی و مسدودسازی حملات تزریق پرامپت (Prompt Injection)
- برچسبگذاری اسناد و هدایت شاخههای کاری در فرایندها
- محاسبه امتیاز ریسک بر اساس آستانههای مشخص
- استخراج چندین تصمیم مستقل و مرتبط از یک متن واحد
محدودیتها و نکاتی که باید بسنجید
- هر پاسخ حتماً باید در قالب یک گزینه مشخص، فیلد بولی (بله/خیر) یا یک مقیاس عددی معین بگنجد.
- افزایش تعداد سوالات و گزینهها باعث طولانیتر شدن پرامپت و سنگینتر شدن هزینه پردازش میشود.
- کالیبراسیون ممکن است در مواجهه با تغییرات پیشبینینشده در توزیع دادهها افت کند.
- دقت کلی ممکن است عملکرد ضعیف مدل در دستههای کمیاب یا پرهزینه را پنهان کند.
- مدلهای کلاسیک طبقهبندی (مانند انکودرها) همچنان ممکن است سبکتر و سریعتر اجرا شوند و معیار مقایسه خوبی هستند.
- تولید متنهای خلاقانه و وظایفی که به توضیح متنی نیاز دارند، همچنان نیازمند مدلهای مولد معمولی هستند.
تیمهایی که تا امروز تنها برای طبقهبندی متون از APIهای گرانقیمت مدلهای عمومی استفاده میکردند، حالا میتوانند یک مدل محلی ۰.۸ یا ۳ میلیارد پارامتری سبک با خروجی کاملاً ساختاریافته را تست کنند. مقایسه جامع میان دقت در سطح وظیفه، کالیبراسیون، اوج مصرف رم گرافیکی، تأخیر صدک ۹۵ (p95)، هزینههای جاری سرور و زحمت نگهداری سیستم، به روشنی نشان میدهد که آیا جایگزینی مدلهای سنتی یا APIها با این شیوه جدید توجیه اقتصادی دارد یا خیر.
مطالب مرتبط و پیشنهادی
دردسرهای فنی OpenAI Dots و ظهور شبیهسازهای متنباز؛ وقتی ایجنت همیشهروشن به این سادگیها نیست!
سرویس جدید OpenAI Dots با وعده ایجنتهای ابری همیشهروشن عرضه شد، اما بروز اختلالات فنی متعدد و قطعیهای پیدرپی حسابی صدای کاربران را درآورده است. همزمان، توسعهدهندگان مستقل با عرضه پروژههای متنبازی چون OpenDots و Open Dot در تلاشاند جایگزینهایی ارزانتر، آزادتر و بدون محدودیت در اختیار همگان بگذارند.
دانشمندان آزمایشگاه آرگون میکروسکوپ پرتو ایکس سخنگویی ساختند که با زبان طبیعی فرمان میگیرد و زوم میکند!
پژوهشگران آزمایشگاه ملی آرگون با اتصال ایجنتهای هوش مصنوعی به خط باریکه نانوپروب پرتو ایکس، میکروسکوپی توسعه دادهاند که دانشمندان میتوانند به زبان ساده و گفتاری با آن مکالمه کنند و از دستگاه بخواهند روی نقاط دلخواه نمونه زوم کند. این نوآوری با بازسازی بلادرنگ دادههای سنگین تایکوگرافی، افقهای تازهای در تحقیقات مواد پیشرفته و ساخت نیمههادیها میگشاید.
استارتاپ هوش مصنوعی ورنیک راهی اروپا شد؛ تأسیس نخستین مقر در لوکزامبورگ
استارتاپ هوش مصنوعی ورنیک (Verneek) که توسط نسرین مصطفیزاده و امید بخشنده تأسیس شده، قصد دارد با راهاندازی نخستین دفتر اروپایی خود در لوکزامبورگ فعالیتهایش را گسترش دهد. این شرکت فعال در حوزه هوش مصنوعی سازمانی، با پلتفرم اختصاصی خود به غولهای خردهفروشی کمک میکند تا دادههای پراکنده را یکپارچه کرده و بهرهوری را افزایش دهند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.