جهش چشمگیر سرعت vLLM روی سرورهای Blackwell انویدیا؛ رکورد ۸۴۲ توکن در ثانیه برای Kimi K3
فریمورک vLLM با همکاری انویدیا، یک موتور رمزگشایی اختصاصی برای مدل Kimi K3 روی سرورهای Blackwell معرفی کرد. این بهینهسازی با ادغام محاسبات و تبادل داده میان پردازندهها، سرعت تولید متن را به بیش از ۸۴۰ توکن در ثانیه میرساند و تاخیر پاسخگویی ایجنتهای هوش مصنوعی را بهشکل چشمگیری کاهش میدهد.
در یک نگاه (نکات کلیدی خبر)
خلاصه مهمترین نکات و تحولات این گزارش برای مطالعه سریع
- فریمورک vLLM با توسعه کِرنلهای اختصاصی در پلتفرم CuTe DSL انویدیا، سرعت تولید توکن مدل Kimi K3 را روی سرورهای GB300 به ۸۴۲ توکن در ثانیه رساند.
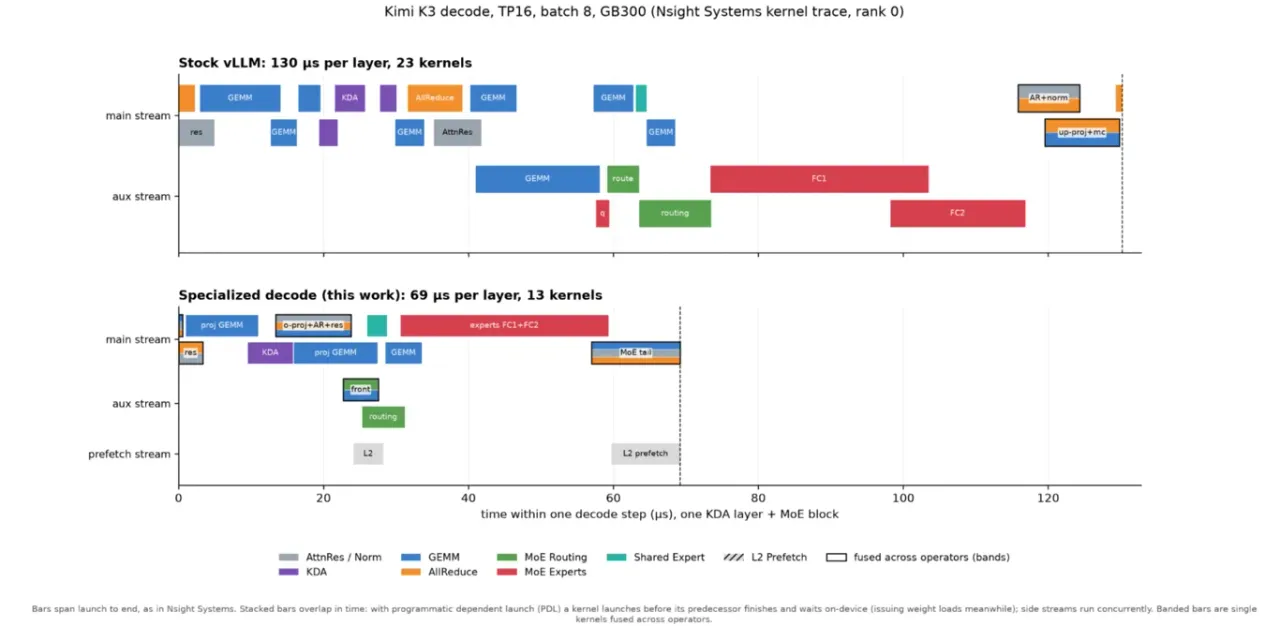
- این بهینهسازی با ادغام محاسبات ماتریسی، مسیریابی مدلهای MoE و همپوشانی ارتباط میان GPUها، زمان پردازش هر لایه را از ۱۳۰ به ۶۹ میکروثانیه رسانده است.
- این ارتقا، کارایی ایجنتهای کدنویسی را در بنچمارک AgentX تا ۱٫۸ برابر افزایش داده و مسیر را برای ادغام کدهای بهینهسازی نوشتهشده توسط هوش مصنوعی هموار میکند.
تیم توسعهدهنده vLLM با همکاری انویدیا، یک موتور رمزگشایی (Decode Backend) اختصاصی برای مدل Kimi K3 شرکت مانشات (Moonshot) روی سیستمهای GB300 انویدیا پیادهسازی کرده است. این موتور اختصاصی با استفاده از کِرنلهای سفارشی نوشتهشده با زبان سطح پایین CuTe DSL انویدیا، محاسبات بخش توجه (Attention)، سازوکار ترکیب متخصصان (MoE) و تبادل داده میان پردازندههای گرافیکی را در یکدیگر ادغام میکند. این مسیر اجرایی فشردهتر با کاهش محسوس تعداد فراخوانیهای کِرنل، نرخ تولید توکن را در کانفیگهای پشتیبانیشده معماری بلکول (Blackwell) به اوج میرساند.
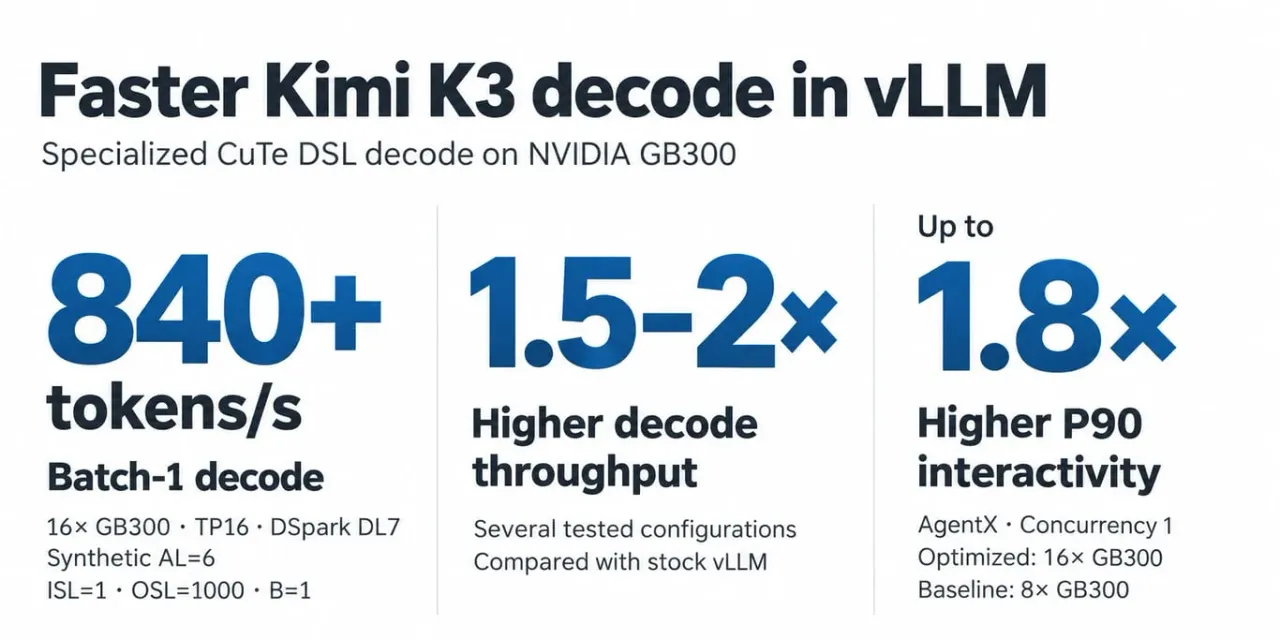
مرحله رمزگشایی (Decode) وظیفه تولید توکنها را پس از پردازش اولیه پرامپت بر عهده دارد؛ از این رو تاخیر در این مرحله مستقیماً روی سرعت برنامههای تعاملی مانند ایجنتهای کدنویسی اثر میگذارد. طبق گزارش تیم vLLM، این موتور در اندازه بچ (Batch Size) برابر با ۱ روی ۱۶ پردازنده گرافیکی GB300 بههمراه تکنیک DSpark و طول پذیرش مصنوعی ۶ توکن، به نرخ تولید بیش از ۸۴۰ توکن در ثانیه دست مییابد. همچنین این راهکار در چندین کانفیگ مختلف، خروجی رمزگشایی را ۱٫۵ تا ۲ برابر افزایش میدهد و شاخص تعاملی P90 را در سناریوهای AgentX تا ۱٫۸ برابر بهبود میبخشد.
فشردهسازی چرخه رمزگشایی با ادغام کِرنلها
این موتور پردازشی، بخش عمده عملیات داخل چرخه رمزگشایی Kimi K3 را با کِرنلهای نوشتهشده در CuTe DSL (سیستم برنامهنویسی سطح پایین انویدیا برای GPU) جایگزین میکند. در چرخه استاندارد vLLM، پردازش یک لایه از مدل با ۲۳ بار فراخوانی کِرنل حدود ۱۳۰ میکروثانیه طول میکشد؛ در حالی که در مسیر بهینهسازیشده اختصاصی، با ترکیب عملیات و هماهنگسازی پردازش میان استریمهای CUDA، این زمان با تنها ۱۳ فراخوانی به ۶۹ میکروثانیه کاهش مییابد.
۴ تغییر کلیدی که عامل این جهش کارایی هستند
- ضرب ماتریسی سازگار با ابعاد (Shape-aware): کِرنلهای ماتریسهای کوچک، تصویرسازی ورودیهای توجه (Attention Input Projections) را در بچهای سایز ۱ و ۲ مدیریت میکنند. در بچهای بزرگتر از کِرنلهای split-K استفاده میشود که یک عمل ضرب ماتریسی را بین واحدهای پردازشی بیشتری از GPU تقسیم میکنند.
- ادغام محاسبات با ارتباطات شبکه: نگاشت خروجی لایه توجه نتایج جزئی را مستقیماً روی بافرهای حافظه قابل دسترس از طریق NVLink مینویسد. کِرنلهای دریافتکننده بیدرنگ عملیات all-reduce را اجرا میکنند، این نتایج را میان تمام GPUها ادغام کرده و پردازش را در محاسبات باقیمانده (Residual) ادامه میدهند.
- مسیریابی خردشده در MoE (مسیریابی Sharded): رنکهای موازیسازی تانسوری، وظیفه محاسبه امتیازهای روتر و تصویرسازی متغیرهای پنهان را بین خود تقسیم میکنند. متخصص مشترک (Shared Expert) روی یک استریم جداگانه اجرا میشود و این امکان را فراهم میسازد تا همزمان با عملیات مسیریابی یا اجرای متخصصان هدایتشده پردازش شود.
- پیشواکشی وزنها (Weight Prefetching): کِرنلی در یک استریم فرعی، وزنهای مدل را در زمانهایی که تبادل اطلاعات بخش کمتری از پهنای باند حافظه را اشغال کرده بارگذاری میکند. در نتیجه، عملیات بعدی میتواند بخش بیشتری از وزنهای مورد نیازش را مستقیماً از حافظه کش فراخوانی کند.
حفظ کارایی بالا در ابعاد و اندازههای مختلف پردازش
موتور اختصاصی جدید، نرخ رمزگشایی را در تمام اندازههای بچ گزارششده بهبود میبخشد؛ حتی در آزمایشهایی که بدون رمزگشایی حدسی (Speculative Decoding) اجرا شدهاند. شایان ذکر است که TP8 و TP16 بهترتیب به موازیسازی تانسوری (Tensor Parallelism) روی ۸ و ۱۶ پردازنده گرافیکی اشاره دارند.
پیکربندی | نسخه استاندارد vLLM | موتور اختصاصی | میزان بهبود |
|---|---|---|---|
TP16، بچ ۱ | ۱۳۶ توکن در ثانیه | ۲۵۶ توکن در ثانیه | ۱٫۸۸ برابر |
TP16، بچهای ۱۶ تا ۶۴ | متغیر بر اساس اندازه بچ | ۱٫۶۲ تا ۱٫۷۱ برابر | |
TP8، بچهای ۱۶ تا ۶۴ | متغیر بر اساس اندازه بچ | ۱٫۳۱ تا ۱٫۴۳ برابر | |
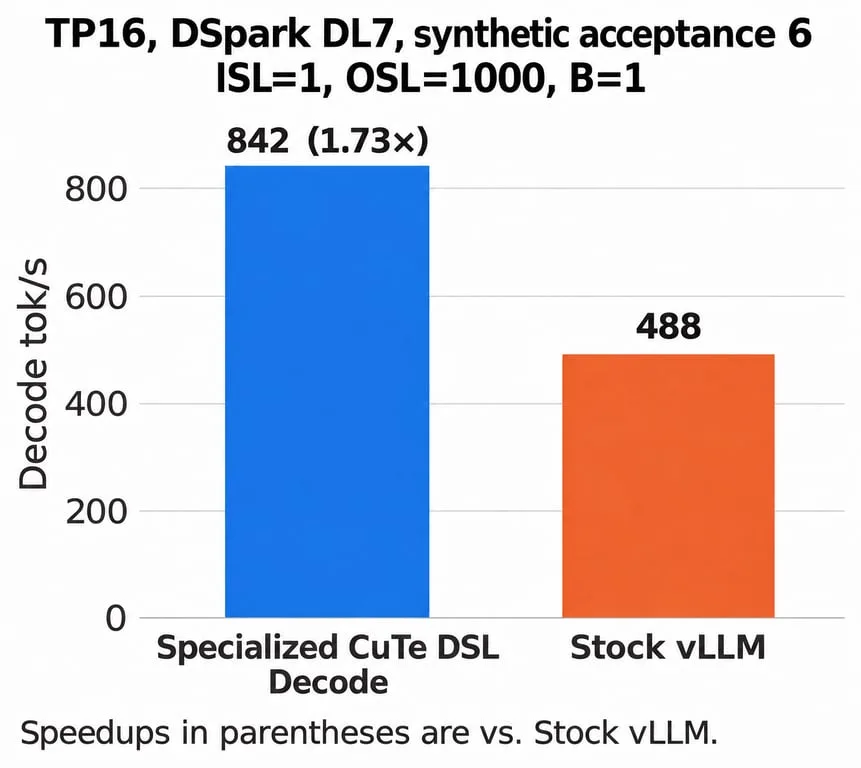
TP16، بچ ۱ با DSpark (طول پذیرش ۶) | ۴۸۸ توکن در ثانیه | ۸۴۲ توکن در ثانیه | ۱٫۷۳ برابر |
بنچمارک AgentX متعلق به موسسه SemiAnalysis، ترافیک واقعی ایجنتهای کدنویسی را با کانتکستهای طولانی، گفتوگوهای چندمرحلهای، مکثهای ناشی از فراخوانی ابزارها، فعالیت سابایجنتهای موازی و استفاده مجدد از حافظه KV-cache شبیهسازی میکند. در نرخ همزمانی ۱، بیلد بهینهسازیشده جدید در شاخص تعاملی P90 بهسرعت ۴۰۳٫۲ توکن در ثانیه برای هر کاربر دست یافت؛ رقمی که در مقایسه با سرعت ۲۲۳٫۷ توکن در مسیر استاندارد، پیشرفتی چشمگیر محسوب میشود.
شرایط و محدودیتهای راهاندازی در محیط عملیاتی
این بهینهسازی بهطور ویژه برای پردازشهای رمزگشایی مدل Kimi K3 روی ۸ یا ۱۶ پردازنده گرافیکی انویدیا بلکول درون یک دامنه NVLink با پشتیبانی از چندپخشی (Multicast) طراحی شده است. دامنه تحت پوشش این روش شامل بچهای رمزگشایی ۱ تا ۶۴ است و از قابلیت موازیسازی زمینه در رمزگشایی (Decode Context Parallelism) برای توالیهای طولانی پشتیبانی میکند. در کانفیگهایی که مشمول این شرایط نیستند، سیستم بهطور خودکار به مسیر استاندارد vLLM برمیگردد.
بخش | دامنه پشتیبانیشده |
|---|---|
سختافزار | انویدیا Blackwell از جمله GB300 |
تعداد پردازنده گرافیکی (GPU) | ۸ یا ۱۶ عدد |
توپولوژی | یک دامنه NVLink با پشتیبانی از قابلیت چندپخشی (Multicast) |
اندازه بچ رمزگشایی | ۱ تا ۶۴ |
کانتکستهای طولانی | پشتیبانی اختیاری از موازیسازی زمینه رمزگشایی |
قابلیتهای سرویسدهی | سرویسدهی فولکانتکست، نمونهبرداری با دما (Temperature Sampling)، خروجی ساختاریافته و رمزگشایی حدسی |
این موتور پردازشی صرفاً سرعت تولید توکن را شتاب میبخشد و مرحله پیشپردازش پرامپت (Prefill) را تغییر نمیدهد. تغییرات اعمالشده کاملاً درون کدهای اختصاصی رمزگشایی همین مدل ایزوله شدهاند و بخشهای مشترک نظیر آمادهسازی ورودی، نمونهبرداری و مدیریت KV-cache دستنخورده باقی ماندهاند. در صورت فراهم بودن سختافزار و توپولوژی مناسب، تیمهای فنی میتوانند با تعیین مقدار latency_specialized در تنظیمات backend، این مسیر بهینهسازی اختصاصی را فعال کنند.
نظارت و اعتبارسنجی دقیق برای کِرنلهای تولیدشده با هوش مصنوعی
این انتشار همچنین زمینه اجرایی یک درخواست تغییرات (RFC) ویژه و سریع را فراهم کرده است که برای کدهای بهینهسازی تولیدشده توسط ایجنتهای هوش مصنوعی پیشنهاد شده بود. از آنجا که ارزیابی صحت کِرنلهای ادغامشده CuTe صرفاً از طریق بررسی خطبهخط کدها بسیار دشوار است، این پیشنهاد مشارکتکنندگان را ملزم میکند تا پیش از بررسی معماری، تغییرات خود را درون کدهای اختصاصی مدل ایزوله کنند، کانفیگهای تحت پشتیبانی را بهطور شفاف تعریف نمایند و نتایج تکرارپذیری از صحت عملکرد و بازدهی فنی ارائه دهند.
در فرآیند بازبینی کِرنلهای Kimi K3 مشخص شد کامپایلر ممکن است خواندن مقادیر اکتیویشن را قبل از انتظار برای همگامسازی (Synchronization Wait) جابهجا کند؛ مشکلی که با محدود کردن این الگوی بارگذاری صرفاً به وزنهای استاتیک برطرف شد. علاوه بر این، ارزیابیهای مربوط به کانتکستهای طولانی از جمله بنچمارکهای MRCR و AIME25، برخی ناپایداریهای محاسباتی و خطاهای عددی را در کِرنلهای بخش توجه و ارتباطات آشکار کردند که تستهای اولیه با دادههای ساختگی متوجه آنها نشده بودند.
گسترش این الگو به سایر مدلهای هوش مصنوعی
در همین راستا، یک پولریکوئست اختصاصی برای دیپسیک پیکربندی مشابه decode_backend: latency_specialized را به مدل DeepSeek-V4.1-Flash اضافه کرده است. این پیادهسازی عملیات all-reduce را در مرزهای هر زیرلایه ادغام میکند و محاسبات CPU در هر گام را در قالب یک گراف CUDA برای اجرای مجدد ذخیره مینماید.
برای مدل Muse Spark Open شرکت متا نیز تیم توسعهدهنده به نرخ خروجی اولیه بیش از ۹۵۰ توکن در ثانیه به ازای هر کاربر (با هفت توکن پیشنویس در رمزگشایی حدسی) دست یافته است. همچنین برنامهریزیها نشان میدهد که مدل GLM 5.3 نیز بهزودی به این مسیر پردازشی اختصاصی مجهز خواهد شد.
در نهایت، برای راهاندازی مدل Kimi K3 با پیکربندیهای TP8 یا TP16 در بستر شبکههای تحت پشتیبانی NVLink، این موتور یک راهکار اختصاصی برای کاهش چشمگیر تاخیر رمزگشایی ارائه میدهد؛ بدون آنکه نیازی به تغییر در زیرسیستمهای مشترک vLLM باشد. علاوه بر این، سند RFC همراه با این بهروزرسانی، چارچوب مشخصی تعریف میکند تا کدهای مشابه تولیدشده توسط ایجنتهای هوش مصنوعی بتوانند با تعیین دقیق محدوده، مسیرهای جایگزین شفاف و اعتبارسنجی تکرارپذیر، با ایمنی کامل به استک سرویسدهی مدلها راه یابند.
برچسب های مرتبط
مطالب مرتبط و پیشنهادی
غرامت ۲۵۰ میلیون دلاری اپل برای تبلیغات گمراهکننده هوش مصنوعی؛ نحوه ثبتنام خریداران آیفون
اپل برای حلوفصل پرونده تبلیغات گمراهکننده درباره قابلیتهای هوش مصنوعی سری آیفون ۱۶، توافق کرده است ۲۵۰ میلیون دلار به خریداران خسارت بپردازد. کاربران واجد شرایط میتوانند با مراجعه به سامانه رسمی، فرم دریافت سهم ۲۵ تا ۹۵ دلاری خود را تکمیل کنند.
آیا این تصویر واقعی است؟ آموزش گامبهگام تشخیص عکسهای هوش مصنوعی متا در ۴ مرحله
با پیشرفت چشمگیر هوش مصنوعی، تشخیص تصاویر واقعی از محتوای ساختگی دشوارتر از همیشه شده است. متا با ابزار رایگان خود و واترمارک نامرئی Content Seal، این امکان را فراهم کرده تا تنها در ۴ مرحله ساده اصالت عکسها، ویدیوها و فایلهای صوتی را بررسی کنید.
ابزار متنباز Geo-sleuth ایجنتهای هوش مصنوعی را به کارآگاه مکانیابی تصاویر تبدیل میکند
پروژه متنباز Geo-sleuth با افزودن اسکیل مکانیابی به ایجنتهای کدنویسی، امکان تشخیص موقعیت جغرافیایی عکسها را بدون نیاز به دادههای GPS یا نشانههای مشهور فراهم میکند. این ابزار هوشمند با ترکیب دادههای هندسی، مدلهای بینایی ماشین و نقشههای ماهوارهای، مختصات دقیق و زاویه دید دوربین را استخراج میکند.
دیدگاه ها و گفتگوی تخصصی
نظرات خود را با جامعه مخاطبان وایر ای آی در میان بگذارید
هنوز دیدگاهی برای این مطلب ثبت نشده است
اولین نفری باشید که دیدگاه، تحلیل یا دیدگاه خود را درباره این موضوع با دیگران به اشتراک می گذارد.